第 8 章 · 第八节
第六部分:AI 伦理与治理
从技术问题走到社会问题。
重 点这一部分是全章最长的一块
从第 61 页一直排到第 81 页,讲五件事:伦理挑战、公平性与透明度、价值对齐、全球治理、治理面临的困难。
打个比方和上一部分的区别
安全与隐私是技术问题,有技术解法。伦理与治理是社会问题,技术只能帮一部分忙,剩下的要靠规则和共识。
想一想
技术上能做到的事,是不是都应该做?
从技术问题走到社会问题。
从第 61 页一直排到第 81 页,讲五件事:伦理挑战、公平性与透明度、价值对齐、全球治理、治理面临的困难。
安全与隐私是技术问题,有技术解法。伦理与治理是社会问题,技术只能帮一部分忙,剩下的要靠规则和共识。
技术上能做到的事,是不是都应该做?
AI 参与决策之后,公平性、可信度与错误责任都难以界定。
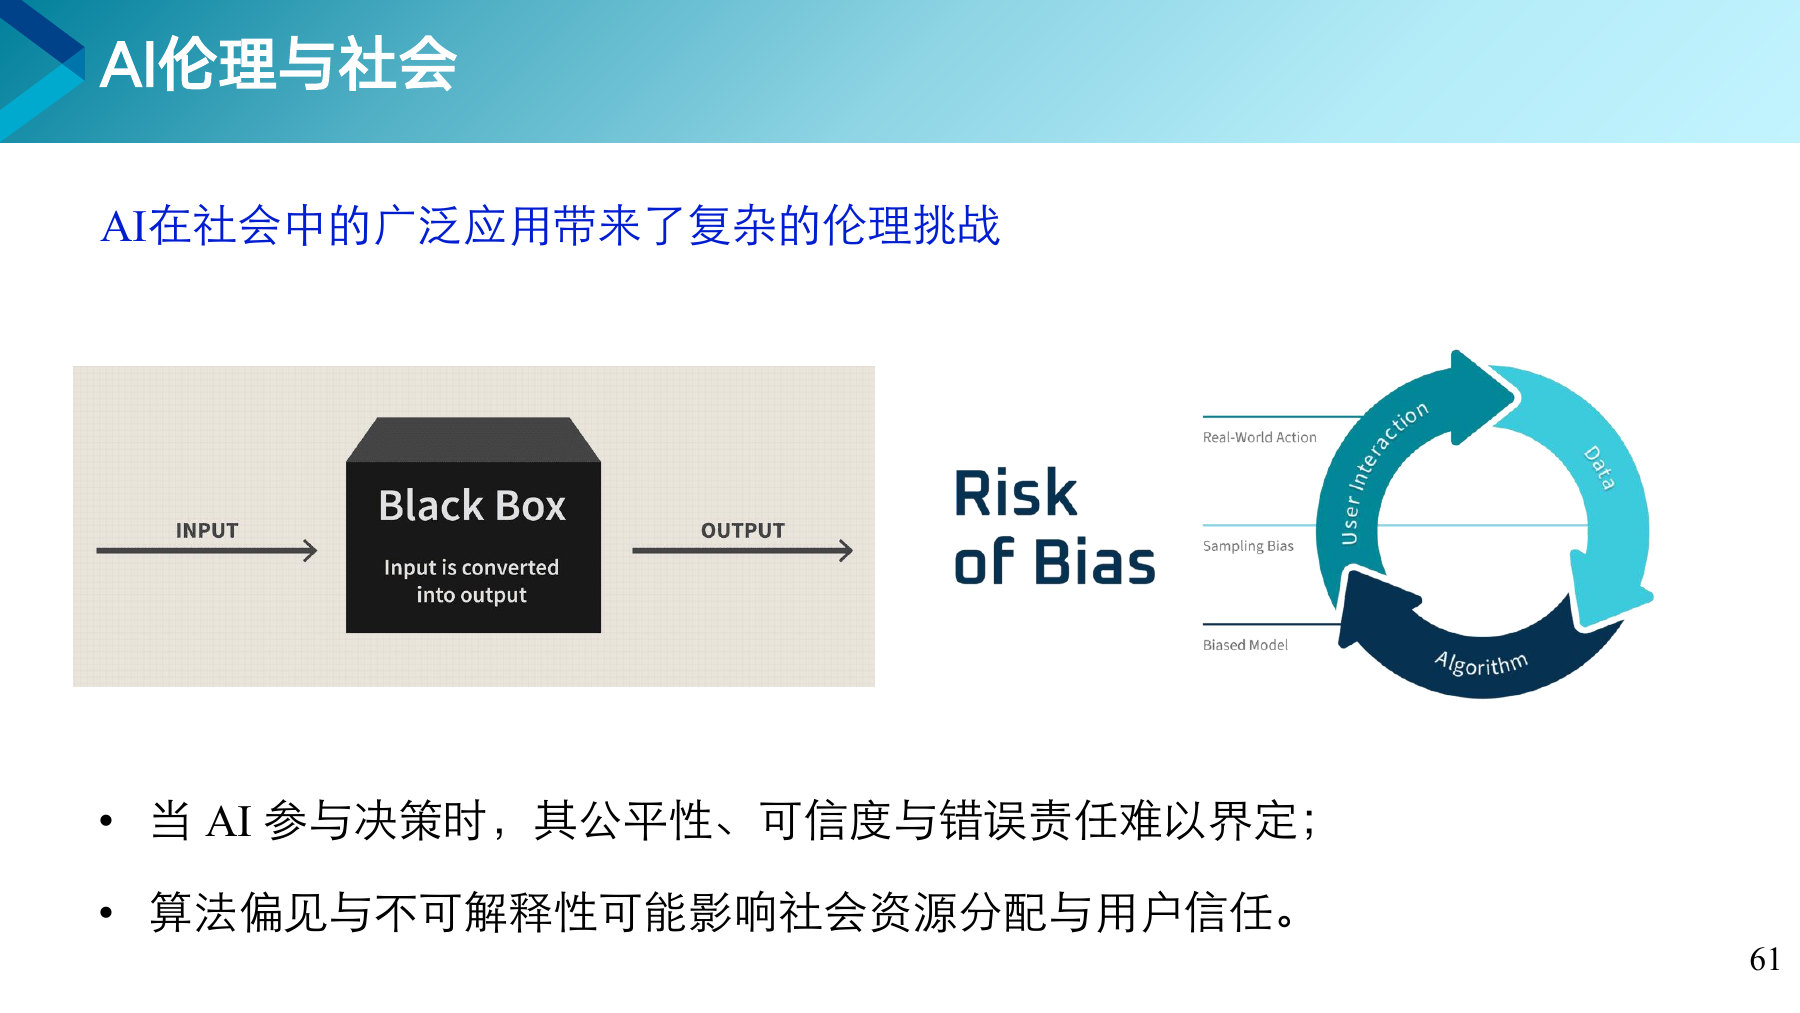
当 AI 参与决策时,其公平性、可信度与错误责任难以界定。算法偏见与不可解释性可能影响社会资源分配与用户信任。
输入进去,输出出来,中间发生了什么没人知道。旁边那个循环画的是偏见如何在数据、算法、用户交互之间转圈放大。用户按推荐点击,点击又成了新数据,偏见就被固化下来。
一个人做错事责任清楚。一个系统做错事,可能是数据的问题、算法的问题、部署方式的问题,也可能是用户用错了。第 69 页会专门讲这个。
贷款申请被AI拒绝了,你能问到理由吗?
深度学习依赖海量数据,很容易越过隐私的边界。
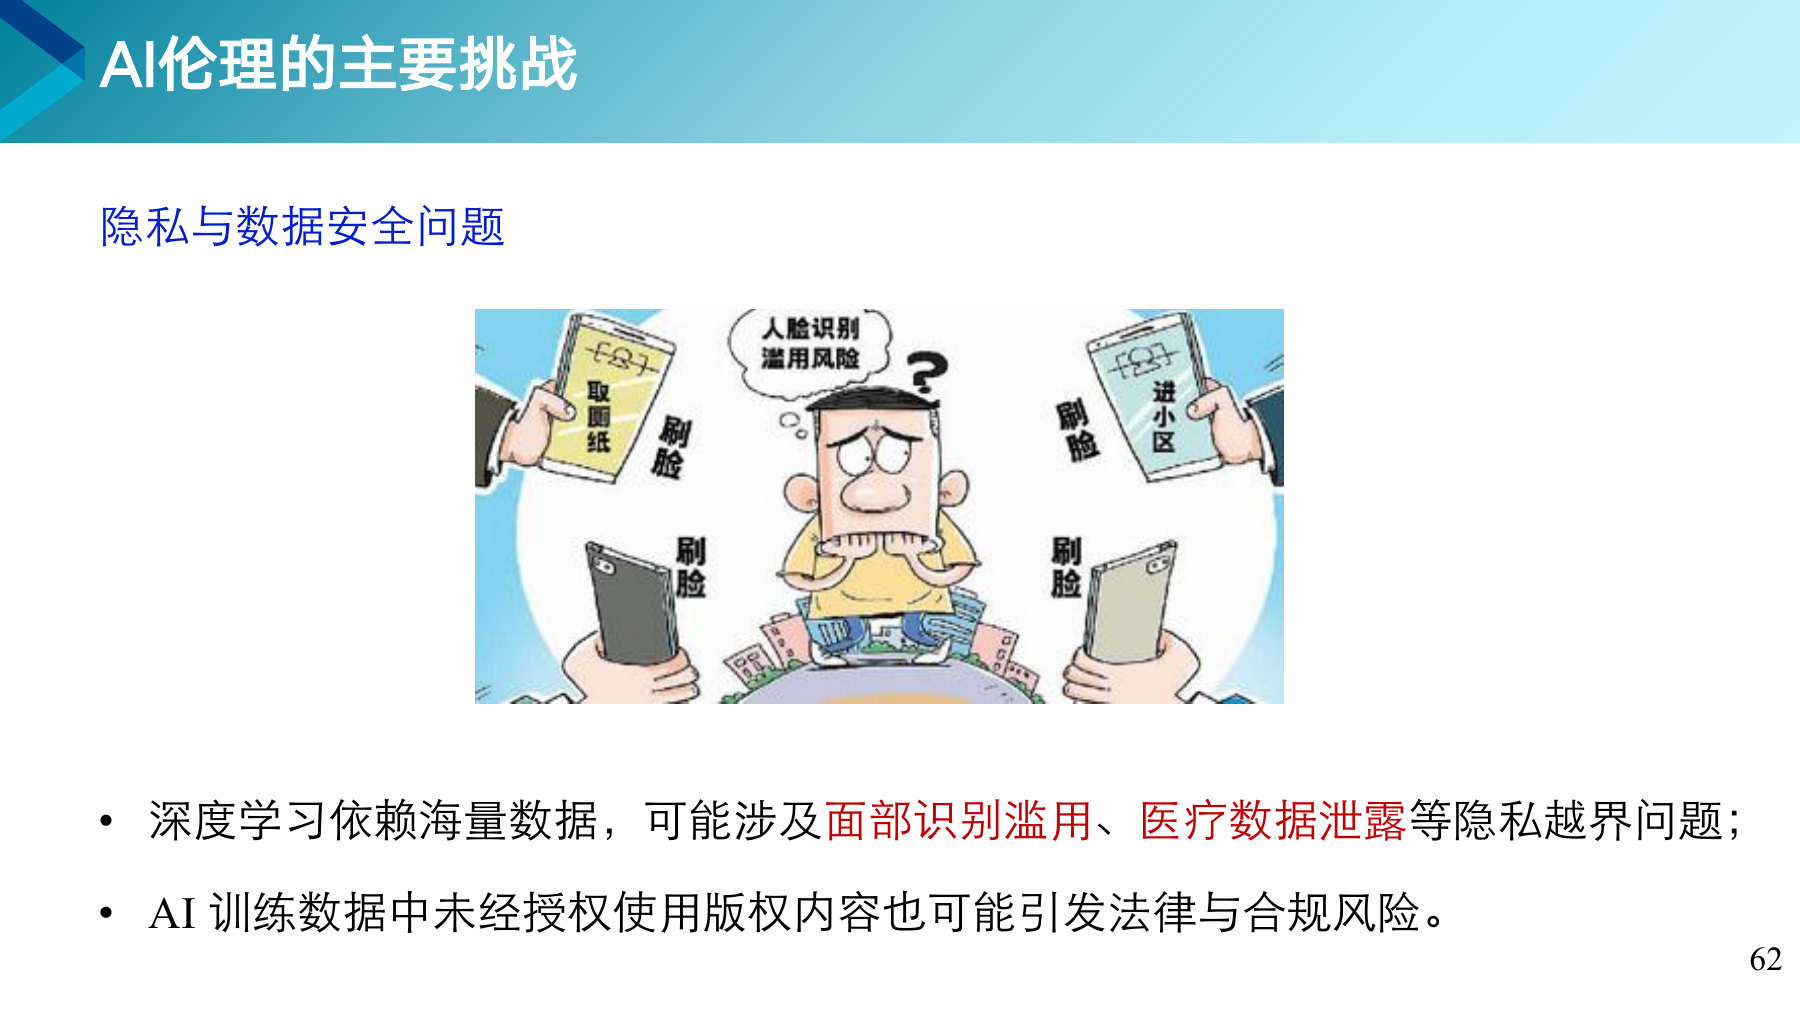
深度学习依赖海量数据,可能涉及面部识别滥用、医疗数据泄露等隐私越界问题。AI 训练数据中未经授权使用版权内容也可能引发法律与合规风险。
取个纸要刷脸,进小区要刷脸,办点事都要刷脸。每一次刷脸都在某个地方留下了一份数据,而普通人根本不知道这些数据存在哪、谁能看。
大模型训练用了大量网络上的文本和图片,其中相当一部分是有版权的。这几年围绕这件事的诉讼在全球范围内不断出现。
你今天刷了几次脸?这些数据存在哪里?
历史数据中的偏见会被模型继承并放大。
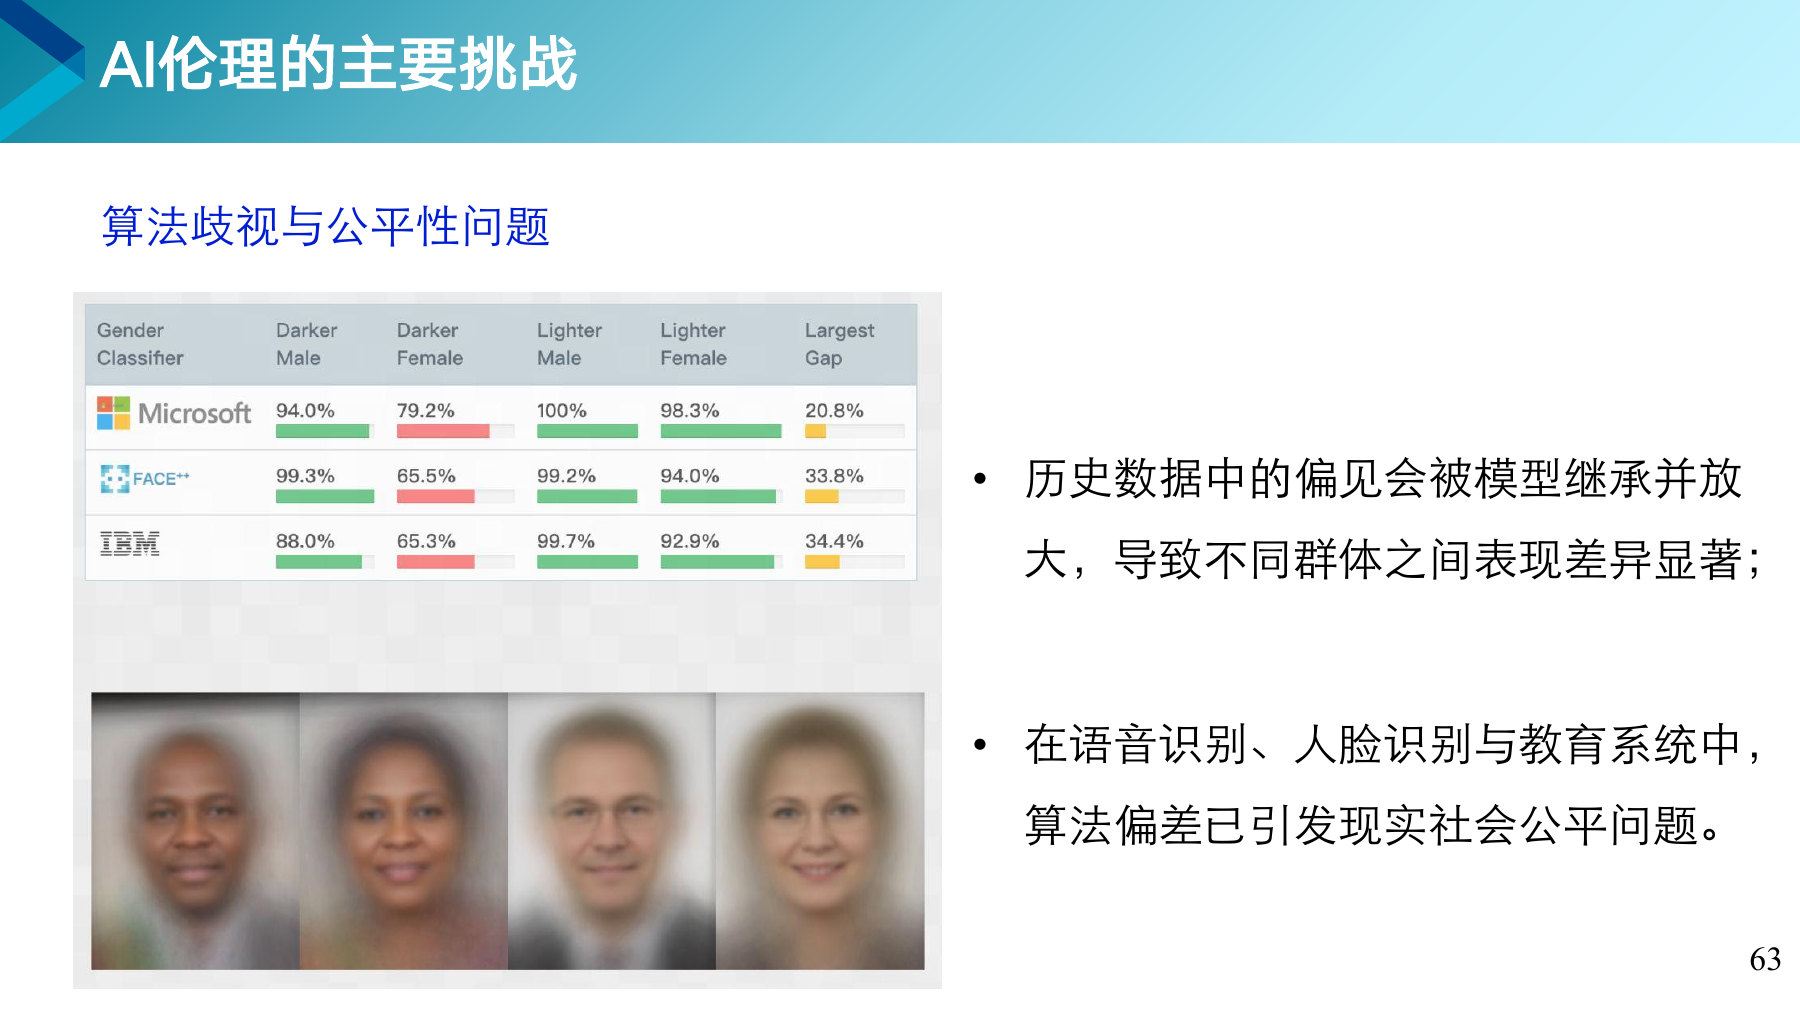
三个商用的性别分类系统,在深肤色女性上的准确率分别是 79.2%、65.5%、65.3%,而在浅肤色男性上都接近百分之百。最右边那一列是最大差距,最高达到 34.4%。
训练数据里浅肤色男性的照片多,深肤色女性的照片少。模型在见得多的那一类上练得好,见得少的那一类就练不好。它没有恶意,只是照着数据学。
在语音识别、人脸识别与教育系统中,算法偏差已引发现实社会公平问题。一个准确率百分之九十的系统,如果那百分之十的错误全落在同一群人身上,这个系统就是不公平的。第 7 章第 11 页说的看清性能来源,讲的就是这件事。
一个系统对不同人群准确率差三成,还能叫准确吗?
开发者、运营商与用户之间的责任边界很模糊。
有用户使用某AI平台查询高校报考信息,AI 生成了不准确的信息,并承诺若内容有误将赔偿十万元。用户随后起诉平台研发公司要求赔偿,成为国内首例 AI 幻觉侵权案。法院认为 AI 不具有民事主体资格,其自行生成的赔偿承诺不能视为服务提供者的意思表示,故不产生法律效力。
AI 说的话不算数,因为它不是一个法律上的人。它的话要算数,得由背后的公司来认。这一点在未来会被反复引用。
AI 承诺赔偿十万元,这句话应该由谁负责?
深度伪造技术可生成虚假图像、视频与音频。
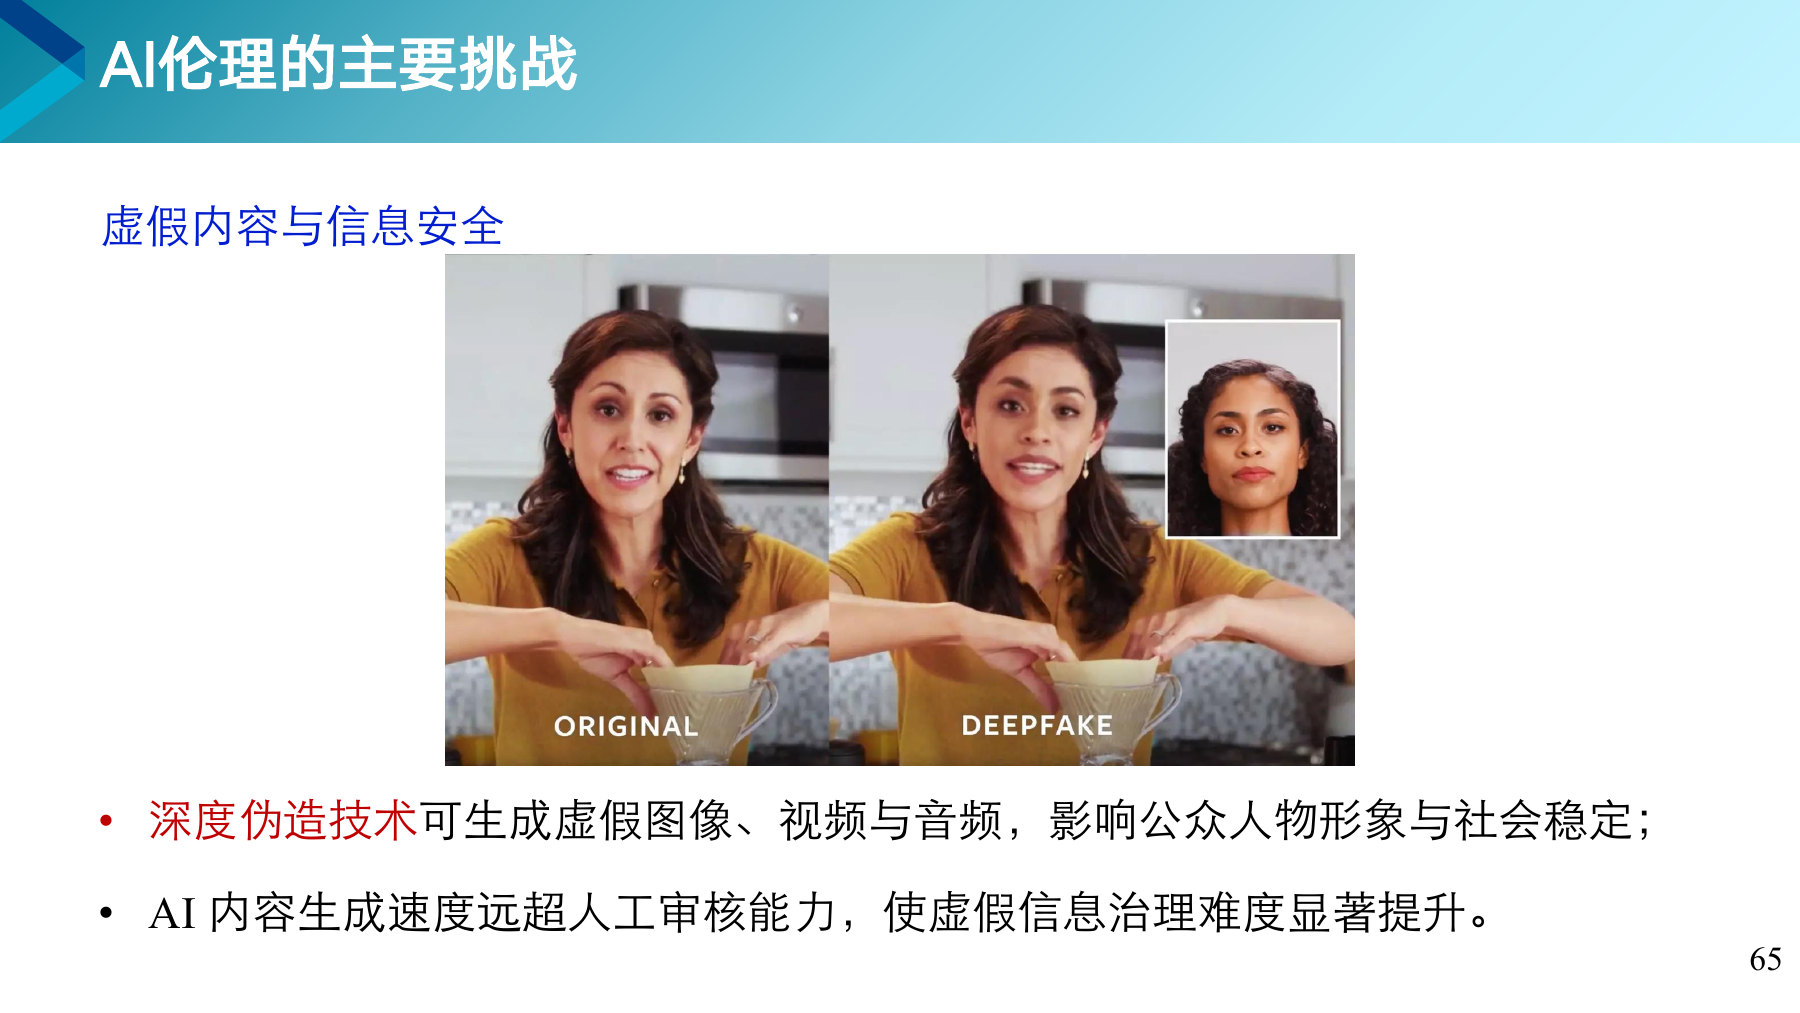
深度伪造技术可生成虚假图像、视频与音频,影响公众人物形象与社会稳定。AI 内容生成速度远超人工审核能力,使虚假信息治理难度显著提升。
左边是原始视频,右边是把另一个人的脸换上去之后的结果。表情、口型、光影都对得上,肉眼很难分辨。生成这样一段视频现在只需要几分钟。
生成一条假视频要几分钟,人工核实一条要几小时。这个速度差意味着靠人工审核永远追不上。第 7 章第 56 页要求 AI 生成内容须标注,就是应对这个问题的办法之一。
一段视频看起来完全真实,你怎么判断它是不是AI生成的?
自动化与生成式AI正在替代制造业与知识型岗位。
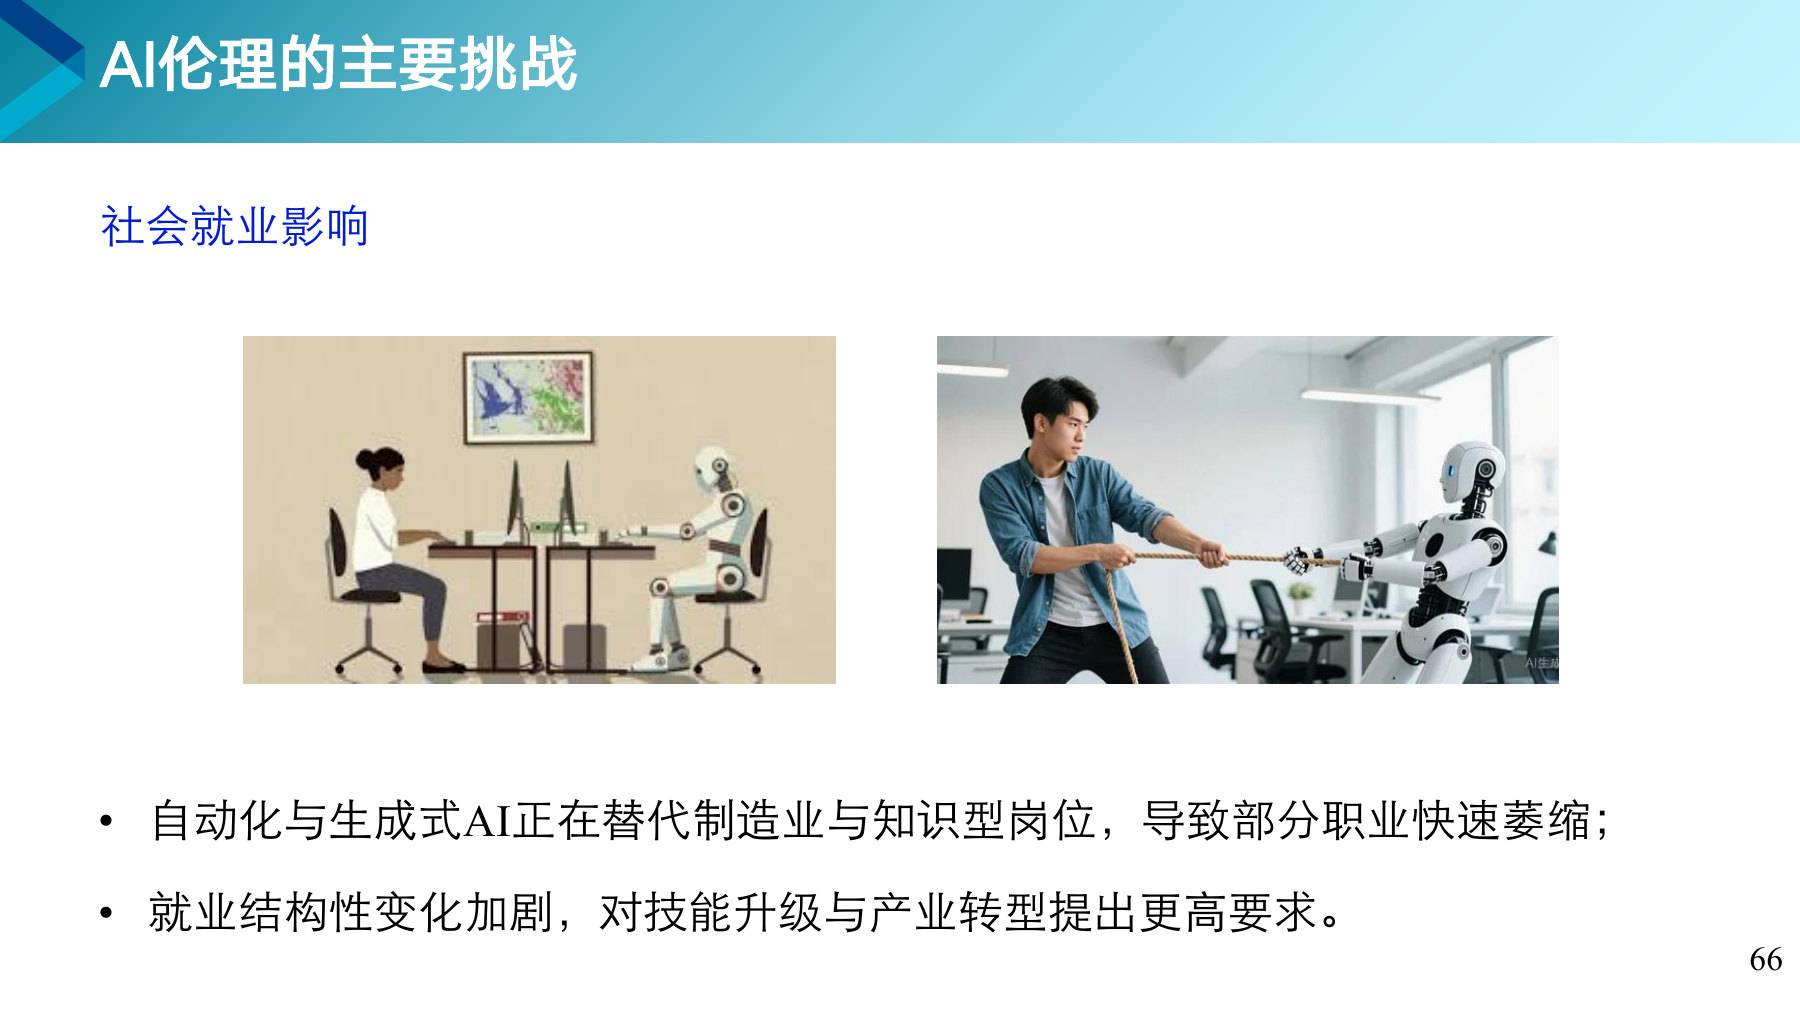
自动化与生成式AI正在替代制造业与知识型岗位,导致部分职业快速萎缩。就业结构性变化加剧,对技能升级与产业转型提出更高要求。
前几次替代的主要是体力劳动,这一次连写文案、画图、写代码这些知识型工作也在被替代。受影响的人群和以往不一样。
不是简单的岗位变少,而是需要的技能类型变了。有些岗位消失的同时有些新岗位出现,问题在于失去工作的人不一定能顺利转到新岗位上去。
你打算从事的行业,哪些环节可能被AI替代?