第 8 章 · 第六节
第五部分:AI 安全与隐私
前面讲AI能做什么,从这里开始讲AI会出什么问题。
重 点这一部分分两块
安全问题来自对抗攻击、数据投毒与模型脆弱性。隐私风险来自训练数据泄露与模型反演攻击。两块分别对应第 49 到 54 页和第 55 到 59 页。
打个比方
前面几部分像在讲一辆车能跑多快,这一部分开始讲刹车和安全带。
想一想
一个很强但不安全的系统,你敢用吗?
前面讲AI能做什么,从这里开始讲AI会出什么问题。
安全问题来自对抗攻击、数据投毒与模型脆弱性。隐私风险来自训练数据泄露与模型反演攻击。两块分别对应第 49 到 54 页和第 55 到 59 页。
前面几部分像在讲一辆车能跑多快,这一部分开始讲刹车和安全带。
一个很强但不安全的系统,你敢用吗?
AI 在广泛应用的同时面临严峻的安全与隐私挑战。
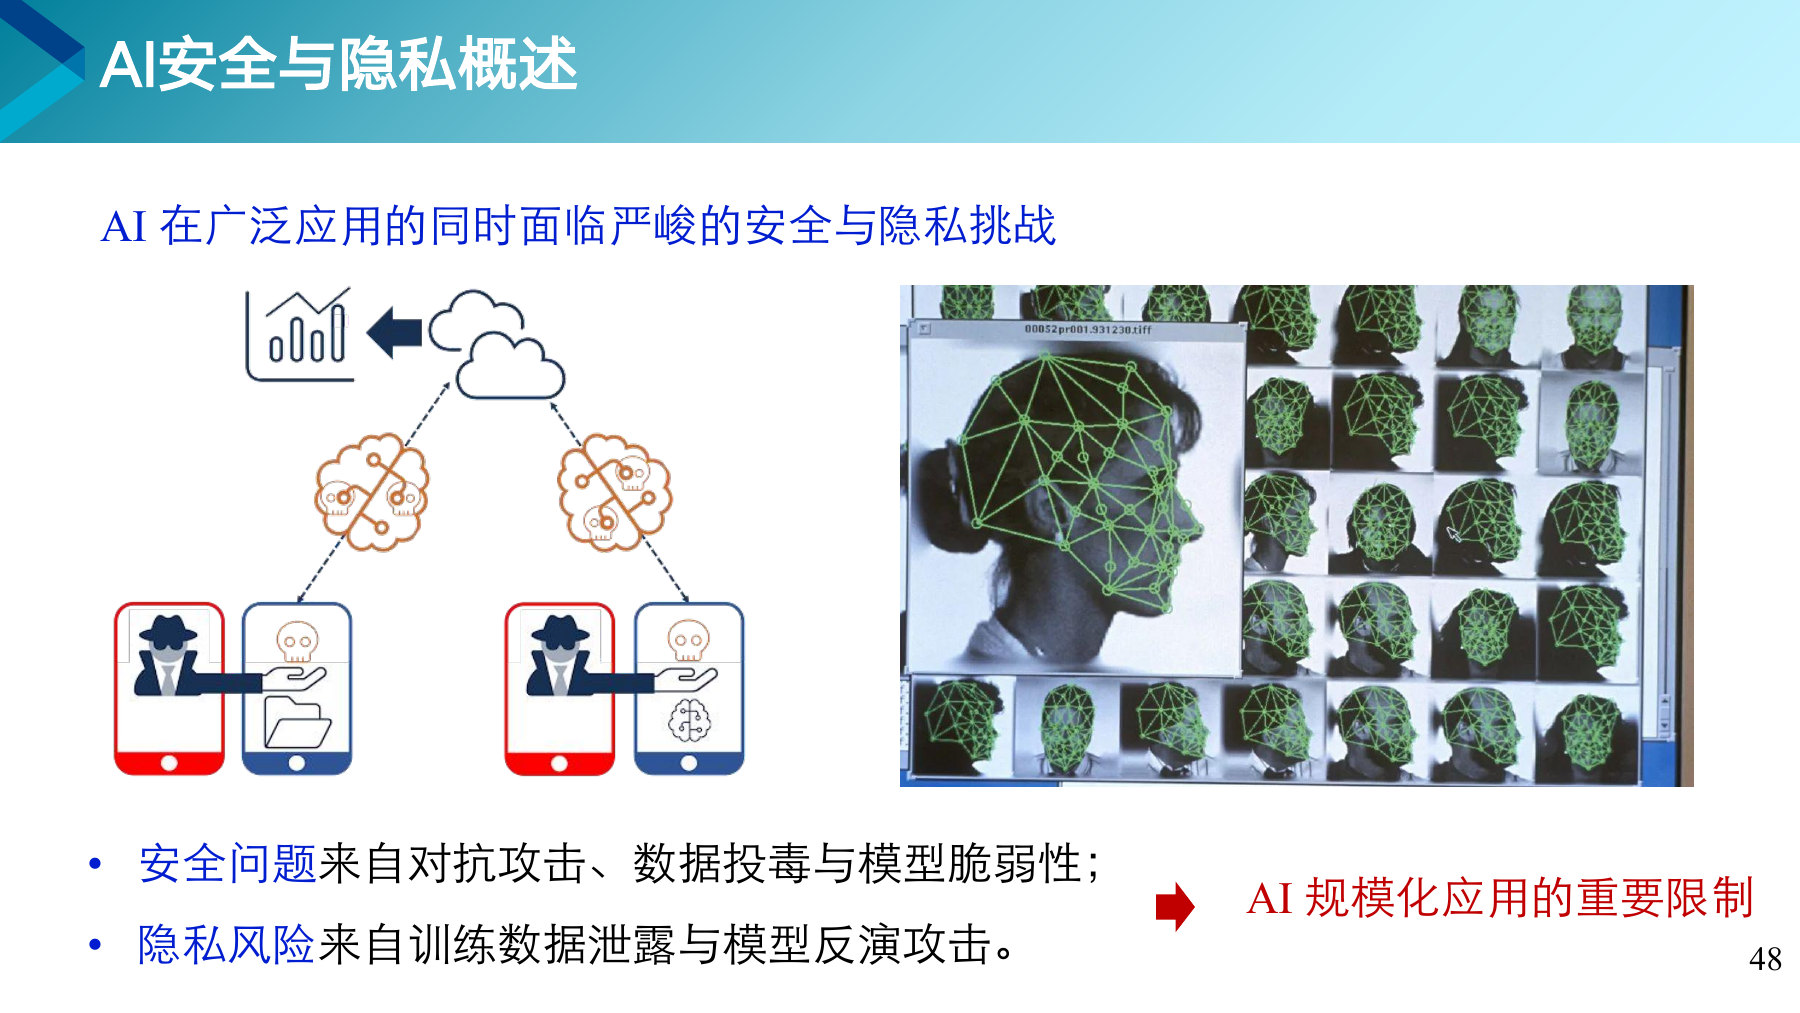
这些问题是 AI 规模化应用的重要限制。也就是说不解决这些,模型再强也推不开。
一个人的面部特征被采集成几十上百个关键点存进数据库。这些数据一旦泄露是无法更换的。密码泄露了可以改,脸泄露了改不了。
安全问题是有人主动攻击你的模型,隐私风险是你的模型无意中泄露了训练数据。一个是外部入侵,一个是内部渗漏。
密码可以改,人脸和指纹泄露了怎么办?
加一点人眼看不出的扰动,模型就会以高置信度答错。
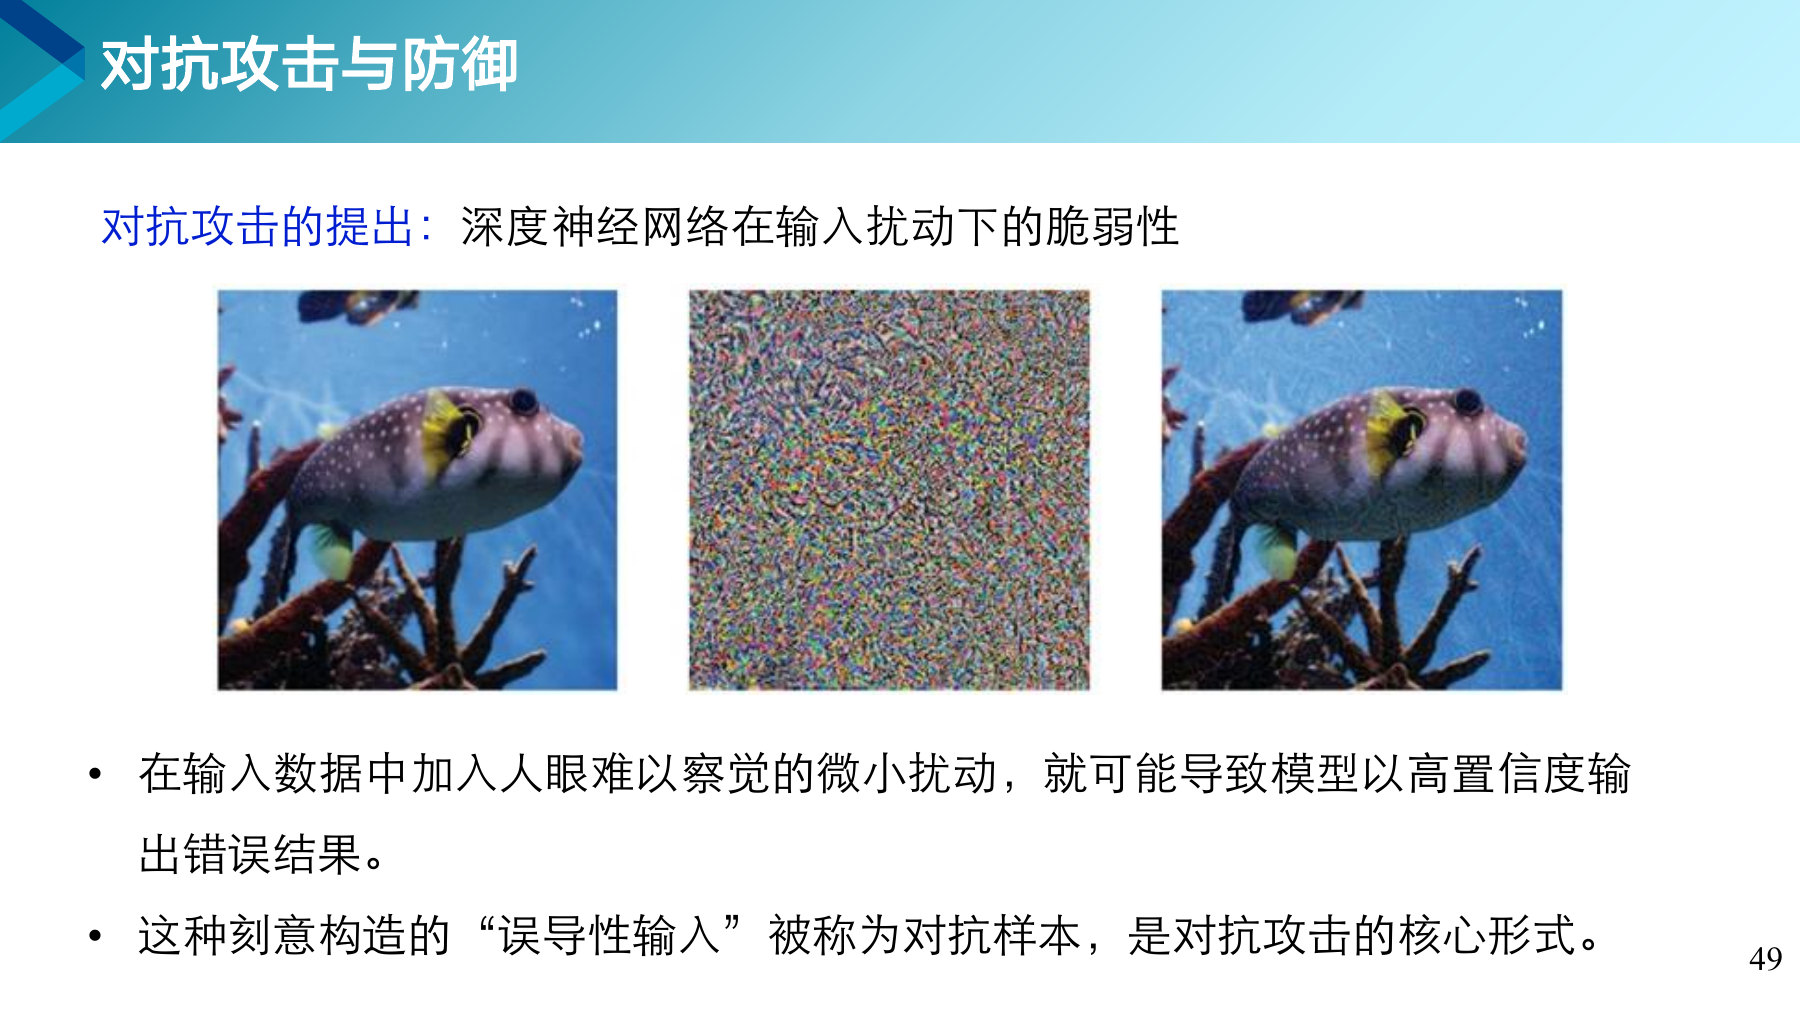
左边是原始的河豚照片,模型认得对。中间是一层看起来像噪点的扰动。右边是两者相加的结果,人眼看和左边没有区别,模型却认成了别的东西。
不是模型偶尔看错,而是有人可以精确地设计出让它看错的输入,而且它错得非常自信。这说明模型学到的判断依据和人完全不一样。
两张人眼看起来一模一样的图,模型给出不同答案,问题出在哪?
让模型在训练与推理过程中见过攻击、识别攻击并抵抗攻击。
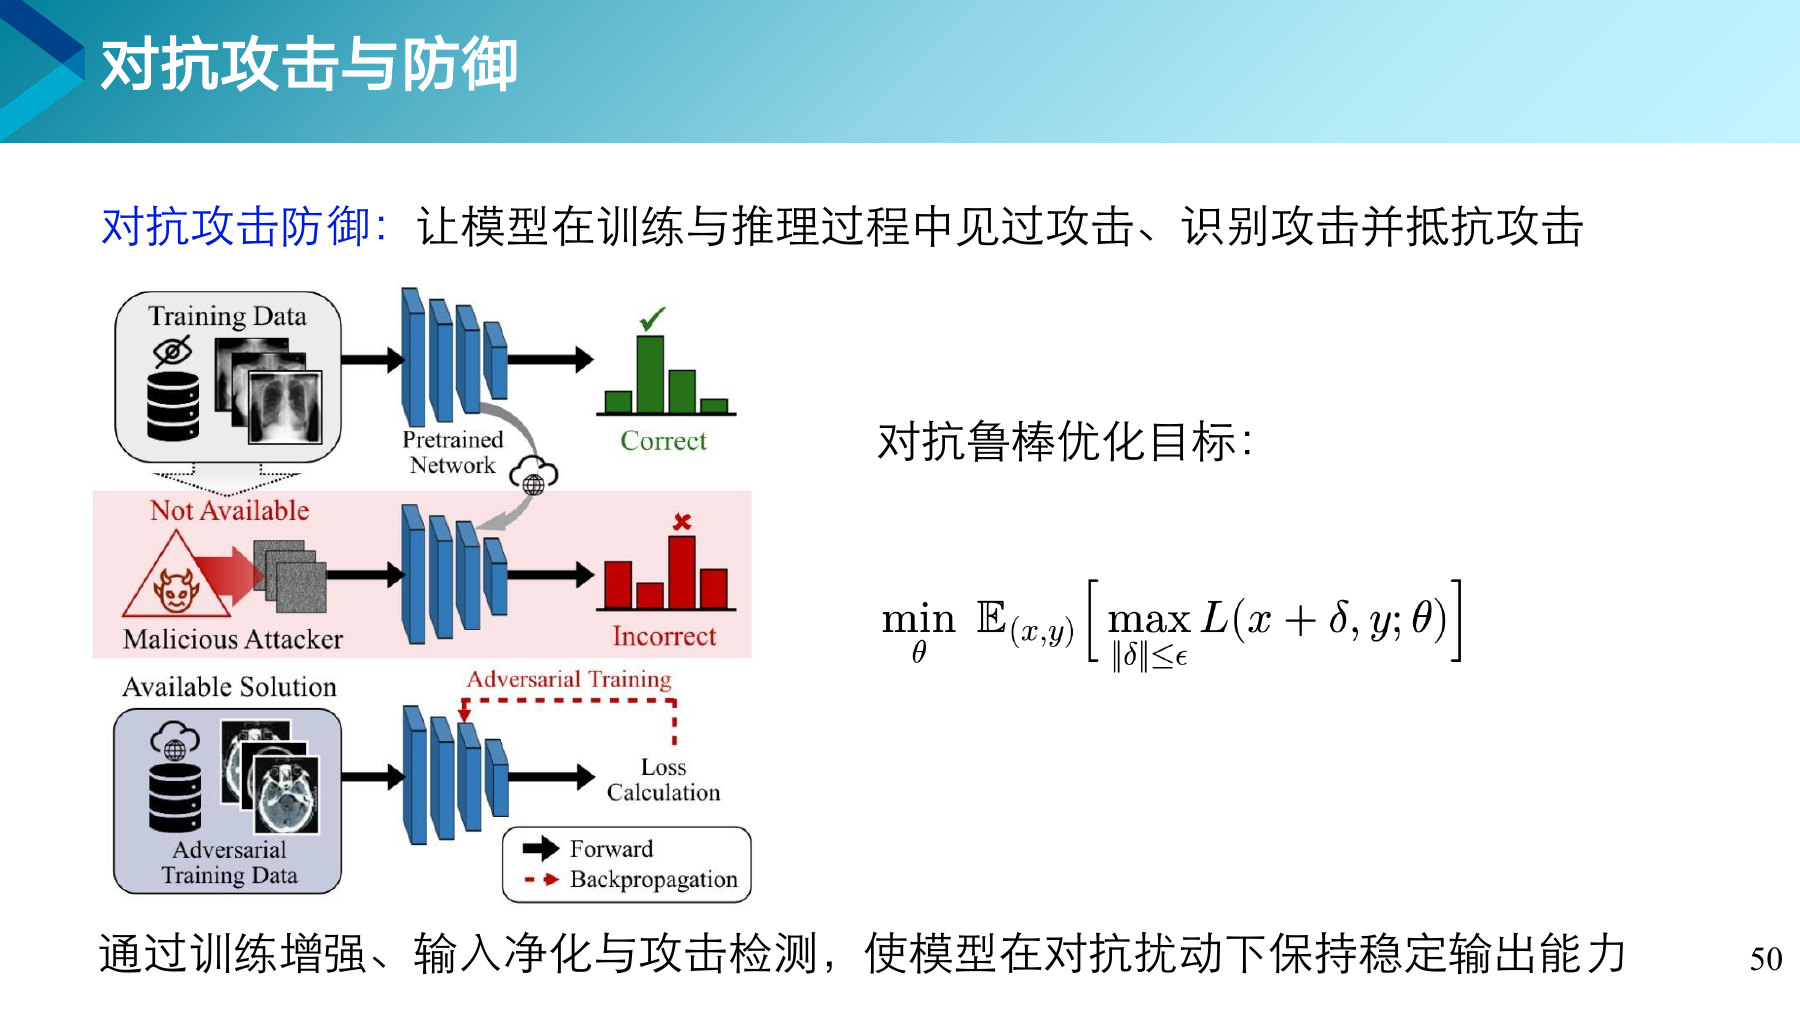
里层的 max 是攻击方,在允许的扰动范围内找一个让损失最大的扰动。外层的 min 是防御方,调整参数让这个最坏情况下的损失尽量小。整个式子就是一句话,按最坏情况来练。
普通训练是把课后习题做熟。对抗训练是专门找最难最刁钻的题来做。最坏情况都准备好了,正常题自然不在话下。
训练增强、输入净化与攻击检测,分别对应训练阶段、推理之前和运行之中。后面几页各讲一种。
按最坏情况来训练,代价是什么?
直接影响身份认证、自动驾驶与工业控制等关键场景。
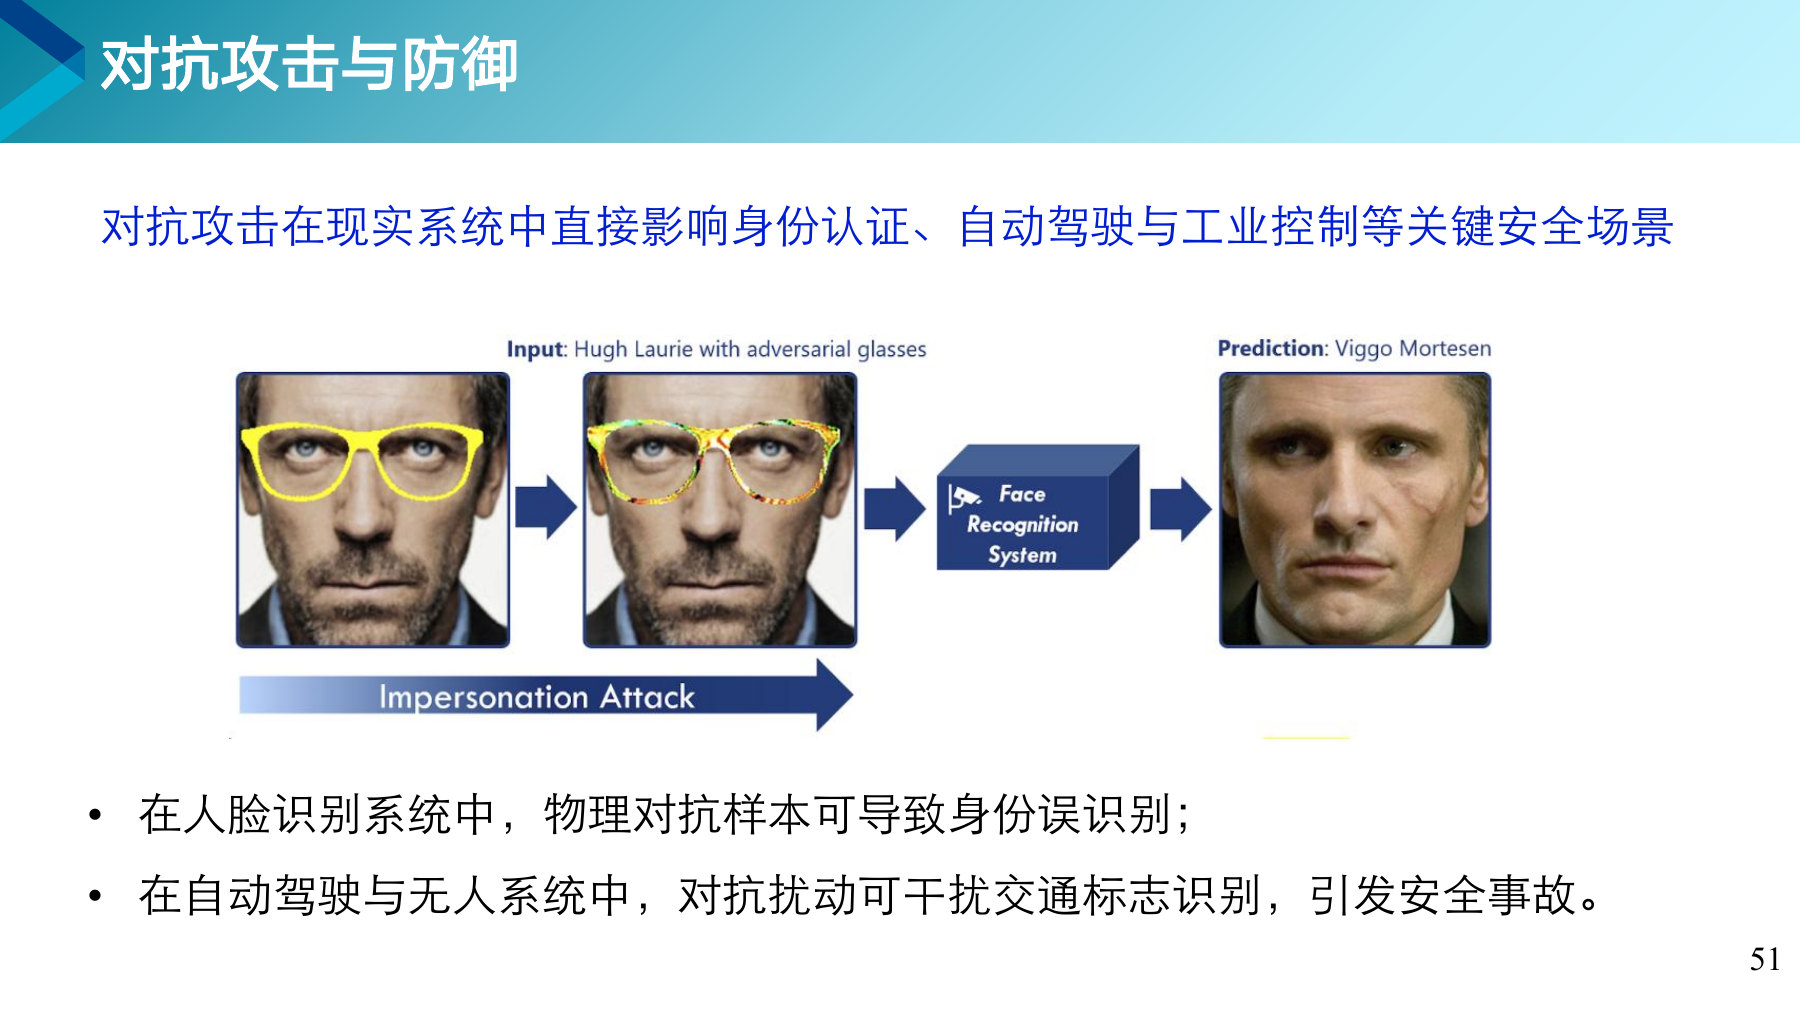
攻击都发生在物理世界,不需要碰到系统本身。人脸识别那边靠一副眼镜,自动驾驶那边靠贴在交通标志上的一张纸。前面几章讲的模型问题多半只影响准确率,这一类直接影响人身安全。
研究者做了一副印着特殊花纹的眼镜,戴上之后人脸识别系统把这个人认成了另一个完全不同的人。花纹不是随便印的,是专门算出来的。
数字世界的攻击要能改到输入文件才行。物理对抗样本印在眼镜、贴纸、衣服上,不需要接触系统就能生效。第 2 章讲的模型鲁棒性,在这里有了很实际的含义。
在停车标志上贴一张纸,自动驾驶车可能怎么判断?
在模型推理之前先把输入洗一遍,破坏扰动的结构。
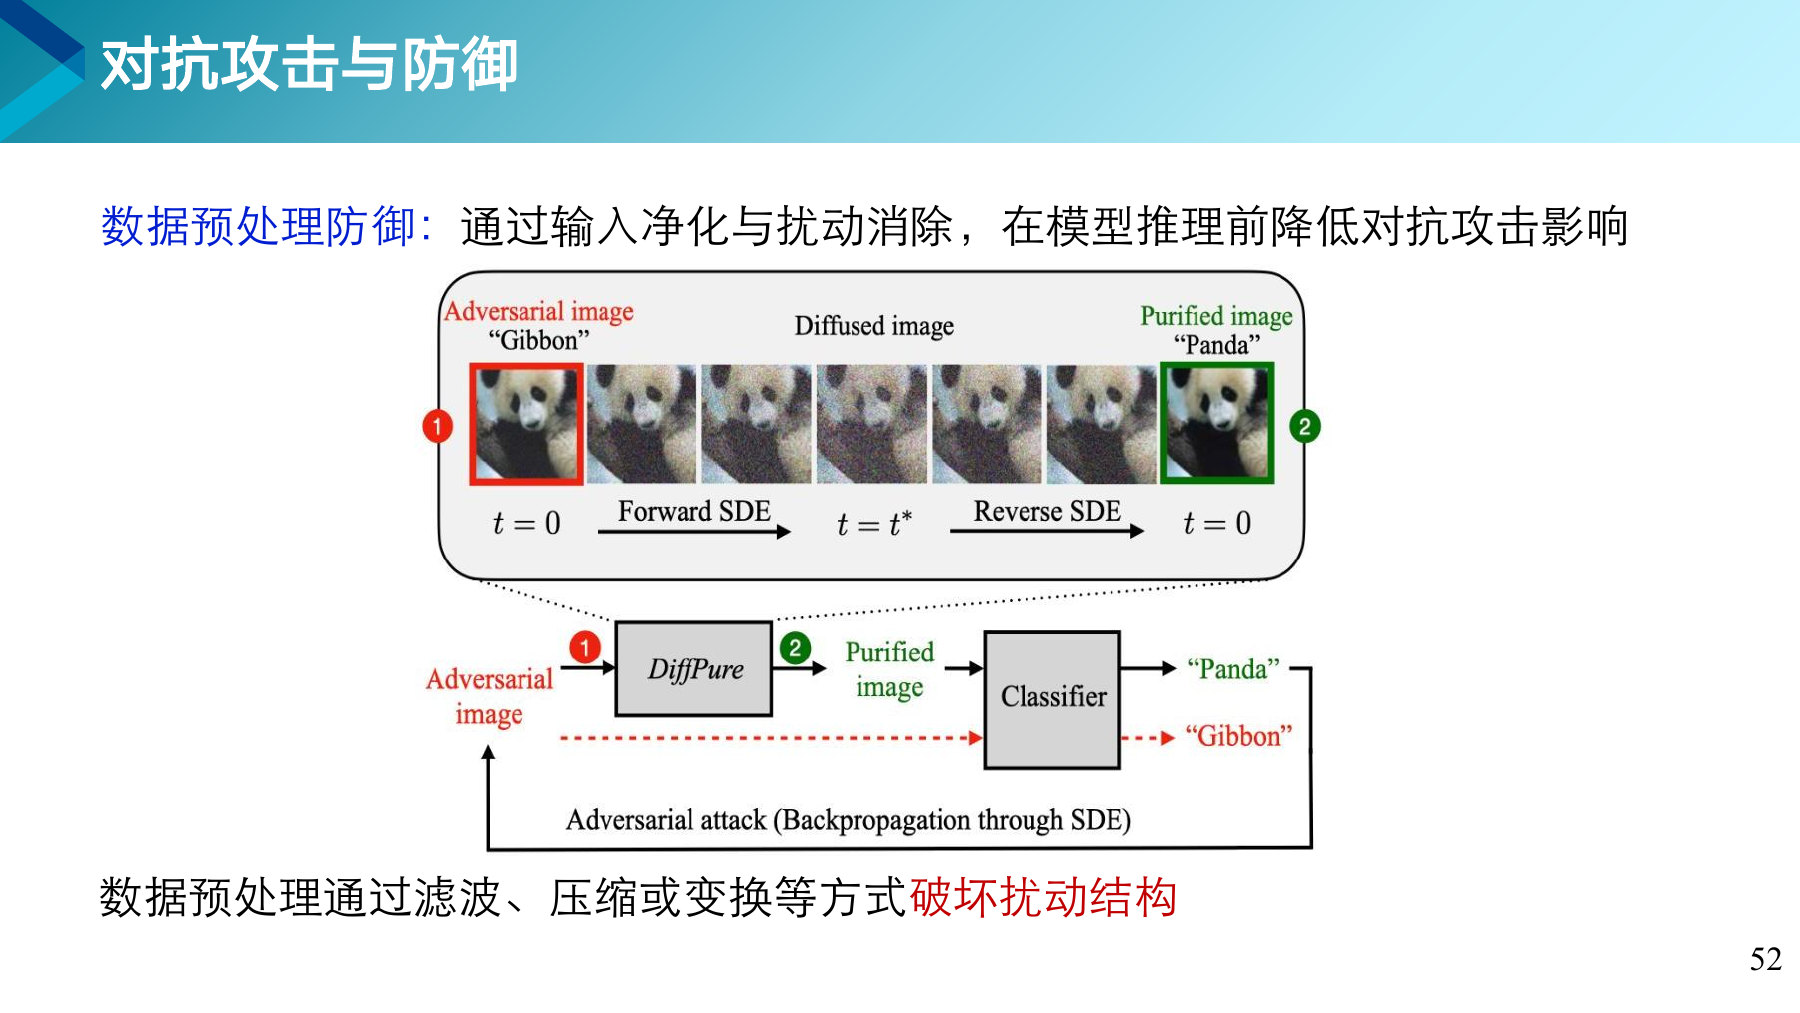
通过滤波、压缩或变换等方式破坏扰动结构。对抗扰动是精心设计出来的,结构很脆弱,稍微一动就失效了。
一张被攻击成长臂猿的熊猫图,先加噪声再去噪,走一遍扩散模型的正反向过程,出来之后模型就重新认对了。加噪那一步把攻击者的精心设计冲掉了,去噪那一步把图像本身的内容补了回来。
它不动模型,只处理输入,属于推理前的一道过滤。代价是图像本身也会有一点损失,所以要在洗得干净和留得清楚之间权衡。
把图片先模糊再还原,为什么攻击就失效了?
在训练阶段就引入攻击样本,从模型层面提升鲁棒性。
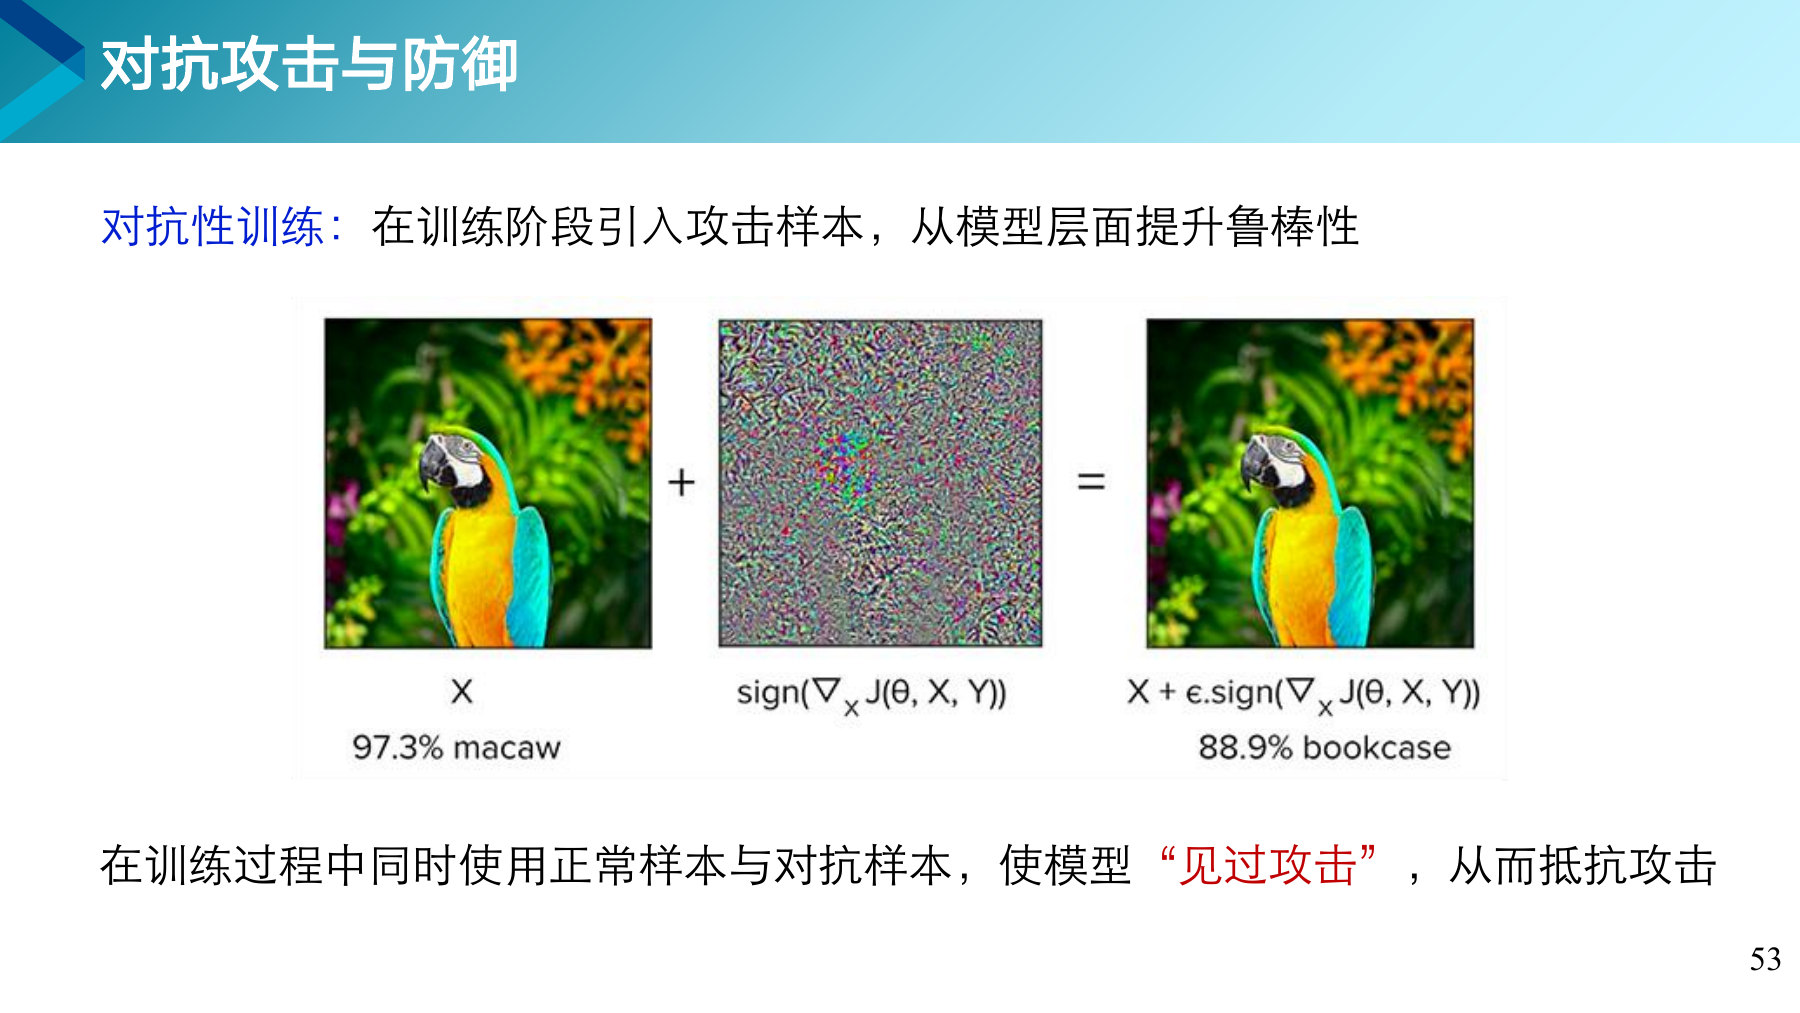
原图是金刚鹦鹉,模型给出 97.3% 的置信度。加上一层按梯度符号算出来的扰动之后,模型认成了书柜,置信度 88.9%。这就是第 49 页说的自信而错误。
它只取梯度的正负号,不管大小。意思是每个像素都往最能让模型出错的方向挪一小步,挪多远由前面那个小系数控制。这样加出来的扰动很小但很有效。
数据预处理是推理前洗输入,对抗训练是训练时练模型。前者治标见效快,后者治本代价高。实际系统里两者常常一起用。
训练时故意给模型看错的样本,为什么反而更强?
在模型运行阶段实时检测异常输入并触发防御机制。
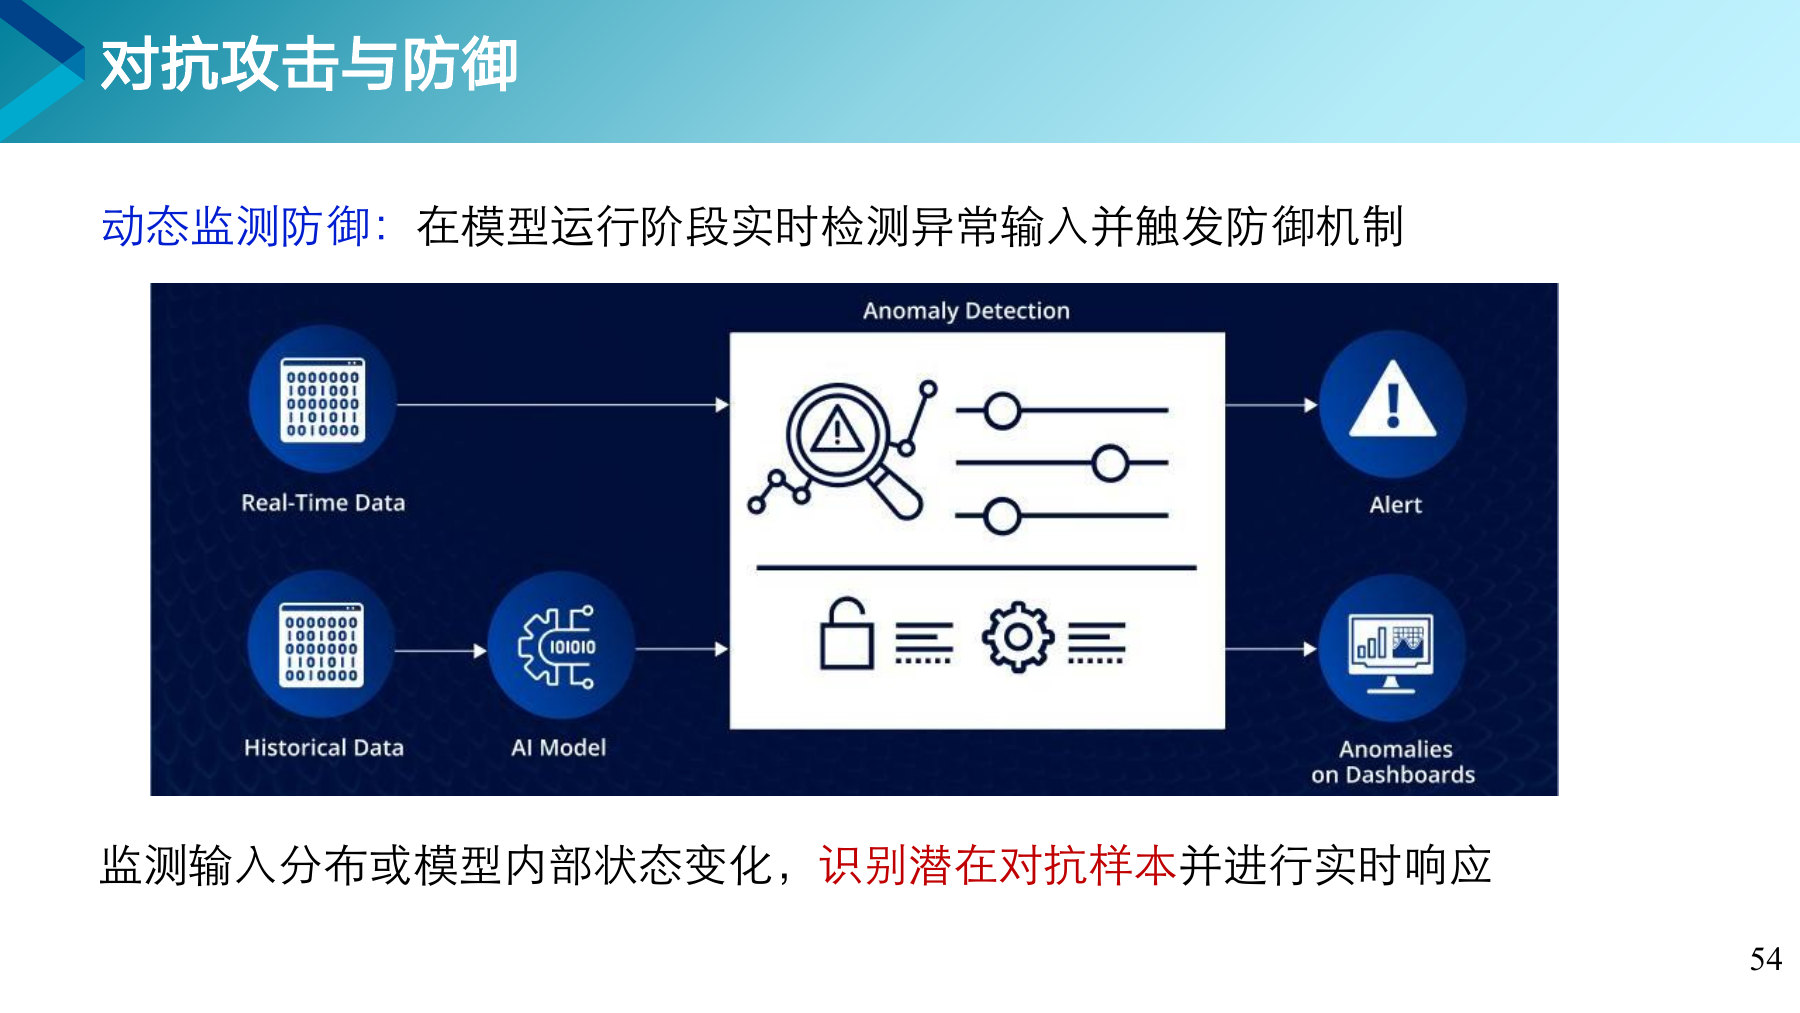
监测输入分布或模型内部状态的变化,识别潜在对抗样本并进行实时响应。前两种防御是事先准备,这一种是运行中的监控。
实时数据和历史数据一起进来,经过AI模型和异常检测模块,一路发出告警,一路把异常记录到看板上。这和第 7 章第 58 页讲的运行治理是同一套思路。
对抗训练是让模型自身更结实,数据预处理是在门口过滤,动态监测是在屋里巡逻。三道都不是万无一失,叠加起来才够用。
事先加固和事中监控,哪一种更适合已经上线的系统?