人工智能导论 第 5 章 · 第六节
课程 › 第 5 章 › 第六节 规模定律涌现能力MoE训练流程预训练指令微调RLHF提示与思维链RAG 与工具
第 5 章 人工智能生成内容与大模型 · 第六节

大模型的规模、训练与使用

为什么越做越大,怎样训出来,怎样用好
本 节 知 识 点
  1. 50规模定律:模型为什么越做越大
  2. 51涌现能力
  3. 52MoE:混合专家模型
  4. 53大模型训练的整体流程
  5. 54预训练:让模型学会语言
  6. 55指令微调:让模型听懂任务
  7. 56RLHF 与模型对齐
  8. 57提示工程与思维链
  9. 58RAG 与工具调用
50
第 5 章 · 第六节

规模定律:模型为什么越做越大

参数、数据、算力按比例一起加,效果就会稳步变好。

第 50 页 规模定律

训练一个模型要算多少次

训练计算量 ≈ 6 × 参数量 × 训练用的词元数
模型参数量训练词元(约)计算量(次运算)
Llama 3 8B80 亿15 万亿约 7.2 × 10²³
Llama 3 70B700 亿15 万亿约 6.3 × 10²⁴
Llama 3 405B4050 亿15.6 万亿约 3.8 × 10²⁵
参数翻一倍,或者数据翻一倍,计算量都跟着翻一倍。规模定律说的是:参数、数据、算力按合适的比例一起加大,模型的表现会按可以预测的方式稳步提升。
式子里的 6 是粗略估计:每个词元经过每个参数,算出结果大约要 2 次运算,回头调整参数大约还要 4 次。Llama 3 是 Meta 公司 2024 年开放的模型系列,名字里的 B 表示十亿(billion),8B 就是 80 亿个参数。词元数取自 Meta 公布的技术报告,报告中 405B 的计算量也是约 3.8 × 10²⁵ 次。

关键术语

规模定律Scaling Law
模型表现随参数量、数据量和算力的增加,按可预测的规律提升。
参数Parameter
模型里靠训练调出来的数,梯度下降调的就是它们。

知道更多钱要花在合适的地方

2022 年 DeepMind 的研究发现,算力一定时,模型不宜只做大而数据太少。按他们的估算,每个参数大约配 20 个训练词元比较合适。后来很多模型为了用起来更省,会用多得多的数据去训练较小的模型。

随堂练习

按左边的式子,一个模型的参数量不变,训练词元增加到原来的 3 倍,计算量变成原来的几倍?

  1. 1 倍
  2. 3 倍
  3. 6 倍
  4. 9 倍
查看答案
答案 B。计算量等于 6 × 参数量 × 词元数。参数量不变、词元数乘 3,计算量也乘 3。式子里的 6 是固定的系数,不会跟着变。
51
第 5 章 · 第六节

涌现能力

有些本事,模型要大到一定程度才突然显现。

第 51 页课件

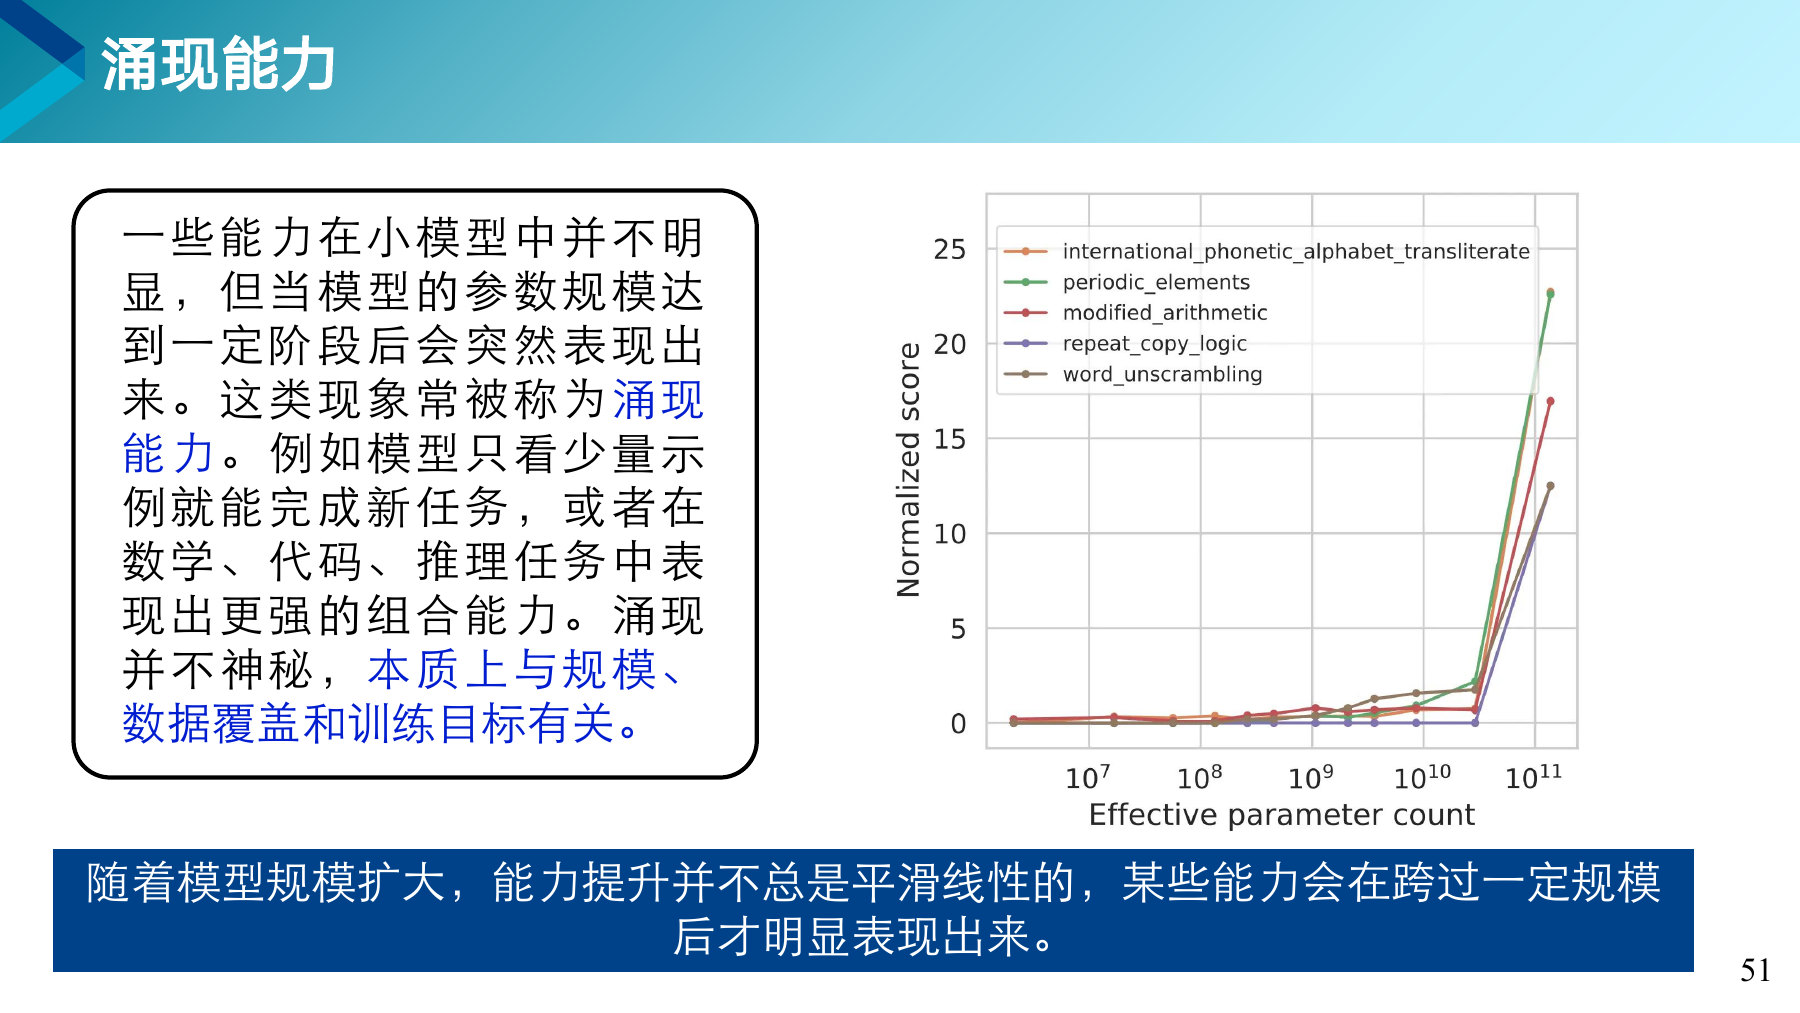
重 点看右图的曲线

横轴是模型的参数量,纵轴是在几项任务上的得分。参数从几百万增加到几百亿,得分一直贴着零。到了一千多亿,得分一下子跳到十几、二十几。

打个比方

冰从零下 20 度升到零下 1 度,一直是硬邦邦的冰。到了 0 度,冰开始化成水。热量是一点点加进去的,表现出来却是一下子的变化。

知道更多也有不同看法

2023 年有研究指出,这种“突然”部分来自打分方式。比如一道题要 10 个数字全写对才得分,全对的机会是每个数字的把握连乘 10 次。把握从 50% 升到 70%,全对的机会只从约 0.1% 升到约 3%,看着一直贴着零。把握升到 95%,全对的机会一下子到了约 60%。

52
第 5 章 · 第六节

MoE:混合专家模型

模型里有很多位专家,每个词只请其中几位来算。

第 52 页 MoE:混合专家模型

以 Mixtral 为例:每个词元只叫醒两位专家

“猫”一个词元路由器给 8 位专家打分专家 1专家 2权重 0.7专家 3专家 4专家 5权重 0.3专家 6专家 7专家 8按权重合起来,得到输出其余 6 位这次休息
模型总参数每个词元实际用到
Mixtral 8x7B约 470 亿约 130 亿
DeepSeek-V36710 亿370 亿
总参数很大,能学到的东西多。每次只算一小部分,速度和成本又能控制住。
Mixtral 8x7B 每层有 8 位专家,每个词元选 2 位,图中的例子就按这个设置画。DeepSeek-V3 每层有 256 位专家,每个词元选 8 位,另外还有 1 位每个词元都要用的共享专家。

关键术语

混合专家Mixture of Experts, MoE
模型里有多个专家子网络,每次只让其中少数几个参与计算。
路由器Router
给各位专家打分、决定这个词元交给谁处理的小网络。
密集模型Dense Model
每次都用上全部参数的普通模型,没有专家分工。

打个比方

大医院有几十个科室,病人再多,也不会让所有医生一起会诊。分诊台看一眼病情,把你分到最对口的一两个科室。医院整体规模很大,你这一次看病只用到了一小部分医生。

随堂练习

按左边的表,DeepSeek-V3 处理一个词元时,实际用到的参数大约占总参数的多少?

  1. 约 5%
  2. 约 25%
  3. 约 50%
  4. 100%
查看答案
答案 A。370 亿 ÷ 6710 亿 ≈ 0.055,也就是约 5%。其余 95% 左右的参数这一次都在休息,混合专家就是这样省下算力的。
53
第 5 章 · 第六节

大模型训练的整体流程

先学会接话,再学会听懂要求,最后学会答得得体。

第 53 页 大模型训练的整体流程

三个阶段,各补一样本事

预训练读海量文字,
学会接话
→
指令微调看大量问答示范,
学会听懂要求
→
对齐按人的评价调整,
学会答得得体
训练到哪一步问它“帮我写一句给妈妈的生日祝福”
只做完预训练可能把这句话当成文章开头,接着编出一串类似的句子,比如“帮我写一句给爸爸的生日祝福”
做完指令微调能按要求写出一句祝福
做完对齐写得更贴心、长短合适。遇到有害的请求,会礼貌地拒绝
第 54 到第 56 页分别讲这三个阶段。

重 点为什么不能一步到位

预训练用的是网上海量的普通文字,里面很少有“有人提问、有人认真回答”的格式,所以预训练完的模型只会接话。听懂要求、答得得体,要靠后面两个阶段专门教。

打个比方

这像培养一名医生。先读很多年书,掌握医学知识。再到医院实习,学会按病人的需要办事。最后在前辈的点评中,学会说话有分寸,知道什么不该做。

54
第 5 章 · 第六节

预训练:让模型学会语言

用海量文字练习猜下一个词,顺带学会语法和常识。

第 54 页课件

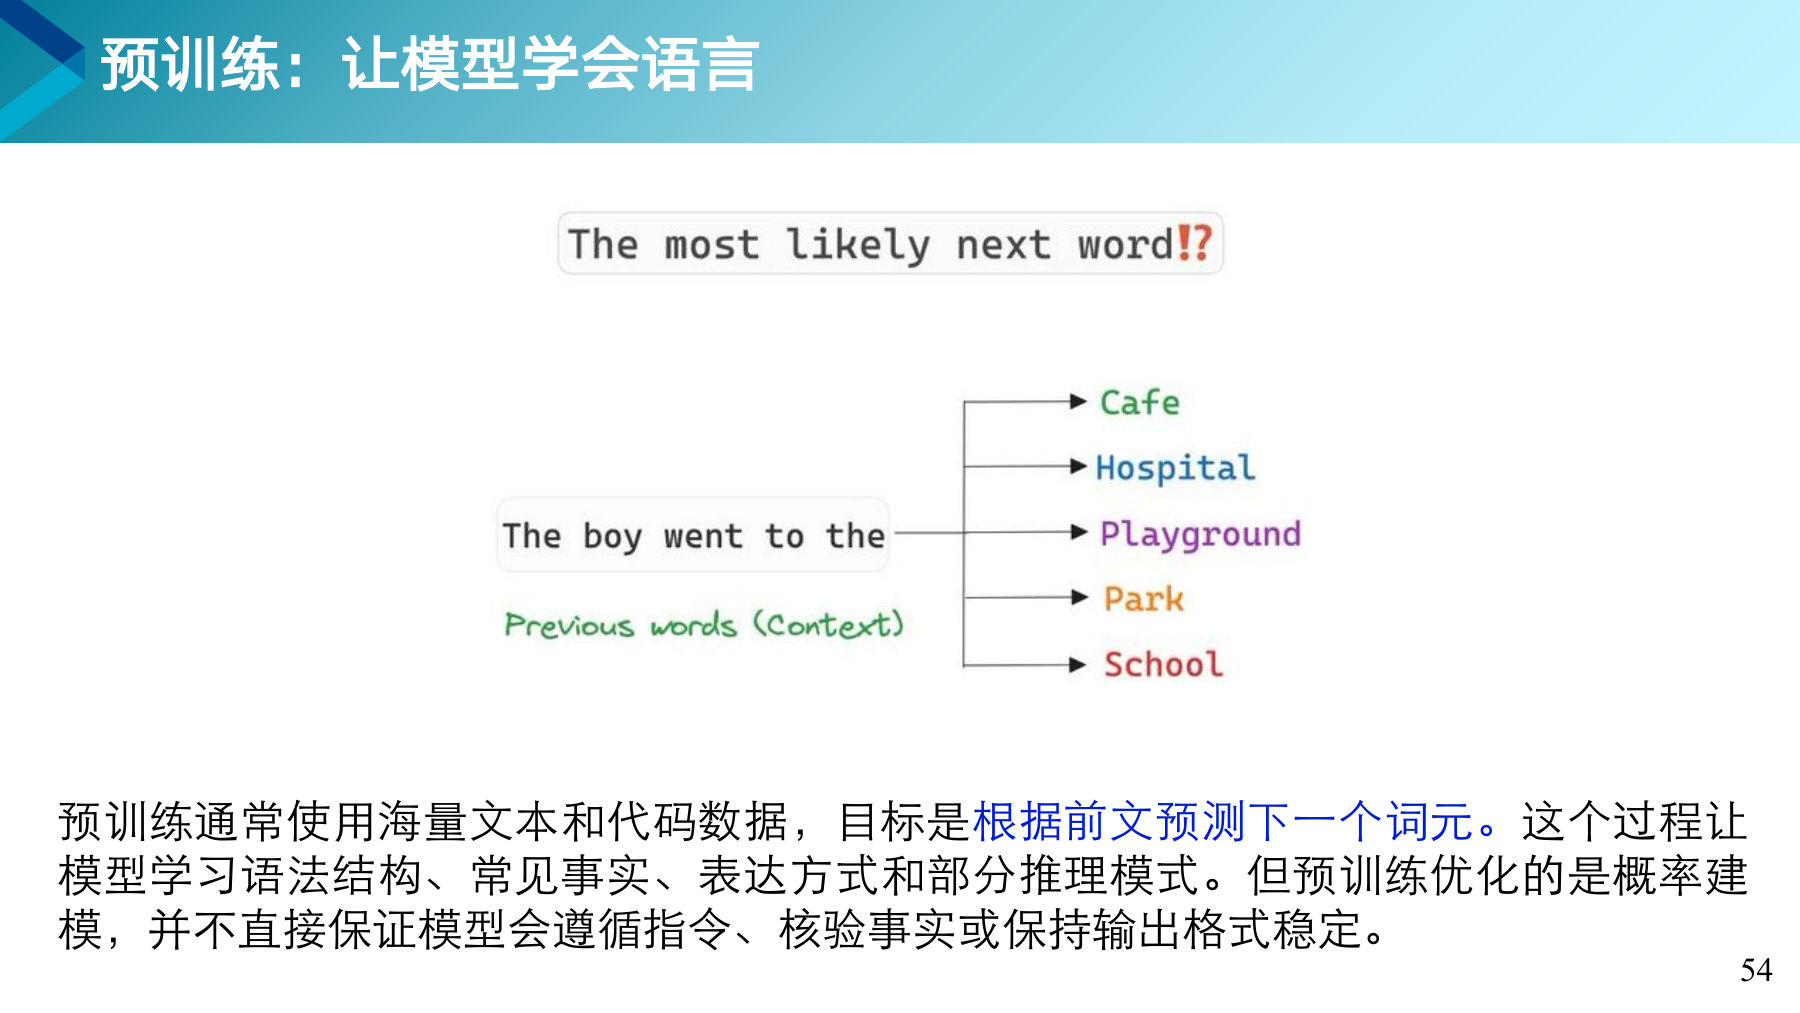
重 点看图中的例子

“The boy went to the”(男孩去了……)后面,接咖啡馆、医院、操场、公园、学校都说得通。模型给每个候选打一个可能性,见得越多,打得越准。为了猜得准,它顺带学会了语法和常见的事实。

打个比方

孩子天天听大人说话,没人专门教他语法,他也慢慢知道一句话该怎么往下接。

知道更多不用人来标注

预训练的“答案”就是文章里真实的下一个词,不需要人一条条去标。第 4 章讲过的自监督学习,就是这样让数据自己给自己出题。

55
第 5 章 · 第六节

指令微调:让模型听懂任务

用成千上万条“要求加示范回答”,教它按要求办事。

第 55 页 指令微调:让模型听懂任务

一条指令微调样本长什么样

部分例子
指令把下面这句话翻译成英文。
材料今天很冷,记得多穿点衣服。
示范回答It is cold today, so remember to dress warmly.

样本里还常有这几种内容:

  • 角色设定 “你是一位耐心的小学数学老师。”
  • 格式要求 “用三条列表回答,每条不超过二十字。”
  • 拒答示范 遇到危险的请求,示范怎样礼貌地拒绝。
样本要覆盖各种任务,写得准确。精挑细选的少量样本,往往比大量重复雷同的样本更管用。

关键术语

指令微调Instruction Tuning
在基座模型上,用“指令和示范回答”配对的数据继续训练。
基座模型Base Model
只做过预训练、还没学会听指令的模型。

打个比方

这像新员工入职培训。专业本事早就有了,培训教的是公司交代事情的说法、成果交付的格式,还有哪些事不能做。

知道更多少而精的例子

2023 年 Meta 的研究人员只用 1000 条精心挑选的样本做指令微调,得到的模型回答质量已经相当不错。这项研究叫 LIMA,意思是“对齐时少即是多”。

56
第 5 章 · 第六节

RLHF 与模型对齐

让人挑出更好的回答,训练一个打分员,再照着分数调整。

第 56 页 RLHF 与模型对齐

让人来挑,训练一个打分员

  1. 出两个回答 同一个问题,让模型写出回答 A 和回答 B。
  2. 人来挑 标注员选出更好的那个。这样的比较要收集成千上万条。
  3. 训练打分员 用这些比较训练一个奖励模型,让它学会给回答打分,人喜欢的得分高。
  4. 强化学习 模型写回答,奖励模型打分,按分数调整模型,得分高的写法越来越常出现。
调整时还要拴一根“绳子”:新模型不能离原来的模型太远。否则它可能学会一些专门讨好打分员、却不像人话的写法。

关键术语

基于人类反馈的强化学习Reinforcement Learning from Human Feedback, RLHF
用人的偏好训练奖励模型,再用强化学习让模型朝人喜欢的方向调整。
对齐Alignment
让模型的行为符合人的期望和安全规范。

重 点和第 3 章的强化学习对上

模型是智能体,写一段回答是一次动作,奖励模型给的分数就是奖励。第 3 章提到的 PPO 算法,常用在第 4 步。

随堂练习

RLHF 里,“人来挑”这一步产出的是什么?

  1. 更多的训练文章
  2. 模型的新参数
  3. 一本标准答案
  4. 两个回答中哪个更好的比较结果
查看答案
答案 D。标注员只需要比较两个回答、选出更好的一个。这些比较结果用来训练奖励模型,模型的参数要到第 4 步才改。
57
第 5 章 · 第六节

提示工程与思维链

把任务交代清楚,再让模型把推理步骤写出来。

第 57 页 提示工程与思维链

交代清楚,再让它一步步想

要素例子
角色你是一位高中数学老师
目标给学生讲清一道排列题
材料5 人排成一排拍照,甲不能站两端,乙丙必须相邻,有几种排法
约束只用高中学过的方法,不超过 200 字
输出格式先分步骤写,最后单独一行写答案

思维链 模型先把推理过程写出来:

  • 把乙丙捆成一个整体,和甲、丁、戊一起排,有 4 × 3 × 2 × 1 = 24 种,乙丙内部还能换位,共 48 种。
  • 去掉甲站两端的:甲在左端时有 3 × 2 × 1 × 2 = 12 种,在右端也是 12 种,两端合计 12 + 12 = 24 种。
  • 48 − 24 = 24,所以一共有 24 种排法。

关键术语

提示工程Prompt Engineering
研究怎样写输入给模型的话,让它更准确地完成任务。
思维链Chain of Thought
让模型先写出一步步的推理过程,再给出结论。

重 点写出步骤的好处

每一步都写在纸面上,人可以一步步检查。步骤写得漂亮,不等于每一步都对,重要的事情仍要查资料或用工具核实。

想一想

为什么让模型先写出步骤,答对的机会往往会变高?

查看参考思路
大语言模型是一个词一个词往下写的。直接写答案,相当于要它一步心算出结果。先写出步骤,后面每写一个词都能参考前面写好的中间结果,一道难题就被拆成了几道容易的小题。
58
第 5 章 · 第六节

RAG 与工具调用

记不住就去查资料,算不了就调用工具。

第 58 页 RAG 与工具调用

记不住就去查,算不了就用工具

检索增强生成 假设学校的《图书馆开放时间》里写着“周六、周日 9:00 开馆”。

提问图书馆周末
几点开门?
→
检索在学校文件里
找到相关段落
→
交给模型问题 +
找到的段落
→
回答周末 9 点开门,
并注明出处

工具调用

提问23 × 47 等于多少?
→
调用计算器模型写出算式,
交给计算器去算
→
回答等于 1081
有了这两招,模型从只会凭记忆写字,变成了会查资料、会用工具的助手。下一章的智能体就建立在这个基础上。

关键术语

检索增强生成Retrieval-Augmented Generation, RAG
先从资料库里检索相关内容,再让模型依据这些内容回答。
向量库Vector Database
把每段文字变成一串数存起来。意思相近的文字,数也相近,方便按意思查找。

打个比方

闭卷考试全凭记忆,记错了自己也不知道。开卷考试可以把资料摊在桌上,答案有出处,还能翻回去核对。RAG 把大模型的闭卷考改成了开卷考。

随堂练习

RAG 能减少模型编造答案,主要原因是什么?

  1. 模型的参数变多了
  2. 回答变得更短了
  3. 回答时有检索到的资料作依据
  4. 用户问得更清楚了
查看答案
答案 C。RAG 在回答之前先查资料,模型依据找到的内容作答,还能注明出处。模型的参数和回答的长短都没有变。
保山学院·人工智能教研室·曹鼎鼎