人工智能导论 第 5 章 · 第五节
课程 › 第 5 章 › 第五节 为何自回归大语言模型传话与开会自注意力Q、K、V多头与位置三种搭法仅编码器仅解码器编码器解码器
第 5 章 人工智能生成内容与大模型 · 第五节

Transformer 与注意力机制

大语言模型的地基:每个词都看其他词
本 节 知 识 点
  1. 39文字为什么走向自回归
  2. 41大语言模型的基本概念
  3. 42从序列模型到 Transformer
  4. 43自注意力的直观理解
  5. 44Q、K、V 与注意力权重
  6. 45多头注意力与位置编码
  7. 46三类 Transformer 架构
  8. 47仅编码器架构:理解优先
  9. 48仅解码器架构:生成优先
  10. 49编码器-解码器架构:转换优先
39
第 5 章 · 第五节

文字为什么走向自回归

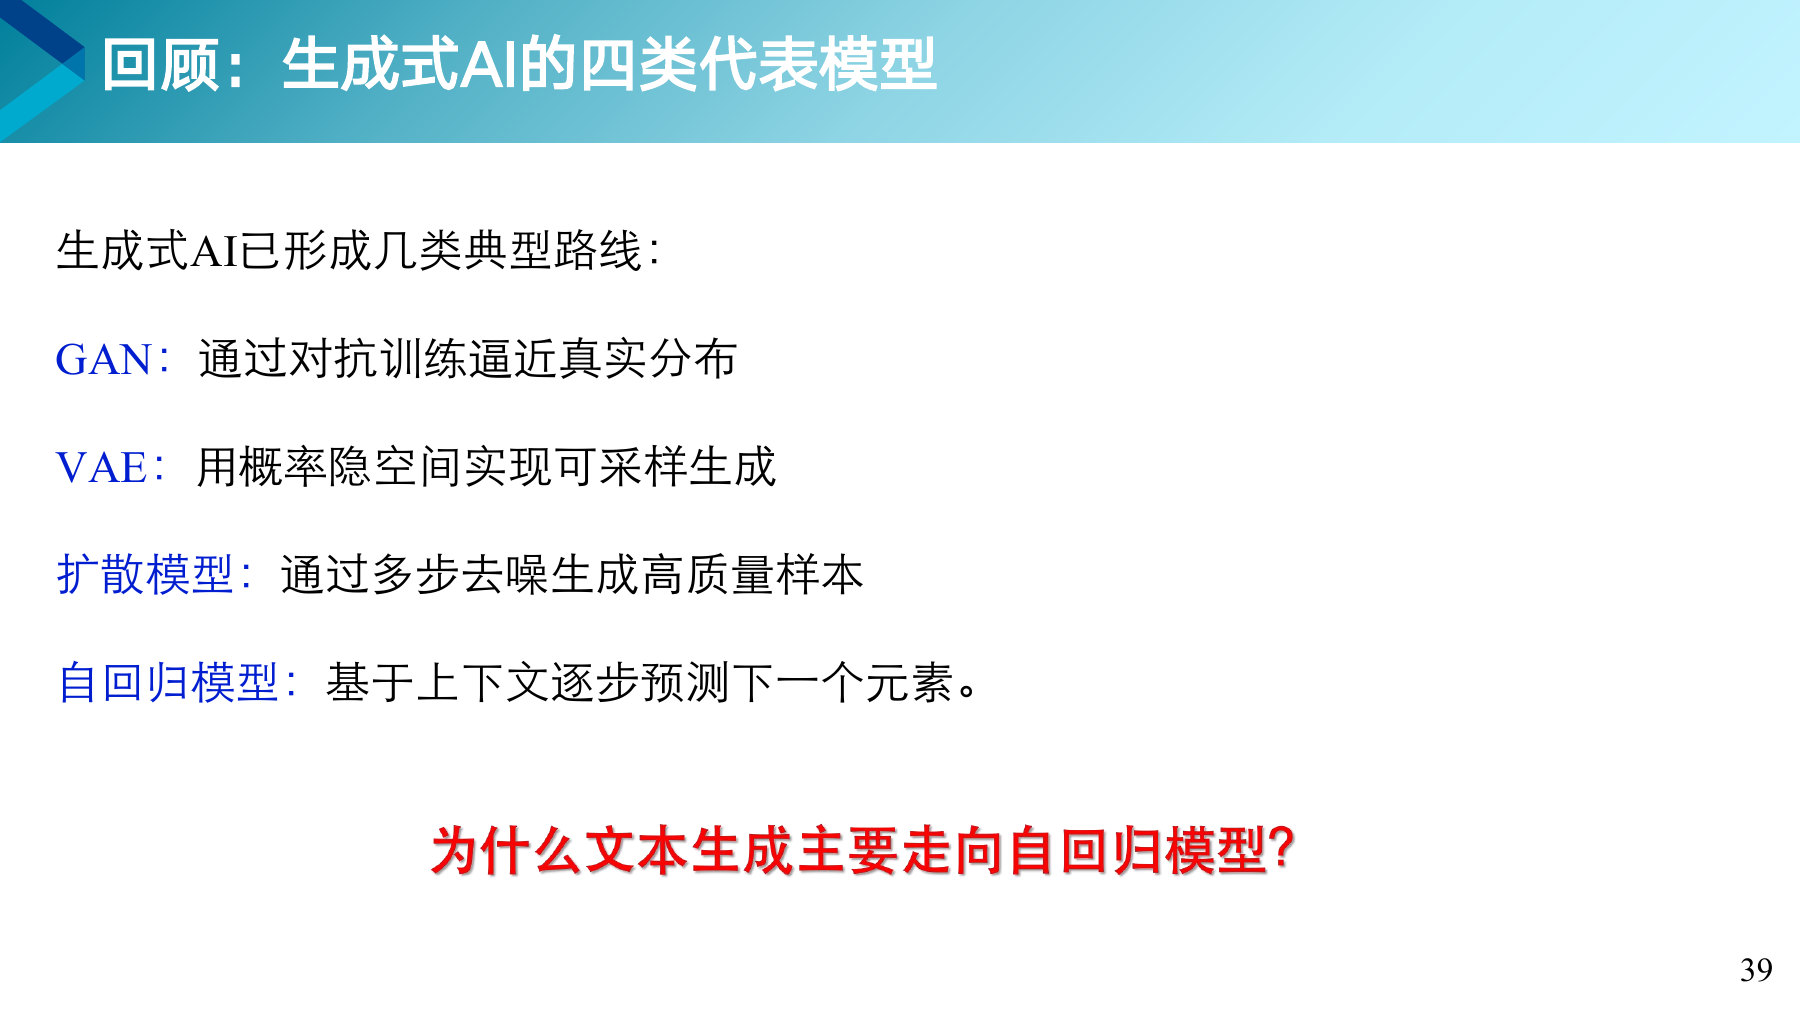
文字天生就是一个字接一个字的序列。
第 39 页课件

重 点回答那个问题

一句话本来就是从前往后一个字一个字说出来的,按顺序预测下一个字,和语言的样子天然贴合。图片的像素没有天然的先后,所以画图更常用扩散模型,从整体上一遍遍变清楚。

打个比方

写文章是一个字一个字往下写,画画往往先起草稿,再铺颜色,最后抠细节。两种创作的过程不同,适合它们的生成方法也不同。

41
第 5 章 · 第五节

大语言模型的基本概念

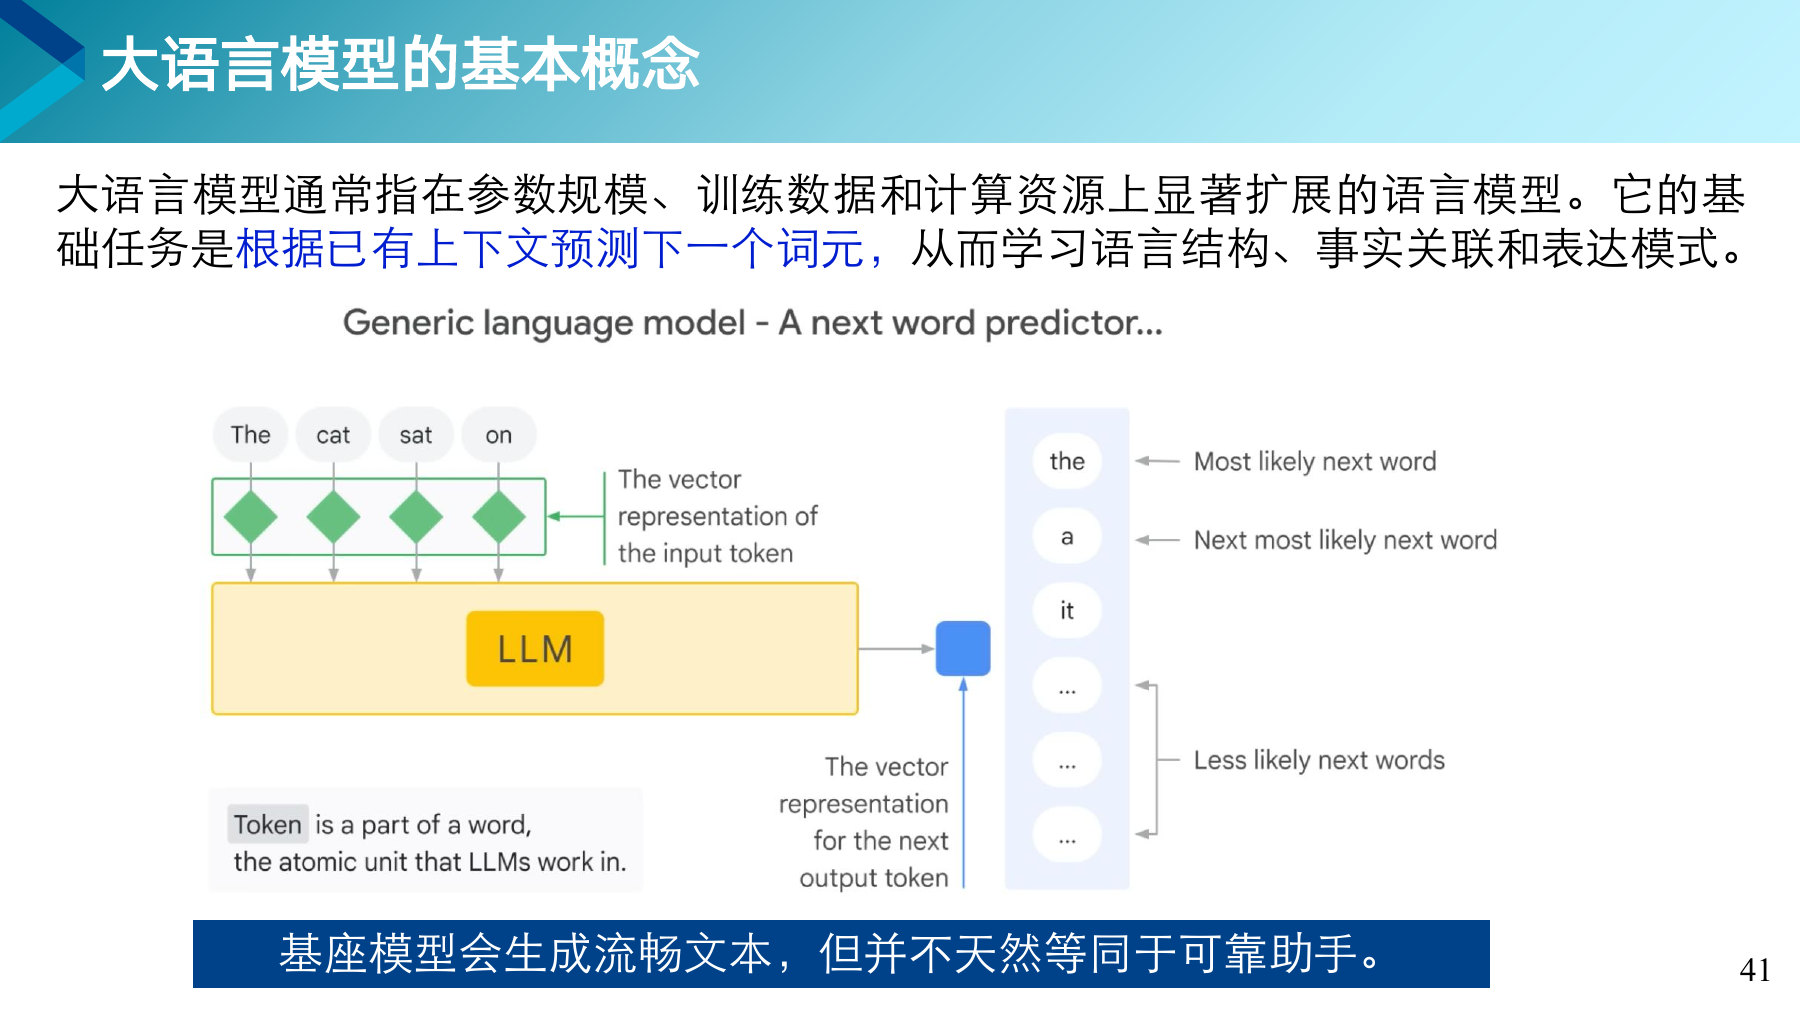
它做的只有一件事:根据前文,猜下一个词元。

第 41 页课件

关键术语

大语言模型Large Language Model, LLM
参数多、训练数据多、耗费算力多的语言模型,比如 ChatGPT、DeepSeek、通义千问背后的模型。

重 点看图中的例子

输入“The cat sat on”(猫坐在……上),模型给每个候选词一个可能性,“the”最高,“a”其次。换成中文也一样,输入“床前明月”,下一个字是“光”的可能性最高。

知道更多会接话不等于会帮忙

只学过猜下一个词的模型叫基座模型。它能写出流畅的句子,却不一定听得懂要求,也可能一本正经地编造。第六节会讲怎样把它训练成可靠的助手。

42
第 5 章 · 第五节

从序列模型到 Transformer

任意两个词直接相连,读进来的词还能同时计算。

第 42 页 从序列模型到 Transformer

传话与开会

RNN:一站一站往后传我把苹果放在桌子上它很圆“苹果”的信息要经过 3 次传递才到“它”,越传越淡Transformer:任意两个词直接相连我把苹果放在桌子上它很圆“它”一步就能看到“苹果”,读进来的词可以同时计算
RNN 这类老方法

按顺序一个词一个词地算,前一个没算完,后一个只能等。隔得远的两个词,信息传到后面已经变淡了。

Transformer

读进来的词可以同时计算,任意两个词之间一步直达。它靠注意力建立词与词的联系,再用位置编码记住先后顺序。

位置编码怎样补上词序,第 45 页会细讲。写回答时为什么仍要一个词一个词地写,见第 48 页。

关键术语

循环神经网络Recurrent Neural Network, RNN
按顺序逐个读入词语、把信息一站站往后传的网络。LSTM 和 GRU 是它的两种改进版。
Transformer 架构Transformer
2017 年由谷歌的研究人员提出的网络结构,今天的大语言模型几乎都建立在它上面。

打个比方

RNN 像传话游戏,第一个人说的话传到第十个人时已经走样,还必须一个一个排队传。Transformer 像围着圆桌开会,谁想跟谁说话就直接说,大家还能同时发言。

43
第 5 章 · 第五节

自注意力的直观理解

每个词都给别的词打分,按权重把信息汇到自己身上。

第 43 页 自注意力的直观理解

“我把苹果放在桌子上,它很圆”,“它”指谁?

9%24%67%我把苹果放在桌子上,它很圆“它”在打分权重
“它”先给每个词打分,再把分数换成加起来等于 100% 的权重,权重越大,连线越粗。“苹果”分到 67%,“它”身上的信息大部分从“苹果”那里取来,于是模型明白“它”说的是苹果。
为了好算,图中只让“它”在三个词之间分配权重。实际上每个词都会给句子里所有的词打分,包括它自己。仅解码器模型只给前面的词打分,第 48 页会讲。

关键术语

自注意力Self-Attention
一句话里的每个词都去看同一句话里的其他词,按相关程度汇集信息。

重 点为什么能认出是苹果

苹果和桌子都出现在前面,让天平倒向苹果的是后面的“很圆”。苹果是圆的,桌子一般不是。模型要同时看到“它”“苹果”“桌子”“圆”,任意两个词之间都要能直接联系。

打个比方

开会时听到“这件事交给他办”,你会回想刚才提到的几个人里,谁最可能是“他”。自注意力做的就是这种回头找人。

44
第 5 章 · 第五节

Q、K、V 与注意力权重

拿“想找什么”去对“能提供什么”,算出权重再汇总。

第 44 页 Q、K、V 与注意力权重

上一页的 67% 是怎么算出来的

给每个词两个特征:是不是一样东西,是不是圆的。是记 1,不是记 0。“它”后面跟着“很圆”,所以它要找的是“一样圆的东西”,查询 Q = (1, 1)。

词键 K和 Q 对一对分数权重
苹果(1, 1)1×1 + 1×120.67
桌子(1, 0)1×1 + 1×010.24
放(0, 0)1×0 + 1×000.09

分数怎样换成权重 用的是 Softmax:分数为 0 的记作 1,分数每高 1 分就再乘 2.72,三个词得到 7.40、2.72、1。加起来是 11.12,各自除以 11.12,就是 0.67、0.24、0.09。

“它”的新内容 = 0.67 × 苹果的值 V + 0.24 × 桌子的值 V + 0.09 × 放的值 V
Q 查询

我想找什么

K 键

我能提供什么线索

V 值

最后被汇总的内容

真实模型里的 Q、K、V 各有几十到几百个数,都是训练出来的,这里只用了两个。算分数时还会除以一个固定的数,防止分数太大,这里省略了。

关键术语

查询、键、值Query、Key、Value
每个词都会算出这三样东西,分别用 Q、K、V 表示。
归一化指数函数Softmax
把一组分数换算成加起来等于 1 的权重,分数越高,占的比例越大。

打个比方

Q、K、V 像在图书馆查资料。心里的问题是查询 Q,每本书的书名和目录是键 K,书里的正文是值 V。拿问题去对目录,越对得上的书,从里面摘抄的内容越多。

随堂练习

如果“桌子”的键也变成 (1, 1),和“苹果”一样,那么“它”分给苹果和桌子的权重会怎样?

  1. 苹果更多
  2. 桌子更多
  3. 两者一样多
  4. 都变成 0
查看答案
答案 C。两个词的键相同,和 Q 对出来的分数都是 2,换算成的权重也就一样多。这时模型分不清“它”指谁,需要更多线索。
45
第 5 章 · 第五节

多头注意力与位置编码

几个头各看一种关系,位置编号补上词的先后。

第 45 页 多头注意力与位置编码

几个头各看一方面,再加上位置编号

多头注意力 同一句话,同时交给几组注意力去算,每组叫一个“头”。

第 1 个头

专看指代:“它”指向“苹果”。

第 2 个头

专看动作和对象:“放”连着“苹果”和“桌子”。

第 3 个头

专看左右邻居:“很”连着“圆”。

位置编码 注意力本身不管词的先后。给每个字加上“第几位”的记号,顺序才分得清。

第 1 位第 2 位第 3 位
我爱你我爱你
你爱我你爱我
每个头看什么,是训练中自己学出来的,上面的分工只是举例。

关键术语

多头注意力Multi-Head Attention
同时用几组注意力,各自关注不同的关系,最后把结果拼起来。
位置编码Positional Encoding
给每个词加上表示位置的信息,让模型知道谁在前、谁在后。

打个比方

多头注意力像医生会诊。内科医生看化验单,外科医生看片子,营养师问饮食,各看一面,合起来才是完整的判断。

随堂练习

如果去掉位置编码,模型最可能分不清下面哪一对句子?

  1. “我爱你”和“你爱我”
  2. “我爱你”和“我恨你”
  3. “今天晴”和“明天雨”
  4. “猫”和“狗”
查看答案
答案 A。A 的两句话用的字完全相同,只是顺序不同,没有位置信息就分不开。其余几对用的字本来就不一样,不靠位置也能分清。
46
第 5 章 · 第五节

三类 Transformer 架构

同样的注意力积木,三种搭法,擅长的事各不相同。

第 46 页 三类 Transformer 架构

同一种积木,三种搭法

搭法每个词能看到哪里擅长代表模型
仅编码器前后都能看理解:分类、检索、找关键信息BERT
仅解码器只能看前面生成:对话、写作、写代码GPT、Llama
编码器-解码器先读完输入,再逐词写输出转换:翻译、摘要、改写T5
编码器负责读懂,解码器负责写出来。只要读懂就用前者,要写就用后者,要“读完再写”就两个都用。
后面三页分别细讲这三种搭法。

重 点分清这三类有什么用

看到一个模型的名字,先弄清它是哪种搭法,就大致知道它擅长做什么。BERT 适合做判断和检索,GPT 适合写,T5 适合把一段文字转换成另一段。

打个比方

同样一堆砖,可以砌成围墙、烟囱或拱门。材料一样,结构不同,用途就不同。

知道更多三个名字的年份

BERT 和第一代 GPT 都出现在 2018 年,前者来自谷歌,后者来自 OpenAI。T5 由谷歌在 2019 年提出。

47
第 5 章 · 第五节

仅编码器架构:理解优先

靠做完形填空练出来,前后文都看,擅长读懂。

第 47 页 仅编码器架构:理解优先

做完形填空,前后都看

今天天气很遮住,适合出去玩看前面也看后面模型猜:好
训练时随机遮住一部分词,让模型根据前后文把它们猜回来,这叫掩码语言建模。BERT 每次大约遮住 15% 的词。
擅长

判断一条评论是好评还是差评,从文章里找出人名地名,按意思搜索相似的句子。

不擅长

续写。它习惯了前后都能看到,可是写到一半时,后面的内容还不存在。

关键术语

BERTBidirectional Encoder Representations from Transformers
谷歌 2018 年提出的仅编码器模型,名字里的 Bidirectional 意思是“双向”。
掩码语言建模Masked Language Modeling
遮住句子里的部分词,让模型根据上下文猜出来。第 4 章讲过的掩码学习就是这种办法。

打个比方

像一位精读的读者。给他一段话,他能说出意思、情绪、提到了谁。让他接着往下写,就不是他的强项了。

48
第 5 章 · 第五节

仅解码器架构:生成优先

从左往右接龙,每一步只看前面,是今天大模型的主流。

第 48 页 仅解码器架构:生成优先

从左往右接龙,只看前面

床第 1 步猜“前”床前第 2 步猜“明”床前明第 3 步猜“月”床前明月第 4 步猜“光”床前明月光第 5 步猜“,”涂色的格子:这一步能看到的字
训练时,每个位置只许看它前面的字,去猜下一个字。用的时候也一样,一个字一个字往后写。训练和使用的条件完全一致。
GPT、Llama、通义千问(Qwen)、DeepSeek 等常见的大语言模型,大多是这种结构。

关键术语

因果语言建模Causal Language Modeling
只根据前文预测下一个词的训练方式。“因果”指只能由前面决定后面。

重 点为什么不让它偷看后文

如果训练时能看到后文,模型会学着“抄”后面的答案。到了使用的时候,后文还没写出来,它就不会了。所以训练时要把后面的字遮住。

随堂练习

按左图,第 3 步时模型能看到哪几个字?

  1. 只有“明”
  2. “床”“前”“明”
  3. 全部五个字
  4. “月”“光”
查看答案
答案 B。第 3 行涂色的格子是“床”“前”“明”,模型根据这三个字去猜下一个字“月”。后面的“月”“光”这时还看不到。
49
第 5 章 · 第五节

编码器-解码器架构:转换优先

先把输入完整读懂,再一个词一个词写出结果。

第 49 页 编码器-解码器架构:转换优先

先读懂,再写出来

输入我爱北京
→
编码器把整句读完,
前后都能看
→
解码器一个词一个词写,
随时回头看原句
→
输出I love Beijing
解码器每写一个词,都通过交叉注意力回头看编码器读出的内容。写到“love”时,它主要看的是“爱”。
搭法像什么
仅编码器理解器:读懂一段话
仅解码器续写器:接着往下写
编码器-解码器转换器:把一段话变成另一段

关键术语

交叉注意力Cross-Attention
解码器去看编码器输出的注意力,Q 来自解码器,K 和 V 来自编码器。
T5Text-to-Text Transfer Transformer
谷歌 2019 年提出的编码器-解码器模型,把各种任务都当成“输入一段文字,输出一段文字”。

打个比方

同声传译先听完一句中文,在脑子里形成意思,再用英文说出来。听和说是两个环节,中间隔着一层理解。

保山学院·人工智能教研室·曹鼎鼎