第 5 章 · 第七节
多模态大模型
前面讲的模型只读文字,接下来让模型能看、能听。
重 点什么是模态
信息的一种形式叫一种模态。文字、图片、声音、视频各是一种模态。能同时处理好几种形式的模型,叫多模态模型。
知道更多四个部分与八节
原课件分四个部分,本网站拆成八节,第四部分就是第七、八节。
前面讲的模型只读文字,接下来让模型能看、能听。
信息的一种形式叫一种模态。文字、图片、声音、视频各是一种模态。能同时处理好几种形式的模型,叫多模态模型。
原课件分四个部分,本网站拆成八节,第四部分就是第七、八节。
以语言模型为中心,把图片、声音都翻译成它能懂的形式。
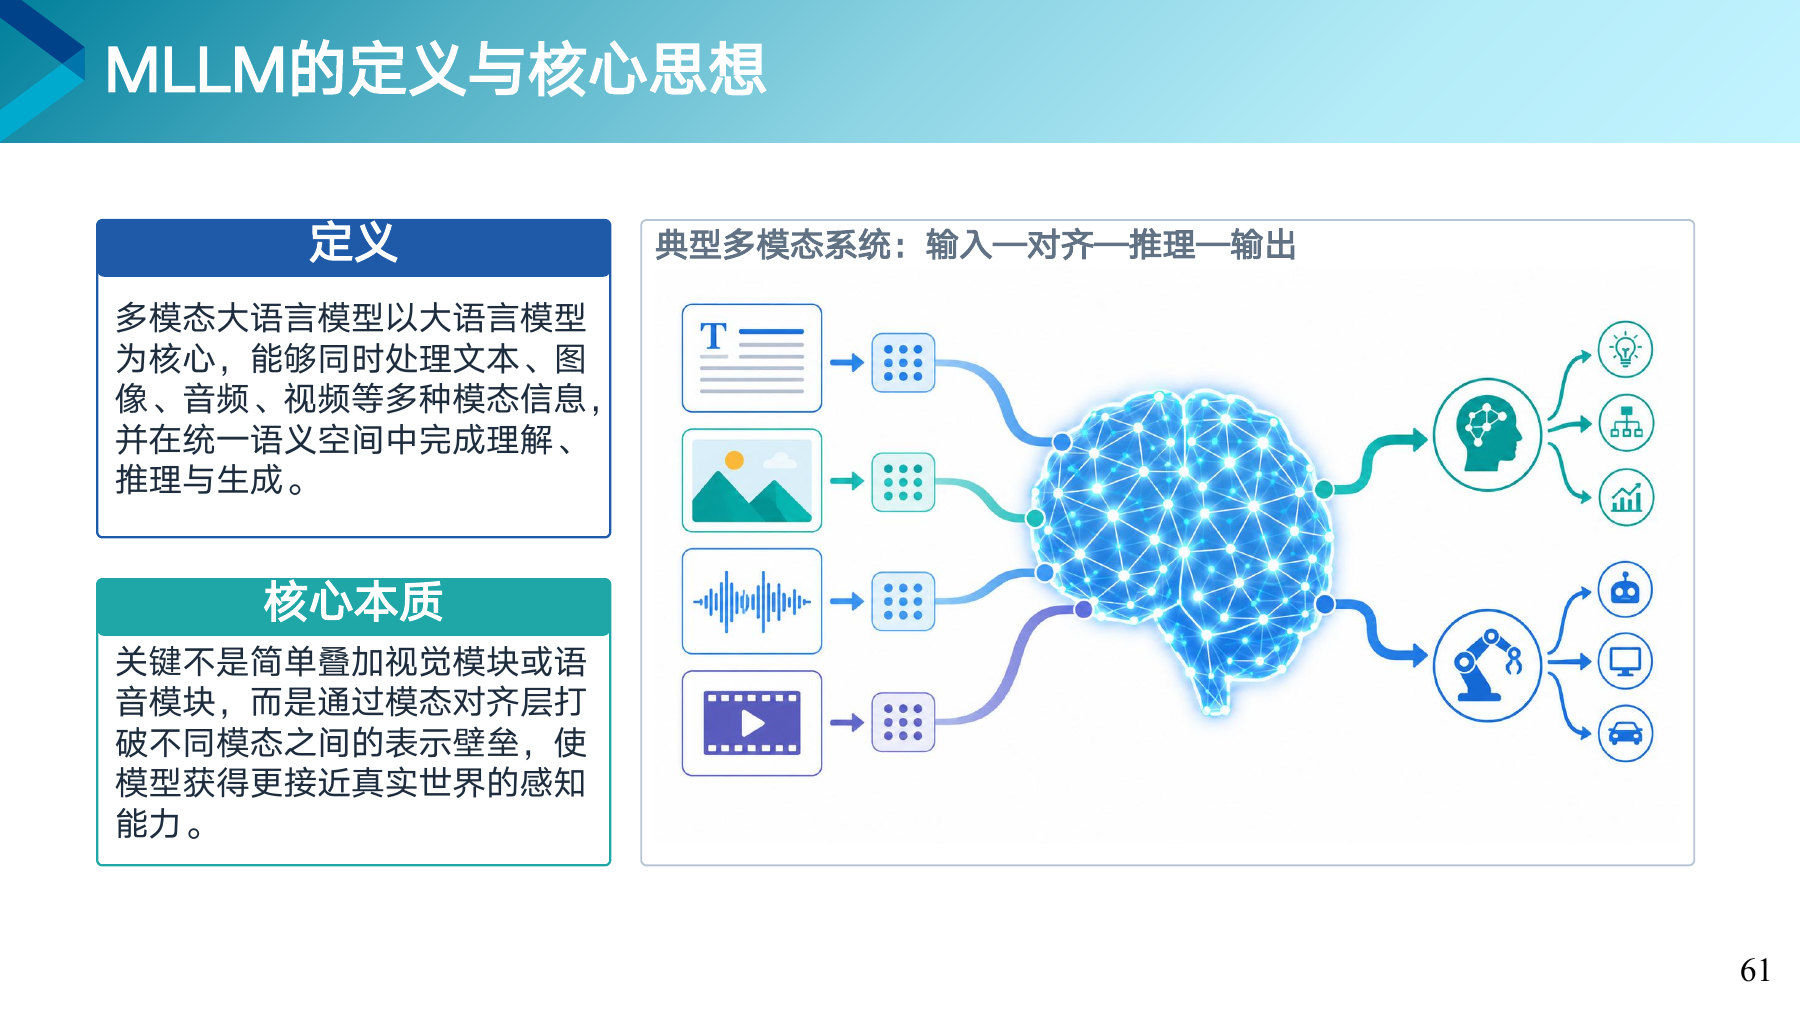
在语言模型旁边挂一个看图的模块,两边各干各的,并不能互相理解。要让图片里的“猫”和文字里的“猫”落在同一个位置上,模型才能看着图回答问题。
国际会议上,各国代表的发言都译成同一种工作语言,大家才能讨论到一起。统一语义空间就是这种工作语言。
只读文字的模型,看不见,也听不见。
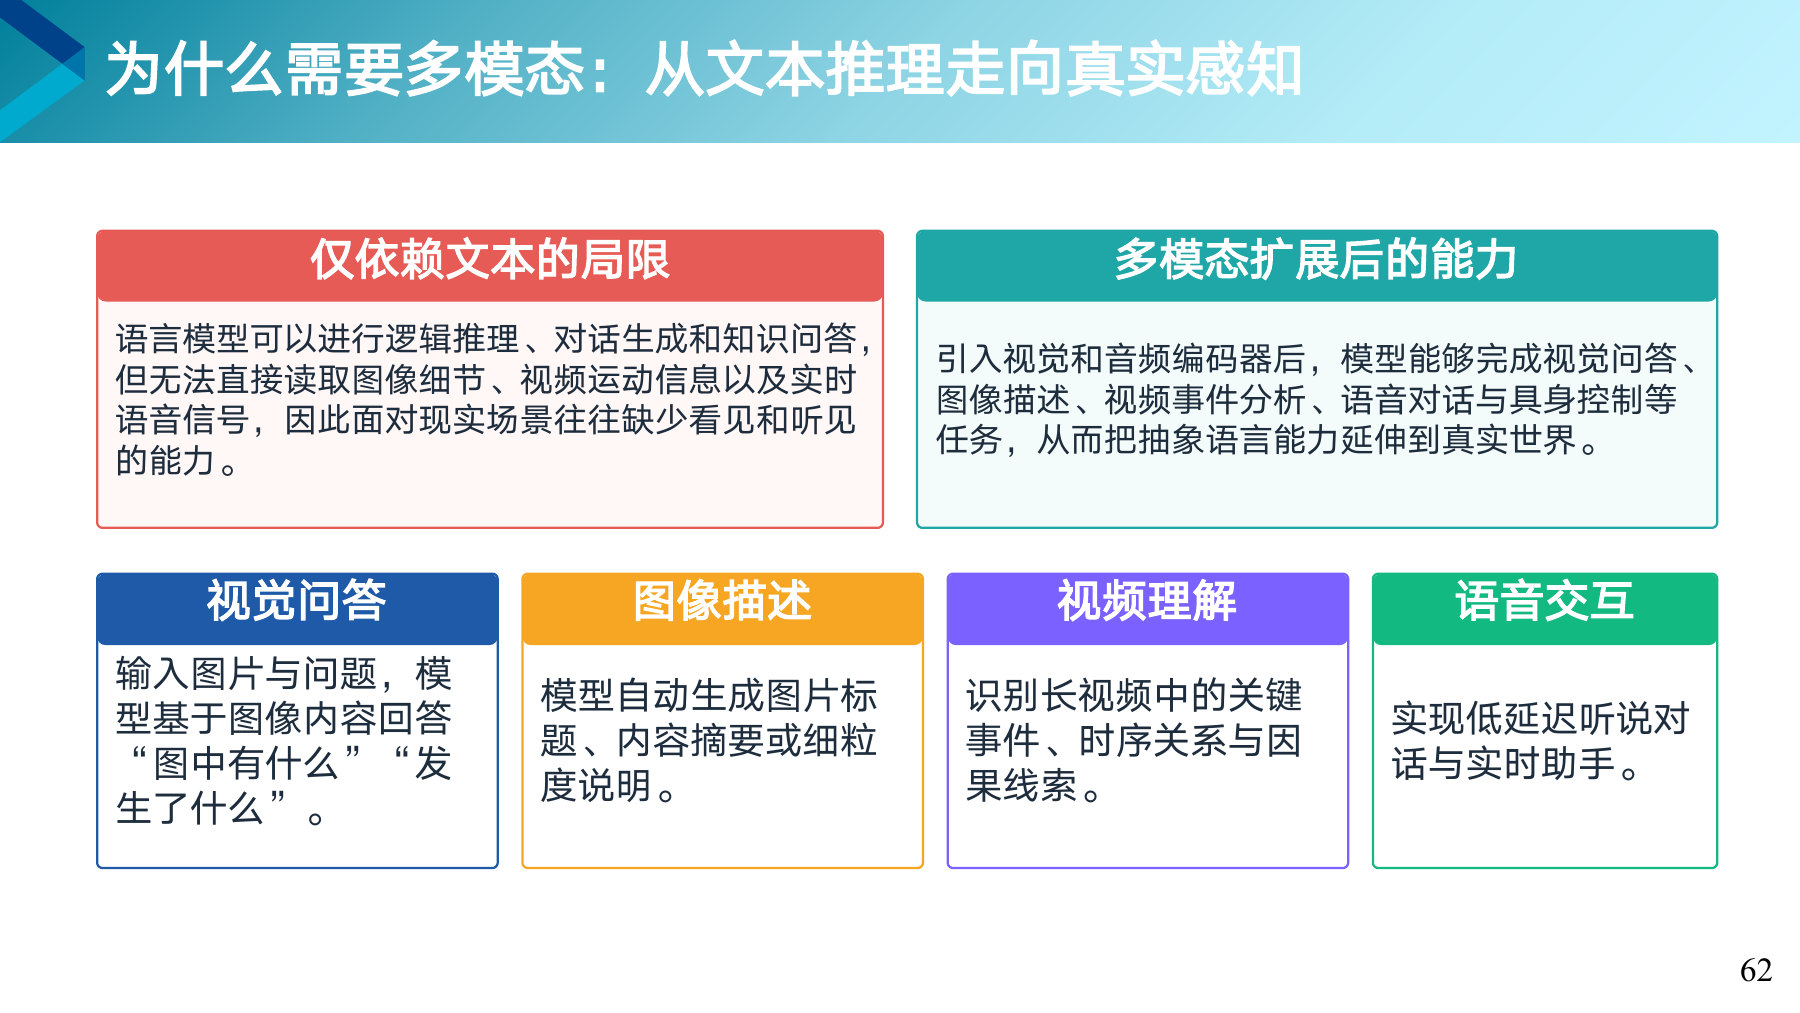
只靠文字的模型能推理、能对话,却看不到照片里的细节,也听不出说话的语气。接上视觉和听觉,它就能回答“图里有什么”,给视频写摘要,和人直接语音对话。
一个人书读得再多,闭着眼睛也没法告诉你眼前这个路口现在能不能过。
用手机拍下一道数学题,让 AI 讲解解题思路。这用到了图中列出的哪一种能力?
先把信号变成特征,再翻译给语言模型,最后回答。
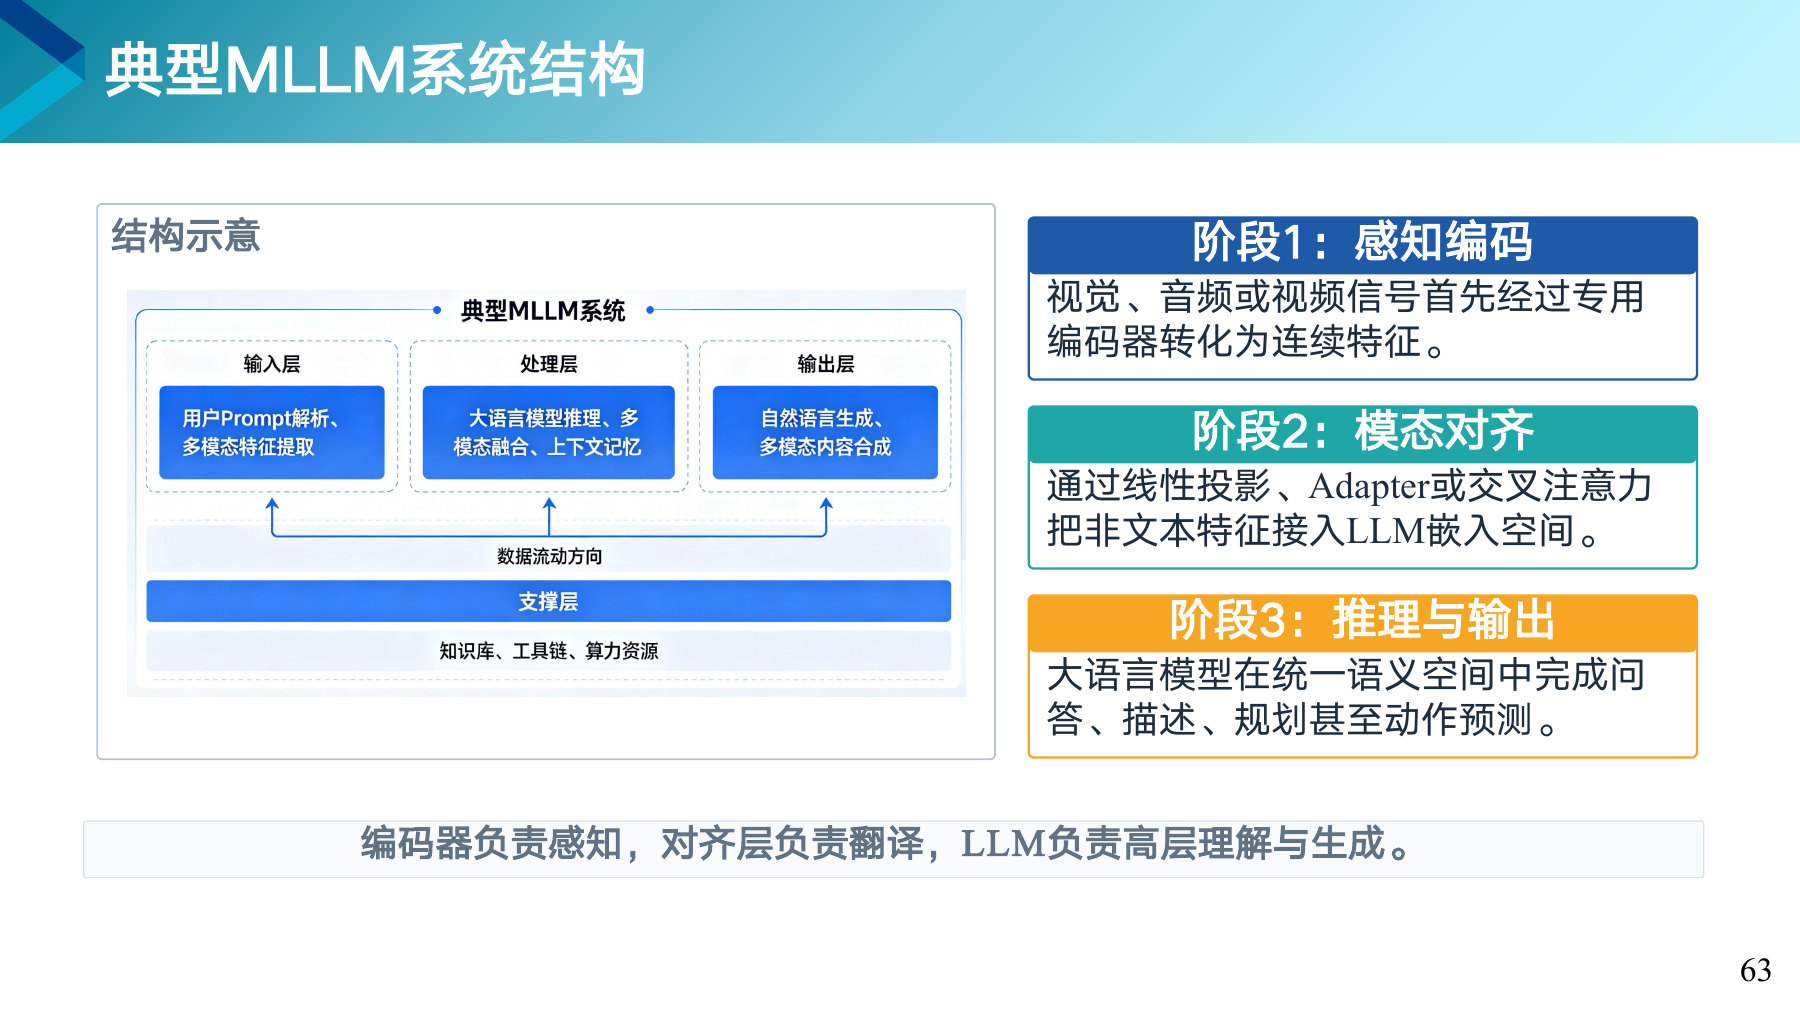
上传一张照片,问“图里有几只猫”。视觉编码器先把照片变成一串特征,这是感知编码。连接层把特征翻译成语言模型读得懂的形式,这是模态对齐。语言模型结合问题答出“两只”,这是推理与输出。
四类架构,各自对付一个难题。
| 架构 | 要解决的难题 | 大致做法 | 例子 |
|---|---|---|---|
| 基础对齐 | 能不能看懂 | 视觉编码器 + 连接层 + 语言模型 | LLaVA |
| 特征压缩 | 图太大、视频太长,词元太多 | 合并、挑选,把视觉词元压少 | MiniCPM-V |
| 混合专家 | 想让模型更大,又不想变慢 | 每次只请少数专家计算 | Qwen3-Omni |
| 视觉-语言-动作 | 看懂以后能不能动手 | 输出机器人的动作 | OpenVLA |
视频太长看不过来,找特征压缩。模型想更强又怕太慢,找混合专家。想让机器人按指令干活,找视觉-语言-动作模型。
同是车,货车加大车厢,救护车装上急救设备,校车装上安全座椅。每种改装对付一个问题,一辆车也可以同时做好几种改装。
图片切成小块变成视觉词元,经连接层送进语言模型。
| 图片边长 | 切成多少块 | 视觉词元数 |
|---|---|---|
| 336 × 336 像素 | 24 × 24 | 576 |
| 672 × 672 像素 | 48 × 48 | 2304 |
结构清楚,搭起来容易,训练成本也不高,很适合快速做出一个能看图的模型。代价是图一清晰、词元一多,语言模型能读的位置很快就被占满。
一张图的边长从 336 像素放大到 1008 像素,每块仍是 14 × 14 像素,视觉词元变成多少个?
视频太长、图片太大时,先把视觉词元压少。
只留画面有明显变化的帧。
连续几帧很像,用一个叫重采样器的小网络,把它们合成少量词元。
相邻位置、相邻时刻的词元取平均,合成一个。
给三小时的会议做纪要,不用逐字记录,两三页就能写清要点。相邻几分钟讲的是同一件事,就合成一条。
一个负责理解和思考,一个负责说出来,都用混合专家。
思考者和说话者都用了混合专家。以 Qwen3-Omni-30B-A3B 为例,总参数约 300 亿,每处理一个词元只用到约 30 亿。
理解和发声分开做。文字回答一出来,声音就能一段段跟着合成,对话更流畅。
像一档访谈节目。编剧在后台读材料、想好要说的话,主持人拿到稿子一句句说给观众听。编剧不用等整篇稿子写完,写好一段就递出去一段。
A 是激活(activated)的意思,3B 是 30 亿。和第 52 页的 DeepSeek-V3 一样,总参数很大,每次只用一小部分。
模型的输出从一句话变成一串动作,机器人照着做。
| 7 个数 | 管什么 |
|---|---|
| 第 1 到 3 个 | 机械手往前后、左右、上下各挪多少 |
| 第 4 到 6 个 | 机械手绕三个方向各转多少 |
| 第 7 个 | 夹爪张开还是合上 |
把每个动作数值分成 256 档,每一档对应一个专用的词元。这样输出动作和输出文字一样,都是一个词元接一个词元往下写,语言模型原来的本事可以直接用上。
和聊天模型相比,VLA 模型的输出有什么不同?