人工智能导论 第 3 章 · 第四节
课程 › 第 3 章 › 第四节 监督与无监督K-Means四个步骤迭代过程K 怎么选为什么降维投影散得最开新坐标轴保留前几个留几个
第 3 章 机器学习基础 · 第四节

聚类与降维

数据没有配答案,机器也能自己找出规律
本 节 知 识 点
  1. 26标签缺失:监督学习与无监督学习
  2. 27K-Means 聚类
  3. 28K-Means 的四个步骤
  4. 29K-Means 的迭代过程
  5. 30K-Means 的优点、局限与 K 的选择
  6. 31主成分分析(PCA)
  7. 32投影示例
  8. 33往散得最开的方向投影
  9. 35主成分就是新的坐标轴
  10. 37保留前几个主成分
  11. 39主成分个数怎么选
26
第 3 章 · 第四节

标签缺失:监督学习与无监督学习

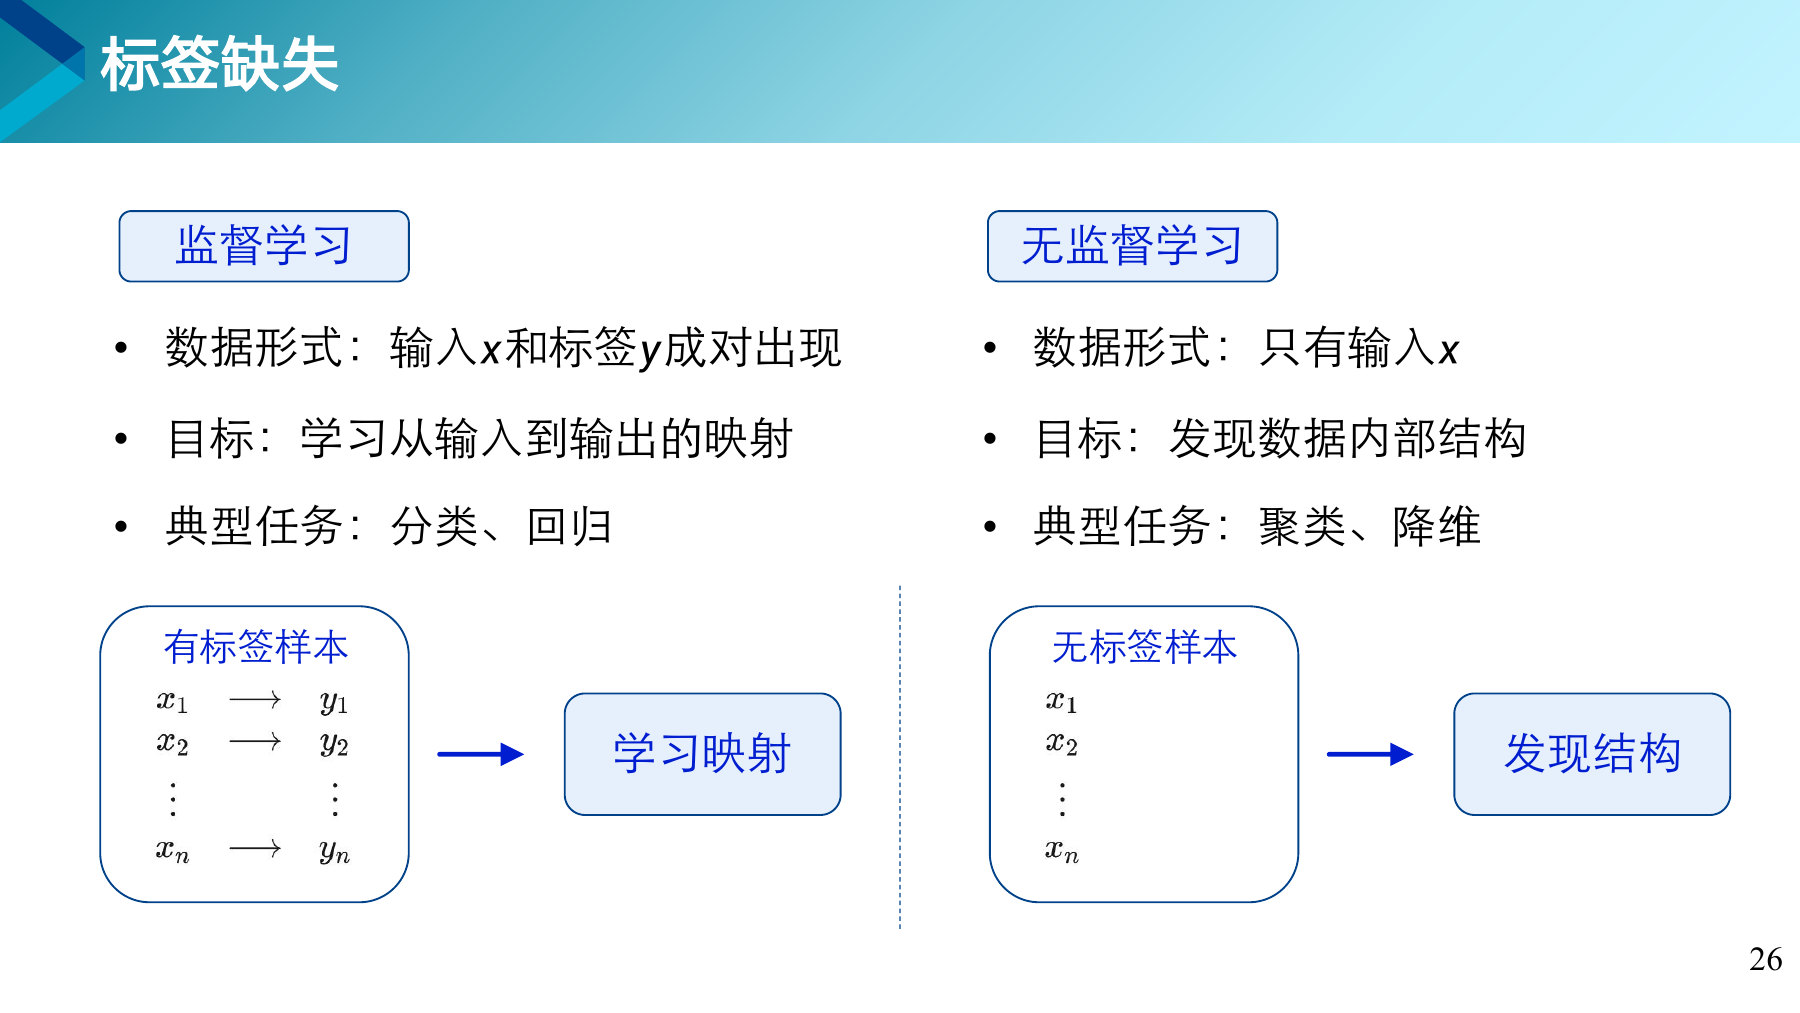
数据没有配答案,机器也能从中找出规律。
第 26 页课件

重 点两种学习的差别

监督学习的每条数据都配着答案,机器学的是怎样从数据推出答案。无监督学习只有数据,没有答案,机器要自己看出这些数据可以分成哪几类,或者藏着什么结构。

打个比方

老师发回一叠批改过的试卷,你照着对错去改进,这是监督学习。给你一抽屉没整理过的照片,让你自己分成几堆,这是无监督学习。

知道更多为什么需要无监督学习

给数据配答案要靠人一条条去标,既费时间又费钱。手机里的照片、网上的文章、商店的交易记录,绝大多数都没有人标过。

随堂练习

下面哪件事属于无监督学习?

  1. 用标好了猫和狗的照片,训练一个识别程序
  2. 把一万名顾客按购物习惯自动分成几群
  3. 根据房子的面积预测房价
  4. 判断一封邮件是不是垃圾邮件
查看答案
答案 B。只有 B 事先没有答案,分成哪几群要由机器自己去找。A 和 D 有现成的类别答案,C 有现成的房价答案,它们都属于监督学习。
27
第 3 章 · 第四节

K-Means 聚类

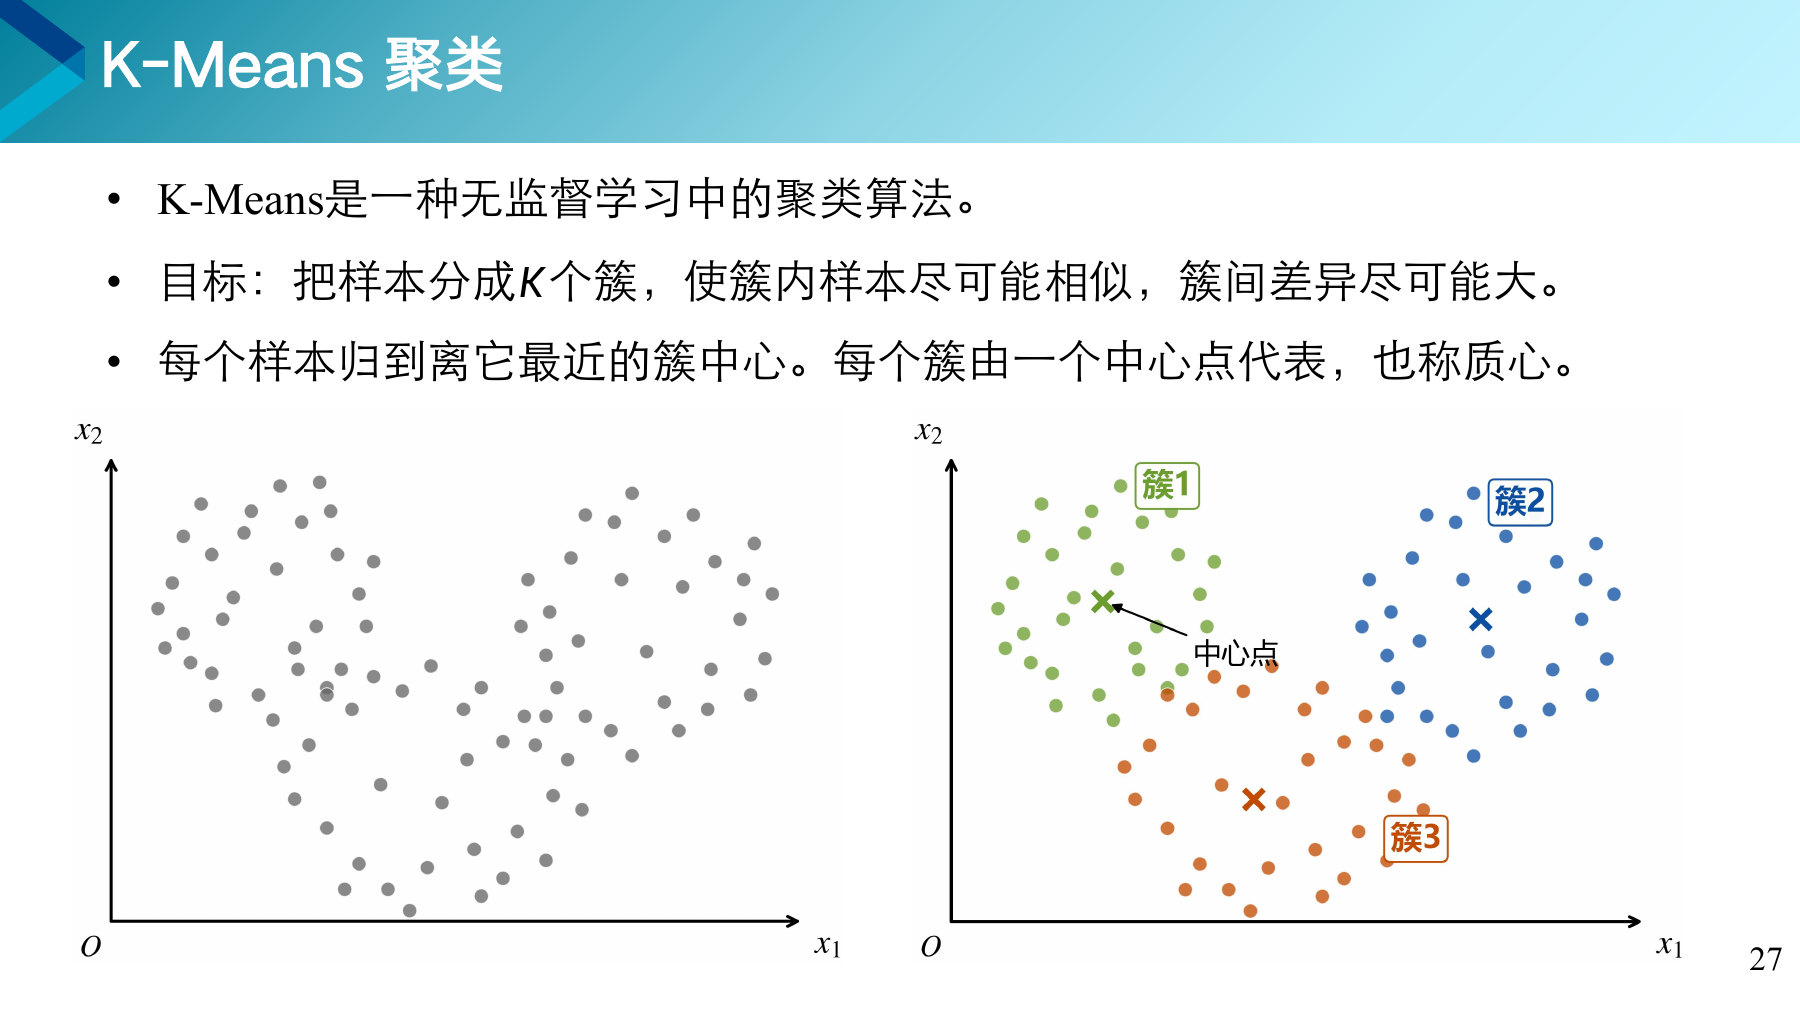
把数据分成 K 堆,同一堆里的点尽量挨在一起。

第 27 页课件

关键术语

聚类Clustering
把相似的样本自动归到同一组,分出来的每一组叫一个簇。
质心Centroid
一个簇的中心点,右图里用叉号标出。

重 点K 由人来定

K 是要分成几堆。K-Means 不会自己决定分几堆,这个数要人事先告诉它。右图的 K 取 3,于是分出了三个簇,每个点都归到离它最近的那个叉号。

打个比方

操场上三位老师各站一处,每个同学走到离自己最近的那位老师身边,操场上的人就分成了三群。老师站的位置就相当于质心。

28
第 3 章 · 第四节

K-Means 的四个步骤

随手放几个中心,然后分组、挪中心,反复几轮就稳定了。

第 28 页 K-Means 的四个步骤

两件事轮流做:先分组,再挪中心

① 放中心随手放下
K 个中心点
→
② 分组每个点跟着
离它最近的中心
→
③ 挪中心中心挪到本组
所有点的正中间
→
④ 重复重复②③,直到
中心不再移动
原来的中心原来的中心挪到蓝组正中间挪到红组正中间
K-Means 要让一个总和变小:每个点到自己中心的距离,平方以后全部加起来,叫距离平方总和。总和越小,每一堆就越紧凑。每做一轮,总和只会变小或者不变,不会变大。

重 点只有两个动作

第②步按中心来分组,第③步按分组来挪中心。两个动作轮流做,分组一轮比一轮合理。等到中心不再移动,分组也不会再变,算法就停下来。

打个比方

班上自由组队讨论。先随便指定三位组长,每个人走到离自己最近的组长那里。站定以后,每组改由站在正中间的同学当组长,大家再重新走一次。几轮之后,就没有人需要换组了。

29
第 3 章 · 第四节

K-Means 的迭代过程

四张小图,看四群点怎样一步步分开。

第 29 页课件

重 点顺着四张图看

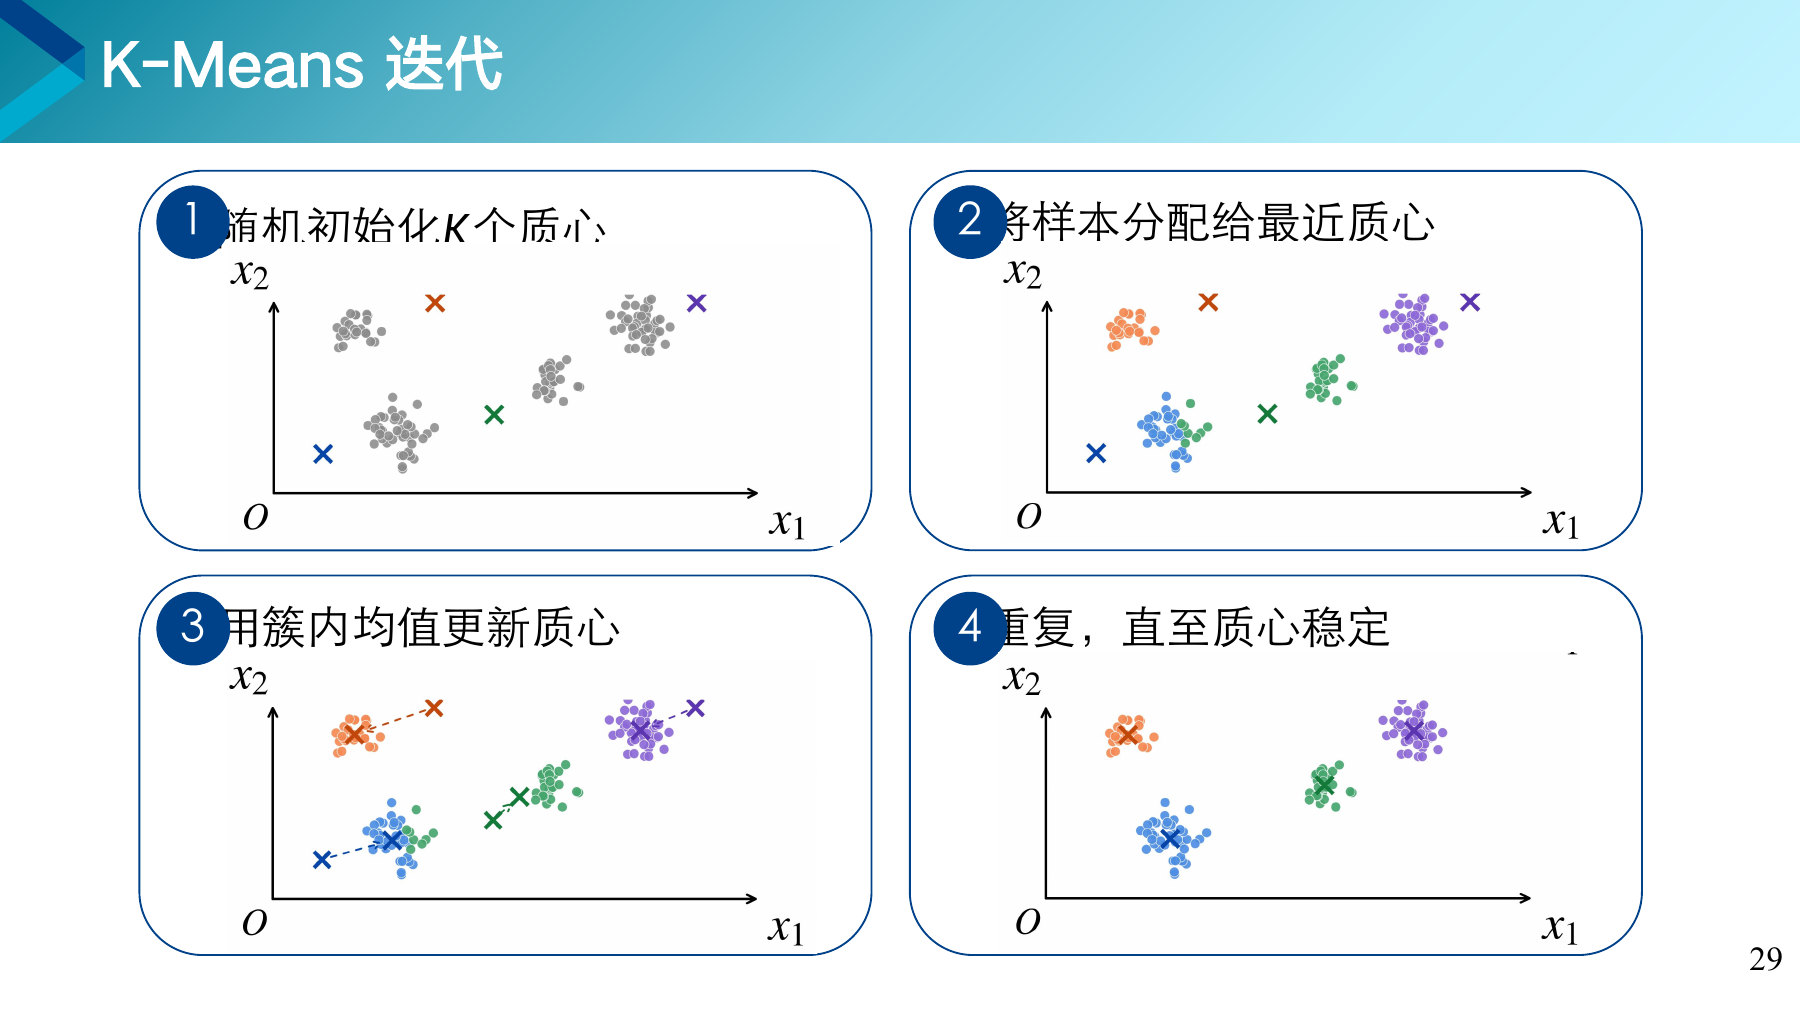
第 1 张的四个叉号是随手放的,位置很偏。第 2 张里每个点按最近的叉号染上了颜色。第 3 张的叉号挪到了各自颜色的中间。第 4 张又重复了几轮,四群点彻底分开。

知道更多起点放得不好怎么办

如果开头的几个中心挤在同一个角落,最后可能把两群点并成一群。常用的办法是换几个不同的起点多跑几次,挑距离平方总和最小的那一次。实验三会动手试一试。

30
第 3 章 · 第四节

K-Means 的优点、局限与 K 的选择

K-Means 算得快、容易看懂,但分几堆要人来定。

第 30 页课件

关键术语

SSESum of Squared Errors
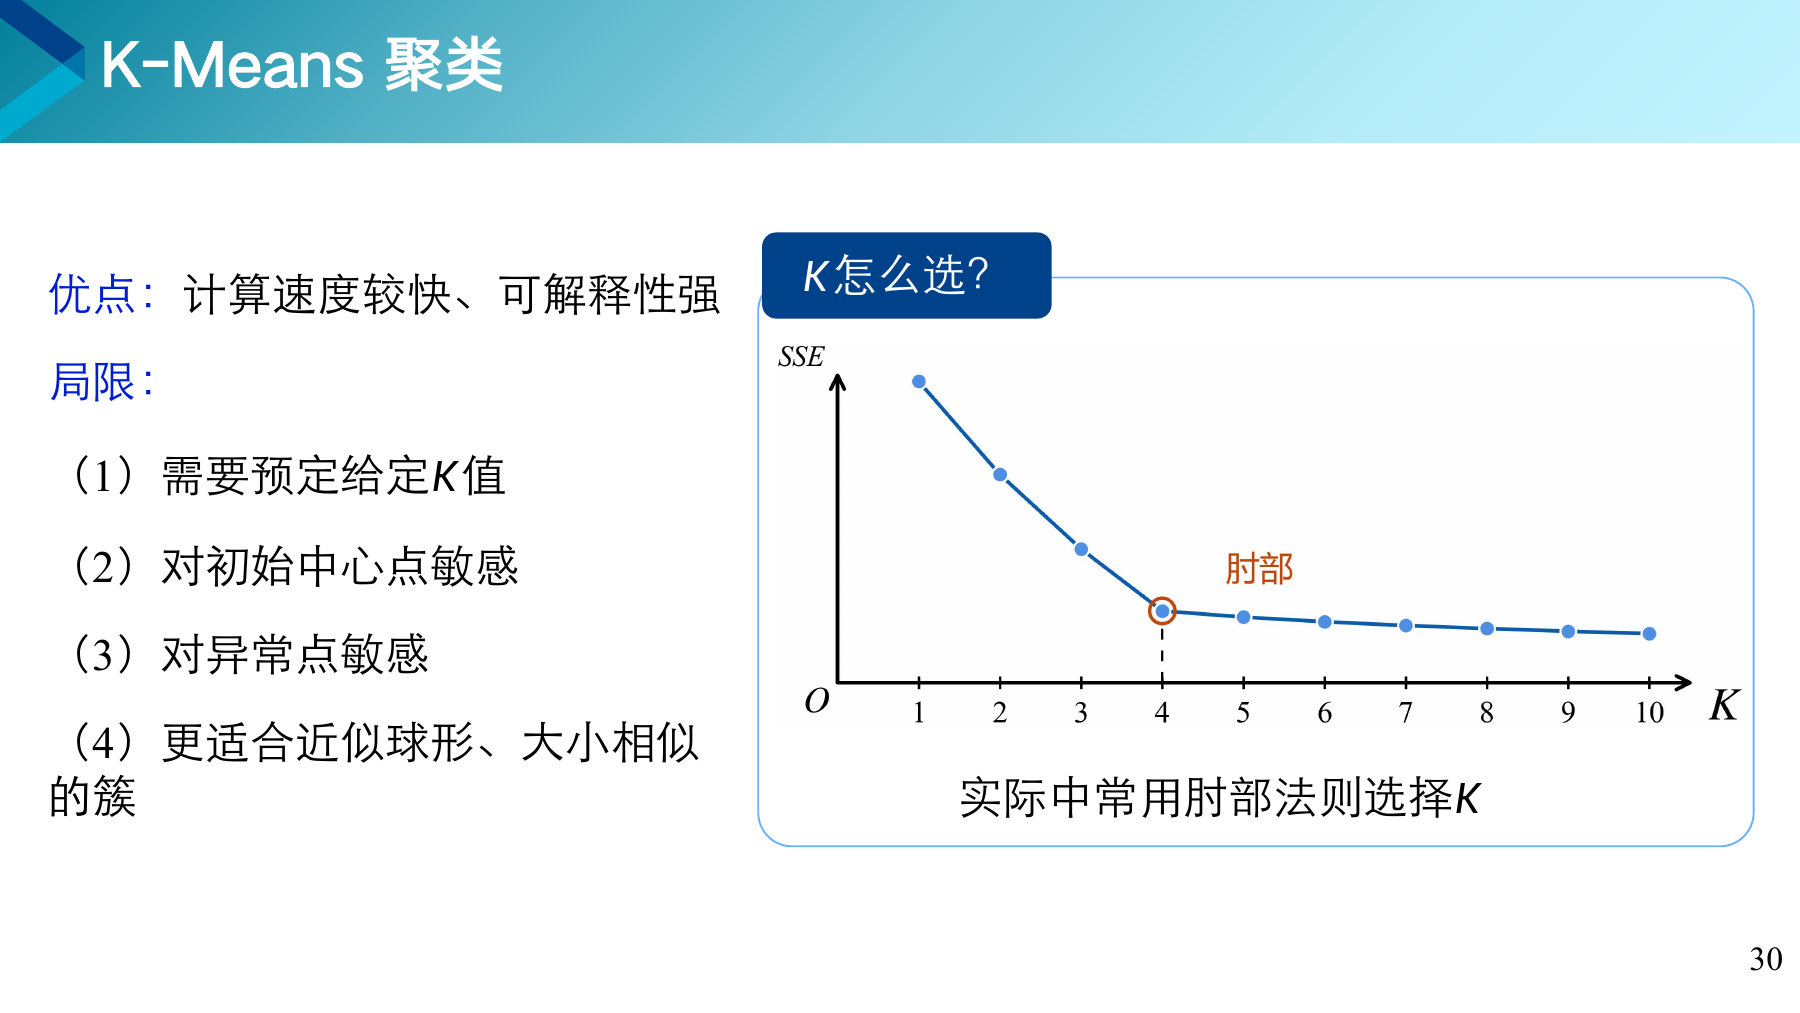
右图的纵轴,就是第 28 页说的距离平方总和,越小表示各堆越紧凑。
肘部法则Elbow Method
把 K 取不同值时的 SSE 画成曲线,选曲线由陡变平的那个拐点。

重 点四条局限

分几堆要事先定好。起点不同,结果可能不同。一个离得特别远的点会把中心拽偏。各堆最好是圆团形、大小差不多,细长条或者大小悬殊的堆分不好。

随堂练习

K 取得越大,距离平方总和会怎样变化?

  1. 越来越大
  2. 越来越小
  3. 保持不变
  4. 先变小,再变大
查看答案
答案 B。堆分得越多,每个点离自己的中心就越近。K 等于点的个数时,每个点自成一堆,总和降到 0,可这样的分组毫无意义。所以不能只追求总和最小,而要找曲线拐弯的地方,图上是 K 等于 4。
31
第 3 章 · 第四节

主成分分析(PCA)

很多特征在重复说同一件事,把它们合并起来,数据变小了,信息却没少多少。

第 31 页 为什么要降维

用一个数代替三个数

同学身高(厘米)臂展(厘米)腿长(厘米)
甲15815694
乙16616599
丙175176104
丁183185109
三列数一起变大,说的差不多是同一件事:这个人的个头有多大。
个头小个头大甲乙丙丁
用一个“个头”代替三个数,四个人之间的差别基本都保留了下来。PCA 做的,就是让计算机自动找出这样的合并方式。

关键术语

维度Dimension
描述一个样本用了几个数。有三个特征,就是三维。
降维Dimensionality Reduction
用更少的数去描述同一批数据。
主成分分析Principal Component Analysis, PCA
最常用的一种降维方法。

重 点为什么要降维

特征太多,计算慢,也没法画出来看。很多特征高度相关,一个涨另一个也跟着涨,可以把它们合成一个数来代表。

32
第 3 章 · 第四节

投影示例

选一个好角度把立体的点压扁,形状仍然看得清。

第 32 页课件

重 点投影就是看影子

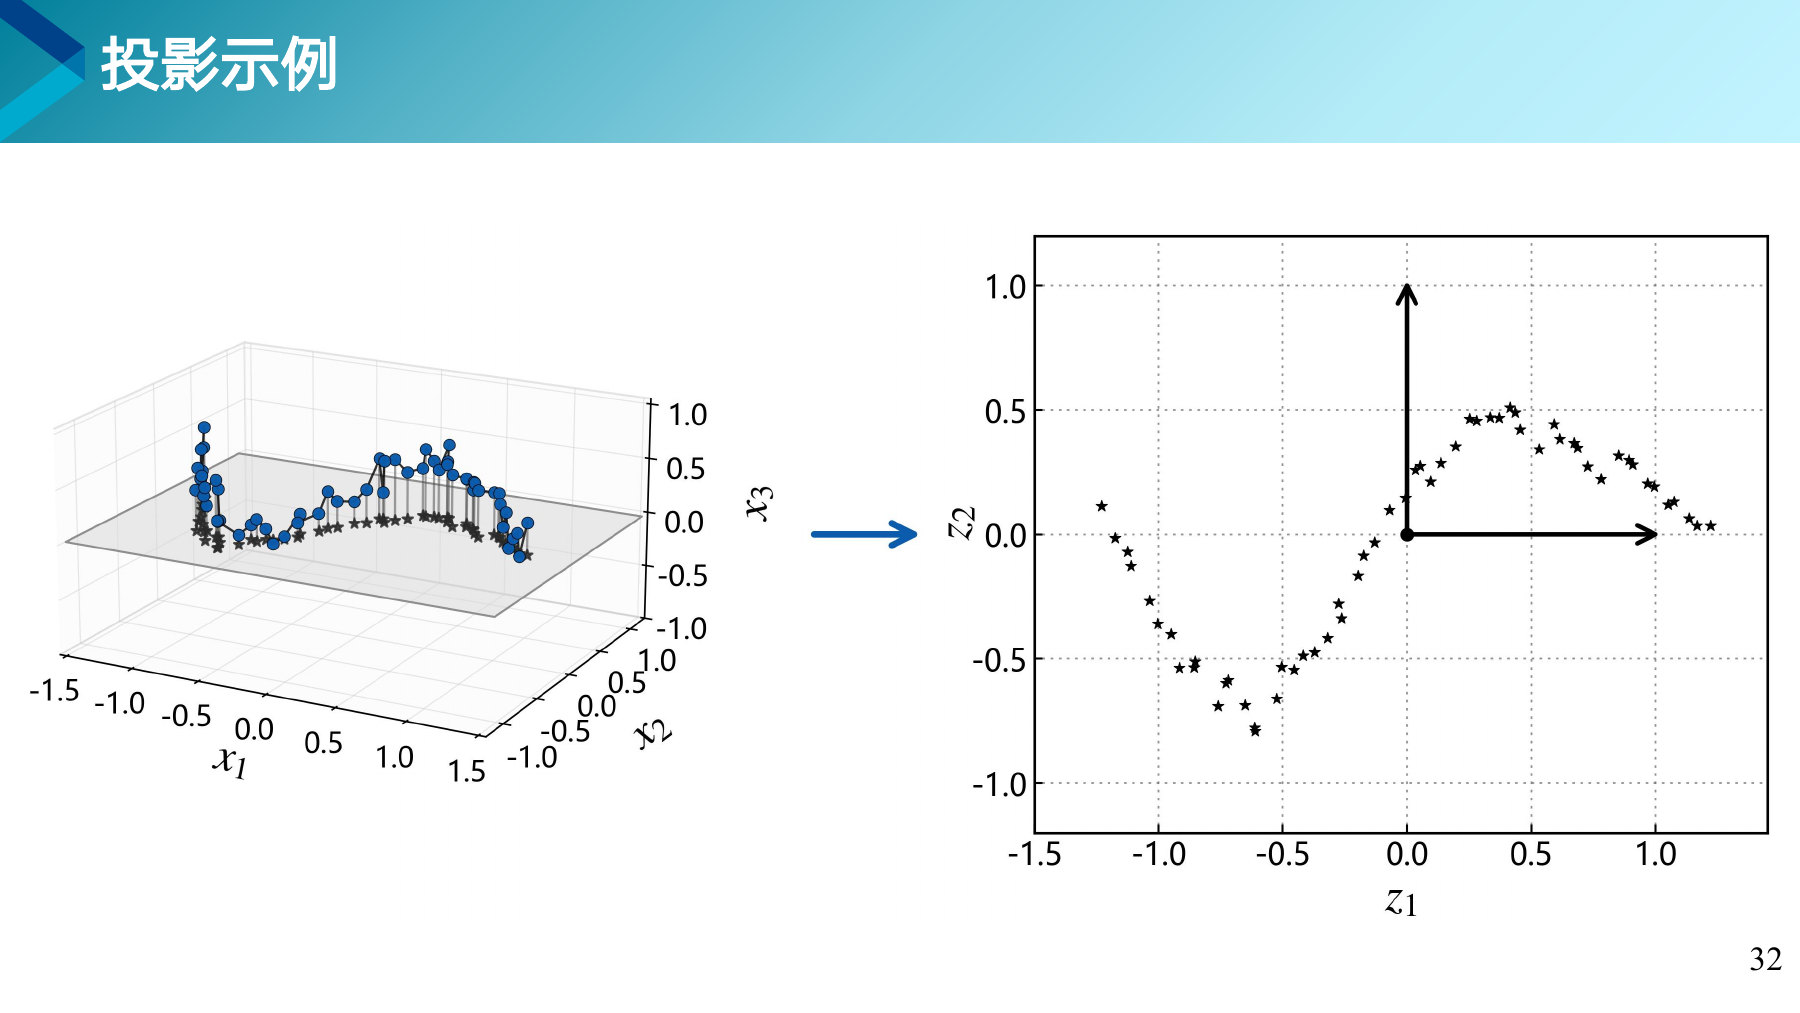
左图是三维空间里的一串点,灰色平面是要投上去的面。每个点垂直落到平面上,就得到了右图。右图只有两个坐标,那条波浪的形状却完整地留了下来。

打个比方

用灯照一个茶杯。从正上方照,影子只是一个圆。从侧面照,影子能看出杯身和把手。选对角度,影子里留下的形状最多。PCA 要找的就是这个最好的角度。

33
第 3 章 · 第四节

往散得最开的方向投影

投影以后点散得越开,留下的信息就越多。

第 33 页 PCA 选哪个方向

同一堆点,投到两个方向上

方向 A方向 B投到 A 上点拉得很开投到 B 上点挤成一团
投到 A 上,点和点之间还拉得开,谁是谁分得清。投到 B 上,点挤成一小段,差别几乎看不出来。
PCA 选的是让点散得最开的那个方向。课件里说的“方差最大”,指的就是这个。

关键术语

方差Variance
衡量一组数散得有多开。数越分散,方差越大。

打个比方

给全班拍合照。从正面拍,高矮胖瘦一眼就能分清。从头顶往下拍,每个人都只剩一个圆圆的头顶。正面这个方向,就是让大家差别最明显的方向。

随堂练习

全班每位同学的“入学年份”都是 2025,这一列数的方差是多少?

  1. 很大
  2. 0
  3. 1
  4. 2025
查看答案
答案 B。所有的数都一样,一点都没有散开,方差就是 0。这样的特征分不出任何两位同学,降维时最先被丢掉的就是这种方向。
35
第 3 章 · 第四节

主成分就是新的坐标轴

PCA 顺着数据的走向,重新画了一套坐标轴。

第 35 页课件

关键术语

主成分Principal Component
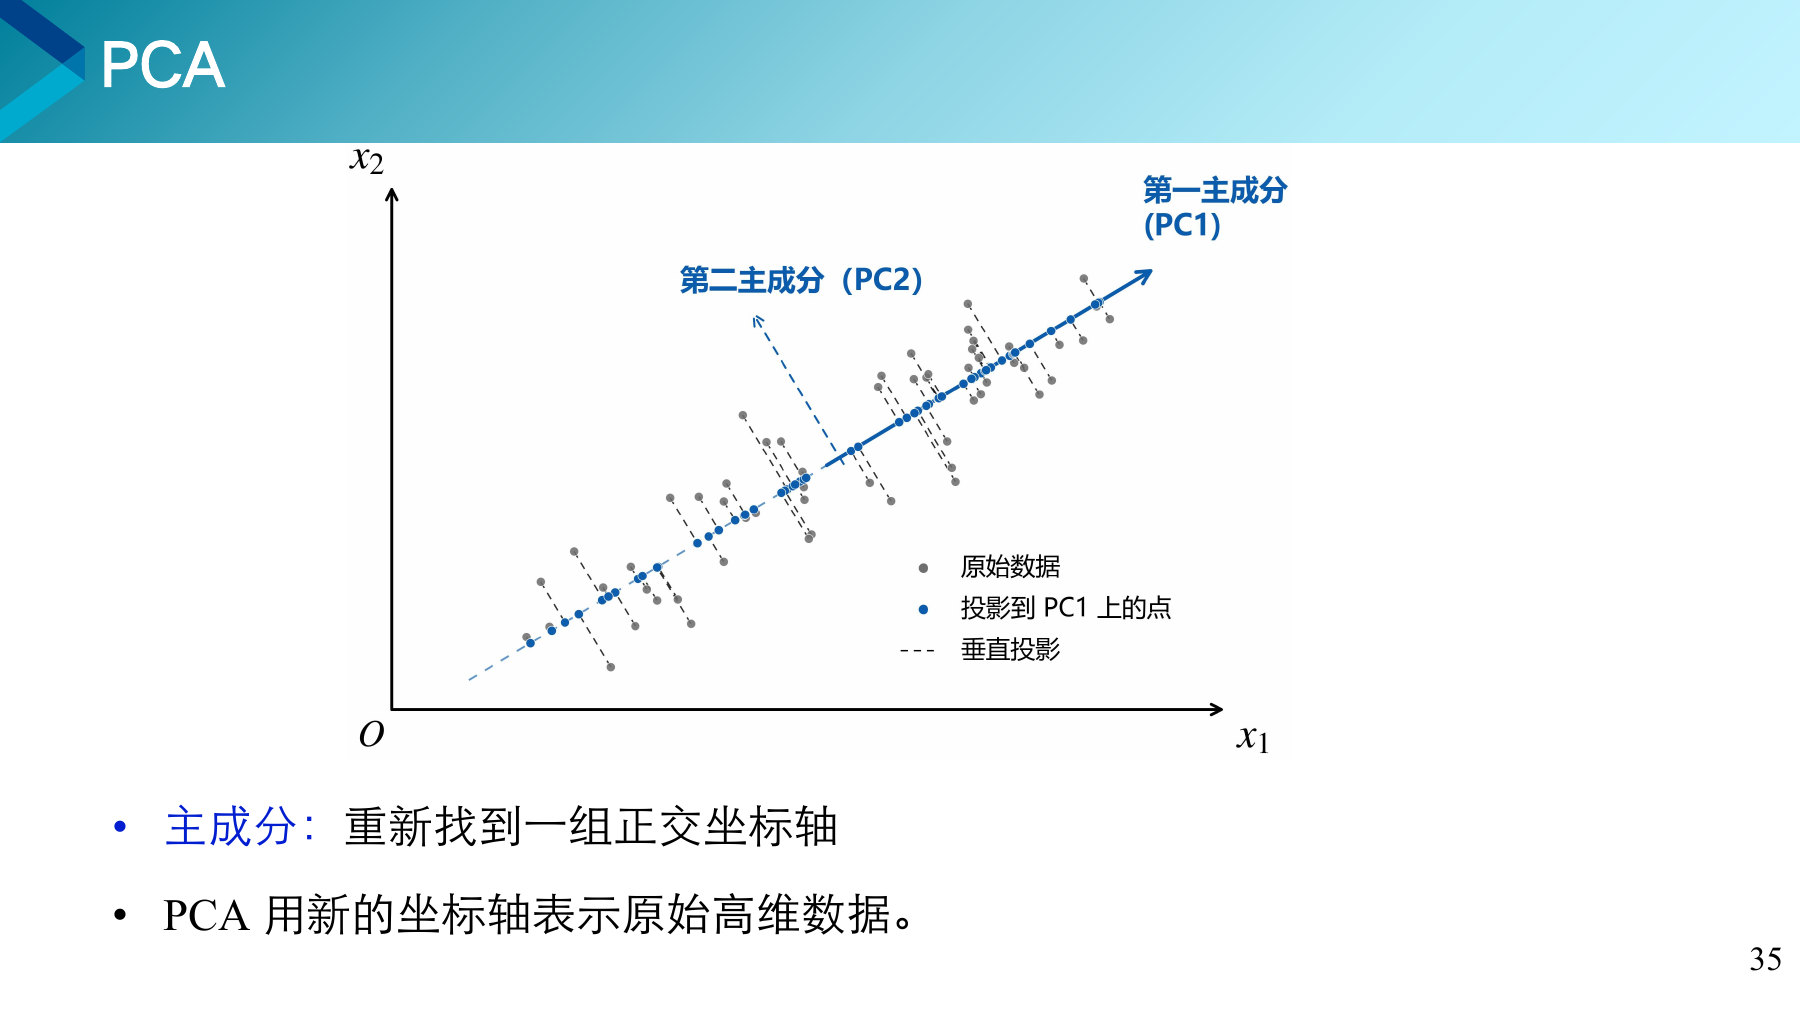
PCA 找出的新坐标轴。第一主成分 PC1 是点散得最开的方向,第二主成分 PC2 与它垂直。

重 点看图上的两个箭头

原来的坐标轴是横着的 x₁ 和竖着的 x₂。PCA 另画了两根轴,实线箭头 PC1 顺着点排成的那条斜线,虚线箭头 PC2 和它垂直。灰点是原始数据,蓝点是它们落在 PC1 上的位置。

知道更多主成分按重要程度排队

数据有几个特征,就能画出几根主成分。PC1 散得最开,PC2 次之,PC3、PC4 依次往后。它们两两垂直,各自描述的内容互不重复。

37
第 3 章 · 第四节

保留前几个主成分

排在后面的主成分散得很小,丢掉它们,降维就完成了。

第 37 页 保留前 k 个主成分

只留 PC1,二维的点变成了一维

PC1原来:每个点两个数沿 PC1 摆成一排现在:每个点一个数
找中心算出所有点的
中间位置
→
找方向找出散得最开的方向,
依次排好
→
投上去只留前几个方向,
把点投上去
这三步都有现成的程序,一行代码就能完成。原课件第 38 页是它的数学写法,要用到后续课程的线性代数,这里没有收录。

重 点降维的最后一步

主成分已经按重要程度排好了队。留下前几个,后面的全部丢掉。左图从二维降到一维,每个点只剩下它在 PC1 上的位置这一个数。

打个比方

压缩一张照片时,留下主要的轮廓和颜色,丢掉肉眼几乎看不出来的细小噪点。文件小了很多,看上去却和原图差不多。

39
第 3 章 · 第四节

主成分个数怎么选

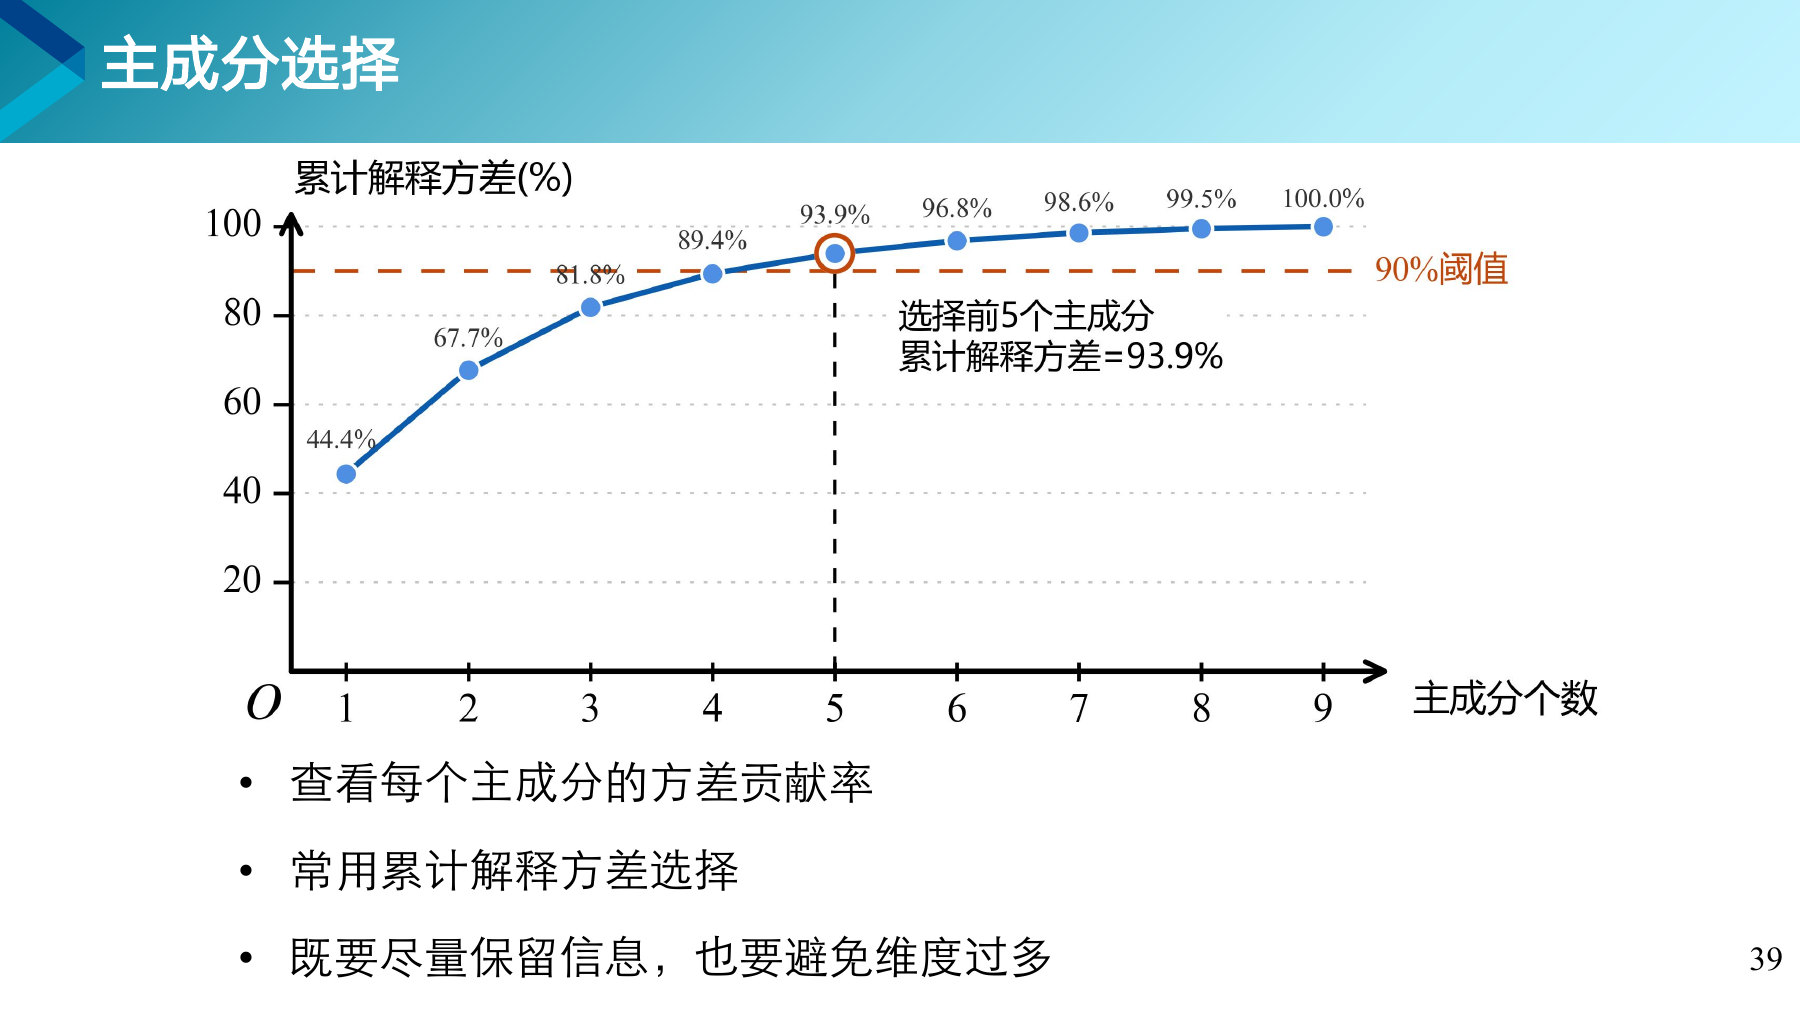
留下的主成分能说明九成的信息,就可以停了。

第 39 页课件

重 点这张图怎么读

横轴是留下几个主成分,纵轴是它们一共保留了原来百分之多少的信息。只留 1 个保留 44.4%,留到第 5 个是 93.9%,越过了 90% 那条虚线,于是选 5 个。原来的 9 个特征,现在 5 个就够了。

知道更多90% 只是常用的经验值

也有人定 85% 或 95%。留得太多,降维的效果不明显。留得太少,丢掉的信息又太多。

随堂练习

按图上的数字,只留前 3 个主成分,大约保留了多少信息?

  1. 44.4%
  2. 67.7%
  3. 81.8%
  4. 93.9%
查看答案
答案 C。在横轴上找到 3,对应的点标着 81.8%。这还不到 90%,所以图上没有停在 3,而是一直选到了 5。
保山学院·人工智能教研室·曹鼎鼎