人工智能导论 第 3 章 · 第五节
课程 › 第 3 章 › 第五节 分类评估回归评估在哪算指标三份数据交叉验证本节小结
第 3 章 机器学习基础 · 第五节

模型评估

模型学得好不好,要用它没见过的数据来检验
本 节 知 识 点
  1. 40分类任务怎么评估
  2. 41回归任务怎么评估
  3. 42指标该在哪些数据上算
  4. 43训练集、验证集与测试集
  5. 44k 折交叉验证
  6. 45小结
40
第 3 章 · 第五节

分类任务怎么评估

光看准确率不够,还要看错在哪一边。

第 40 页 分类任务的评估

100 人参加筛查,其中 10 人真的患病

模型判为患病模型判为健康
真的患病8 人 判对了(TP)2 人 漏掉了(FN)
真的健康4 人 误报了(FP)86 人 判对了(TN)
  • 准确率 判对的人占全部的比例:(8 + 86) ÷ 100 = 94%
  • 精确率 判为患病的 12 人里,真患病的比例:8 ÷ 12 ≈ 67%
  • 召回率 真患病的 10 人里,被找出来的比例:8 ÷ 10 = 80%
F1 分数把精确率和召回率合成一个数,两者都高,它才会高。

关键术语

混淆矩阵Confusion Matrix
把真实情况和模型判断交叉排成的四格表,就是左边那张表。
精确率Precision
模型判为正类(这里就是判为患病)的人里,有多少是真的患病。
召回率Recall
真的属于正类(这里就是真的患病)的人里,有多少被模型找了出来。

重 点准确率为什么会骗人

如果模型偷懒,把 100 人全判成健康,准确率照样有 90%,可 10 个病人一个也没有找出来。所以还要看精确率和召回率。

打个比方

火灾报警器调得很灵敏,一点烟就响,真着火时不会漏掉,召回率高,但常常误报,精确率低。调得很迟钝,一响必定是真着火,精确率高,却可能漏掉小火。两者往往此消彼长。
41
第 3 章 · 第五节

回归任务怎么评估

预测的是一个数,就看它和真实值差了多少。

第 41 页 回归任务的评估

天气预报连报三天,每天差了几度

日期预报(℃)实际(℃)差了几度差值的平方
周一202111
周二252411
周三1822416
  • 平均绝对误差 MAE (1 + 1 + 4) ÷ 3 = 2
  • 均方误差 MSE (1 + 1 + 16) ÷ 3 = 6
周三差了 4 度,在 MAE 里只算 4,在 MSE 里被平方成了 16。MSE 对大的错误更敏感。
课件上还有 KL 散度和沃瑟斯坦距离两个指标,用来比较两批数据整体分布上的差别,后续课程才会用到。

关键术语

平均绝对误差Mean Absolute Error, MAE
每次差了多少,取平均。
均方误差Mean Squared Error, MSE
每次的差先平方,再取平均。第 2 章已经见过它。

重 点两者的区别在大错上

平方会把大的偏差放大。一个模型平时很准、偶尔错得离谱,它的 MSE 会很难看,MAE 却不一定。

随堂练习

另一位预报员三天每天都差 2 度。和上面那位相比,他的两个指标怎样?

  1. MAE 更大,MSE 也更大
  2. MAE 一样,MSE 更小
  3. MAE 更小,MSE 一样
  4. 两个指标都一样
查看答案
答案 B。他的 MAE 是 (2 + 2 + 2) ÷ 3 = 2,和上面那位一样。MSE 是 (4 + 4 + 4) ÷ 3 = 4,比 6 小,因为他没有犯过大错。
42
第 3 章 · 第五节

指标该在哪些数据上算

拿练过的题来考,分数一定虚高。

第 42 页 这些指标该在哪些数据上计算

同一个模型,两种打分方式

用训练过的数据打分

模型见过这些数据,可能只是把答案记住了。分数很高,却说明不了它会不会处理新情况。

用没见过的数据打分

模型以后投入使用,遇到的都是没见过的数据。这样打分往往低一些,但更接近实际水平。

训练和评估用同一份数据,结果往往会过于乐观。

重 点记住和学会是两回事

模型在训练数据上成绩好,可能只是记住了这些数据。要知道它能不能应付新情况,必须用它没见过的数据来考。

打个比方

老师拿练习册上的原题当期末考试,全班都能考九十分。这个分数只能说明大家做过这些题,说明不了真实水平。

43
第 3 章 · 第五节

训练集、验证集与测试集

数据分成三份,各管一件事。

第 43 页课件

重 点三份数据的分工

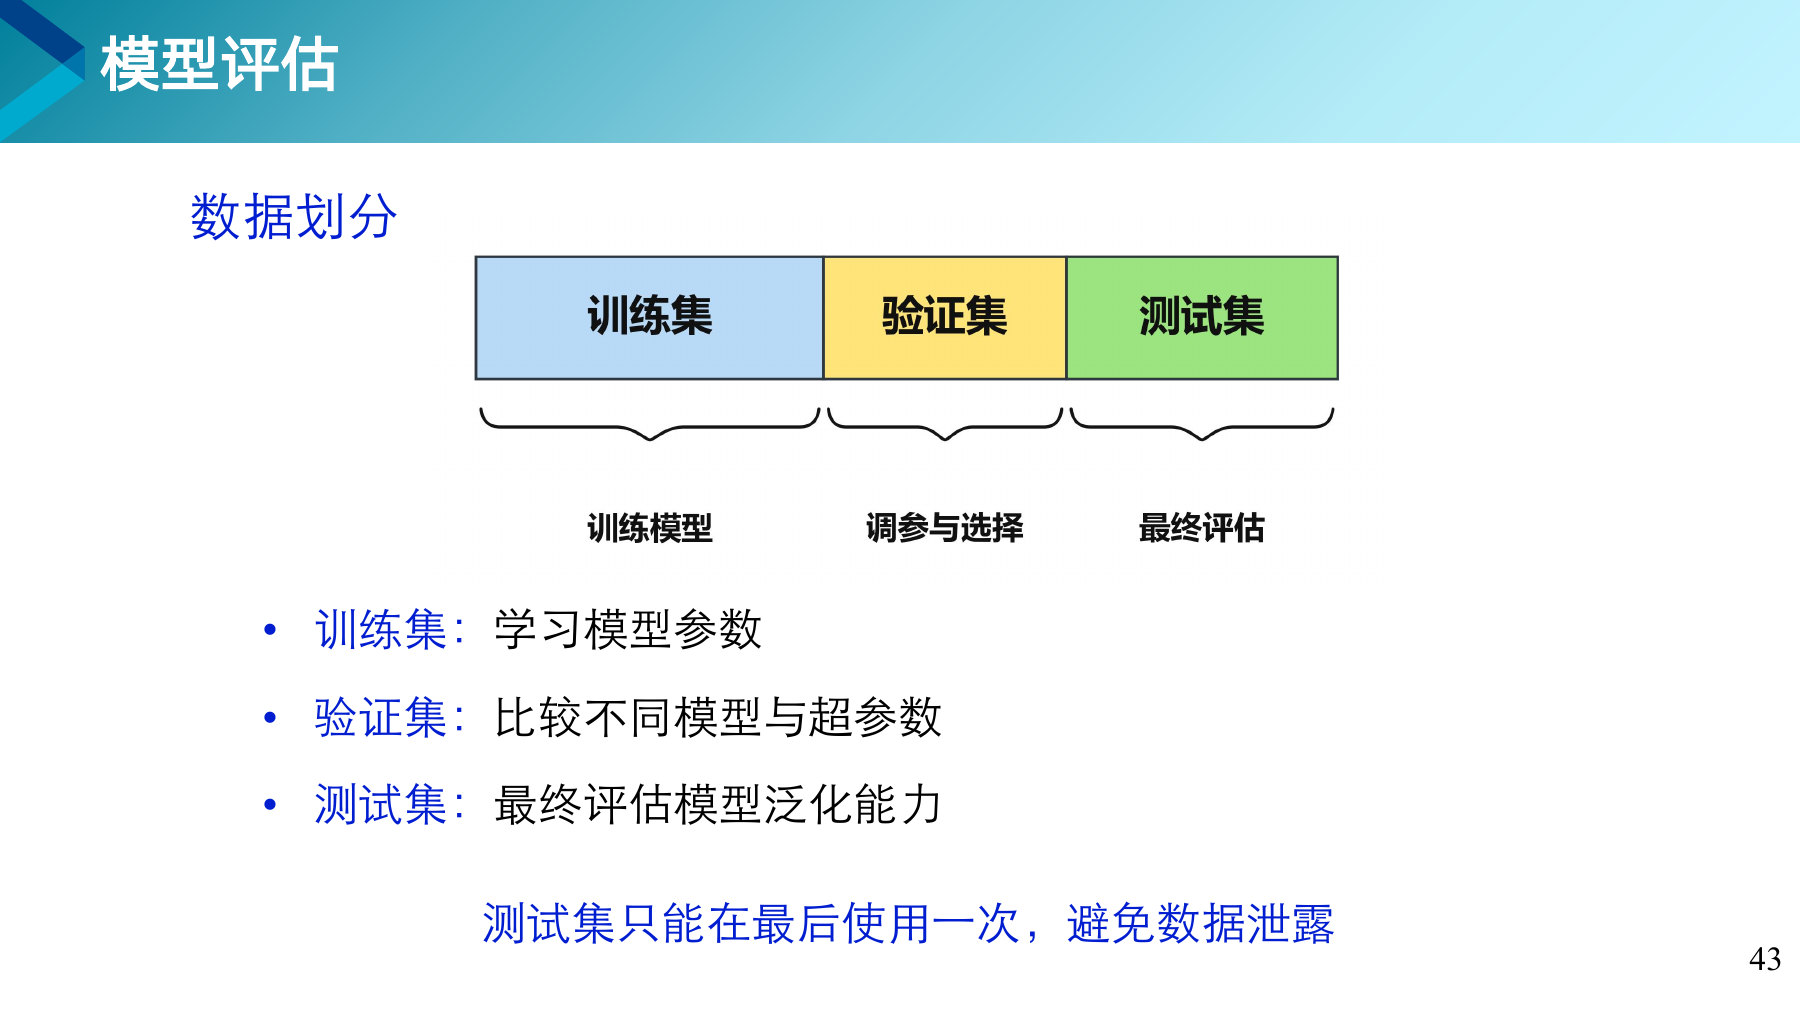
训练集用来学参数。验证集用来比较不同的模型和设置,挑出最好的那个。测试集留到最后只考一次,得出的成绩才算数。如果反复拿测试集的成绩去调模型,等于提前偷看了考题,这就是课件上说的数据泄露。

打个比方

训练集像平时的练习册,可以反复做。验证集像月考,用来调整复习的方法。测试集像期末考试,只考一次,考完就是最终成绩。

随堂练习

想比较决策树的深度取 3 好还是取 5 好,应该看哪一份数据上的成绩?

  1. 训练集
  2. 验证集
  3. 测试集
  4. 三份加起来
查看答案
答案 B。挑模型、调设置是验证集的工作。训练集上的成绩偏高,不能拿来比较。测试集要留到最后才用,不能拿来反复挑选。
44
第 3 章 · 第五节

k 折交叉验证

数据不多的时候,让每一份都轮流当一次验证集。

第 44 页课件

关键术语

k 折交叉验证k-Fold Cross Validation
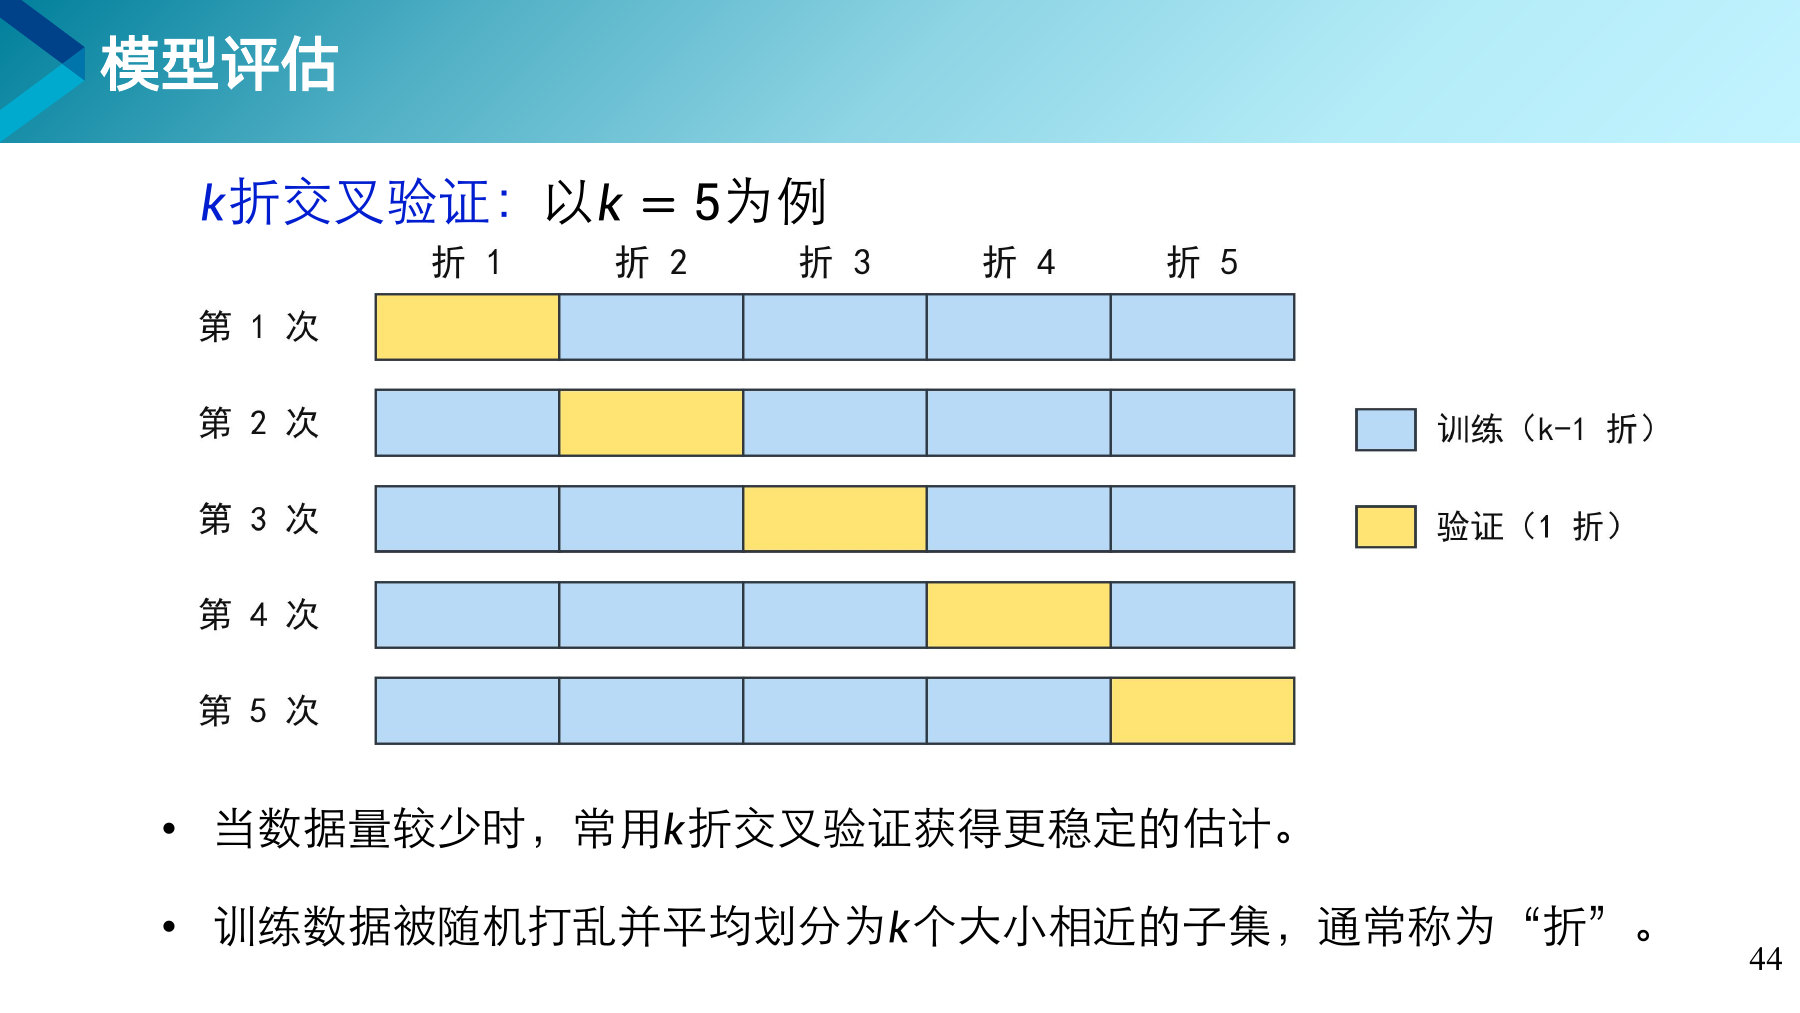
把数据平分成 k 份,轮流拿一份做验证、其余做训练,最后取 k 次成绩的平均。

重 点看图上的五行

k 取 5,数据切成 5 折。第 1 次用第 1 折验证(黄色),其余 4 折训练(蓝色)。第 2 次换成第 2 折验证。轮完 5 次,每一折都当过一次验证集,最后把 5 个成绩取平均。

打个比方

请五位同学评一道菜。只让一个人尝,碰上他口味偏咸,结论就偏了。五个人轮流尝,再取平均,结论要稳当得多。

45
第 3 章 · 第五节

小结

三种有答案的方法,两种没答案的方法,再加一套检验办法。

第 45 页 前五节小结

经典统计学习讲了哪些方法

方法数据有没有答案用来做什么一句话记住
逻辑回归有分类加权打分,换算成概率
支持向量机有分类在两类之间找最宽的通道
决策树有分类问一连串是非题
K-Means没有聚类按远近分成 K 堆
PCA没有降维往散得最开的方向投影
不管用哪种方法,最后都要拿没见过的数据来检验,成绩才可信。

知道更多该选哪一种方法

需要向别人讲清判断依据时,决策树最方便。两类数据的分界弯弯曲曲时,带核函数的支持向量机更合适。只想先看看数据大致分成几类时,可以用 K-Means。

保山学院·人工智能教研室·曹鼎鼎