人工智能导论 第 3 章 · 第三节
课程 › 第 3 章 › 第三节 决策树树的结构术语汇总熵信息增益选哪个特征阶梯状边界
第 3 章 机器学习基础 · 第三节

决策树

一连串是非判断,拼出看得懂的规则
本 节 知 识 点
  1. 19决策树
  2. 20决策树的组成部分
  3. 21四个术语的定义
  4. 22熵:衡量数据的混乱程度
  5. 23决策树的划分标准
  6. 24每一步选信息增益最大的特征
  7. 25决策树的非线性边界
19
第 3 章 · 第三节

决策树

用一连串条件判断,把分类过程拆成看得懂的规则。
第 19 页课件

关键术语

决策树Decision Tree
把分类过程拆成一连串条件判断的模型,每判断一次就缩小一次候选范围。

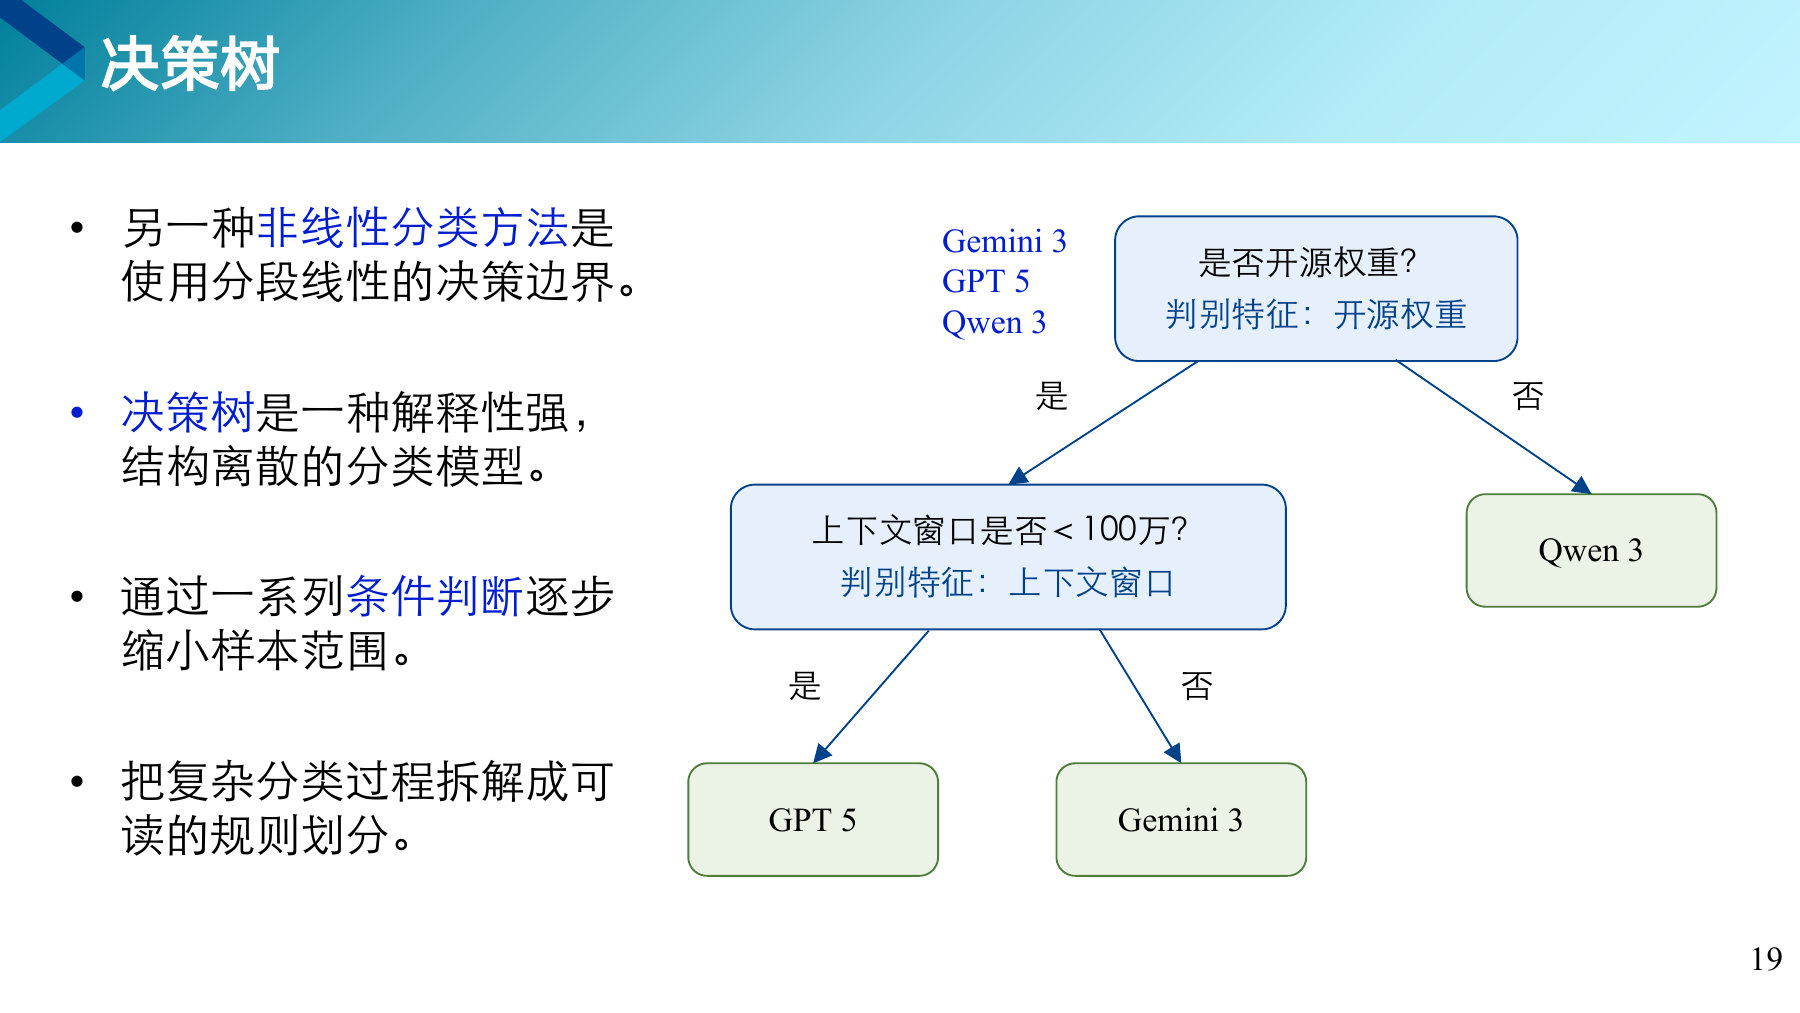
重 点跟着图上的箭头走一遍

从最上面出发,先判断是否开源权重。答否直接落到 Qwen 3。答是再判断上下文窗口是否小于 100 万,答是落到 GPT 5,答否落到 Gemini 3。每判断一次,候选范围缩小一次,三个候选用两个问题就分完了。

打个比方

与猜谜游戏里的二十问相同。是活的吗,会飞吗,比鸽子大吗,每个问题都把可能性砍掉一部分,问不了几轮就锁定答案。决策树要决定的,就是先问哪个问题。问得好几步就分完,问得不好要绕很多弯。

知道更多决策树的主要优点

整棵树可以直接翻译成一句话:开源的、上下文小于一百万的,是 GPT 5。这种可读性是逻辑回归和支持向量机不具备的,也是决策树在需要向人解释结论的场合仍被大量使用的原因。
20
第 3 章 · 第三节

决策树的组成部分

根节点、内部节点、分支、叶节点,四个位置四种角色。

第 20 页课件

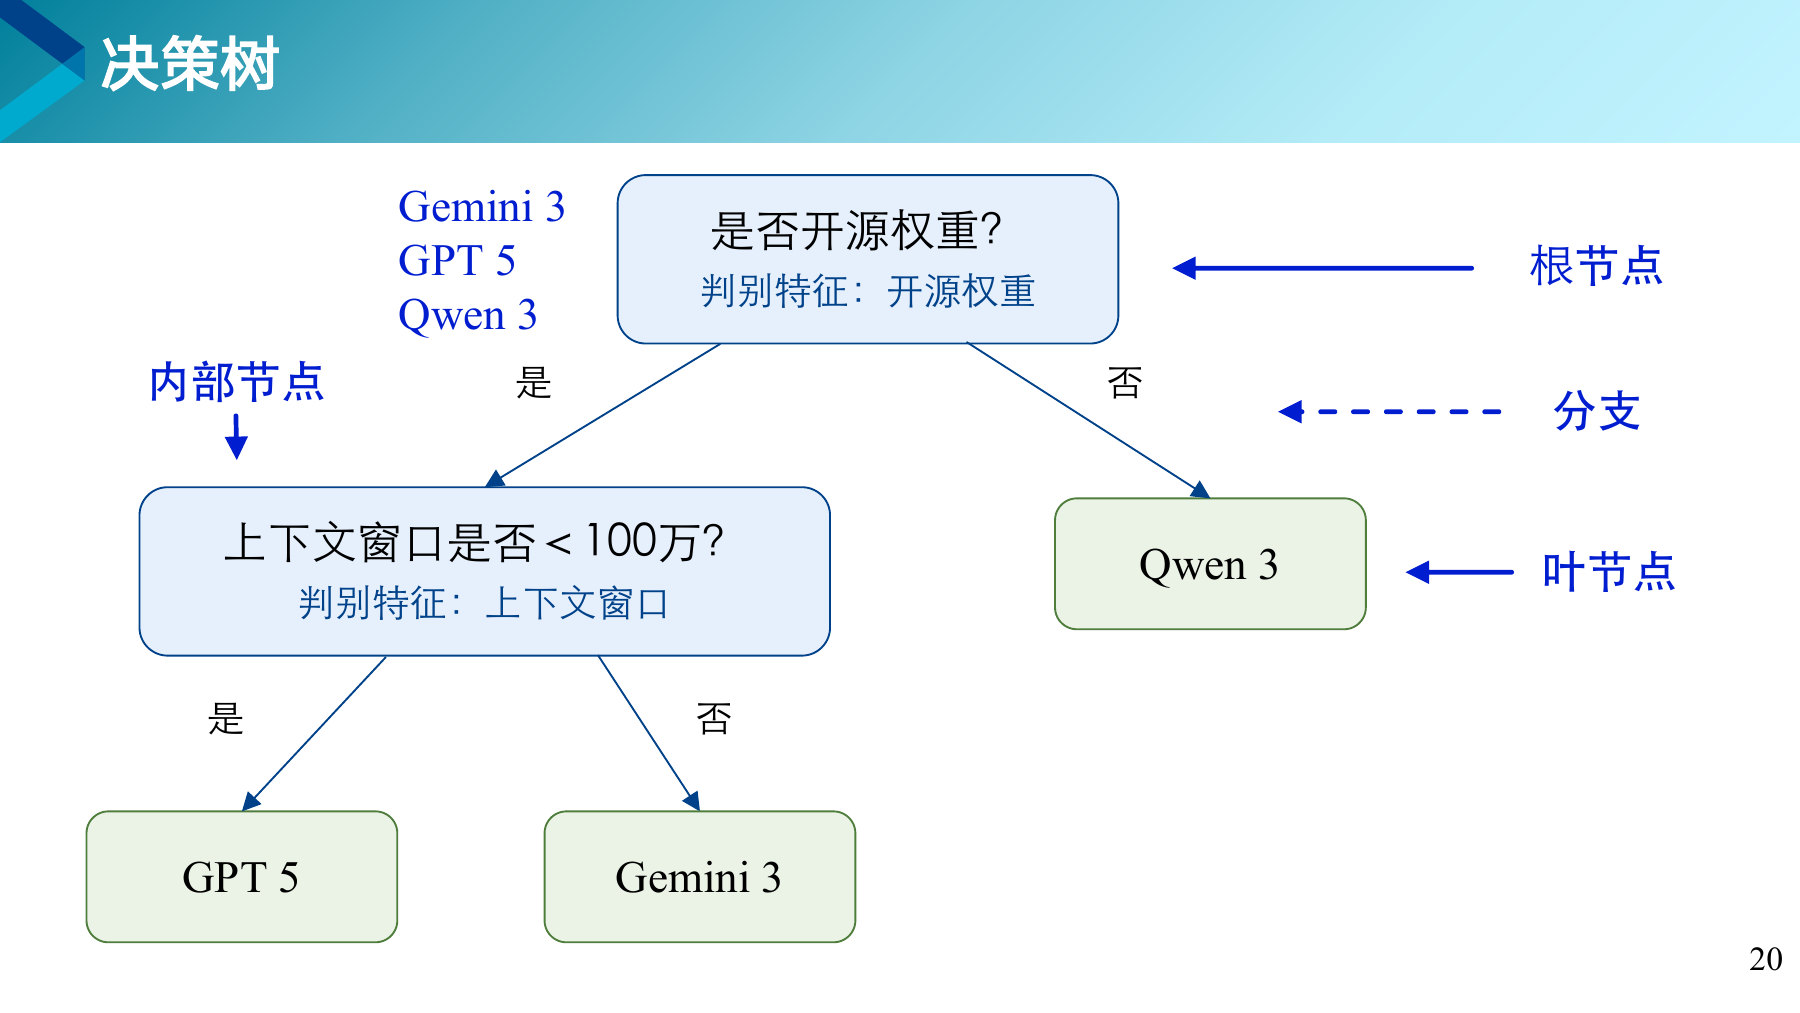
重 点对着四个箭头认位置

根节点在最上面,装着全部初始样本。内部节点在中间,每个负责对某一个特征做判断。分支是节点引出的线,代表判断条件的不同取值。叶节点在最下面,给出最终的分类结果。

打个比方

医院的分诊流程与这个结构对应。挂号大厅是根节点,所有病人从这里进来。分诊台按症状把人分到内科、外科、儿科,这一步是内部节点。通往各科室的走廊是分支。最后到达的那间诊室是叶节点,诊断在那里给出。

知道更多叶节点上写的是什么

叶节点给出的结论,通常是落到这一格里的样本中占多数的那一类。一格里有七个活人三个死人,这一格就判活。叶节点的结论本身也会出错,错的就是那三个人。

21
第 3 章 · 第三节

四个术语的定义

同一棵树,把四个位置的定义并排放一遍。

第 21 页课件

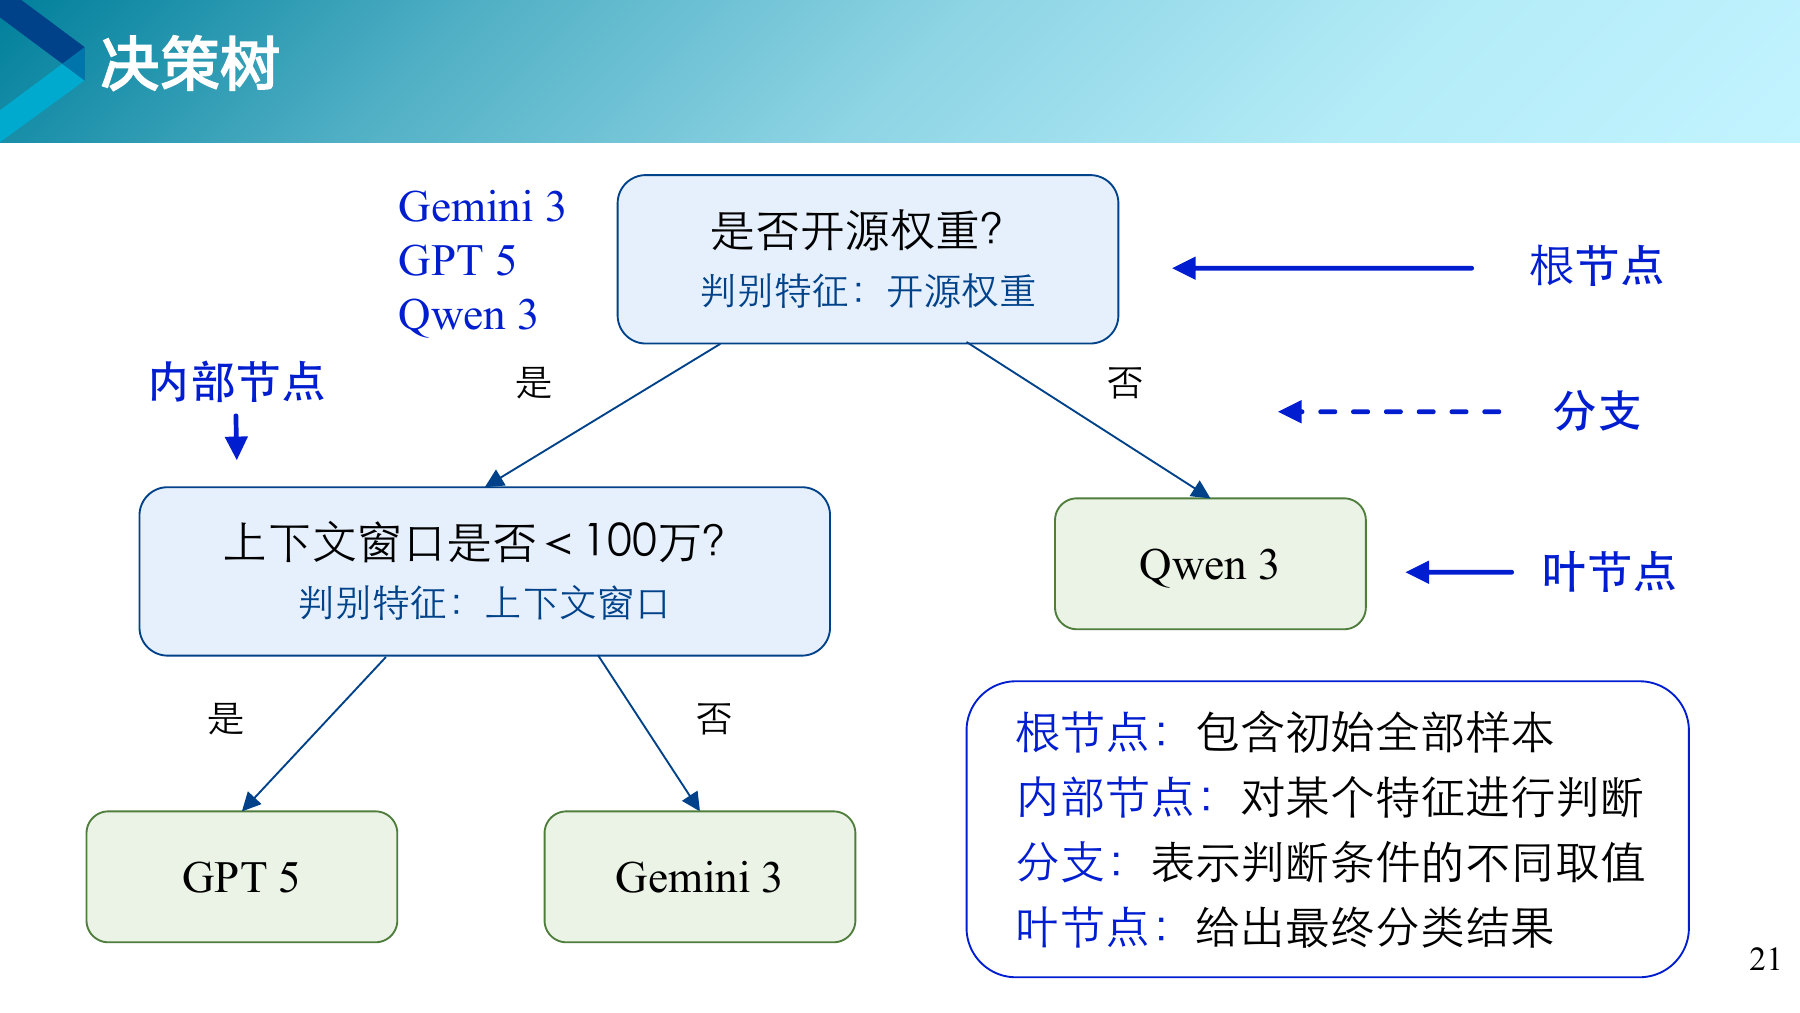
重 点右下角的四条定义

根节点包含初始全部样本。内部节点对某个特征进行判断。分支表示判断条件的不同取值。叶节点给出最终分类结果。这四个词在后面讲随机森林和梯度提升树时会一直用到。

知道更多一个容易忽略的细节

同一个特征可以在树的不同位置被反复判断,只是每次的门槛不同。上层问是否小于 100 万,下层还可以问是否小于 10 万。树的表达能力有一部分来自这种重复切分。

反过来,一棵树用到的特征不一定是全部特征。有些特征从头到尾没有被选中,说明它们在这份数据上帮不上忙。

随堂练习

一棵决策树有五个叶节点,下面哪一句话是对的?

  1. 这棵树只能处理五个样本
  2. 这棵树把样本最多分成五组,不同组可以给出相同的类别
  3. 这棵树一定能分出五个不同的类别
  4. 这棵树的深度一定是五
查看答案
答案 B。叶节点的数量是最终划分出的格子数,每格给出一个结论,但几个格子的结论完全可以相同。叶节点数与样本数、类别数、深度都不是一回事。
22
第 3 章 · 第三节

熵:衡量数据的混乱程度

一堆样本越是混在一起,熵就越大。

第 22 页 熵:衡量数据的混乱程度

熵衡量的是从这堆里随便摸一个好不好猜

低熵 好猜 高熵 难猜 一类占了绝大多数 两类各占一半
  • 左边这堆 几乎全是蓝的,闭着眼摸一个你敢说是蓝的,很好猜,所以熵小。
  • 右边这堆 蓝红各一半,摸之前你完全没把握,很难猜,所以熵大。
  • 全是一种颜色 闭着眼也不会错,这时熵等于 0,取到最小值。
决策树希望每问一个问题,剩下的样本都变得更好猜。下一页就是在给好猜了多少这件事打分。

关键术语

熵Entropy
衡量一组样本有多混乱。样本越集中在某一类,熵越小。全部属于同一类时熵为零。

重 点熵的大小只看比例

熵的大小只与各类所占的比例有关,与样本总数无关。十个球里九个白的,和一千个球里九百个白的,熵完全相同。比例越悬殊熵越小,越接近平均熵越大。课本上那个带求和号的式子算的就是这件事。

打个比方

一个盒子里九十九个白球一个黑球,闭着眼摸一个,说它是白的基本不会错,这种情况熵低。换成五十个白球五十个黑球,摸之前完全没有把握,这种情况熵高。熵衡量的就是猜的难度。

随堂练习

下面四组样本,哪一组的熵最小?

  1. 10 个样本,5 个 A 类 5 个 B 类
  2. 10 个样本,9 个 A 类 1 个 B 类
  3. 100 个样本,50 个 A 类 50 个 B 类
  4. 100 个样本,60 个 A 类 40 个 B 类
查看答案
答案 B。只看比例,B 是九比一,最悬殊,熵最小。A 和 C 都是一比一,熵取到最大值,样本数不同不影响结果。D 是六比四,比 A 和 C 小,但仍大于 B。
23
第 3 章 · 第三节

决策树的划分标准

按哪个特征划分,就看划完之后混乱程度降了多少。

第 23 页 决策树的划分标准

三步连起来是一个减法

划分前有多乱整堆样本
算一个熵
−
划分后有多乱切成几组,各组的熵
按人数占比平均
=
信息增益乱的程度
一共降了多少
划分后的那一项要按人数占比来平均,不能简单地取平均值。切出来一组只有两个人,哪怕它一点不乱,也不能算多大功劳。
增益大

这一刀切下去,两边都变得整齐多了。这个特征值得先用。

增益接近 0

切完跟没切一样乱。这个特征在当前这一步帮不上忙。

这个式子回答的是一句话:按这个特征划分,数据变得好猜了多少。

重 点三步连起来是一个减法

第一步算划分前的熵,第二步算划分后各组熵的加权平均,第三步两者相减得到信息增益。课本上那三行式子对应的就是这三步。

打个比方

整理一抽屉杂乱的文具,可以按颜色分,也可以按类型分。分完之后哪一种方式让每一格里的东西更整齐,哪一种就更值得采用。信息增益就是在给整齐了多少打分。

知道更多为什么要按人数占比加权

如果一刀切出九十八个人和两个人,那两个人的组再整齐也只影响百分之二的样本。加权平均让每一组的贡献与它的人数相称,避免结果被极小的组带偏。

随堂练习

按某个特征划分之后,信息增益算出来接近 0,说明什么?

  1. 这个特征在当前这一步没能让数据变得更好猜
  2. 这个特征的数据记录有误
  3. 这个特征应该立刻从数据集中删除
  4. 这棵树已经训练完成
查看答案
答案 A。增益接近 0 表示切完与没切一样乱。这只说明它在当前这一步派不上用场,换到树的下一层、面对另一批样本时仍可能有用,所以不能据此删掉它。
24
第 3 章 · 第三节

每一步选信息增益最大的特征

哪个问题问下去最能减少混乱,就先问哪个。

第 24 页 拿一个小例子算一遍

十位乘客,四人生还,先按哪个特征分

方案一 按性别分

女 4 人,活了 3 人
男 6 人,活了 1 人

方案二 按舱位分

头等 3 人活 2,二等 3 人活 1
三等 4 人,活了 1 人

划分方式划分前的乱划分后的乱信息增益
按性别分0.970.710.26
按舱位分0.970.880.09
性别的增益是舱位的两倍多,所以这一步先按性别分。分完之后在每一边重新算一遍,再挑下一个特征,一层一层往下切。
这些数值由课本那个式子算出,课堂上不要求手算。要看懂的是最后一栏的大小关系。

重 点每一步的做法

把所有特征都试一遍,各自算出信息增益,选最大的那个切下去。切完之后在每个子集里重复同样的过程,直到无法再切或者达到设定的深度。

打个比方

仍用猜谜游戏。问它是活的吗,能把可能性砍掉一大半。问它是不是紫色的,通常砍不掉多少。前者的信息增益大,应该先问。建树的过程就是每一步都挑那个最能缩小范围的问题。

知道更多这是一种走一步看一步的做法

每一步只选当下最好的,不考虑几步之后的情况。这样建出来的树不一定是全局最优的,但计算量可以接受。这种思路在算法里很常见。

实验里会看到,性别确实是泰坦尼克数据上最先该问的那个问题。

随堂练习

表中按性别分的信息增益是 0.26,按舱位分是 0.09。这一步应该怎么选,理由是什么?

  1. 选舱位,因为舱位分出的组数更多
  2. 选性别,因为它让数据混乱程度下降得更多
  3. 两个都选,同时切两刀
  4. 无法判断,还需要知道样本总数
查看答案
答案 B。信息增益衡量的就是混乱程度下降了多少,数值大的那个更值得先用。组数多少本身不是理由,切出来的组多但每组仍然很乱,增益照样很低。
25
第 3 章 · 第三节

决策树的非线性边界

每个判断切一刀,多刀拼起来就成了阶梯状的边界。

第 25 页课件

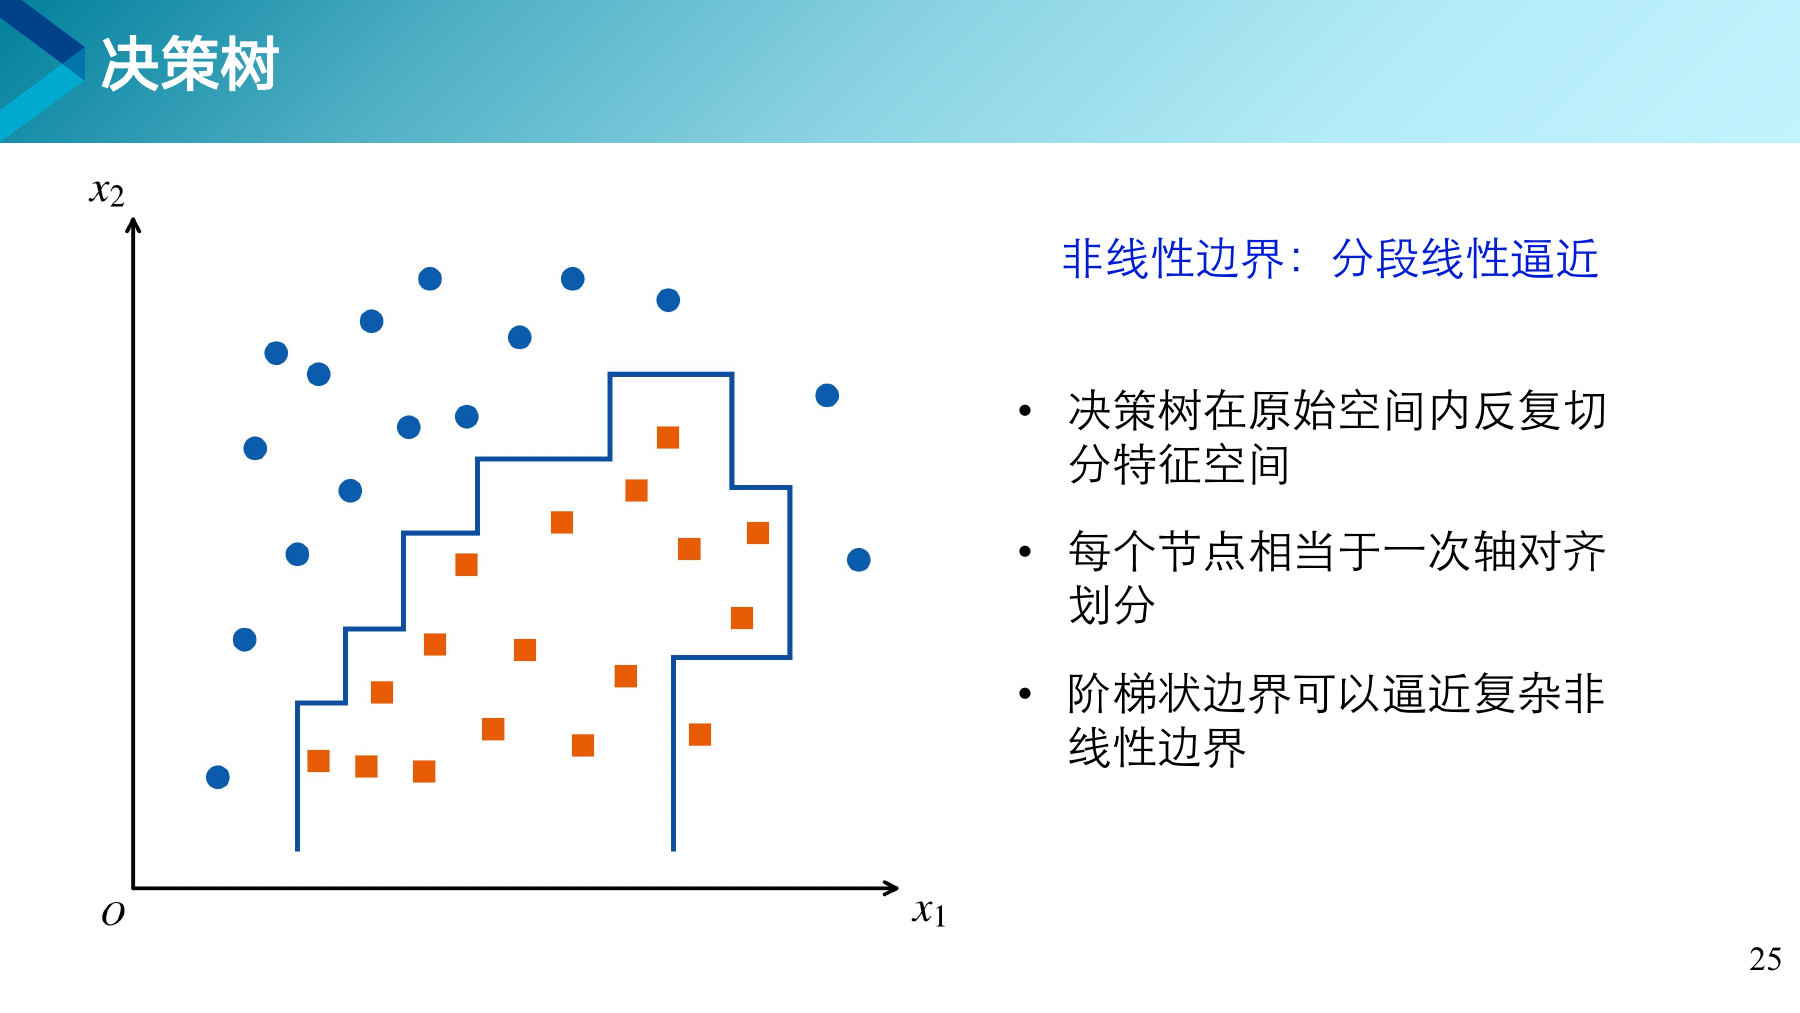
重 点边界为什么呈阶梯状

每个节点只对一个特征做判断,画在图上就是一条横线或一条竖线。多个节点对应多条这样的线,拼起来自然是阶梯形。课件上分段线性逼近这个说法很准确:单看每一段都是直的,整体却能贴合相当复杂的曲线。

打个比方

用方砖铺一条弯曲的小路。每块砖都是方的,铺出来的边缘呈锯齿状,砖越小越贴合曲线。决策树越深,切分越细,阶梯越贴近真实边界。代价是容易把训练数据里的噪声一并贴上,也就是第 2 章讲的过拟合。

知道更多三种方法的对照

逻辑回归给出一条直线,支持向量机用核函数给出一条光滑曲线,决策树用阶梯去逼近。同一件事三种做法,各有各的长处和代价。

随堂练习

把决策树的深度从 3 加到 15,最可能出现的结果是什么?

  1. 训练数据和新数据上的准确率同时提高
  2. 训练数据上的准确率提高,新数据上的反而下降
  3. 两者同时下降
  4. 两者都不变
查看答案
答案 B。树越深,越能把训练数据中每个样本的细节记住,训练集上的成绩一路走高。但这些细节里混着噪声,换到没见过的数据上并不成立,成绩反而回落。这就是过拟合,实验第 04 节会亲手把这条曲线拖出来。
保山学院·人工智能教研室·曹鼎鼎