人工智能导论 第 3 章 · 第二节
课程 › 第 3 章 › 第二节 最大间隔三个术语支持向量决定边界硬间隔软间隔线性不可分核方法核技巧替换内积常见核函数
第 3 章 机器学习基础 · 第二节

支持向量机与核方法

把边界画在最宽的地方,再想办法绕开直线的局限
本 节 知 识 点
  1. 09支持向量机
  2. 10超平面、间隔与支持向量
  3. 11支持向量决定边界位置
  4. 12最大间隔超平面的求解
  5. 13软间隔
  6. 14线性不可分
  7. 15核方法
  8. 16非线性 SVM 与核技巧
  9. 17核技巧的具体做法
  10. 18三种常见的核函数
09
第 3 章 · 第二节

支持向量机

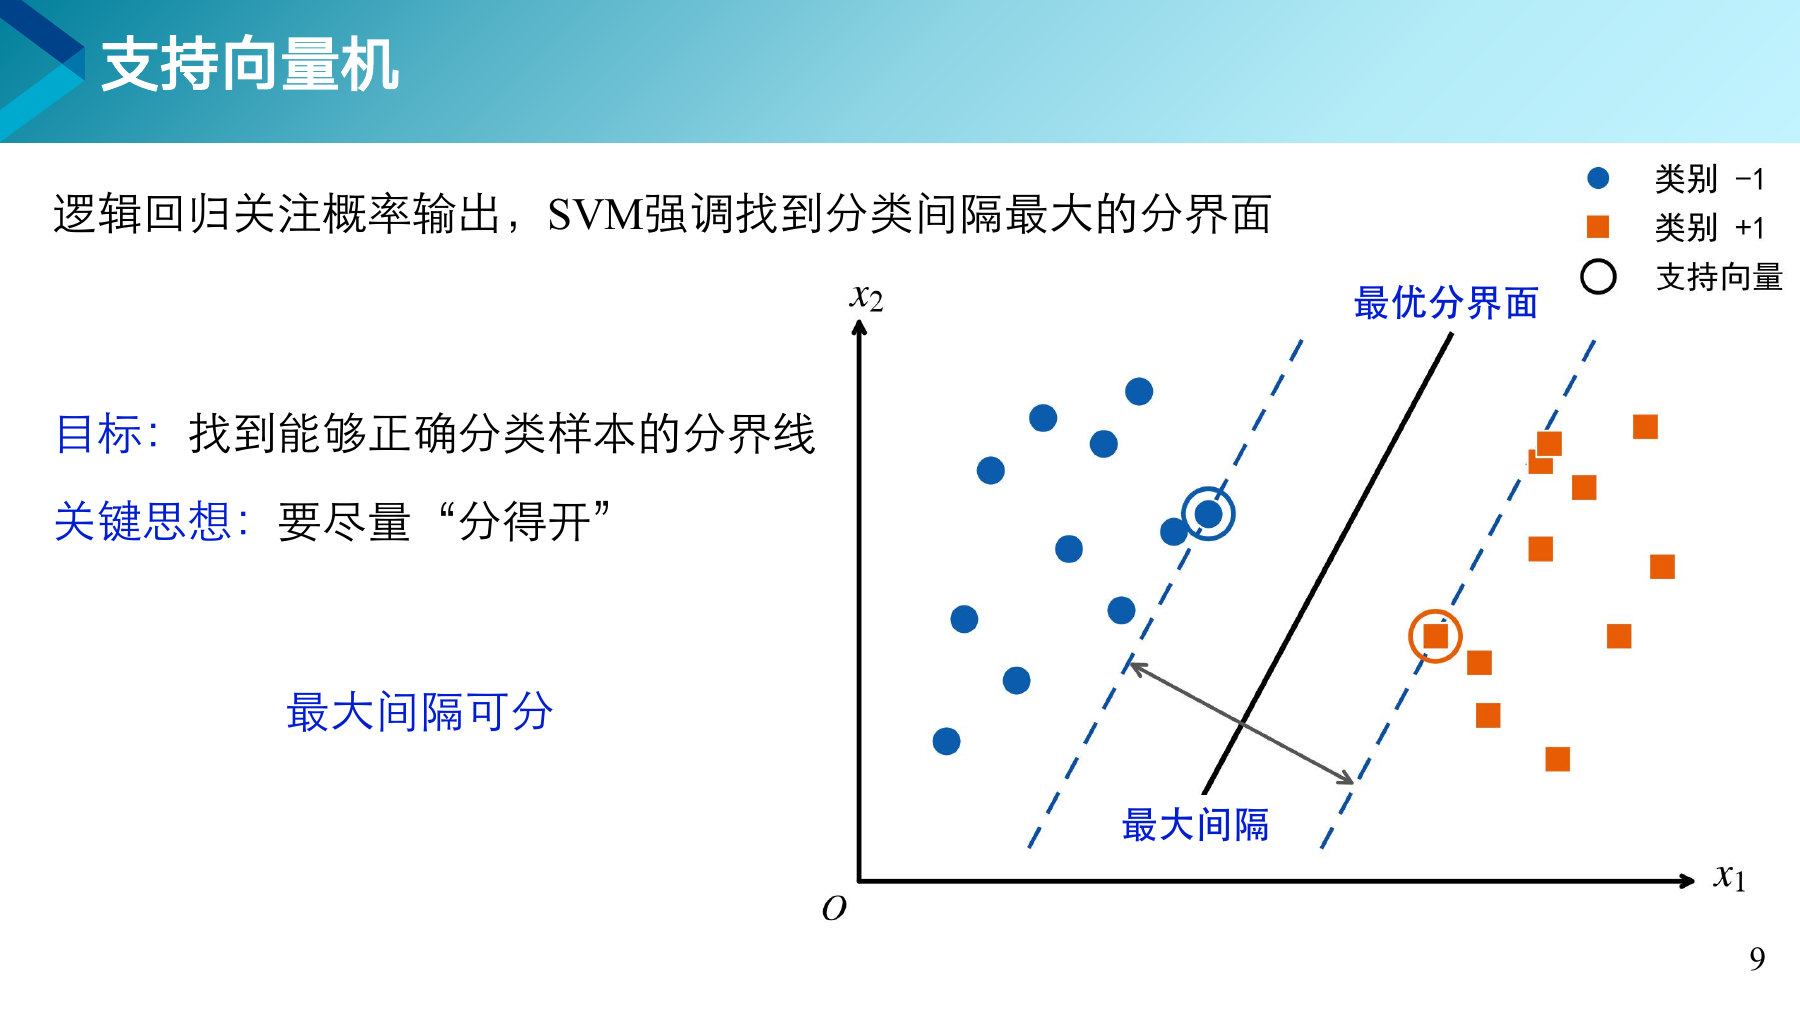
能分开的直线有无数条,要找的是离两边都最远的那一条。
第 9 页课件

关键术语

支持向量机Support Vector Machine
一种分类方法,目标是找到使两类样本间隔最大的那个分界面。

重 点分得对之外还要分得开

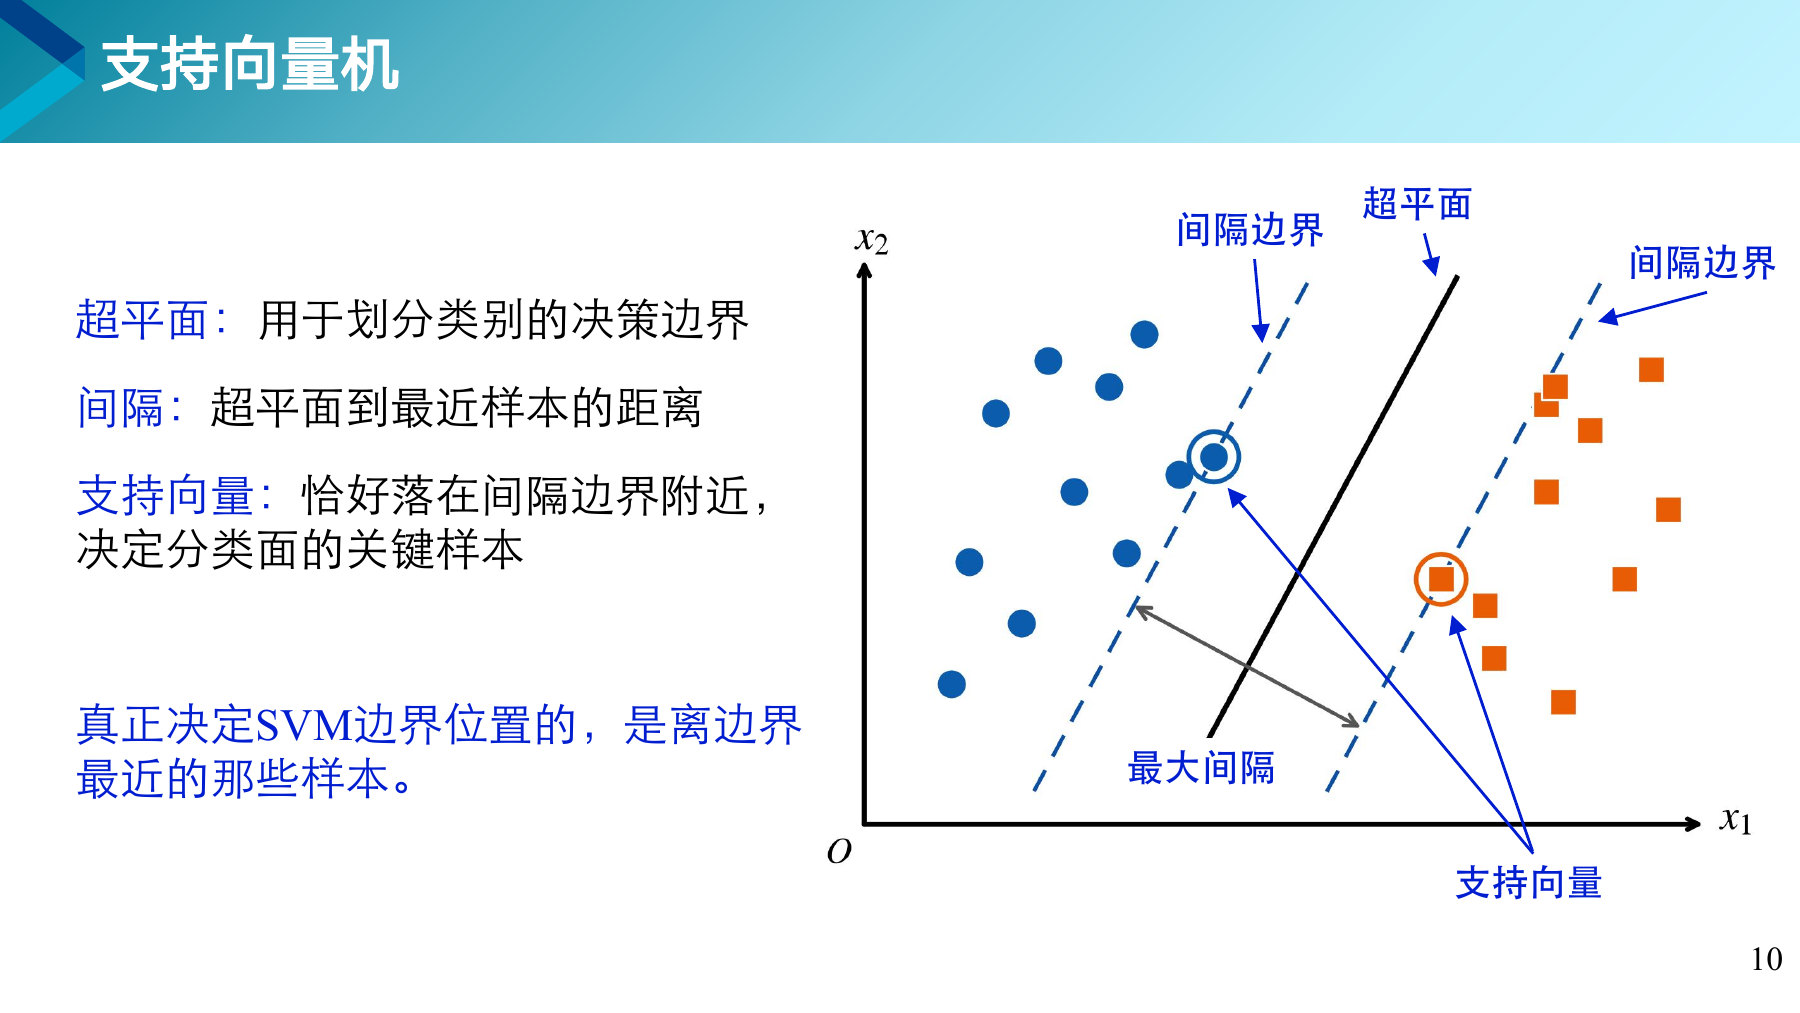
逻辑回归要求把两类分对,支持向量机在此之上还要求分得尽量开。图上实线两侧各有一条虚线,两条虚线之间的宽度称为间隔。在所有能把两类分对的直线中,支持向量机选间隔最大的那一条。

打个比方

在两排货架之间推车通过,能走的路线有很多条。贴着左边走得通,贴着右边也走得通,走正中间则留出了最大的余地。货架稍微被挪动一点,走中间的那条路仍然过得去,贴边走的就未必了。

间隔越大,遇到新样本时的容错余地越大。这是支持向量机比随便选一条可行直线更稳的原因。

随堂练习

能把两类样本分对的直线有无数条。支持向量机选哪一条?

  1. 离原点最近的那一条
  2. 让两类样本数量最均衡的那一条
  3. 到两侧最近样本的距离最大的那一条
  4. 倾斜角度最小的那一条
查看答案
答案 C。这个距离就是间隔。间隔最大意味着分界线离两边的样本都尽量远,新样本稍有偏移也不容易越过边界。A、B、D 三项与分类效果没有关系。
10
第 3 章 · 第二节

超平面、间隔与支持向量

真正决定边界位置的,只是离边界最近的那几个样本。

第 10 页课件

关键术语

超平面Hyperplane
用于划分类别的决策边界。二维里是一条直线,三维里是一个平面,更高维里称为超平面。
间隔Margin
超平面到最近样本的距离。
支持向量Support Vector
落在间隔边界上、决定分界面位置的那些关键样本。

重 点边界位置由少数样本决定

决定支持向量机边界位置的,是离边界最近的那几个样本。图上被圆圈标出的只有三四个点,其余几十个点换个位置也不会影响边界画在哪里。

打个比方

两个村子划地界,起决定作用的是两边最靠近边界的那几户人家。村子中心住得再密,也不影响界碑立在什么位置。这几户人家对应的就是支持向量,方法的名字由此而来。

随堂练习

把一个离边界很远的样本点删掉,支持向量机的边界会怎样?

  1. 边界向被删掉的那一侧移动
  2. 边界位置不变
  3. 边界的倾斜方向会改变
  4. 模型无法继续训练
查看答案
答案 B。边界只由支持向量决定,离边界远的样本不参与。删掉它,间隔和分界线都不动。反过来,删掉一个支持向量,边界通常会移动。
11
第 3 章 · 第二节

支持向量决定边界位置

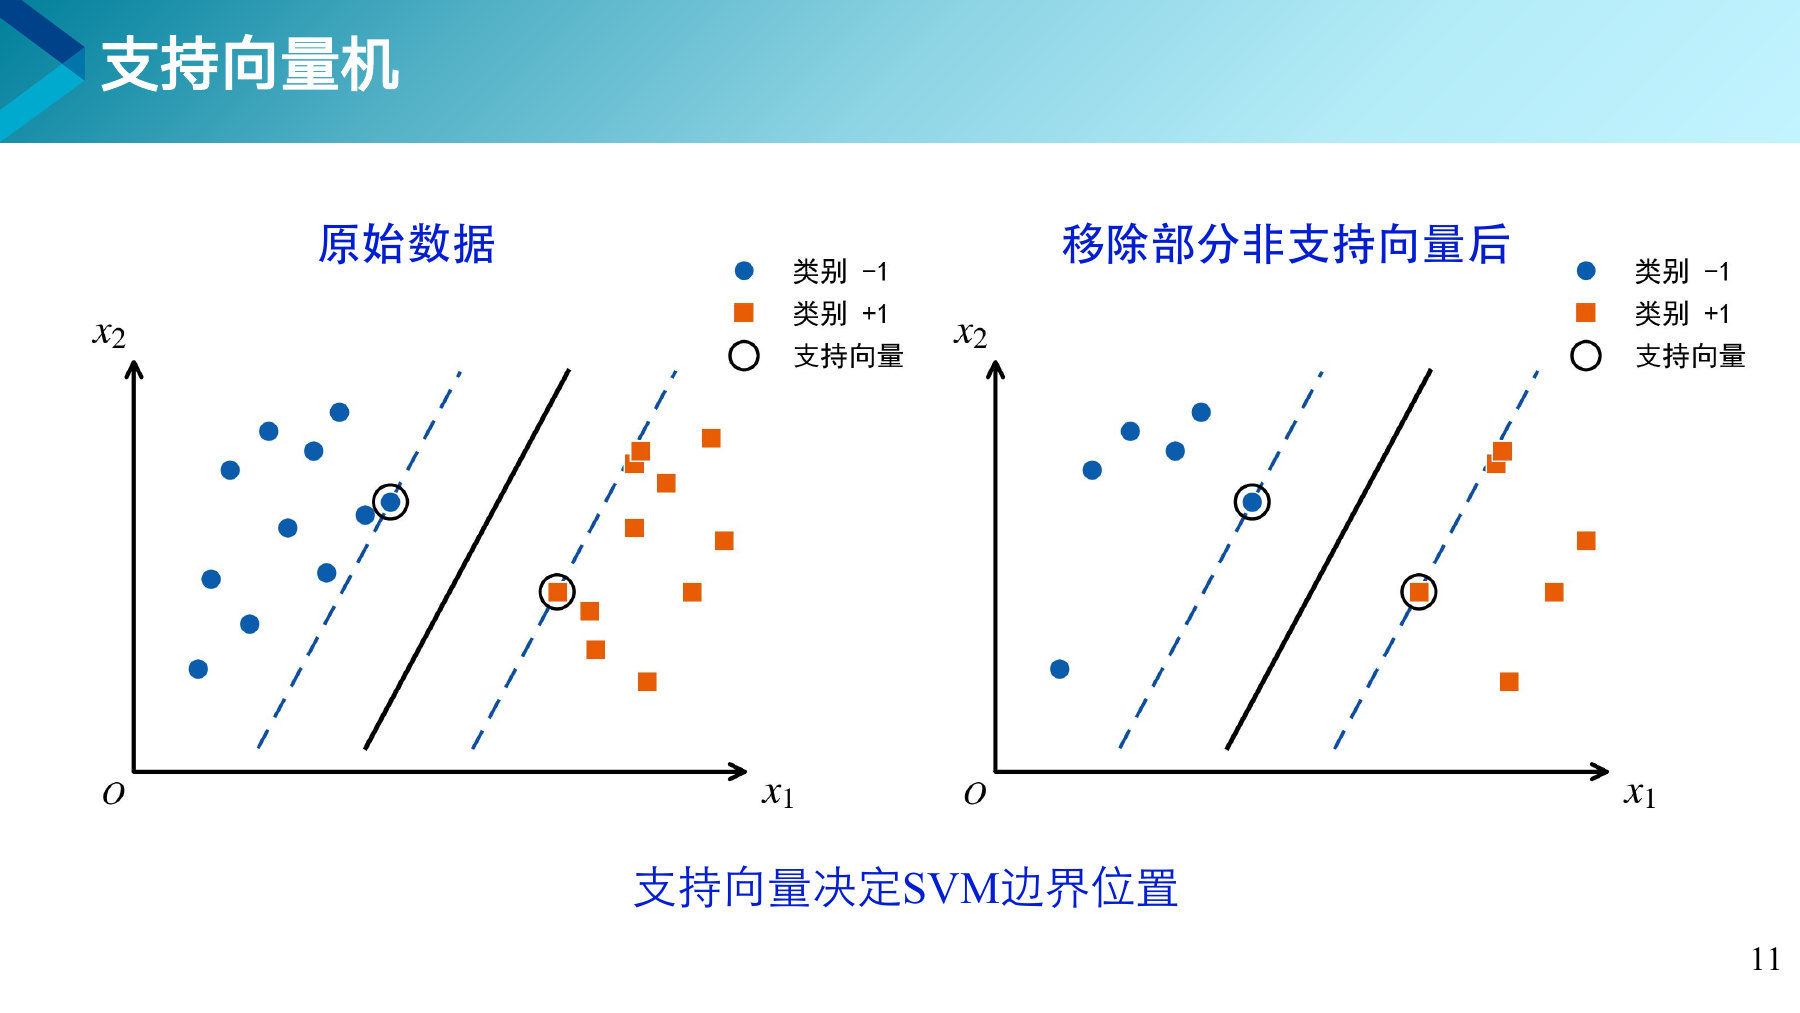
删掉大部分非支持向量,边界一动不动。

第 11 页课件

重 点两张图对照来看

左图是原始数据,右图移除了一部分非支持向量。两图中被圆圈标出的支持向量位置相同,实线和虚线的位置也没有变化。这是上一页那句话的实际验证。

知道更多由此带来的两个结果

一个是好处。模型训练完成后,只需保存那几个支持向量,其余样本可以丢掉,数据量大时能省下可观的存储。

另一个是风险。如果某个支持向量本身是一条标错的数据,整条边界会被它一个点带偏。下一页引入软间隔,处理的正是这种情况。

12
第 3 章 · 第二节

最大间隔超平面的求解

一个目标加一个条件,要找的那条线就定下来了。

第 12 页 最大间隔超平面的求解

既要分得对,也要分得开

间隔 圈出来的是支持向量
目 标

让两条虚线之间的间隔尽量宽。间隔越宽,新来的点越不容易站错队。

条 件

每一个训练样本都要分对,而且要落在自己那一侧的虚线之外。

间隔的宽窄由权重的大小决定,权重越小,间隔越宽。求解时做的事,就是在满足上述条件的前提下把权重压到尽量小。

重 点一个目标加一个条件

目标是让间隔尽量宽,条件是每个样本都要分对并落在间隔之外。课本上那一串式子表达的就是这两句话。

式子里还包含一个等价关系:让间隔最宽等价于让权重最小。推导过程属于后续课程,这里知道有这个关系即可。

打个比方

在两排货架之间划一条通道线。目标是通道尽量宽,条件是不许压到任何一个货架。两者合在一起,通道线的位置就被唯一确定下来了。

知道更多训练完成后怎么用

课本最后那个判断新样本的式子,求和只对支持向量进行,其余样本不参与计算。这再次说明整条边界是由那几个点撑起来的。

随堂练习

在硬间隔的设定下,训练数据中混进了一个标错类别的样本,会发生什么?

  1. 模型自动识别并忽略这个样本
  2. 边界被迫扭曲,间隔被压得很窄
  3. 对结果没有影响
  4. 其余样本的权重会自动归零
查看答案
答案 B。硬间隔要求每个样本都分对,标错的那个样本也必须满足。为了迁就它,边界只能挪到一个很别扭的位置,间隔随之变窄。软间隔就是为了应付这种情况提出的。
13
第 3 章 · 第二节

软间隔

现实数据总有噪声,允许个别样本越界反而更稳。

第 13 页 软间隔

允许极少数点站错队

越界了这么多 这个方块本该在右下,却跑到了左上
硬间隔

所有样本必须严格分对,一个都不许越界。碰上标错的数据,边界会被硬生生扭歪。

软间隔

允许个别样本越界,但越得越多,付出的代价越大。边界因此保持平直。

代价的轻重由一个惩罚参数控制。这个参数调得很大,接近不许越界。调得小,模型就比较宽容,间隔更宽但错分的点更多。

关键术语

硬间隔Hard Margin
要求所有样本严格分对,不允许任何样本越界。
软间隔Soft Margin
允许个别样本越界,越界的程度会被记录下来,再用一个参数控制这笔账算得多重。

重 点多出来的是一笔账

软间隔在原来的目标上增加了一项,用来记录所有越界的总量。惩罚参数决定这一项在总目标里占多大分量。参数取值越大越接近硬间隔,取值越小模型越宽容,间隔更宽但分错的点更多。

打个比方

两个村子之间划地界,如果有一户人家孤零零建在对面村子里,硬要把界线绕过去,界线就会变得歪歪扭扭,其余几百户的归属反而更容易出错。软间隔的做法是承认这一户属于例外,界线该怎么直还怎么直。

为迁就一个异常点而扭曲整条边界,代价往往大于收益。这与第 2 章讲过的过拟合是同一个道理。

随堂练习

把惩罚参数调得很小,模型会朝哪个方向变化?

  1. 间隔变窄,训练集上分错的点变少
  2. 间隔变宽,训练集上分错的点变多
  3. 间隔和错分点都不变
  4. 模型退化成硬间隔
查看答案
答案 B。参数小意味着越界的代价低,模型愿意放几个点越界来换一条更宽更平直的边界。参数调到很大时才接近硬间隔,也就是 D 描述的情况。
14
第 3 章 · 第二节

线性不可分

有些数据无论怎么摆直线都分不开。

第 14 页课件

重 点两张图是两种典型情况

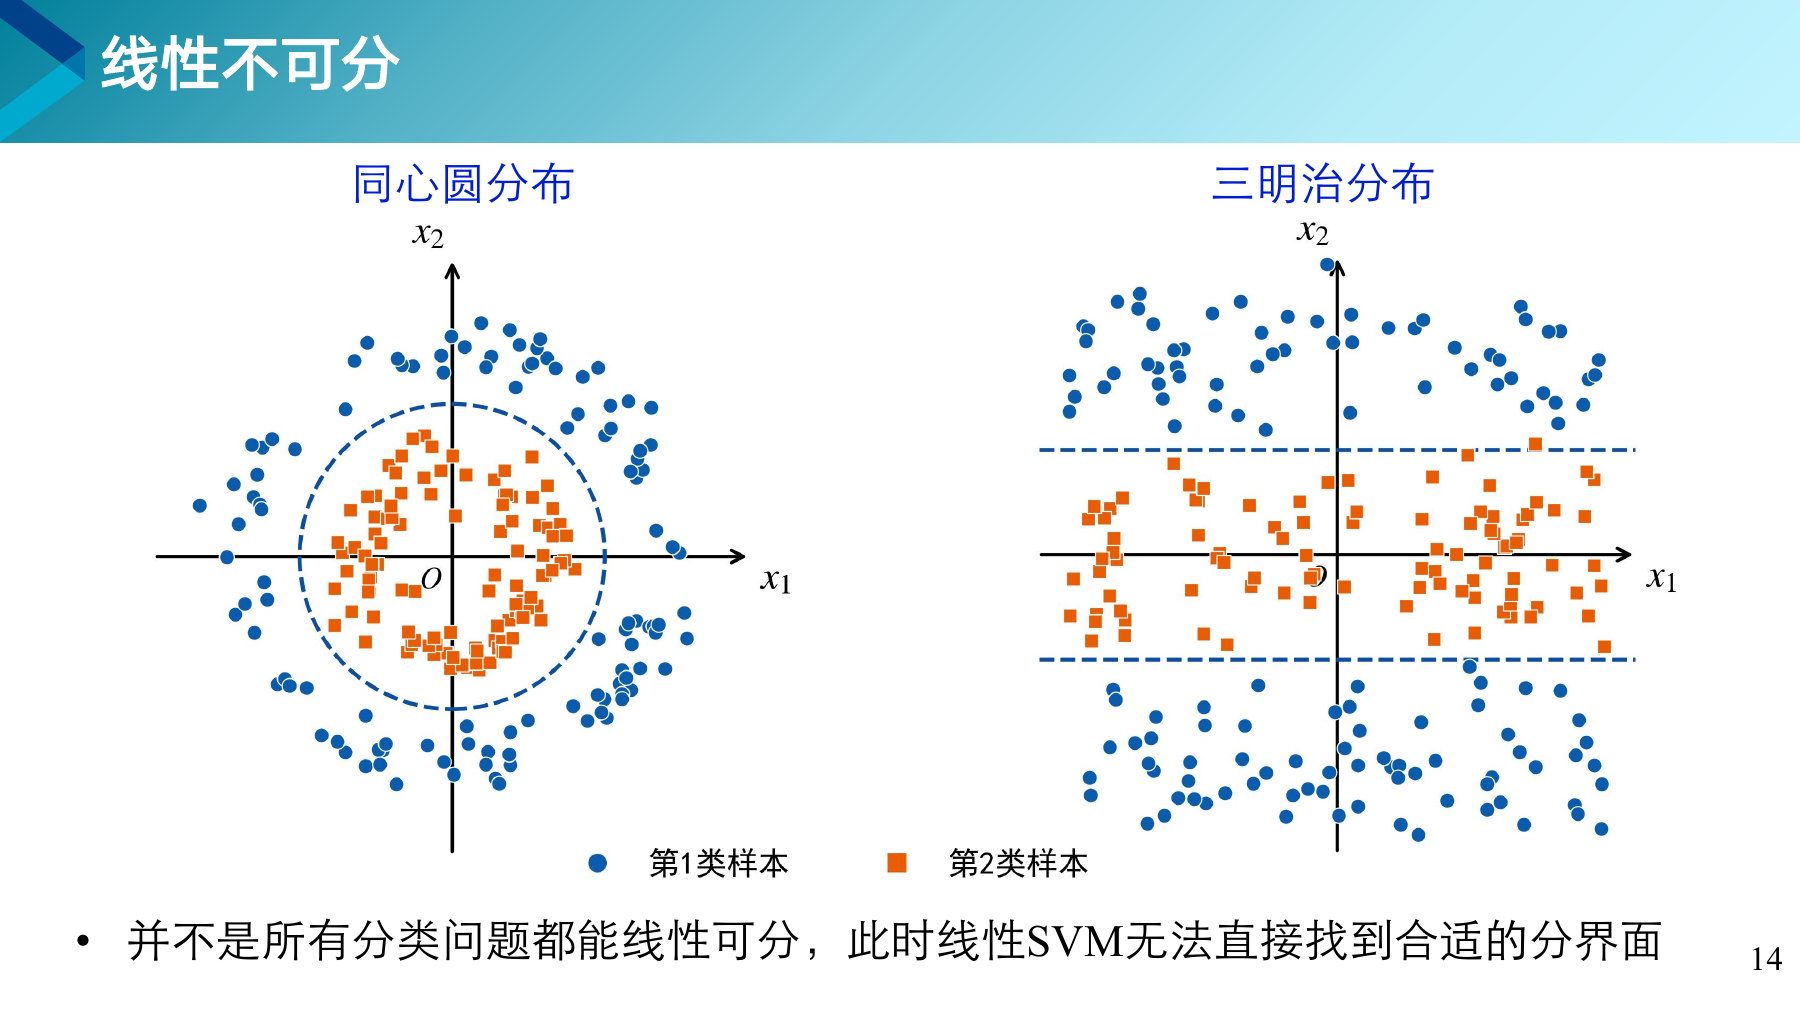
左图是同心圆分布,一类在中间一类在外圈。右图是交替成层的分布,两类像三明治一样夹在一起。这两种情况下,直线无论摆在哪个角度都分不干净。

打个比方

用一把直尺去分甜甜圈的内圈和外圈,怎么摆都做不到。问题不在尺子长短,而在于这件事用直线完不成。出路有两条,一条是换一件能弯的工具,另一条是想办法让问题本身变直。下一页走的是第二条。

知道更多这两种分布并不少见

同心圆的形状在实际数据里经常出现。判断一个零件是否合格,往往要求各项指标都落在中间范围,偏大偏小都算不合格,画出来就是一类被另一类围在中间。交替成层的分布则常见于带有周期性的数据。

15
第 3 章 · 第二节

核方法

在低维分不开的,升到高维往往就分得开了。

第 15 页课件

重 点图上那个箭头

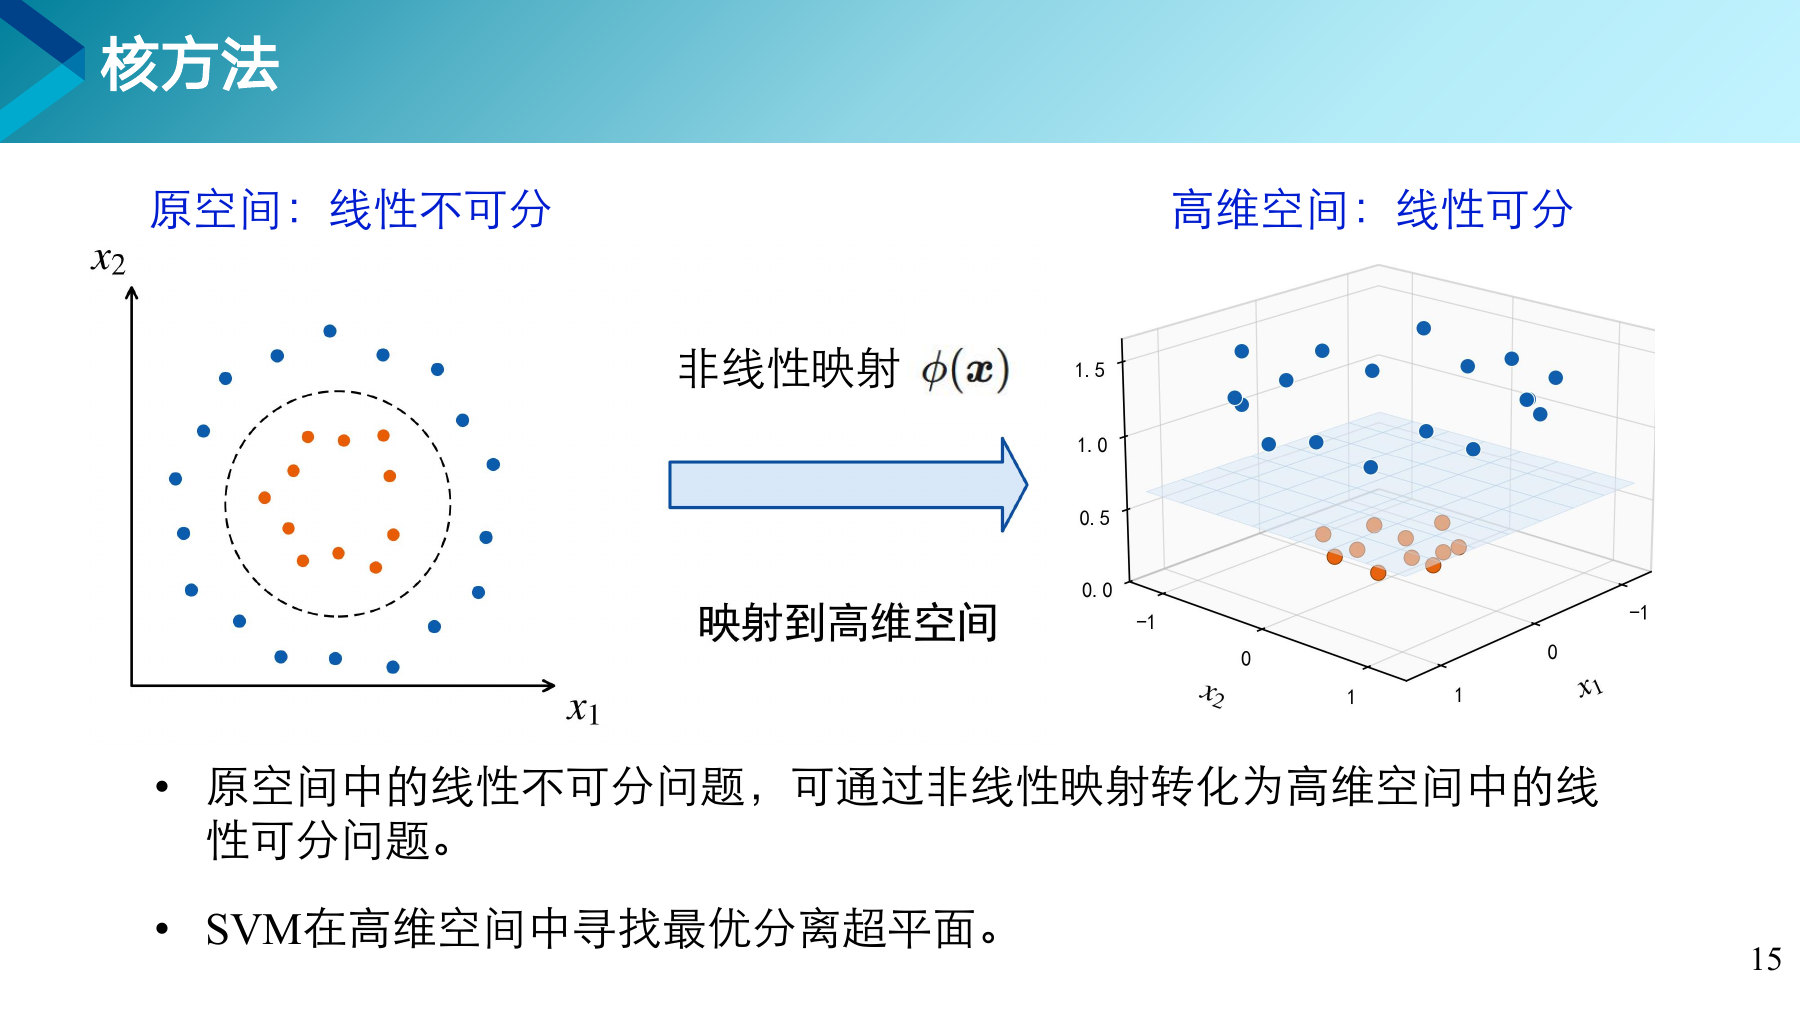
左边的原空间里两类一圈套一圈,直线分不开。经过一次非线性映射升到高维之后,右边的点分成了上下两层,一个平面就能切开。数据本身没有变,变的是观察它的角度。

打个比方

桌面上撒着一圈红豆和一圈绿豆,同心圆分布,用尺子分不开。把中间的红豆整体抬高一点,从侧面看过去,红豆在上绿豆在下,一张纸就能隔开。抬高这个动作对应的就是升维,多出来的那个高度是原来没有的一维。

知道更多高度按什么规则定

在同心圆这个例子里,高度可以取每个点到圆心的距离。里圈的点距离小,外圈的点距离大,按这个高度抬起来,两类自然分成了上下两层。选什么规则来升维,决定了升维之后好不好分。

16
第 3 章 · 第二节

非线性 SVM 与核技巧

不真的升维,只算升维之后的结果。

第 16 页 非线性 SVM 与核技巧

升维有用,直接算却代价太高

上一页说把数据升到高维就能分开。问题是维度可能升到几百、几千甚至无穷,把每个样本在高维里的坐标一个个算出来,计算量根本扛不住。
老老实实升维

先把每个样本搬到高维空间,算出它在那里的全部坐标,再拿这些坐标去分类。维度一高就算不动了。

用核函数

根本不去算坐标。两个样本的原始数值往核函数里一代,直接得到它们在高维空间里的关系。

两条路得到的结果相同,右边这条省掉了升维那一步,这个办法称为核技巧。

关键术语

核技巧Kernel Trick
不真的把数据搬到高维,而是用一个函数直接算出它们在高维空间里的关系。
核函数Kernel Function
承担上述计算的那个函数。输入是两个原始样本,输出是一个衡量它们关系的数。

重 点升维有用,但直接算代价太高

升维本身不难,难的是维度一高,要算的量成倍增长,升到几百几千维时逐个算出坐标已不现实。核技巧绕开了这一步,直接得到升维之后需要的那个结果。

打个比方

想知道两位住户在一栋高楼里相距多远,常规做法是先把两人分别送上楼,量出各自的位置,再算距离。核技巧相当于找到了一个公式,在楼下根据两人的房间号直接算出楼上的距离,人不用上楼。得到的结果一样,省掉的是上楼这一步。

随堂练习

关于核技巧,下面哪一种说法是对的?

  1. 它把数据搬到高维空间之后再分类
  2. 它不计算高维坐标,直接算出两个样本在高维空间里的关系
  3. 它通过删除特征来降低计算量
  4. 它只能用在数据本来就线性可分的情况下
查看答案
答案 B。核技巧的价值就在于跳过了升维这一步。A 是它要避开的常规做法,C 说的是降维,D 说反了,核技巧正是为线性不可分的数据准备的。
17
第 3 章 · 第二节

核技巧的具体做法

式子只换掉一处,边界就从直线变成了曲线。

第 17 页 核技巧的具体做法

整条式子只改一处

  • 线性 SVM 判断一个新样本时,要算它和每个支持向量直接比出来的关系。
  • 非线性 SVM 把上面那处换成核函数算出来的关系,其余部分一字不改。
没变的部分

有哪些支持向量、每个支持向量占多大分量、最后怎么根据正负判类别,全都照旧。

变了的部分

只有衡量两个样本关系的那一处。换成核函数之后,等于在高维空间里比,边界就能是弯的。

正因为只改一处,已经写好的线性 SVM 程序换一个函数就成了非线性 SVM。

重 点课本上用红色标出的就是全部改动

线性支持向量机的式子里,这一处是两个样本直接比出来的关系。非线性支持向量机把它换成核函数,式子的其余部分没有改动。整个非线性化就是这一步替换。

打个比方

给相机换镜头。机身、快门、操作方式都不动,只把标准镜头换成广角镜头,能拍到的画面范围就完全不同。核函数相当于这个可换的镜头,换不同的核就能应付不同形状的数据。

知道更多替换为什么能这么干净

线性支持向量机的式子里,样本始终以两两比较的形式出现,没有单独用到某一个样本的坐标。正因如此,只要把比较的方式换掉,整个方法就搬到了高维空间,别的地方一处都不用改。

18
第 3 章 · 第二节

三种常见的核函数

换不同的核,就是换不同的看数据的方式。

第 18 页 三种常见的核函数

选核就是选一种比较两个样本的方式

核函数它在衡量什么什么时候用
多项式核把几个特征凑在一起相乘,看它们配合起来的效果特征之间明显互相牵连的数据
高斯核两个样本离得近就算像,离得远就算不像最常用,拿不准时先试它
Sigmoid 核形式上接近神经网络里的一道换算用得较少
高斯核用得最多,原因是离得近就算像、离得远就算不像这个判断方式与人的直觉接近,对大多数数据都管用。
实际用的时候,先拿高斯核跑一遍作为基准,再看换别的核有没有明显提升,这是常见的做法。

重 点三句直观理解

多项式核适合特征之间存在配合关系的数据。高斯核按样本之间的远近衡量相似程度,是实际中最常用的一个。Sigmoid 核的形式接近神经网络里的一道换算,使用较少。

三个核的具体表达式属于后续课程内容,选核时记住这三句即可。

打个比方

高斯核判断两个样本像不像,用的是离得近就算像、离得远就算不像。这与人判断东西像不像的方式接近,对大多数数据都管用,因此在实践中用得最多。

知道更多课本那张表有一处笔误

原课件表达式一列中,高斯核与 Sigmoid 核的式子印反了。带指数的那个是高斯核,带 tanh 的那个是 Sigmoid 核。右边直观理解一栏是对的,对照着看不会出错。

随堂练习

拿到一份新数据,不清楚该用哪个核。通常的做法是什么?

  1. 直接用 Sigmoid 核,它最通用
  2. 先用高斯核跑一遍作为基准,再看换别的核有没有提升
  3. 把三个核的结果加起来求平均
  4. 核的选择对结果没有影响,随便选一个
查看答案
答案 B。高斯核适用面广,适合作为第一个基准。有了基准才能判断换核到底有没有带来提升。Sigmoid 核实际用得最少,核的选择对结果影响明显,所以 A、C、D 都不合适。
保山学院·人工智能教研室·曹鼎鼎