人工智能导论 第 3 章 · 第一节
课程 › 第 3 章 › 第一节 章首经典统计学习回顾三要素三条路线逻辑回归用概率描述Sigmoid决策边界
第 3 章 机器学习基础 · 第一节

从统计学习说起

三条路线,以及最基础的逻辑回归
本 节 知 识 点
  1. 01第 3 章 机器学习基础
  2. 02经典统计学习
  3. 03回顾:AI 学习三要素
  4. 04机器学习的三条路线
  5. 05从线性回归到逻辑回归
  6. 06逻辑回归的基本思想
  7. 07Sigmoid 函数
  8. 08逻辑回归的决策边界
01
第 3 章 · 第一节

第 3 章 机器学习基础

第 2 章把题目列成了数学式,这一章讲具体有哪些解题方法。
第 1 页课件

知道更多本章的七节内容

前五节讲经典统计学习,内容包括逻辑回归、支持向量机、决策树这三种监督方法,聚类与降维这两种无监督方法,以及模型评估。后两节讲强化学习,也就是第 1 章提到的那条靠试错来学的路线。

知道更多这些方法今天的位置

本章介绍的方法大多在深度学习之前就已成熟,目前仍在大量使用。它们的推导过程清晰,结论可以向人解释,在需要说明判断依据的场合有明显优势。

它们对数据量的要求也低得多。几百条样本就能训练出可用的模型,这一点在医学、地质等数据获取成本较高的领域很重要。
02
第 3 章 · 第一节

经典统计学习

从有限的样本中总结规律,这是统计学习要解决的问题。

第 2 页课件

重 点样本有限,情况无限

机器能看到的样本数量是有限的,而它将来要应付的情况没有边界。统计学习要回答的问题是,手上只有几百几千条数据,凭什么相信从中总结出来的规律,换一批没见过的数据仍然成立。

打个比方

根据一个班期中考试的成绩去估计这个班期末能考成什么样。看过的人越多,估计越有底气,但不可能把全班将来每一次考试都提前看一遍。

机器学习把见过的那部分数据称为训练数据,没见过的称为测试数据。这两个词在后面每一节和实验里都会用到。

03
第 3 章 · 第一节

回顾:AI 学习三要素

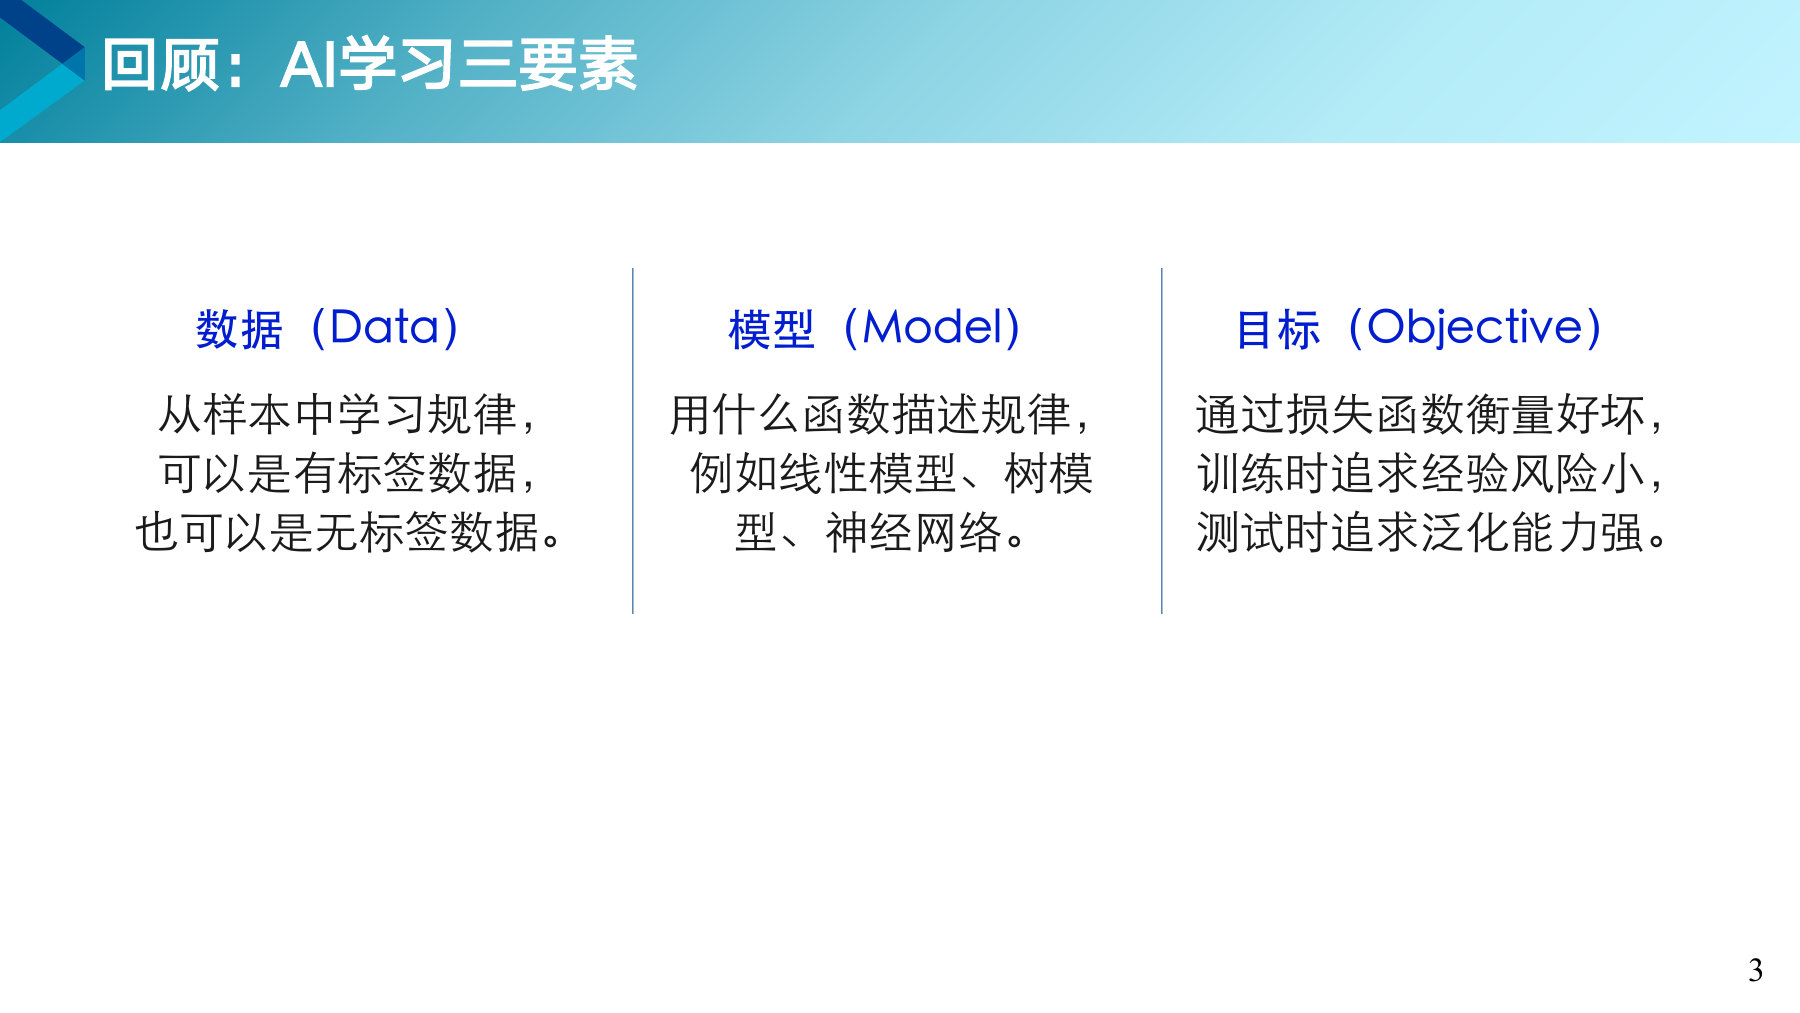
数据、模型、目标,第 2 章的框架继续用。

第 3 页课件

重 点三要素在本章的用法

后面介绍的每一种方法,都可以放进这三栏里对照:它用什么数据(有标签还是无标签),它用什么方式描述规律(一条直线、一棵树还是一张网络),它拿什么衡量好坏。方法在变,这三栏不变。

知道更多有标签与无标签

有标签(labeled)指每个样本都配了要预测的那个答案,比如照片旁边注明了拍的是猫。无标签(unlabeled)指只有样本没有答案,规律要由机器自己找。本章前三节讲前一种,第四节讲后一种。

随堂练习

下面哪一项属于有标签数据?

  1. 一万张风景照片,没有任何说明
  2. 一万张风景照片,每张都注明了是白天还是夜晚
  3. 一万条商品评论的原始文字
  4. 一万个手机号码
查看答案
答案 B。有标签的含义是每个样本都带着要预测的那个答案。B 里的白天或夜晚就是这个答案,可以直接拿来训练。其余三项都只有样本本身,没有配上答案。
04
第 3 章 · 第一节

机器学习的三条路线

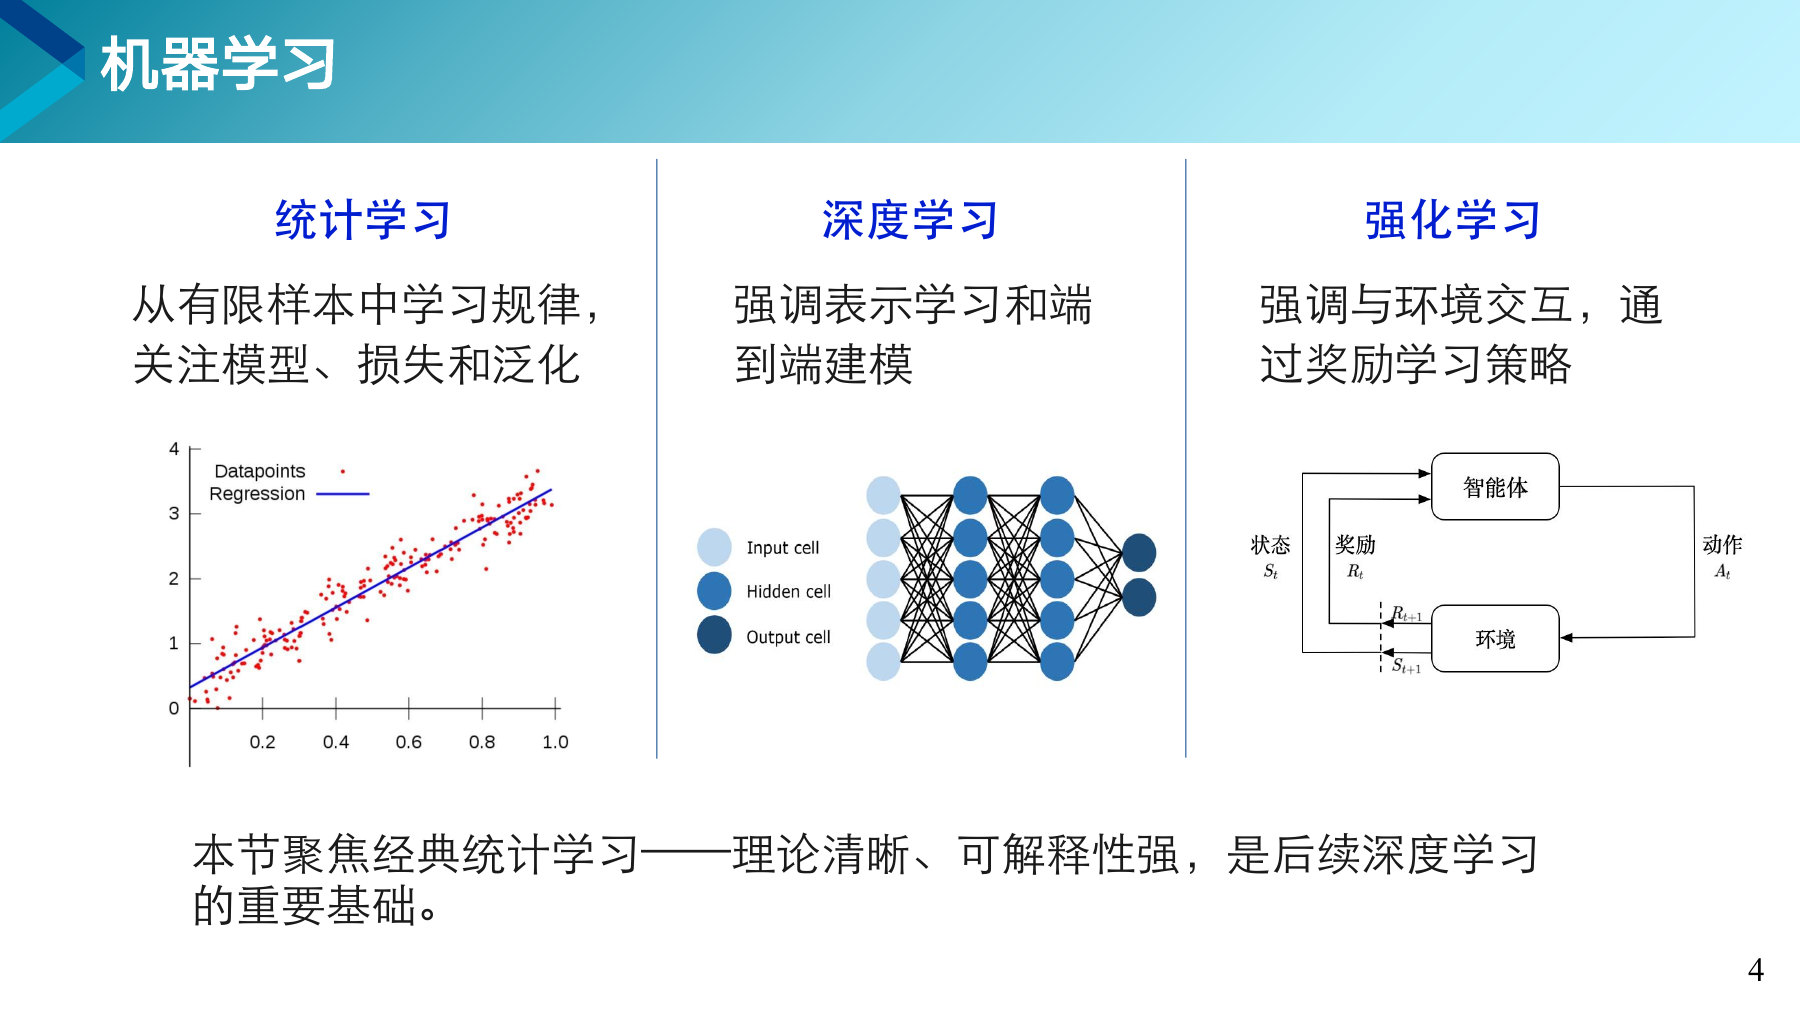
统计学习、深度学习、强化学习,各自解决不同形态的问题。

第 4 页课件

重 点三条路线各自的特点

统计学习从有限样本中总结规律。深度学习让机器自己从原始数据里找出该关注哪些特征。强化学习通过与环境反复打交道,从奖励中学出一套行动策略。本章讲第一条和第三条,第二条从第 4 章开始展开。

打个比方

统计学习像做一本带答案的练习册,题量不多,每道题做完都能对答案。深度学习像大量刷题,题目多到自己总结出了套路,说不太清楚但用得出来。强化学习像下棋,过程中没有人告诉你每一步对不对,只有最后的输赢能说明前面那几十步走得怎么样。

知道更多可解释性

页面底部提到本节聚焦经典统计学习,理由是这些方法理论清晰、可解释性强。可解释性指的是能说明白模型为什么给出这个结论。在医疗、司法、信贷这些需要向当事人交代判断依据的场合,这一点往往比准确率高一两个百分点更有价值。

05
第 3 章 · 第一节

从线性回归到逻辑回归

名字里带着回归,做的却是分类。

第 5 页 从线性回归到逻辑回归

比线性回归多了一道换算

加权求和每个特征乘一个
重要程度再加起来
→
换算一道把算出来的分数
压进 0 到 1
→
得到概率这个样本属于
正类的可能性
线性回归逻辑回归
输出是什么一个连续的数值一个 0 到 1 的概率
做什么任务预测数值判断类别
怎么算错得多离谱看预测值差了多少看概率给得有多偏
两者的前半段相同,逻辑回归在最后多加了一道把分数变成概率的换算。

重 点两者的差别在最后一步

线性回归算出一个数就交卷,逻辑回归把这个数再换算一次,变成 0 到 1 之间的概率。前面加权求和的部分,两者完全相同。逻辑回归可以看作线性回归接上了一个新的出口。

表格最后一行提到两种衡量错误的方式。预测数值时看差了多少,判断类别时看概率给得有多偏,这两件事用的不是同一把尺子。

打个比方

一场考试的总分是把各科成绩按不同权重加起来得到的,这一步相当于加权求和。如果要回答的不是考了多少分,而是这个学生有多大把握及格,就要把总分再换算成一个百分比。逻辑回归多出来的正是这道换算。

随堂练习

用逻辑回归判断一封邮件是不是垃圾邮件,模型直接输出的是什么?

  1. 是或者不是
  2. 一个 0 到 1 之间的数
  3. 这封邮件的字数
  4. 一个可正可负的分数
查看答案
答案 B。模型先算出一个可正可负的分数,这是 D 描述的中间结果,再换算成 0 到 1 之间的概率交出来。要得到 A 那样的结论,还需要拿这个概率去和一道门槛比较。
06
第 3 章 · 第一节

逻辑回归的基本思想

不直接给答案,先给一个属于正类的概率。

第 6 页 用概率描述分类结果

模型做的是两件事

第一步 算分

把每个特征乘上它的权重,全部加起来,再加上一个偏置,得到一个分数。分数可大可小,可正可负。

第二步 换算

把这个分数换算成一个 0 到 1 之间的数,当作这个样本属于正类的概率。

  • 权重 表示每个特征有多重要。数值为正说明这个特征越大越倾向正类,为负则相反。
  • 偏置 一个整体的起点,相当于还没看任何特征之前的基础倾向。
  • 要学的全部东西 就是这些权重和这个偏置,再没有别的了。
概率算出来之后,超过 0.5 判正类,低于 0.5 判负类。0.5 是最常用的一道门槛。

重 点模型输出的是可能性

逻辑回归交出来的是这个人会买的可能性有多大,而把可能性转成结论要再过一道门槛,常用的门槛是 0.5。模型训练过程中要确定的量,就是每个特征的权重和一个偏置。

打个比方

医生看化验单的过程与此接近。每项指标乘一个重要程度加起来得到一个总分,再把总分换算成患病可能性有多大。权重相当于各项指标的重要程度,偏置相当于这个人群本身的基础风险。

知道更多门槛是人定的

0.5 是默认值,不是规定。门槛定在哪里取决于两种错误的代价:漏掉一个的代价大,就把门槛调低。虚报一次的代价大,就把门槛调高。实验里会看到调整门槛对结果的影响。

随堂练习

某医院用模型筛查一种早发现就能治好、漏诊后果严重的疾病。门槛应该怎么定?

  1. 保持 0.5 不动
  2. 调高到 0.8,减少虚报
  3. 调低到 0.3,宁可虚报也不漏掉
  4. 门槛由模型自己决定,人改不了
查看答案
答案 C。漏诊的代价远大于虚报一次。把门槛调低,会有更多人被划进需要进一步检查的范围,漏掉的人就少了。代价是虚报增多,这些人多做一次检查即可排除。门槛由使用者根据代价来定。
07
第 3 章 · 第一节

Sigmoid 函数

把分数变成概率的那道换算。

第 7 页 Sigmoid 函数

一条把任何数都压进 0 到 1 的曲线

1 0.5 0 分数为 0 的地方 分数越来越大 → ← 分数越来越小
  • 分数很大的时候,曲线贴近 1,也就是几乎可以肯定属于正类。
  • 分数很小的时候,曲线贴近 0,也就是几乎可以肯定不属于。
  • 分数正好是 0 的时候,曲线穿过 0.5,两边的可能性一样大。
曲线一路往上走,中间没有任何突然的跳跃,这一点在后面讲模型怎么调整参数时很要紧。

关键术语

Sigmoid 函数Sigmoid Function
一条 S 形曲线,作用是把任意大小的数换算成 0 到 1 之间的数。

重 点曲线上的三个位置

分数很大时曲线贴近 1,分数很小时贴近 0,分数等于 0 时正好穿过 0.5。因此分数大于零和概率大于 0.5 说的是同一件事,判断类别时看哪一个都可以。

打个比方

还用上一页那场考试。总分可以从 0 分到 150 分,跨度很大。换算成有多大把握及格之后,结果被限制在 0 到 100% 之间。分数再高,把握也只能接近 100%,不会超出去。Sigmoid 做的就是这种压缩。

知道更多曲线为什么要光滑

第 2 章讲过模型靠坡度来决定参数往哪个方向调。如果这道换算是一刀切的台阶,台阶面上处处是平的,坡度为零,模型就得不到往哪边挪的提示。光滑的曲线处处都有坡度,参数才调得动。

随堂练习

一个样本算出来的分数正好是 0,经过 Sigmoid 换算之后的概率是多少?

  1. 0
  2. 0.5
  3. 1
  4. 条件不足,无法确定
查看答案
答案 B。曲线在分数为 0 的位置穿过 0.5,这个值与具体是哪个样本、有多少个特征都无关。它也是决策边界的由来:分数为 0 的那些位置,概率恰好都是 0.5。
08
第 3 章 · 第一节

逻辑回归的决策边界

概率等于 0.5 的那条线,就是模型把两类切开的地方。

第 8 页 逻辑回归的决策边界

概率正好 0.5 的地方连成一条线

这一侧概率大于 0.5 这一侧概率小于 0.5 概率正好 0.5 的那条线
把概率等于 0.5 的所有位置标出来,它们连成的就是图上这条虚线。线的一侧判一类,另一侧判另一类。
模型学到的内容,从图上看就是这条线摆在哪、朝哪个方向斜。逻辑回归画出来的边界是直的。

重 点模型学到的是这条线的位置

训练逻辑回归,表面上是在调权重和偏置,从图上看就是在挪动这条线的位置和倾斜方向,直到两类点尽量落在各自该在的一侧。权重决定线朝哪个方向斜,偏置决定线整体往哪边平移。

打个比方

在操场上拉一条绳子把人分成两队。绳子摆在什么位置、朝哪个方向,由权重和偏置决定。这种做法的限制也很清楚:绳子是直的,遇到两队人交错站位的情况就分不开。

知道更多这个限制引出下一节

直线分不开的数据,逻辑回归处理不了,这与第 1 章讲感知机时遇到的是同一个问题。接下来的支持向量机先把这条线画得更讲究,再用核方法绕开这个限制。

随堂练习

下面哪一种数据,逻辑回归比较难处理好?

  1. 两类点各自聚成一团,中间隔着一条空带
  2. 一类点围成一圈,另一类点落在圈子中间
  3. 两类点沿着一条斜线分开
  4. 两类点数量相差很多,但仍能用直线分开
查看答案
答案 B。逻辑回归画出来的边界是一条直线,圈里圈外这种分布没有哪条直线能分干净。A、C、D 三种情况都存在一条可用的直线,其中 D 只是两类数量不均衡,不影响直线的存在。
保山学院·人工智能教研室·曹鼎鼎