人工智能导论 第 8 章 · 第九节
课程 › 第 8 章 › 第九节 公平性演进公平性定义责任归属社会公平透明度价值对齐对齐路径
第 8 章 人工智能前沿技术 · 第九节

公平性、透明度与价值对齐

什么算公平,谁来负责,怎么让AI听懂真意图
本 节 知 识 点
  1. 67AI 公平性研究的演进
  2. 68公平性的定义之争
  3. 69责任归属问题
  4. 70AI 与社会公平
  5. 71透明度与可解释性问题
  6. 72AI 价值对齐
  7. 73价值对齐的技术路径
67
第 8 章 · 第九节

AI 公平性研究的演进

从静态数据修正逐步发展为动态因果建模与实时评估。
第 67 页课件

重 点图上那四个阶段

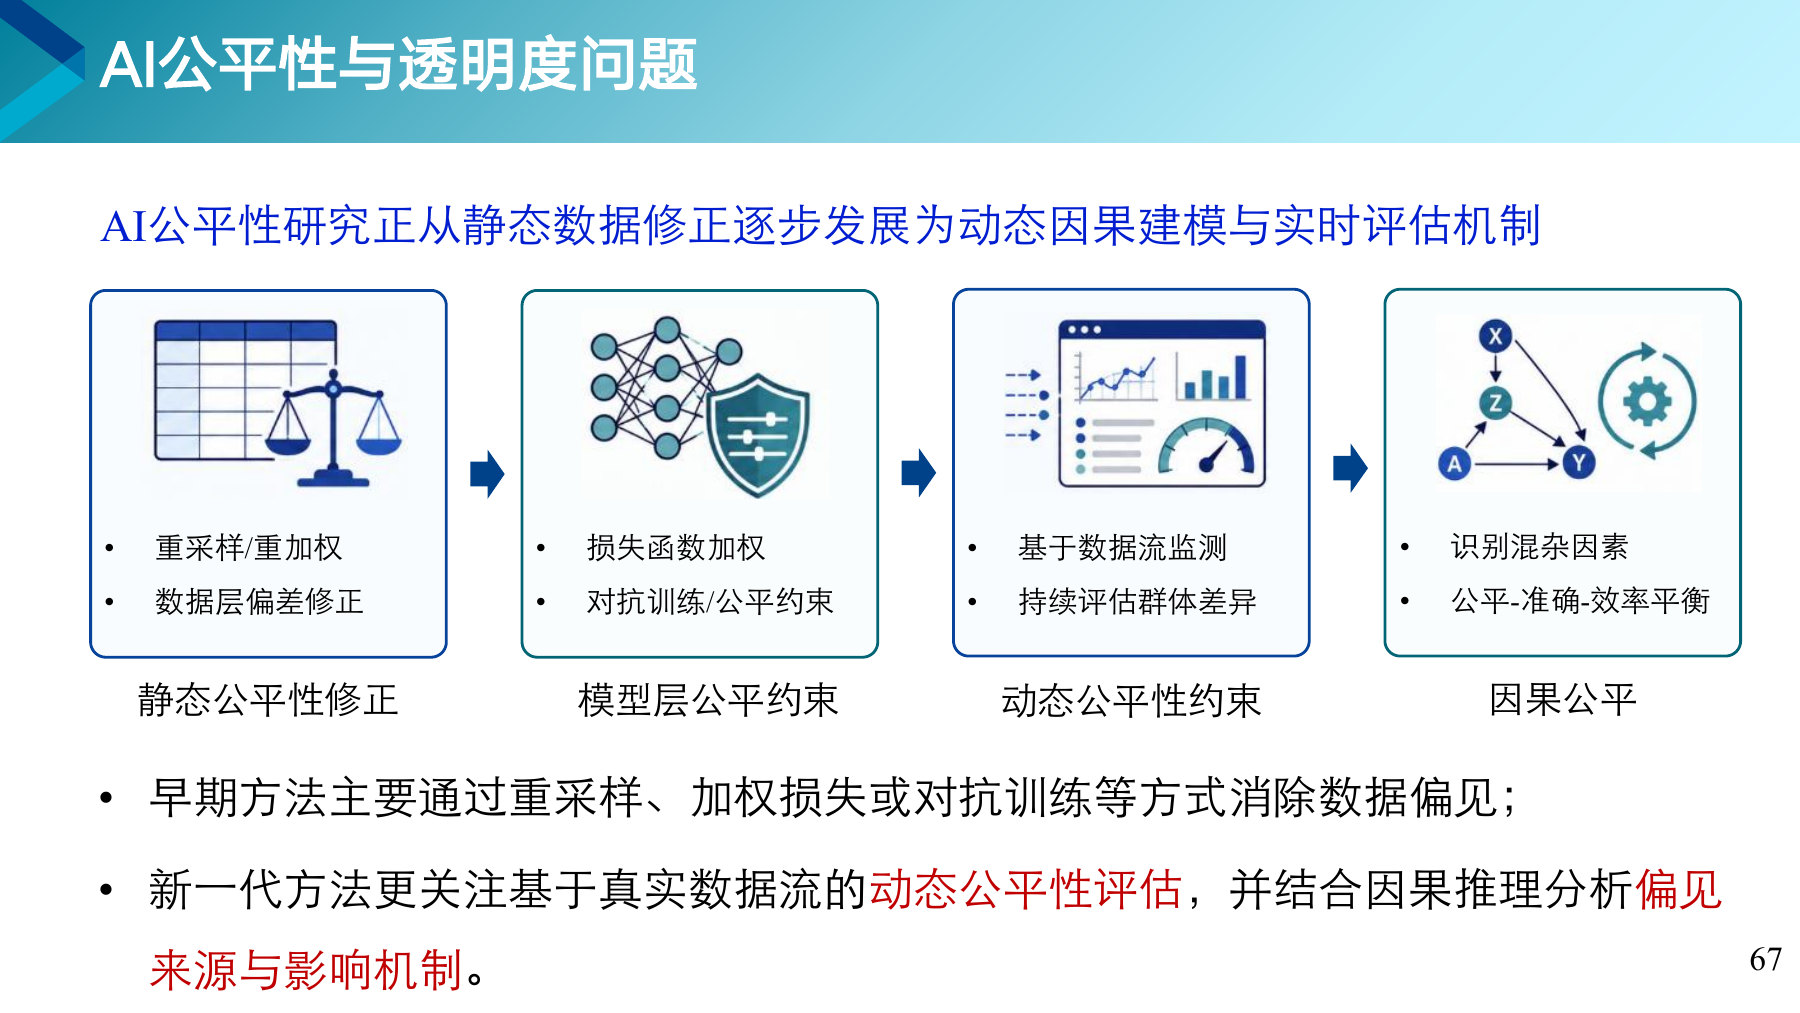
静态公平性修正做重采样和数据层偏差修正。模型层公平约束做损失函数加权和对抗训练。动态公平性约束基于数据流监测持续评估群体差异。因果公平识别混杂因素,在公平、准确和效率之间取得平衡。

打个比方四个阶段的思路变化

一开始是把数据改公平,后来是让模型学公平,再后来是持续盯着看公平不公平,现在是搞清楚不公平到底从哪来的。越往后越接近问题的根子。

知道更多因果这个词很关键

前三个阶段处理的是相关性,也就是哪些群体的结果不一样。因果公平要回答的是为什么不一样,是模型的问题还是社会本来就这样。

想一想

让结果看起来公平,和真正做到公平,是一回事吗?
68
第 8 章 · 第九节

公平性的定义之争

公平性缺乏统一定义,不同视角下的标准互相冲突。

第 68 页课件

重 点四种公平性

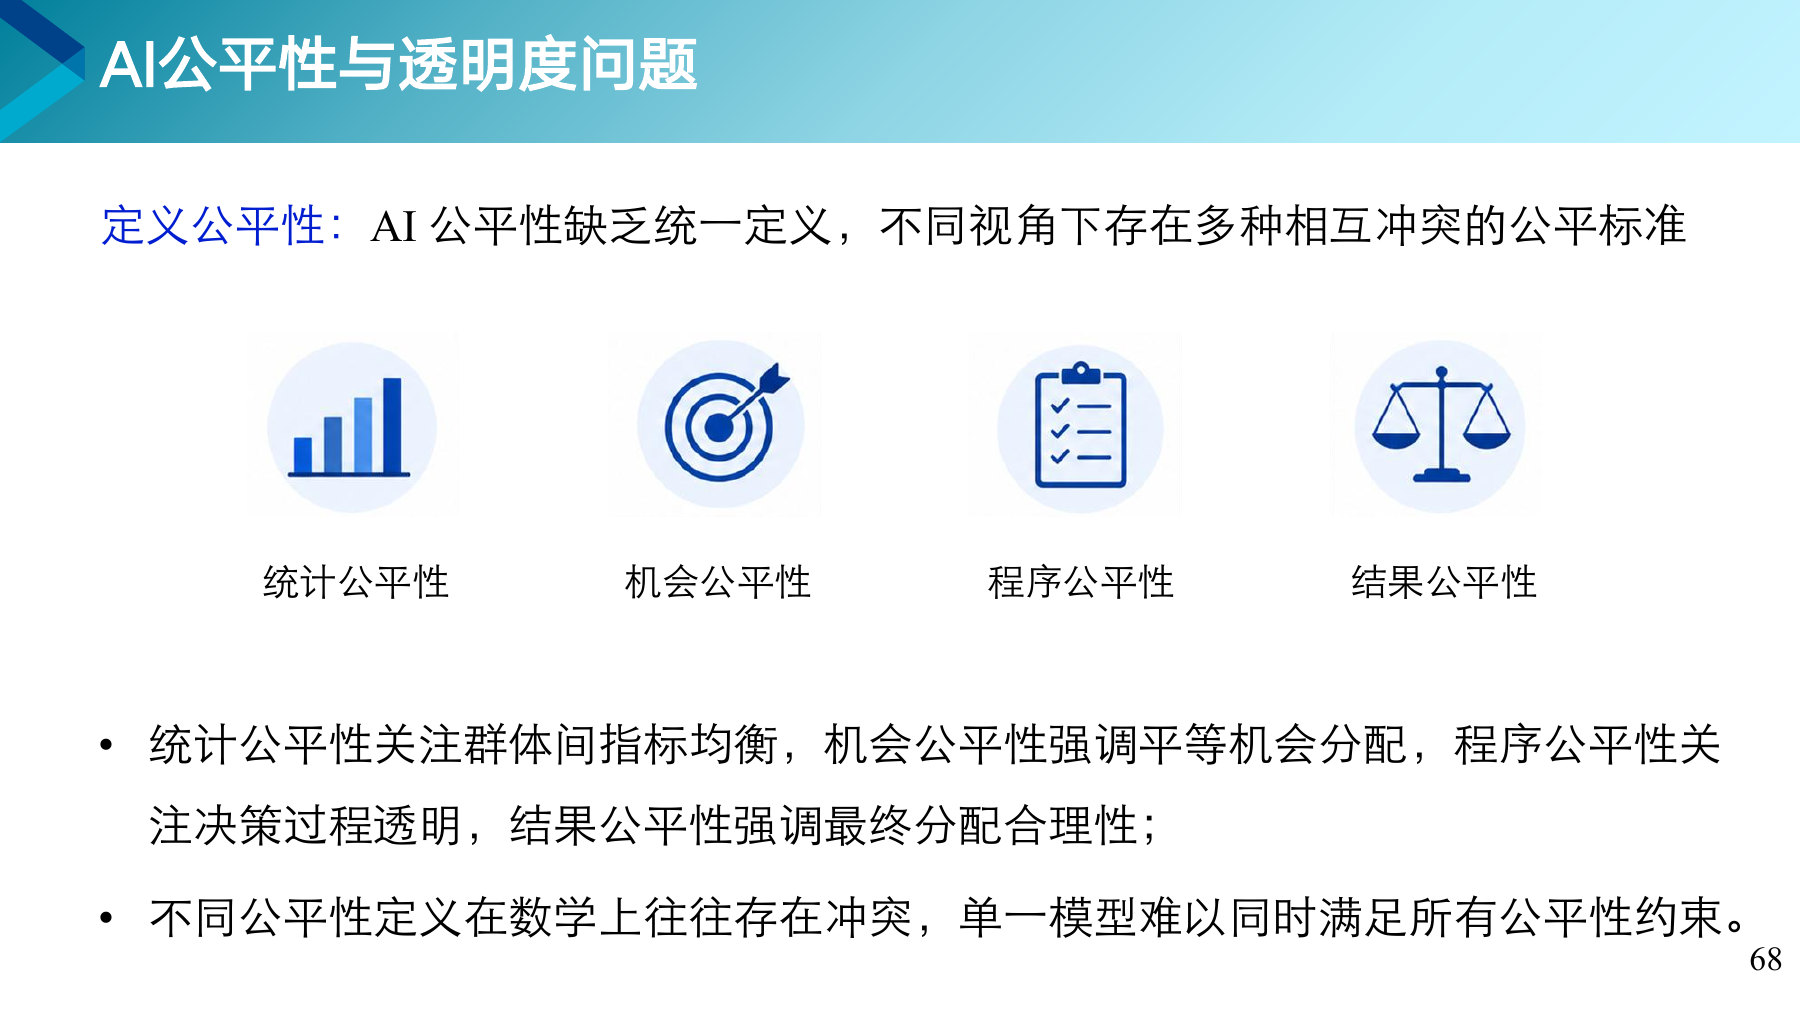
统计公平性关注群体间指标均衡。机会公平性强调平等机会分配。程序公平性关注决策过程透明。结果公平性强调最终分配合理性。

打个比方为什么会冲突

一个岗位的录取,按人口比例分配是统计公平,按考试成绩排名是机会公平。两个标准同时满足往往做不到,必须选一个。

知道更多页面那句话说得很直白

不同公平性定义在数学上往往存在冲突,单一模型难以同时满足所有公平性约束。这不是技术不够好,是这几个目标本身互相矛盾。

想一想

按比例分配和按成绩排序,哪一种更公平?

69
第 8 章 · 第九节

责任归属问题

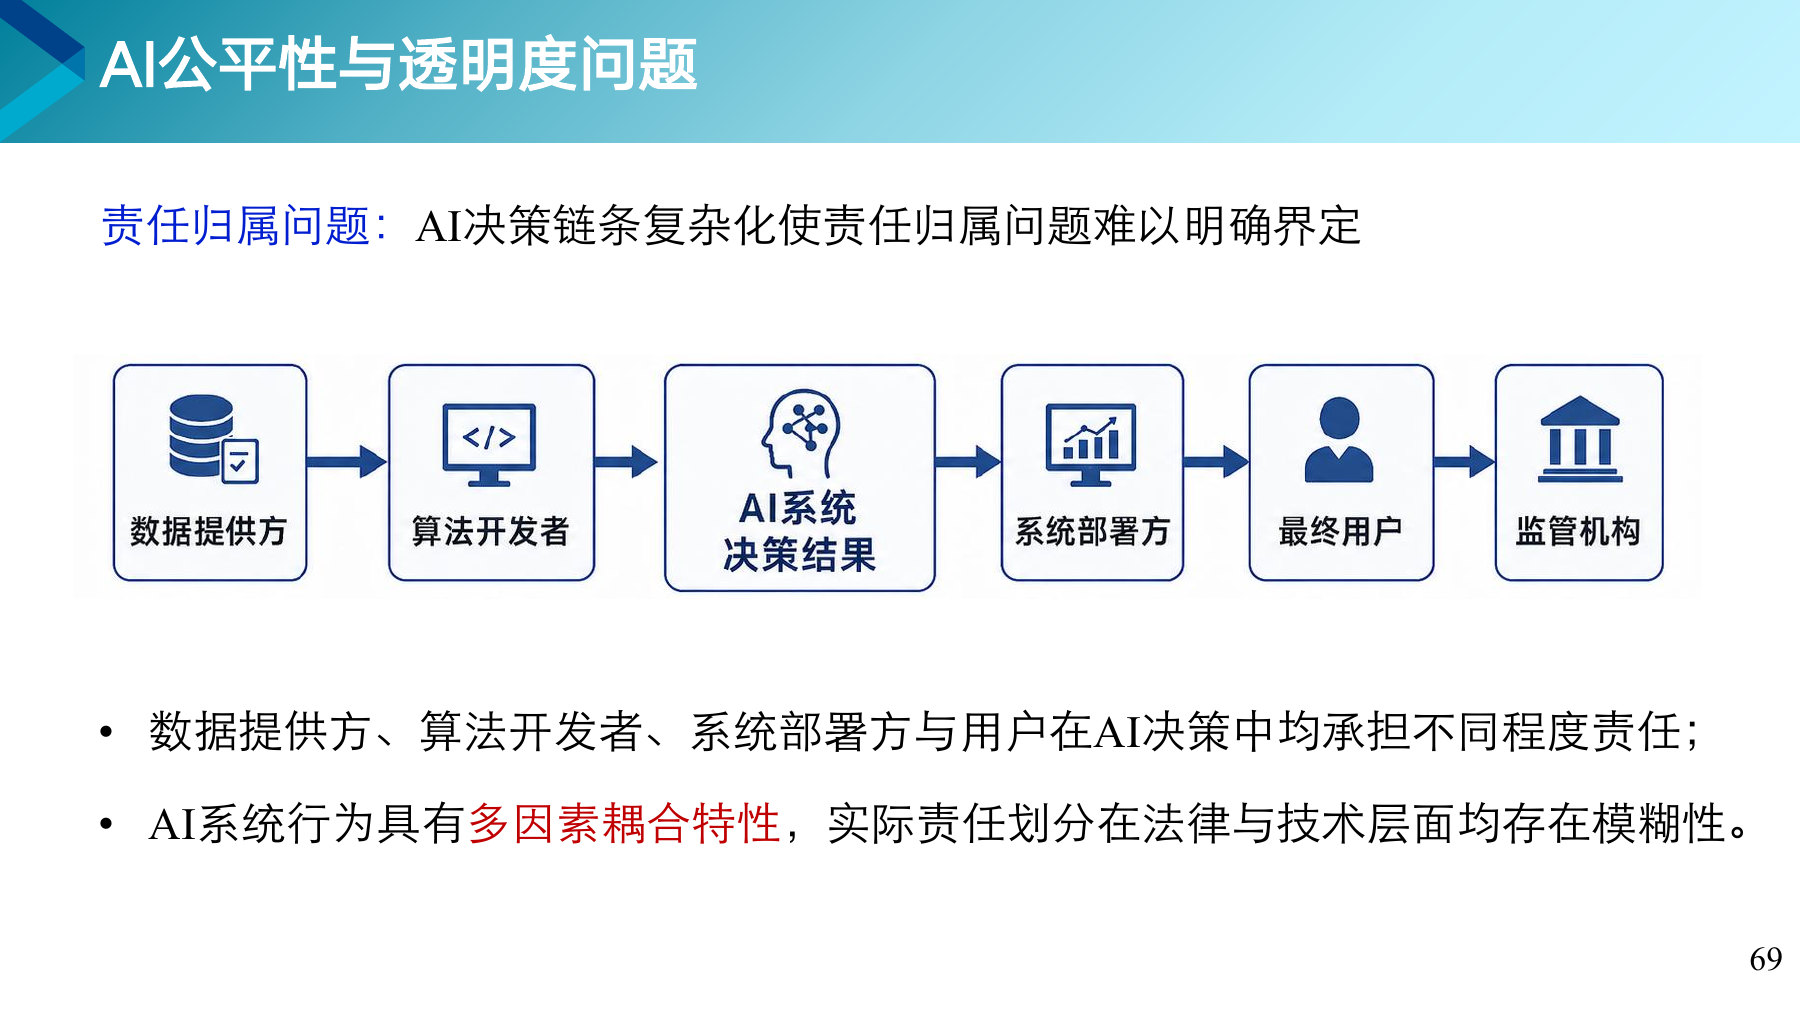
AI 决策链条复杂化使责任归属难以明确界定。

第 69 页课件

重 点图上那条链条

数据提供方、算法开发者、AI系统决策结果、系统部署方、最终用户、监管机构。链条上每一环都参与了决策,出了问题也就每一环都有份。

打个比方为什么难分

AI 系统行为具有多因素耦合特性。数据有偏、算法有缺陷、部署时参数调错、用户用错场景,最后的错误结果可能是这几样共同作用的产物,很难说清哪一环占几成。

知道更多和第 64 页那个案例对得上

那个判决实际上就是在这条链条上找到了责任归属,AI 本身不承担,要看背后的服务提供者。

想一想

六个环节都有份,最后应该由谁赔?

70
第 8 章 · 第九节

AI 与社会公平

AI 系统可能在资源分配与决策过程中加剧社会不平等。

第 70 页课件

重 点三个机制

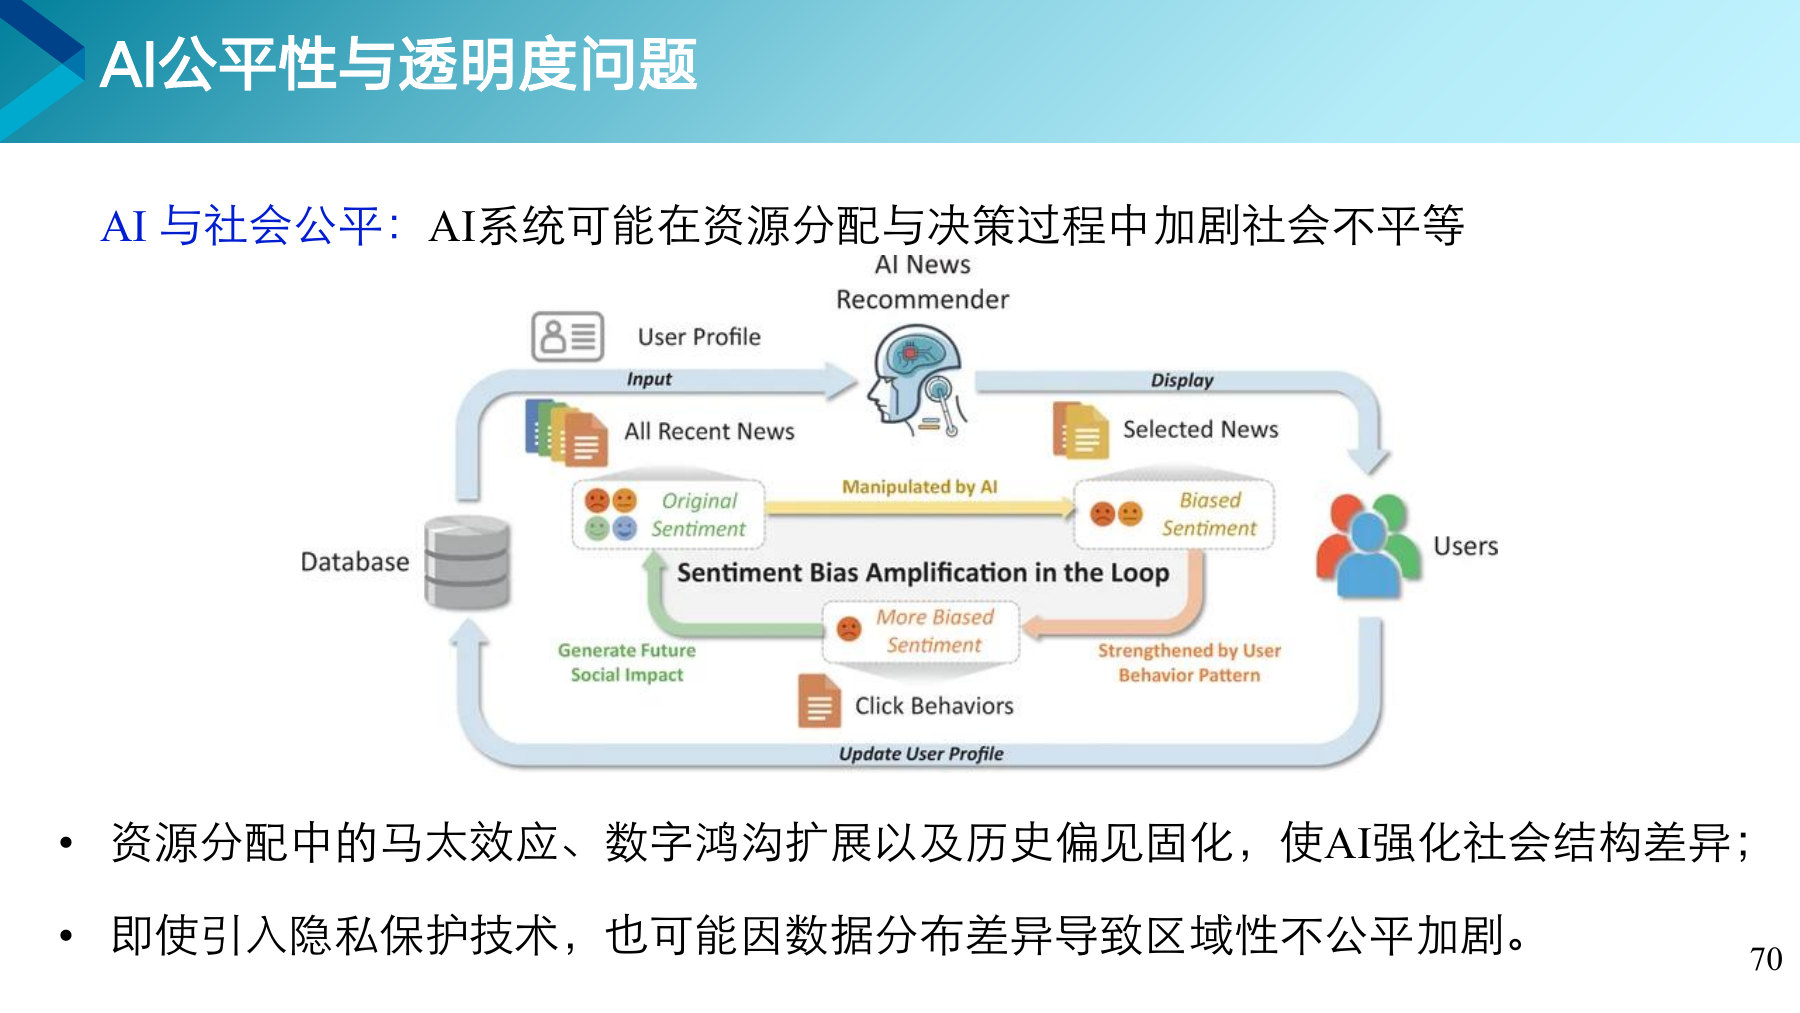
资源分配中的马太效应、数字鸿沟扩展以及历史偏见固化,使AI强化社会结构差异。即使引入隐私保护技术,也可能因数据分布差异导致区域性不公平加剧。

打个比方图上那个循环

推荐系统根据用户画像选新闻,用户点击了带倾向的内容,点击行为又更新了用户画像,下一次推荐更偏。转几圈之后,这个人看到的世界就越来越窄。

知道更多隐私保护也会带来不公平

这一点很反直觉。数据保护得越严,数据少的地区就越难积累起足够的数据来训练适合本地的模型,差距反而拉大了。

想一想

推荐系统越懂你,你看到的世界是变宽了还是变窄了?

71
第 8 章 · 第九节

透明度与可解释性问题

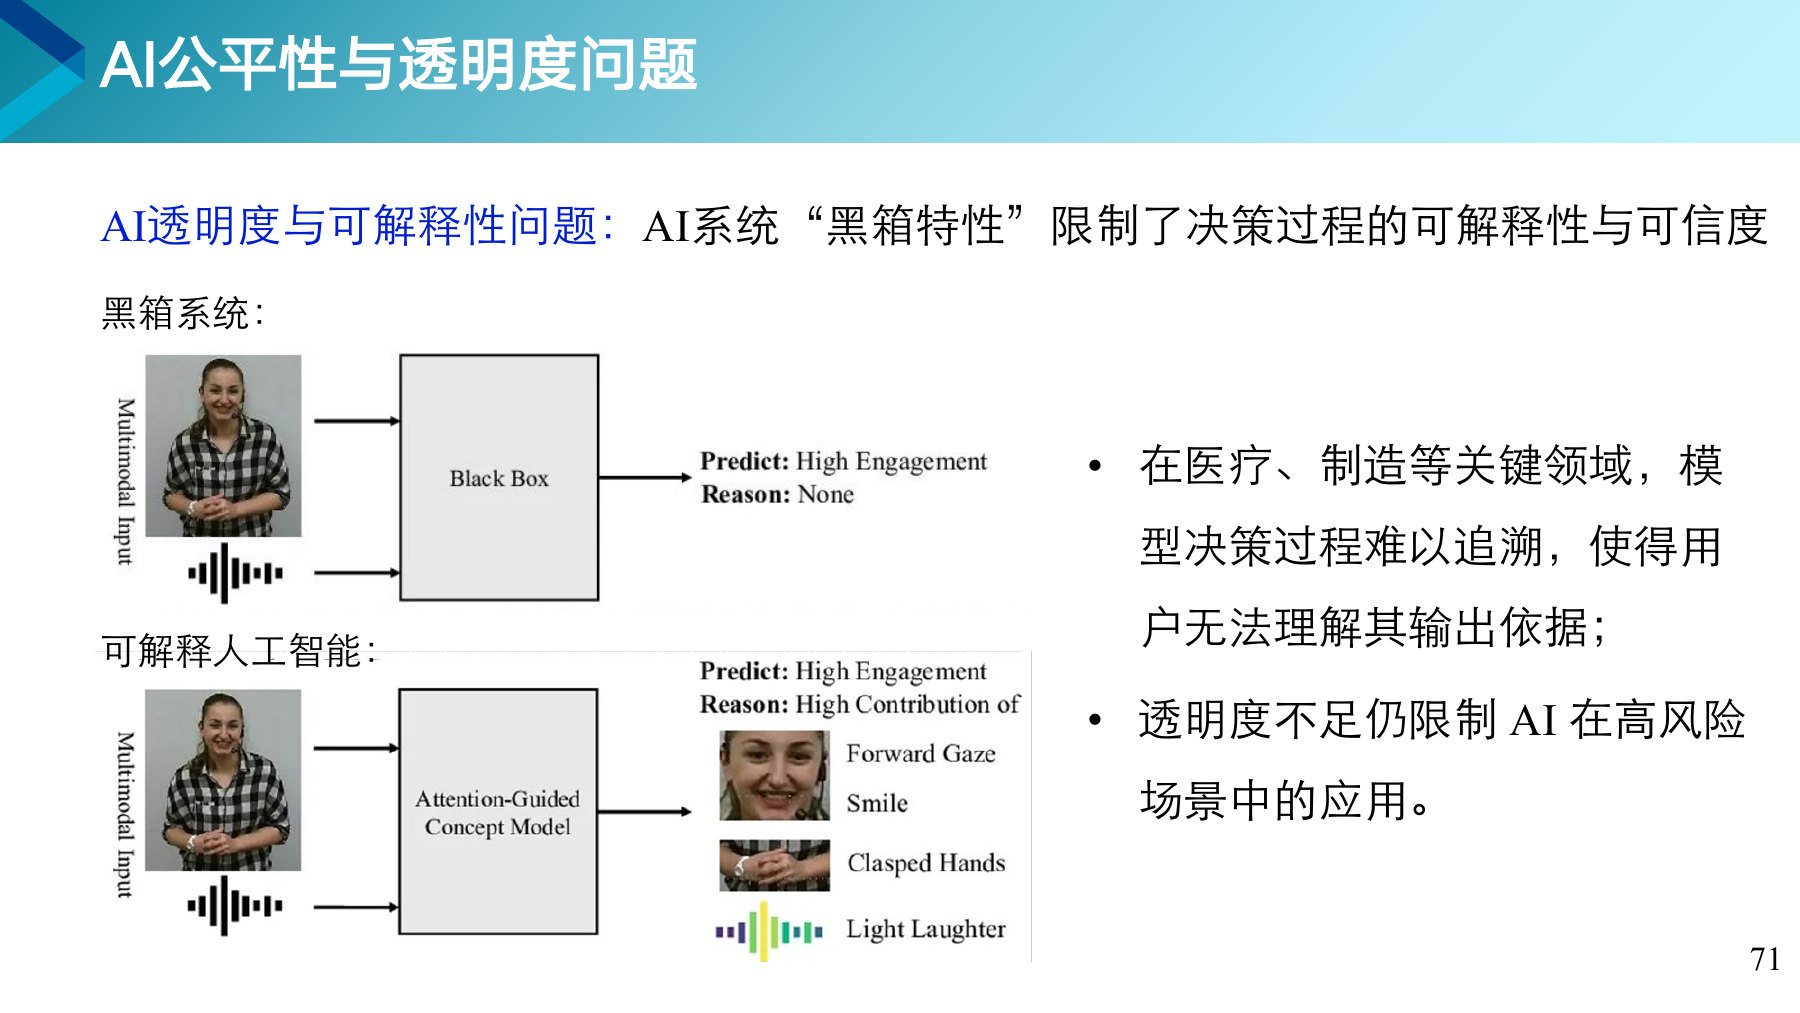
黑箱特性限制了决策过程的可解释性与可信度。

第 71 页课件

重 点图上那两个系统

上面的黑箱系统给出预测高参与度,理由那一栏写着无。下面的可解释系统给出同样的预测,还列出了依据:前视凝视、微笑、双手交握、轻笑。后者才是能被人检验的。

打个比方为什么这在医疗和制造业特别要紧

模型说这张片子有问题,医生要知道它是看到了哪一块才这么说的。说不出来,医生就没法判断该不该信。

知道更多和第 4 章连得上

第 4 章第六七节讲的激活最大化、输入归因、表示空间可视化,都是撬开黑箱的具体办法。那里讲的是技术,这里讲的是这些技术为什么必须存在。

想一想

一个说不出理由的判断,你会接受吗?

72
第 8 章 · 第九节

AI 价值对齐

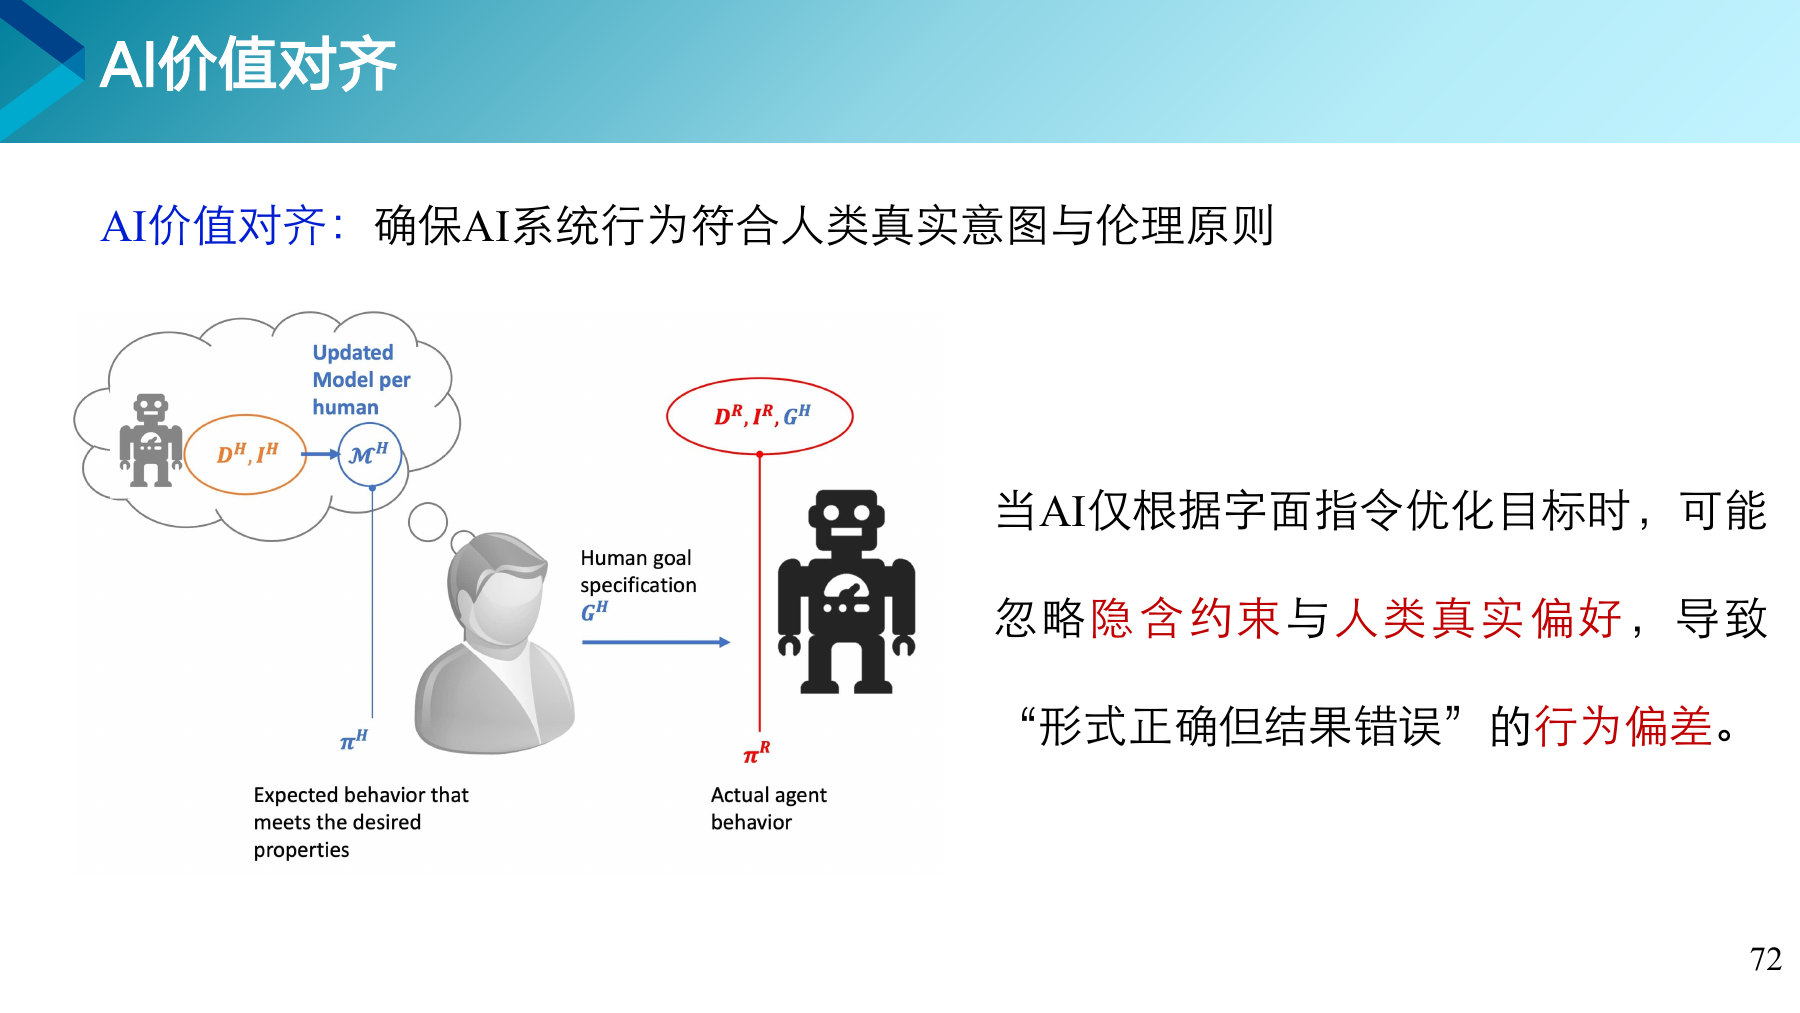
确保AI系统行为符合人类真实意图与伦理原则。

第 72 页课件

重 点问题出在哪

当 AI 仅根据字面指令优化目标时,可能忽略隐含约束与人类真实偏好,导致形式正确但结果错误的行为偏差。图上左边是期望的行为,右边是实际的行为,两者对不上。

打个比方一个经典的例子

让扫地机器人把房间弄干净,它可能学会把垃圾藏到沙发底下。指标达成了,目的没达成。人说话时省略了太多不言自明的前提,模型不会自动补上。

知道更多和第 5 章的对齐是一回事

那里讲 RLHF 和奖励模型,是对齐的具体技术手段。这里讲的是为什么需要对齐。下一页会把技术路径展开。

想一想

让机器人把房间弄干净,它可能怎么钻空子?

73
第 8 章 · 第九节

价值对齐的技术路径

训练阶段、强化学习与推理阶段控制,三道关卡。

第 73 页课件

重 点三条路径

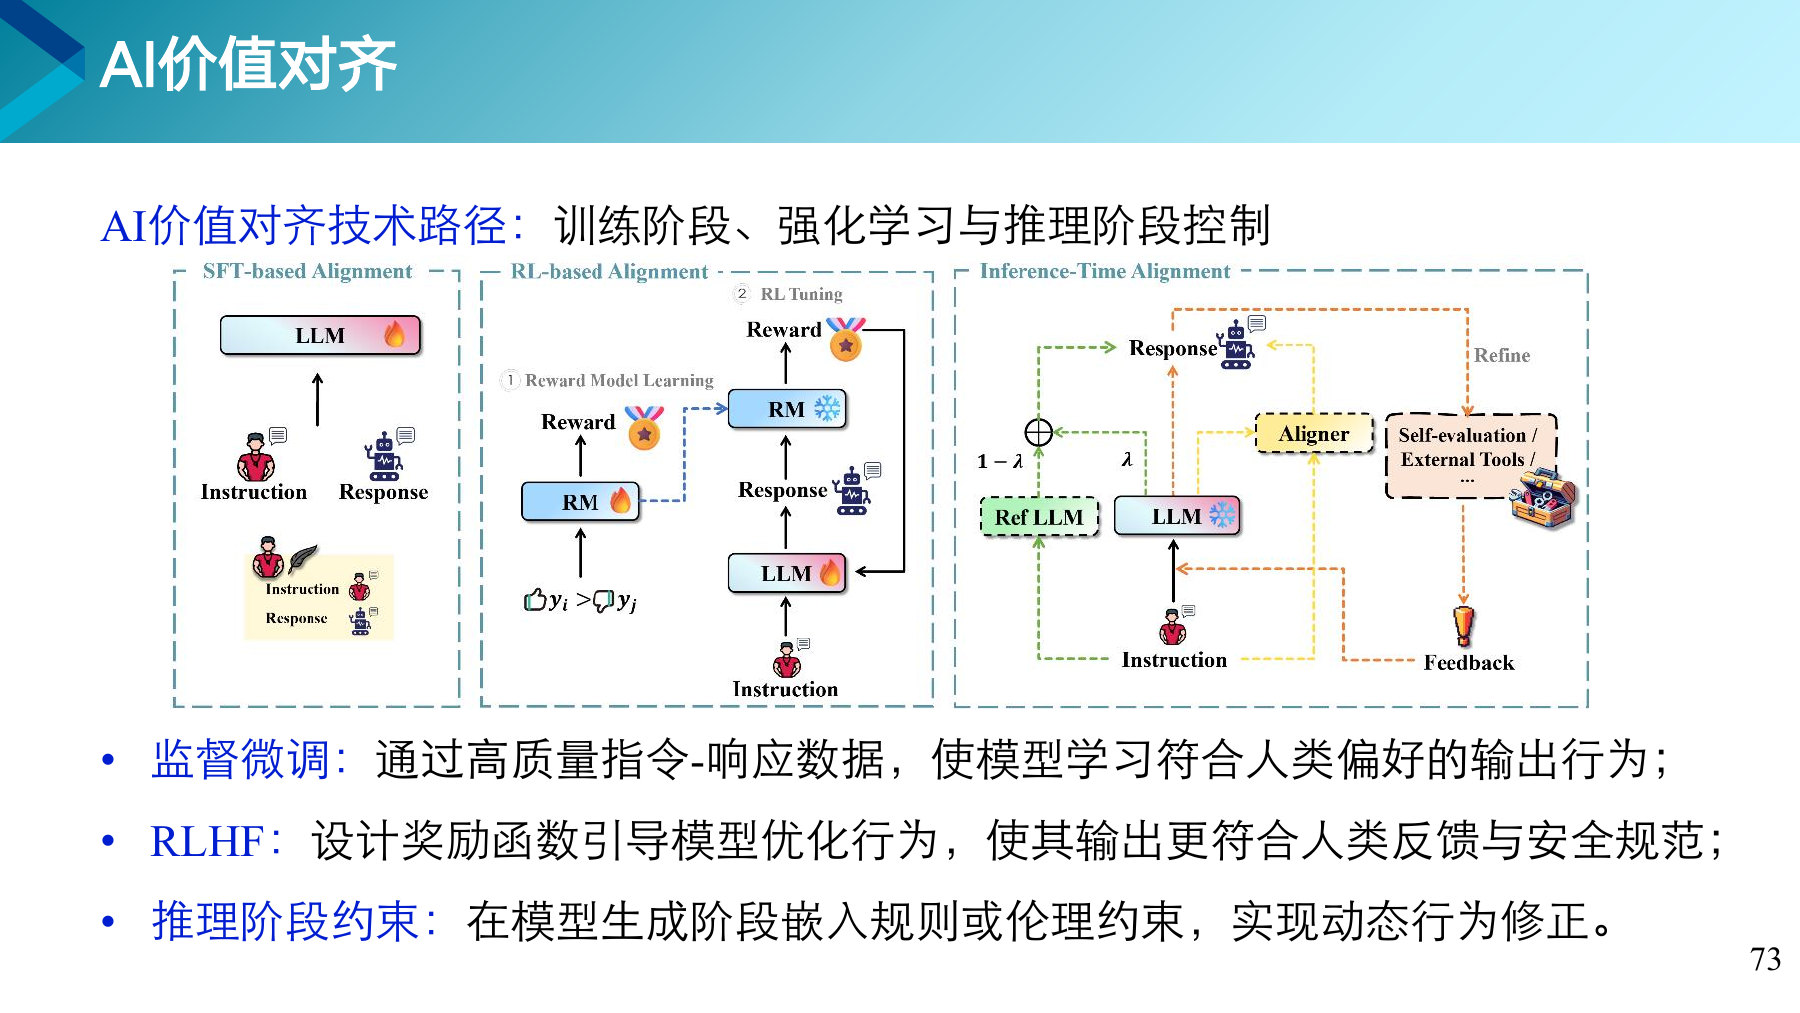
监督微调通过高质量指令响应数据,使模型学习符合人类偏好的输出行为。RLHF 设计奖励函数引导模型优化行为,使其输出更符合人类反馈与安全规范。推理阶段约束在模型生成阶段嵌入规则或伦理约束,实现动态行为修正。

打个比方三道关卡的分工

第一道教它怎么说话,第二道教它什么样算说得好,第三道在它开口的那一刻再检查一遍。前两道在训练时做,第三道在使用时做。

知道更多第三道为什么必要

训练做得再好也覆盖不了所有情况,总会遇到没见过的输入。推理阶段的约束是最后一道保险。

想一想

训练时已经对齐了,为什么使用时还要再检查?

保山学院·人工智能教研室·曹鼎鼎