人工智能导论 第 8 章 · 第三节
课程 › 第 8 章 › 第三节 无人集群概念集群分类协同感知协同决策具身智能概念三维视觉理解视觉语言导航虚拟到现实具身大模型
第 8 章 人工智能前沿技术 · 第三节

无人集群与具身智能

多台一起干活,以及给AI装上身体
本 节 知 识 点
  1. 15无人集群的概念
  2. 16无人集群的分类
  3. 17无人集群的协同感知
  4. 18无人集群的协同决策
  5. 19具身智能的概念
  6. 20核心技术之一:三维视觉理解
  7. 21核心技术之二:视觉语言导航
  8. 22核心技术之三:虚拟到现实迁移
  9. 23核心技术之四:具身大模型
15
第 8 章 · 第三节

无人集群的概念

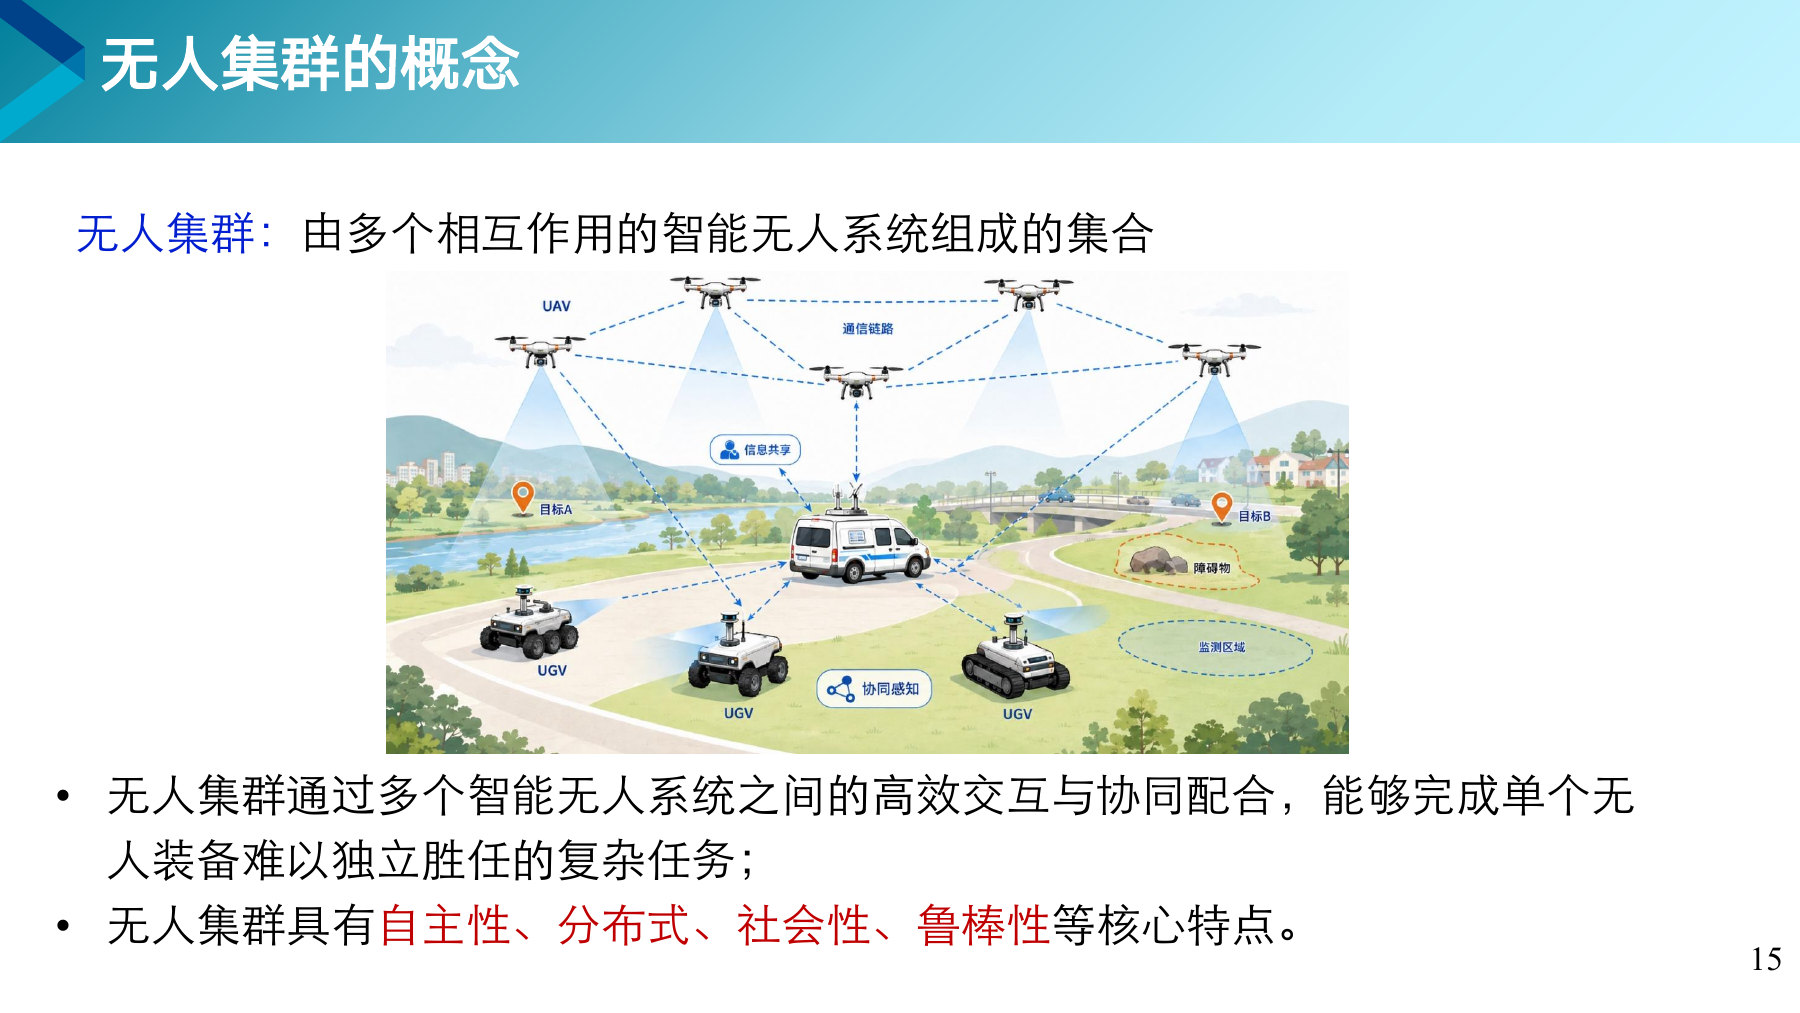
由多个相互作用的智能无人系统组成的集合。
第 15 页课件

重 点集群解决什么问题

通过多个智能无人系统之间的高效交互与协同配合,完成单个无人装备难以独立胜任的复杂任务。核心特点是自主性、分布式、社会性、鲁棒性。

打个比方鲁棒性是集群最大的优势

一架无人机坏了整个任务就停了。一百架里坏了三架,剩下的九十七架自动补位继续干。这种坏一个不影响全局的性质,单机做不到。

知道更多和第 6 章的多智能体是一回事

那里讲的是软件智能体怎么分工协作,这里讲的是硬件设备怎么分工协作。组织形式、任务分配、通信协调这些问题完全一样。

想一想

一百架无人机同时飞,怎么保证它们不撞在一起?
16
第 8 章 · 第三节

无人集群的分类

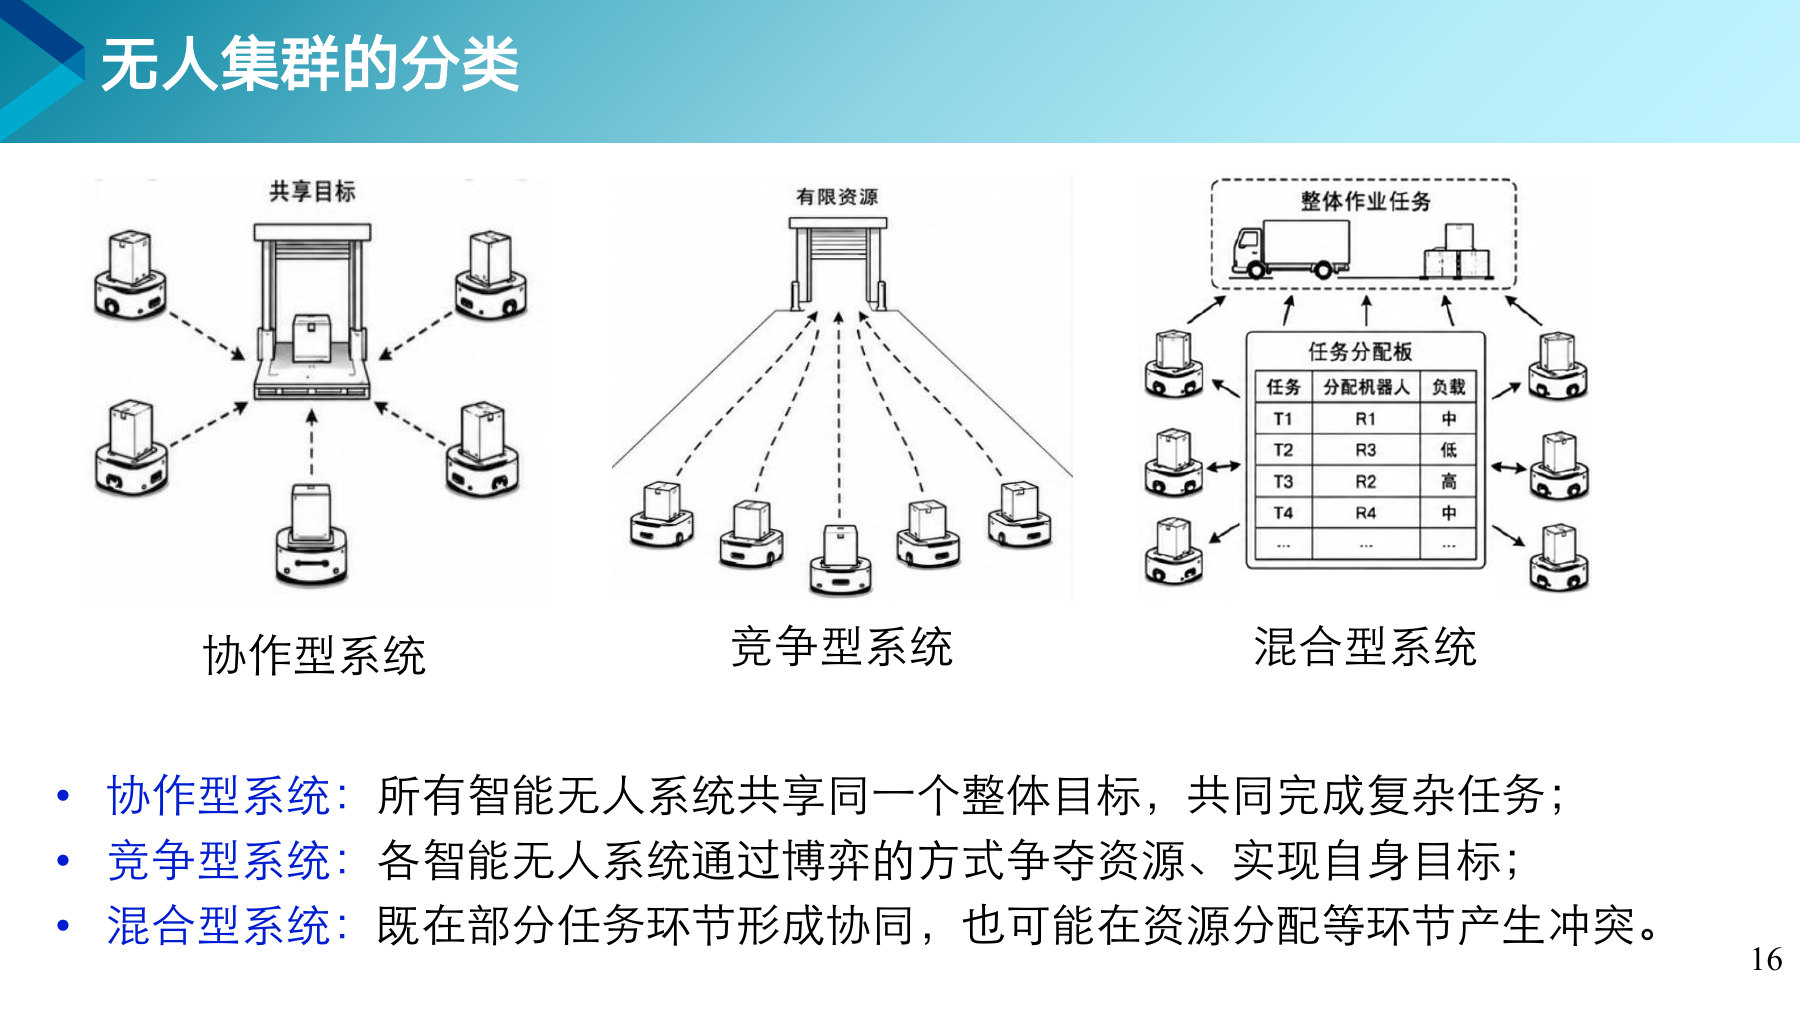
协作型、竞争型、混合型,区别在于目标是不是一致。

第 16 页课件

重 点三类怎么分

协作型所有成员共享同一个整体目标,共同完成复杂任务。竞争型各成员通过博弈的方式争夺资源、实现自身目标。混合型既在部分任务环节形成协同,也可能在资源分配等环节产生冲突。

打个比方图上那三张示意

左边几台机器人围着同一个目标干活,是协作。中间几台抢同一个通道,是竞争。右边挂着一张任务分配板,既分工又抢资源,是混合。

知道更多现实中混合型最多

纯协作和纯竞争都是理想情况。真实系统里成员往往有共同的大目标,但在具体资源上又互相挤,所以混合型才是常态。

想一想

几台扫地机器人在同一个屋子里工作,属于哪一类?

17
第 8 章 · 第三节

无人集群的协同感知

通过信息共享与感知融合,弥补单个系统看不全的短板。

第 17 页课件

重 点为什么需要协同感知

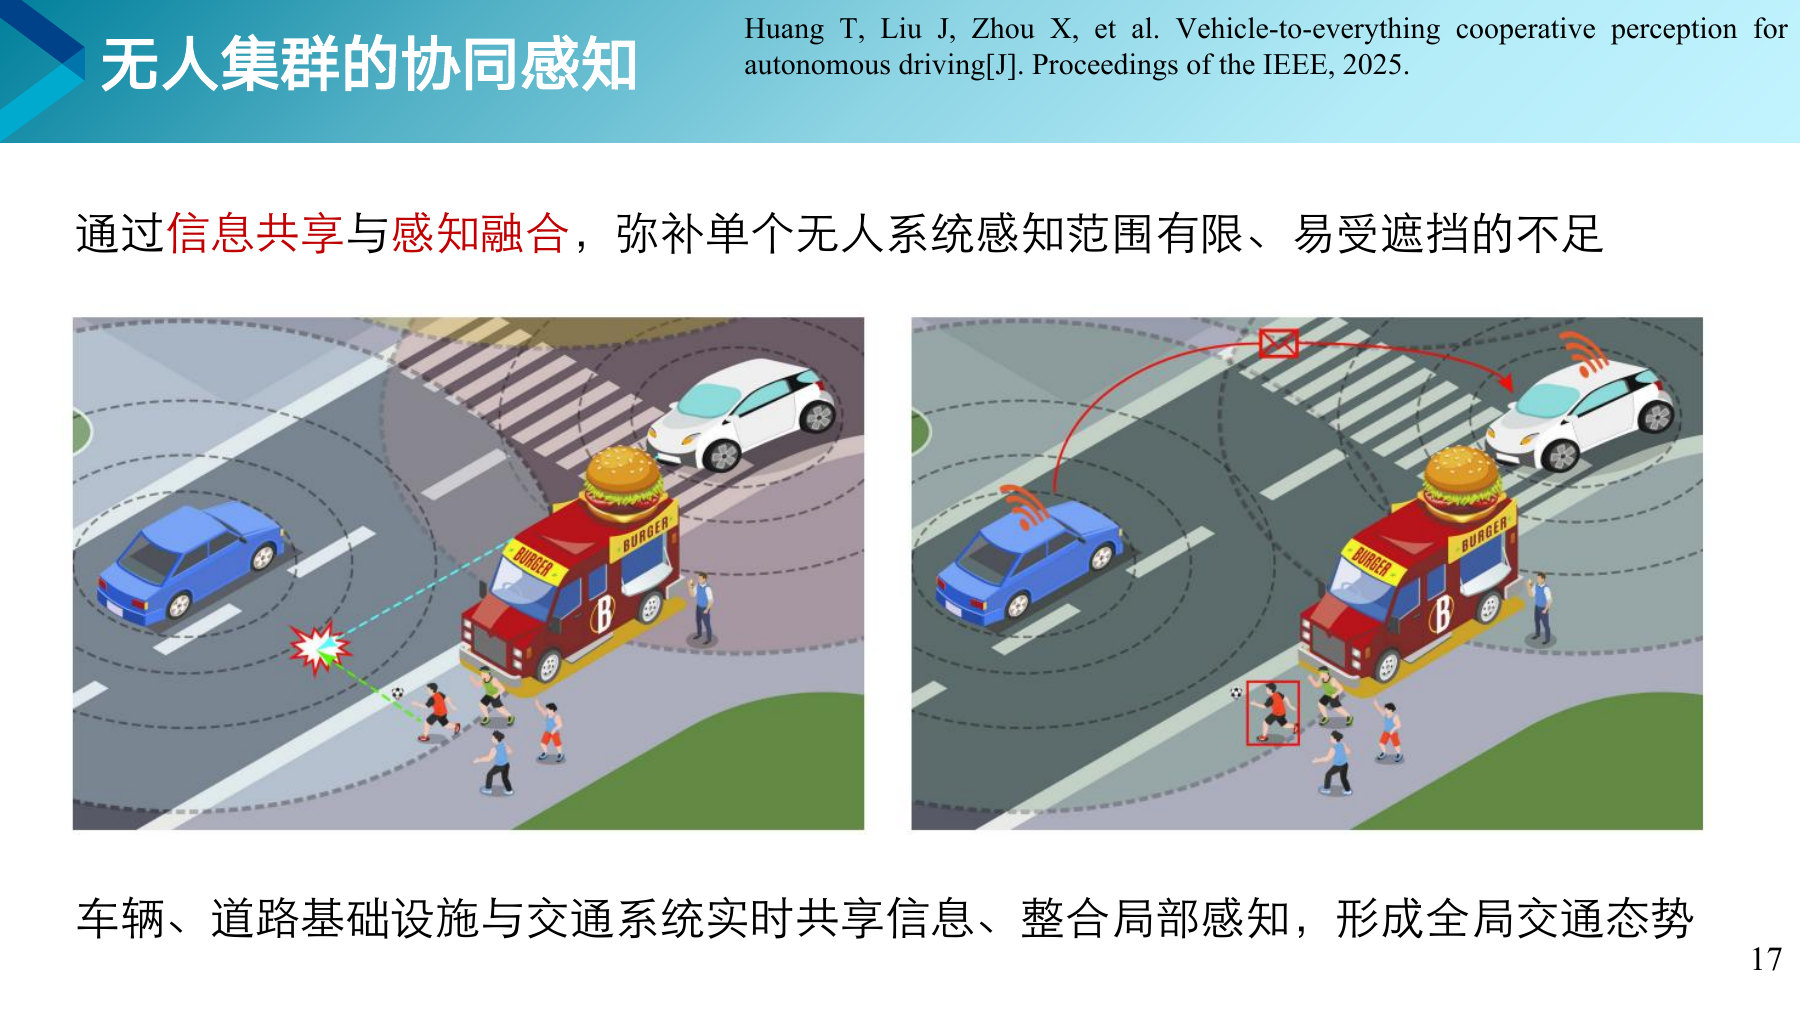
单个无人系统感知范围有限,容易被遮挡。多个系统把各自看到的东西共享出来,就能拼出一张更完整的图。

打个比方图上那两张对比

左边红色的车被前面的公交车挡住,看不见路口的行人。右边公交车把自己看到的行人位置发给了后车,后车虽然看不见,但知道那里有人。这一步的价值可能就是一条命。

知道更多这项技术叫车路云协同

车辆、道路基础设施与交通系统实时共享信息,整合局部感知,形成全局交通态势。它不是靠把单车的传感器做得更强,而是靠让大家把看到的说出来。

想一想

被大车挡住看不见的地方,怎么才能知道那里有没有人?

18
第 8 章 · 第三节

无人集群的协同决策

多节点在共享信息下协同规划行动,特点是强耦合、高维度。

第 18 页课件

重 点这两个词是什么意思

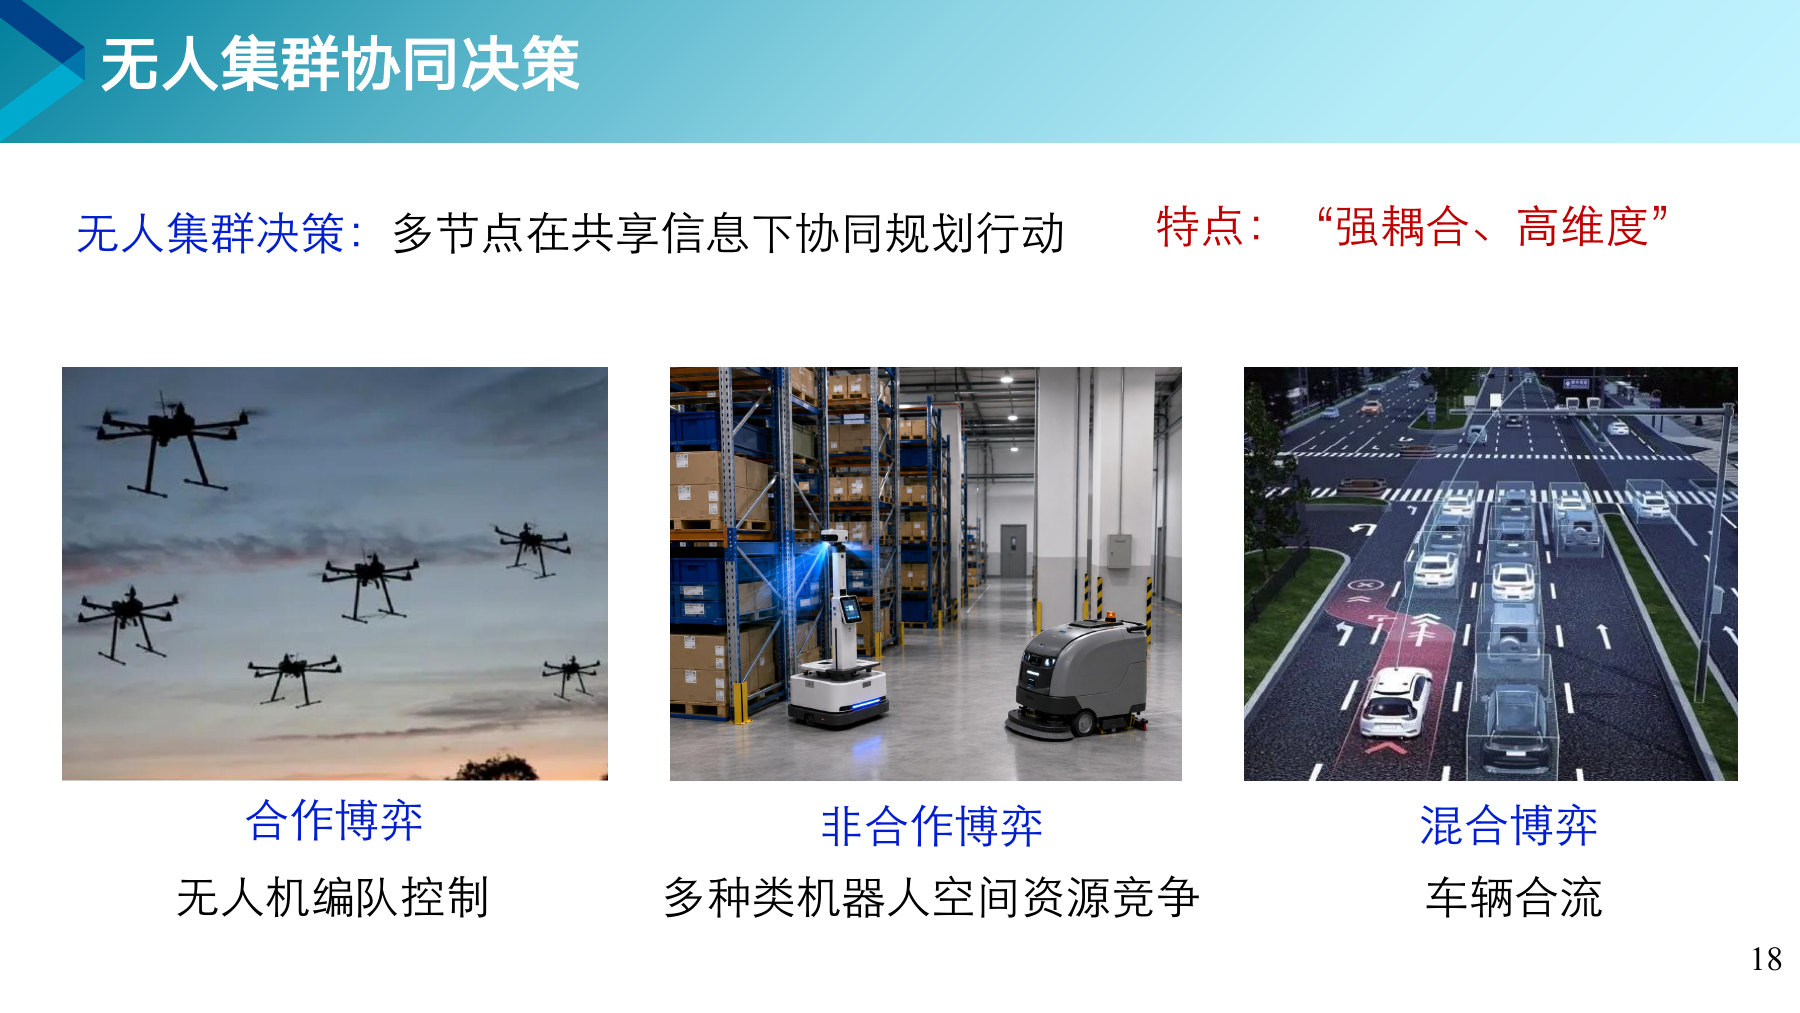
强耦合指一个成员改变动作,其他成员都得跟着调整。高维度指要同时决定几十上百个成员各自怎么动。两者叠加,可能的方案数量大到没法穷举。

打个比方图上那三种博弈

无人机编队控制是合作博弈,大家一条心。多种类机器人抢空间资源是非合作博弈,各顾各的。车辆合流是混合博弈,既要抢位置又不能撞。

知道更多为什么这么难

单个智能体的决策已经不容易,几十个智能体互相影响,方案空间是指数级增长的。第 6 章第 46 页讲的市场化任务分配,就是应对这种复杂度的一种办法。

想一想

十辆车在路口汇流,怎么定谁先走?

19
第 8 章 · 第三节

具身智能的概念

具备物理载体,能在真实世界感知、学习与行动的智能形态。

第 19 页课件

关键术语

具身智能Embodied AI
以物理身体为载体、通过与真实环境交互来感知和行动的智能

重 点和软件智能体的区别

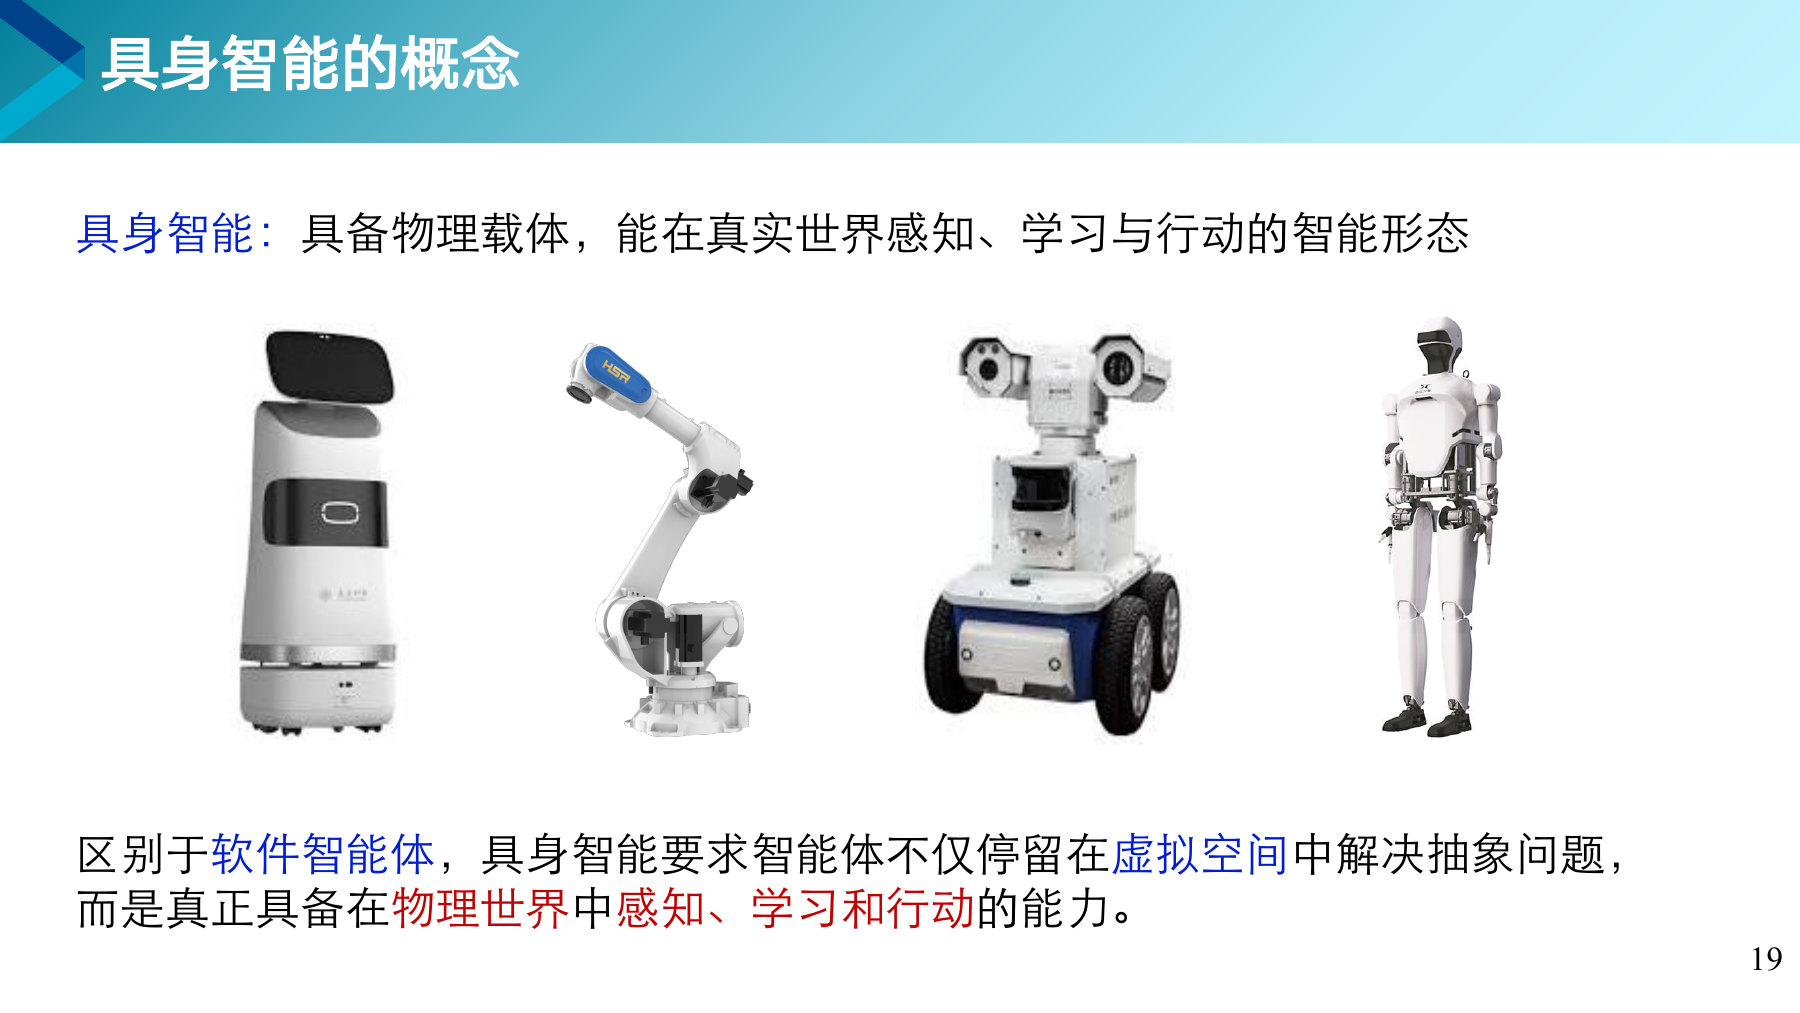
软件智能体只在虚拟空间里解决抽象问题,具身智能要求真正具备在物理世界中感知、学习和行动的能力。区别不在于聪不聪明,在于有没有身体。

打个比方图上那四个

服务机器人、机械臂、巡检机器人、人形机器人。形态差别很大,共同点是都有一个能动的物理身体。

想一想

一个很聪明但没有身体的AI,做不了哪些事?

20
第 8 章 · 第三节

核心技术之一:三维视觉理解

在三维环境中识别、定位和理解目标物体及其空间关系。

第 20 页课件

重 点这一项要解决什么

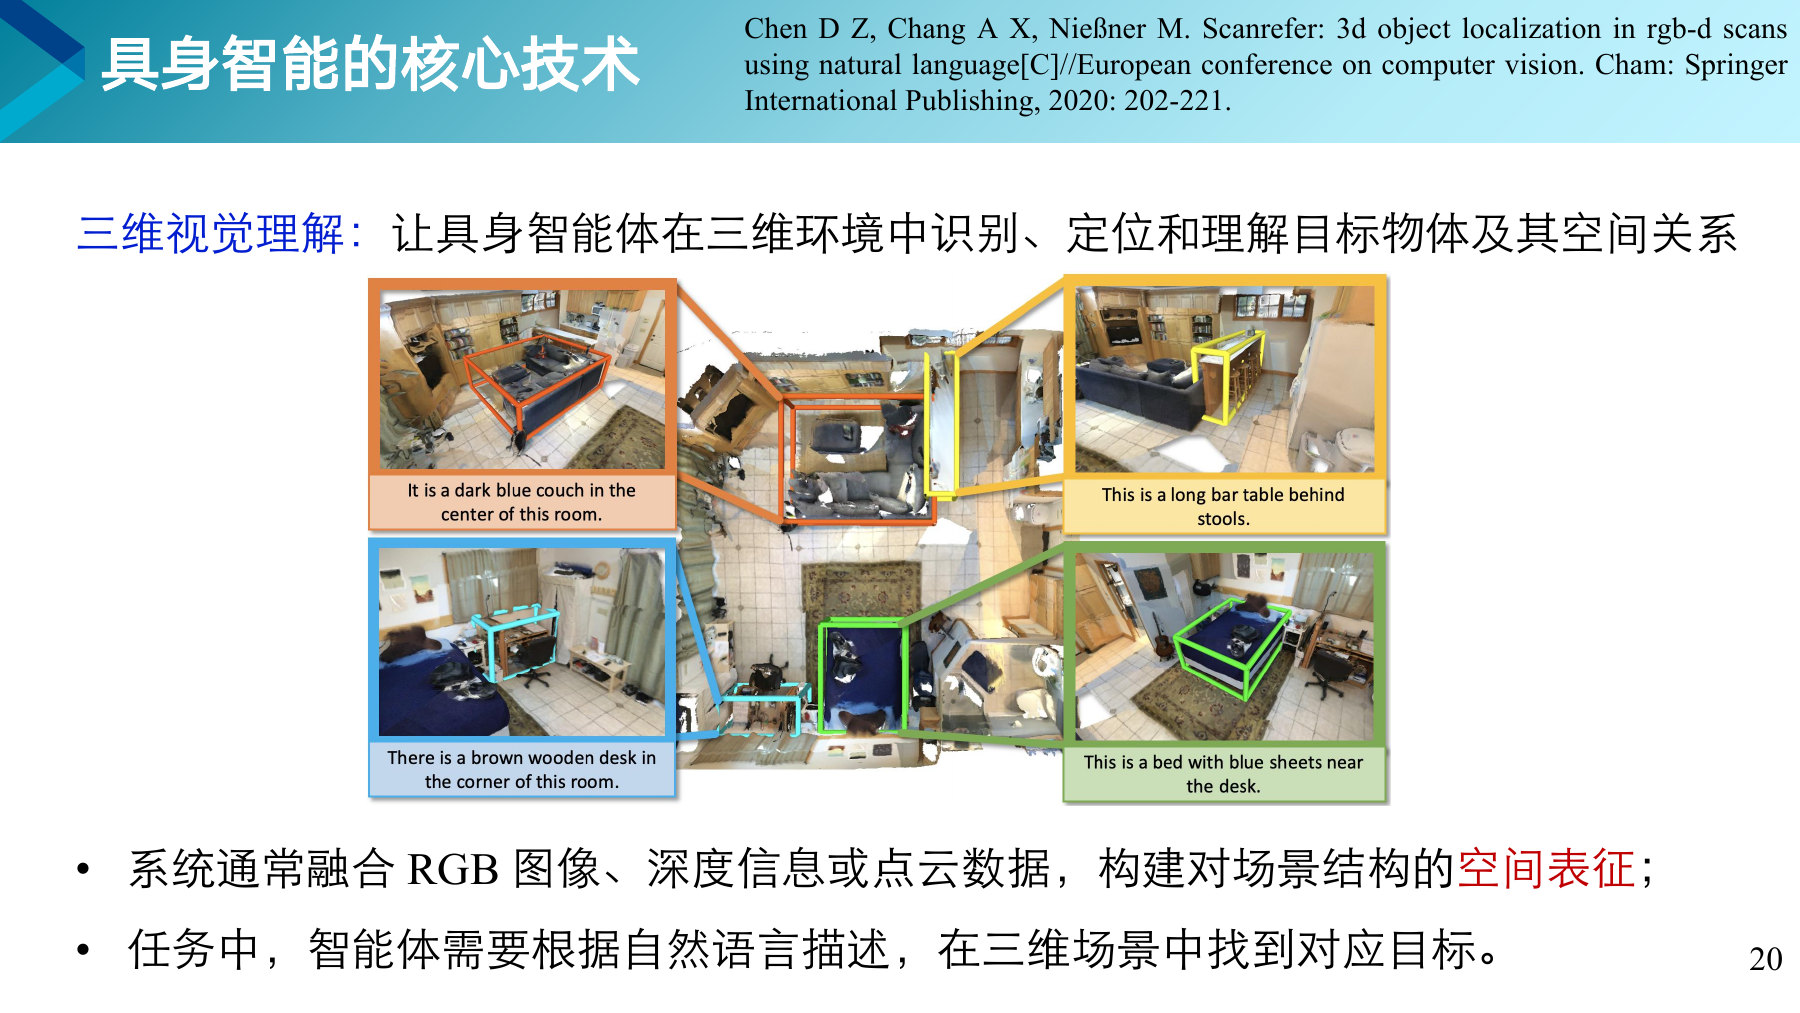
系统通常融合 RGB 图像、深度信息或点云数据,构建对场景结构的空间表征。任务中,智能体需要根据自然语言描述,在三维场景中找到对应目标。

打个比方图上那几句英文说明

这是房间中央的深蓝色沙发、这是凳子后面那张长吧台、这是房间角落里的棕色木桌。让机器根据这样一句话在真实房间里找到东西,就是三维视觉理解要干的活。

知道更多空间关系为什么难

认出一张桌子不难,难的是理解在角落里、在凳子后面这些描述。这需要模型不只认识物体,还要理解物体之间的位置关系。

想一想

让机器人去拿桌子后面那把椅子,它要理解哪几件事?

21
第 8 章 · 第三节

核心技术之二:视觉语言导航

依据人类自然语言指令自主完成导航任务。

第 21 页课件

关键术语

视觉语言导航VLN
把自然语言指令、视觉感知与路径规划结合起来的导航任务

重 点三样东西拼在一起

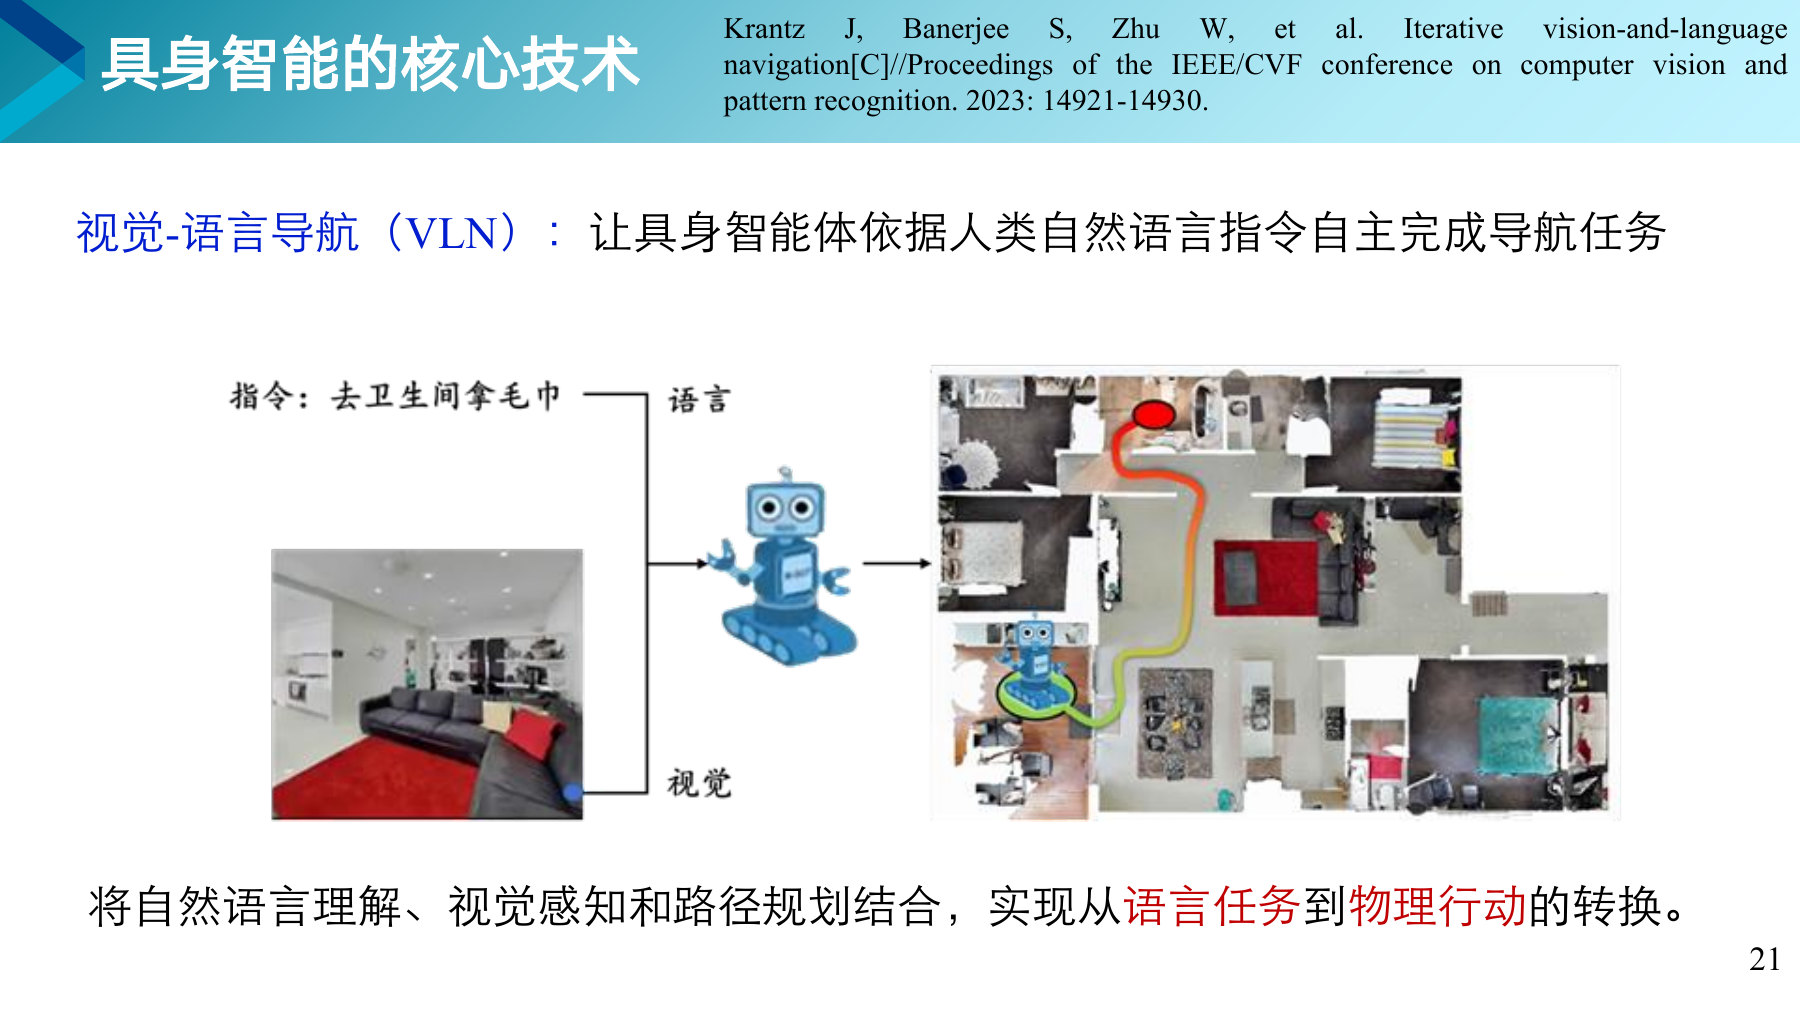
将自然语言理解、视觉感知和路径规划结合,实现从语言任务到物理行动的转换。少了任何一样,这件事都做不成。

打个比方图上那个例子

指令是去卫生间拿毛巾。机器人要听懂这句话,认出眼前的房间布局,规划出一条从客厅到卫生间的路,然后真的走过去。右边那条黄色轨迹就是它规划的路线。

知道更多和第 6 章的 VLA 对上了

那里讲的视觉语言动作模型输出的是机械臂的动作,这里的视觉语言导航输出的是移动路径。两者都是把语言变成物理行为。

想一想

去卫生间拿毛巾这句话,机器人要拆成几步?

22
第 8 章 · 第三节

核心技术之三:虚拟到现实迁移

先在模拟环境中训练,再迁移到真实世界中执行任务。

第 22 页课件

重 点核心难点只有一句

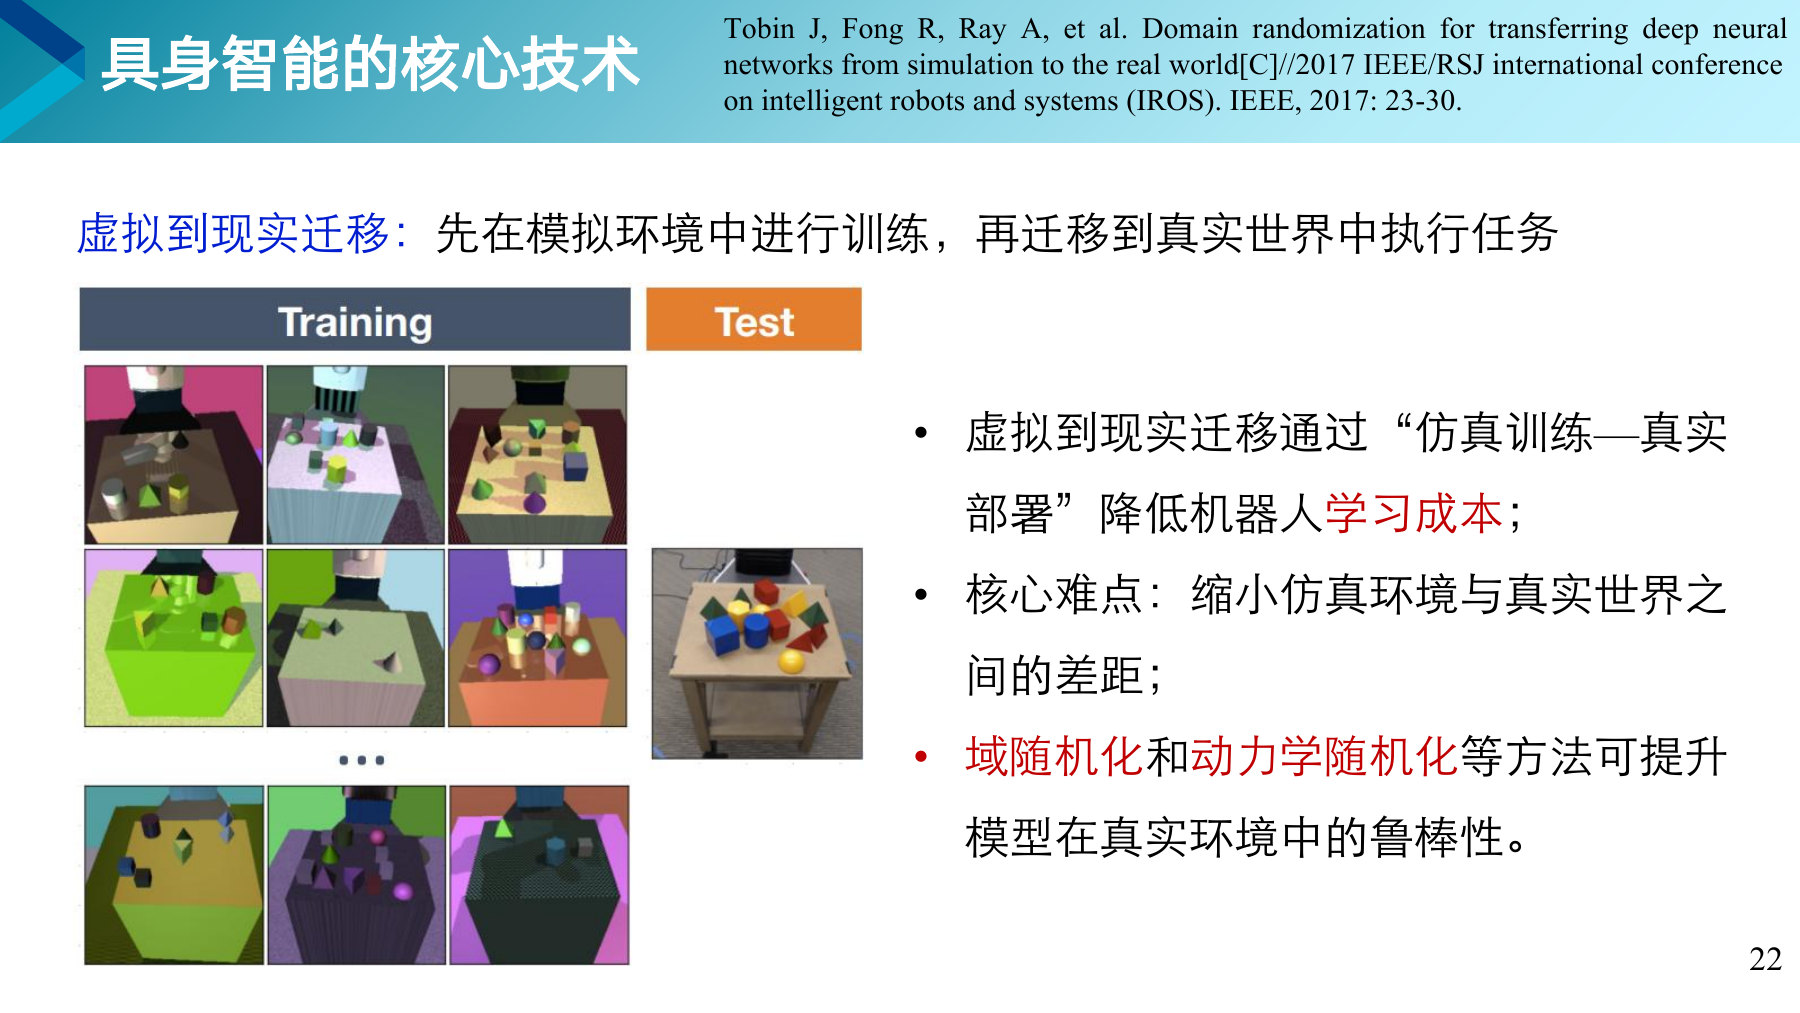
缩小仿真环境与真实世界之间的差距。仿真里训得再好,真实世界的光照、摩擦、噪声都不一样,模型一到现实就可能失灵。

打个比方图上那一堆花花绿绿的图

这是域随机化的做法。训练时故意把桌面颜色、光照、纹理随机换成各种夸张的样子,模型见得多了就不再依赖某一种特定外观。等到了真实环境,虽然没见过,但也算是它见过的那一大堆里的一种。

知道更多为什么值得这么费劲

第 7 章第 38 页说过,真机器人摔一百万次早就报废了。仿真训练是强化学习能落地的前提,而虚拟到现实迁移就是把仿真成果搬到现实的那座桥。

想一想

在游戏里练得再好,到了现实为什么可能不管用?

23
第 8 章 · 第三节

核心技术之四:具身大模型

为机器人提供语言、视觉、动作一体化的能力。

第 23 页课件

重 点它能做什么

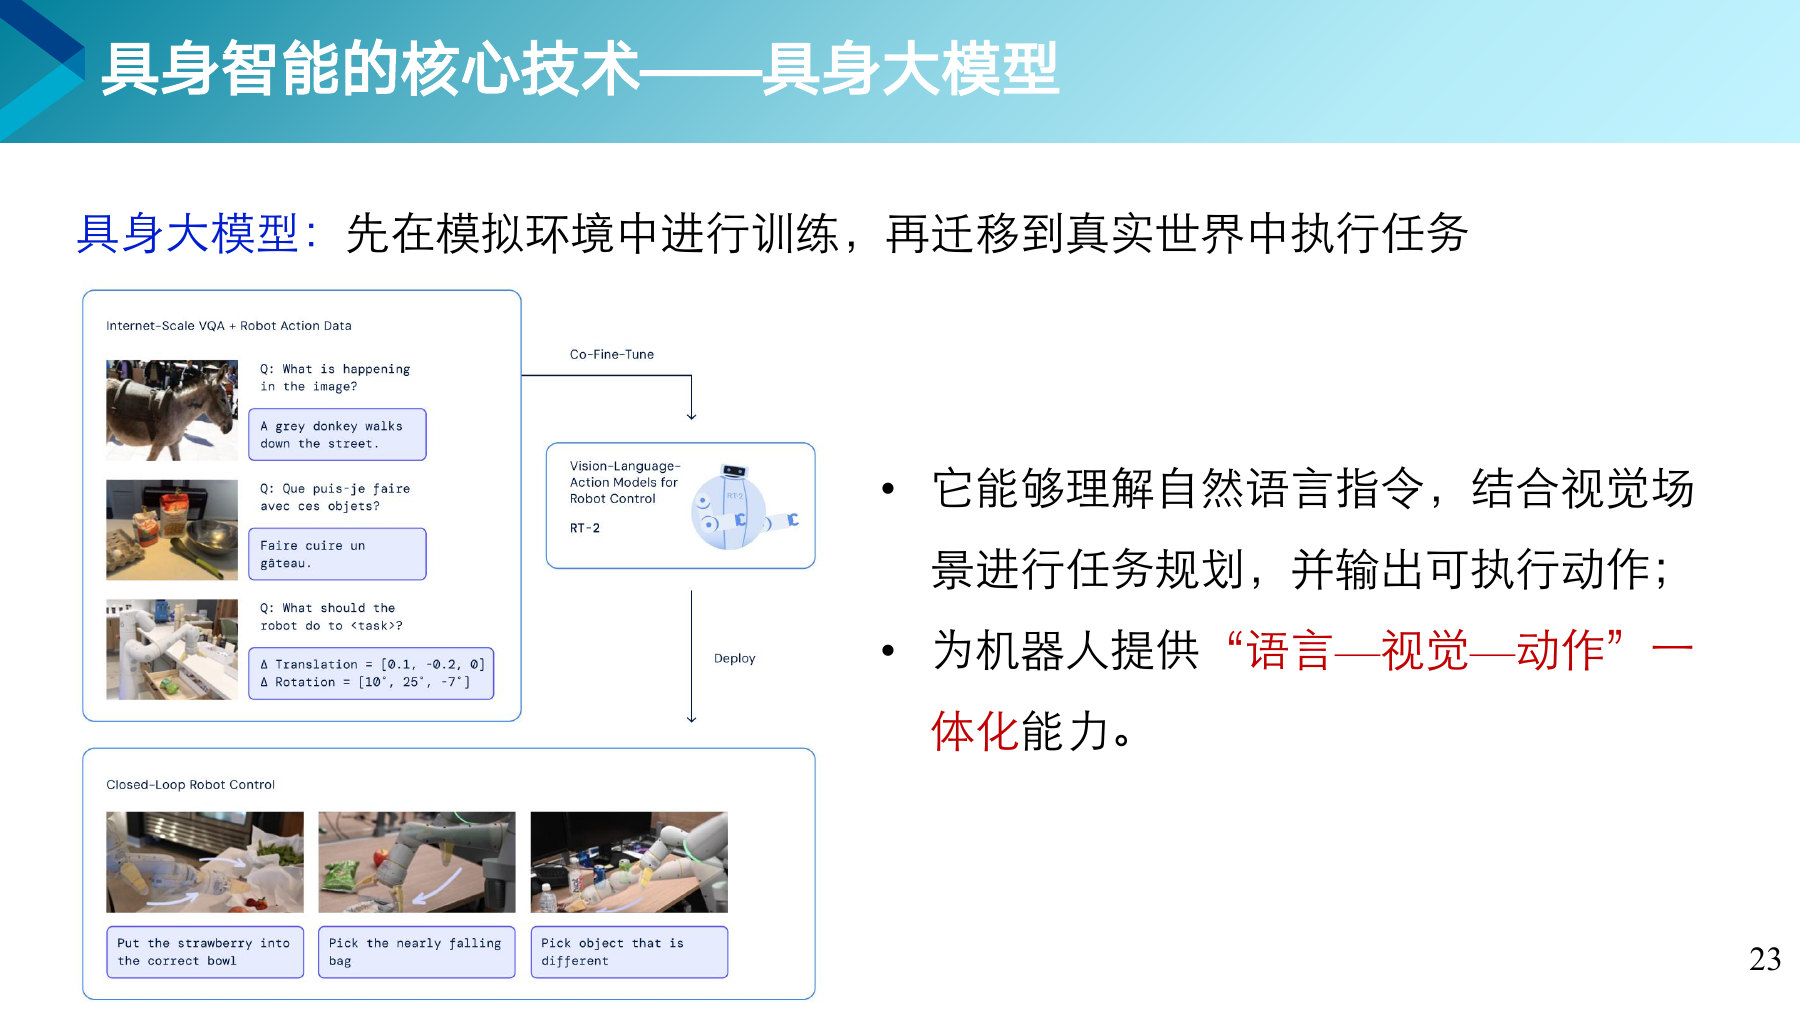
理解自然语言指令,结合视觉场景进行任务规划,并输出可执行动作。三件事在一个模型里完成,不用分成三段再拼起来。

打个比方图上那几个例子

把草莓放进正确的碗里、捡起快要掉下去的袋子、挑出不一样的那个物体。每一条都要同时用到语言理解、视觉判断和动作控制。

知道更多训练数据是怎么来的

图上左边写着互联网规模的视觉问答数据加机器人动作数据,两者联合微调。也就是说它一半知识来自网上的图文,一半来自真实的机器人操作记录。

想一想

挑出不一样的那个,这句话里藏着几个判断?

保山学院·人工智能教研室·曹鼎鼎