大模型的能力与边界
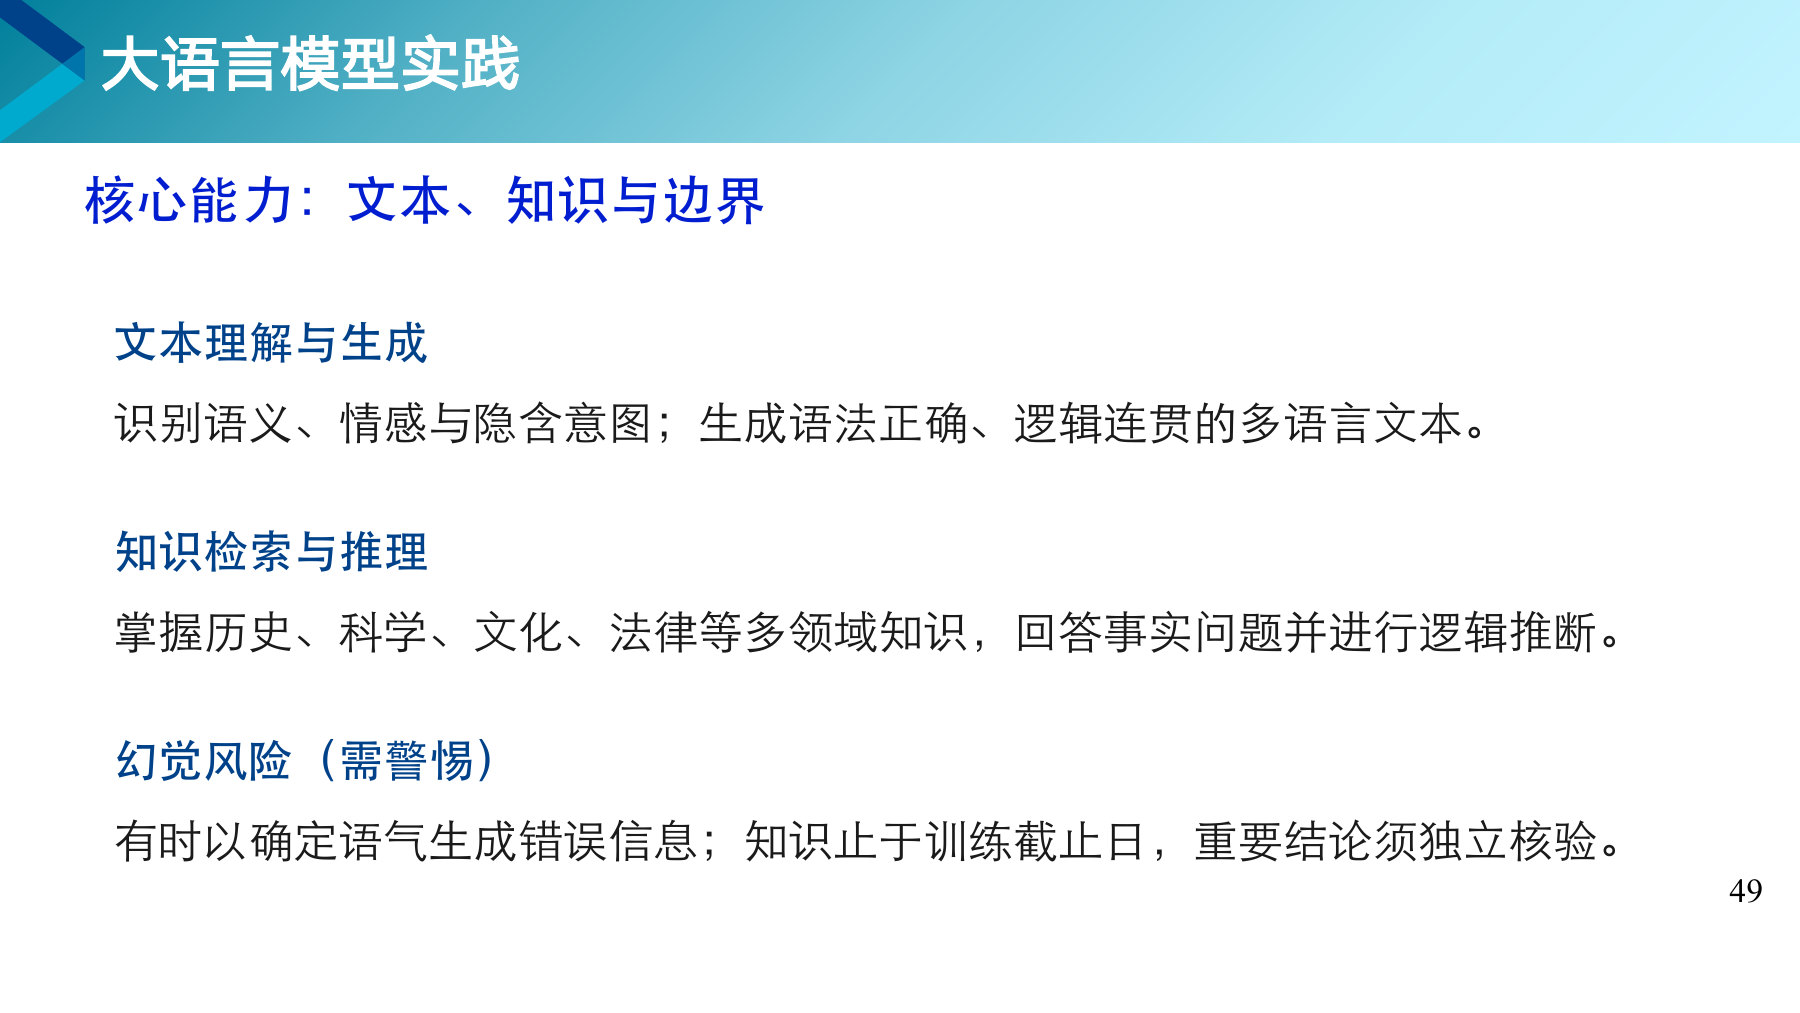
大模型能写能答,也会一本正经地说错。

关键术语
打个比方
请模型推荐几篇论文,它可能给出标题、作者、年份都像模像样的条目,一查却根本不存在。它说错时的语气,和说对时一模一样。
随堂练习
大模型回答得很肯定,还给了具体数字。哪种做法最稳妥?
- 语气肯定,直接采用
- 重要内容去权威来源核对
- 再问一遍,两次一样就对
- 数字越具体越可信
大模型能写能答,也会一本正经地说错。

请模型推荐几篇论文,它可能给出标题、作者、年份都像模像样的条目,一查却根本不存在。它说错时的语气,和说对时一模一样。
大模型回答得很肯定,还给了具体数字。哪种做法最稳妥?
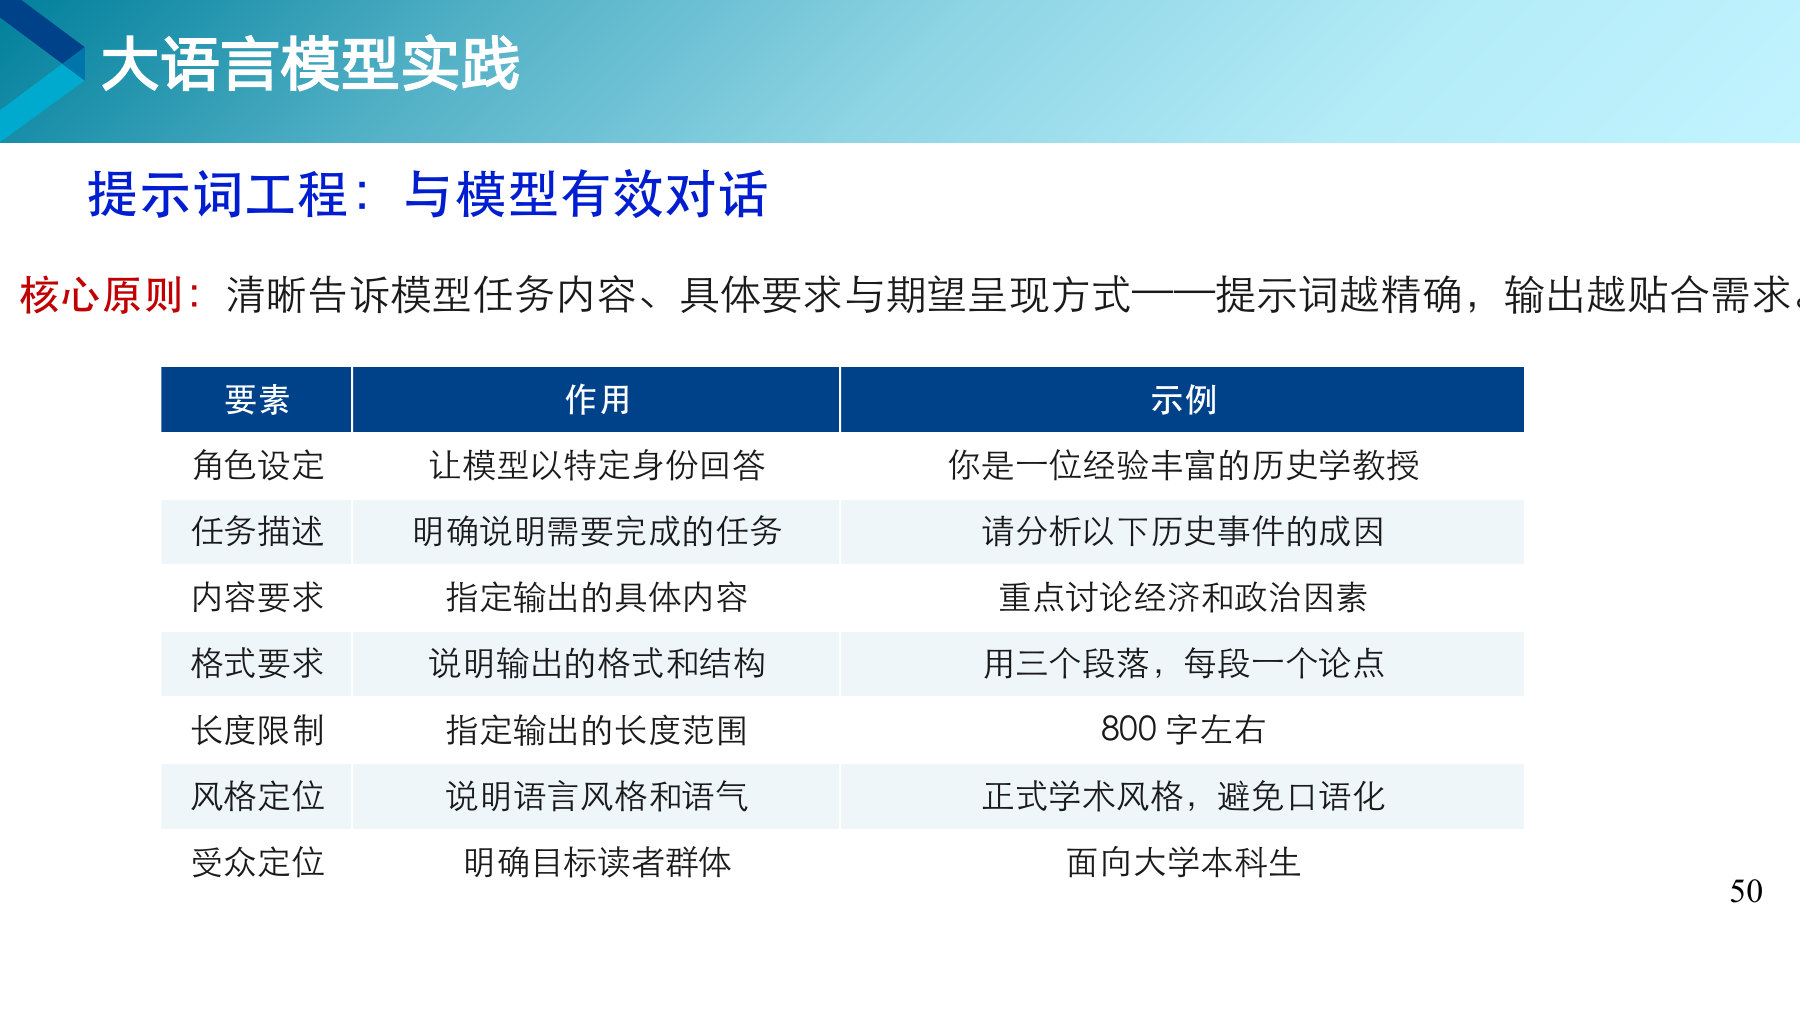
说得越具体,模型给的越接近你想要的。

把表里七条连起来:“你是一位历史学教授。请分析下面这个历史事件的成因,重点讨论经济和政治因素,分三个段落,每段一个论点,800 字左右,用正式的学术风格,读者是大学本科生。”
请人帮忙买奶茶,只说“帮我带一杯”,拿回来的可能不合口味。说清“中杯、少糖、去冰、加珍珠”,才会拿到想要的那一杯。
简单的问题写两三条就够。判断标准是:换一个完全不了解情况的人来做,看了你这段话能不能做对。
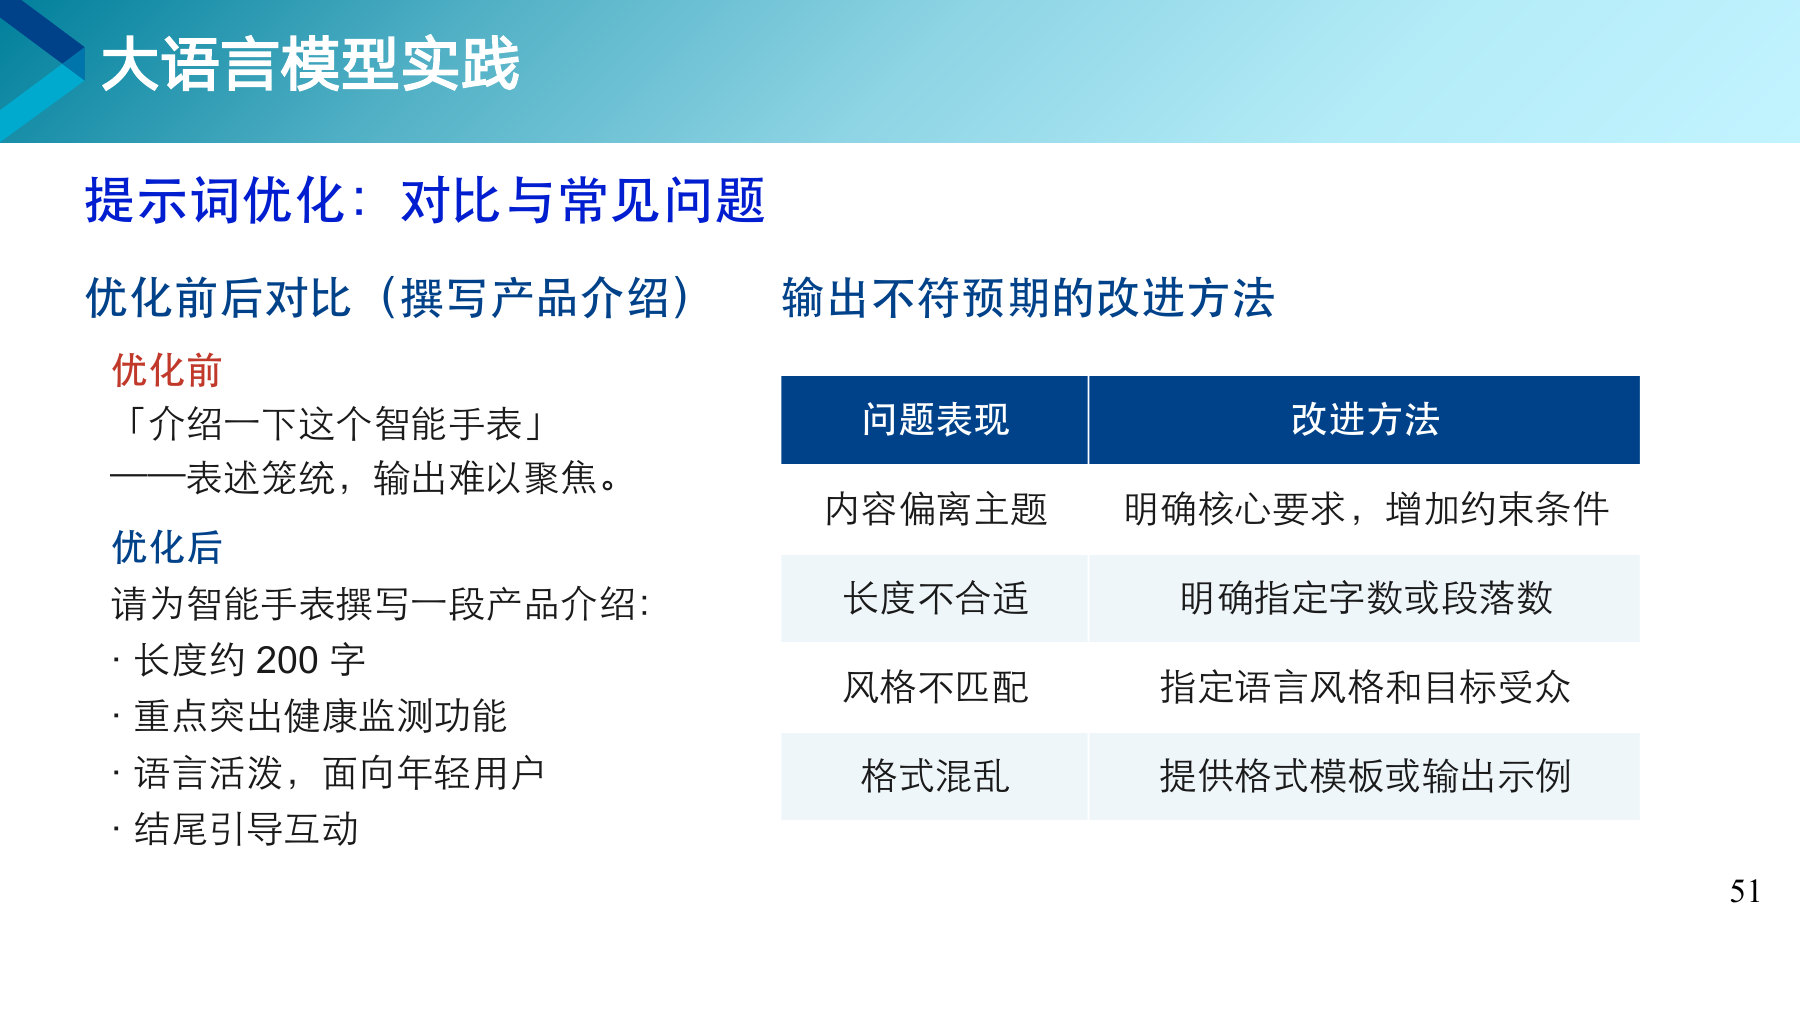
输出不对时,对着症状补上缺的那条要求。

优化前只说要做什么。优化后补上了长度、重点、风格和受众、结尾要求四条约束,模型就知道该往哪个方向写。
想要固定的格式,直接写一行样子给它看,比用文字描述半天管用。比如先示范一行“品名:×× | 价格:××元”,模型照着模仿,格式很少出错。
模型写的产品介绍总是太长,最直接的改法是?
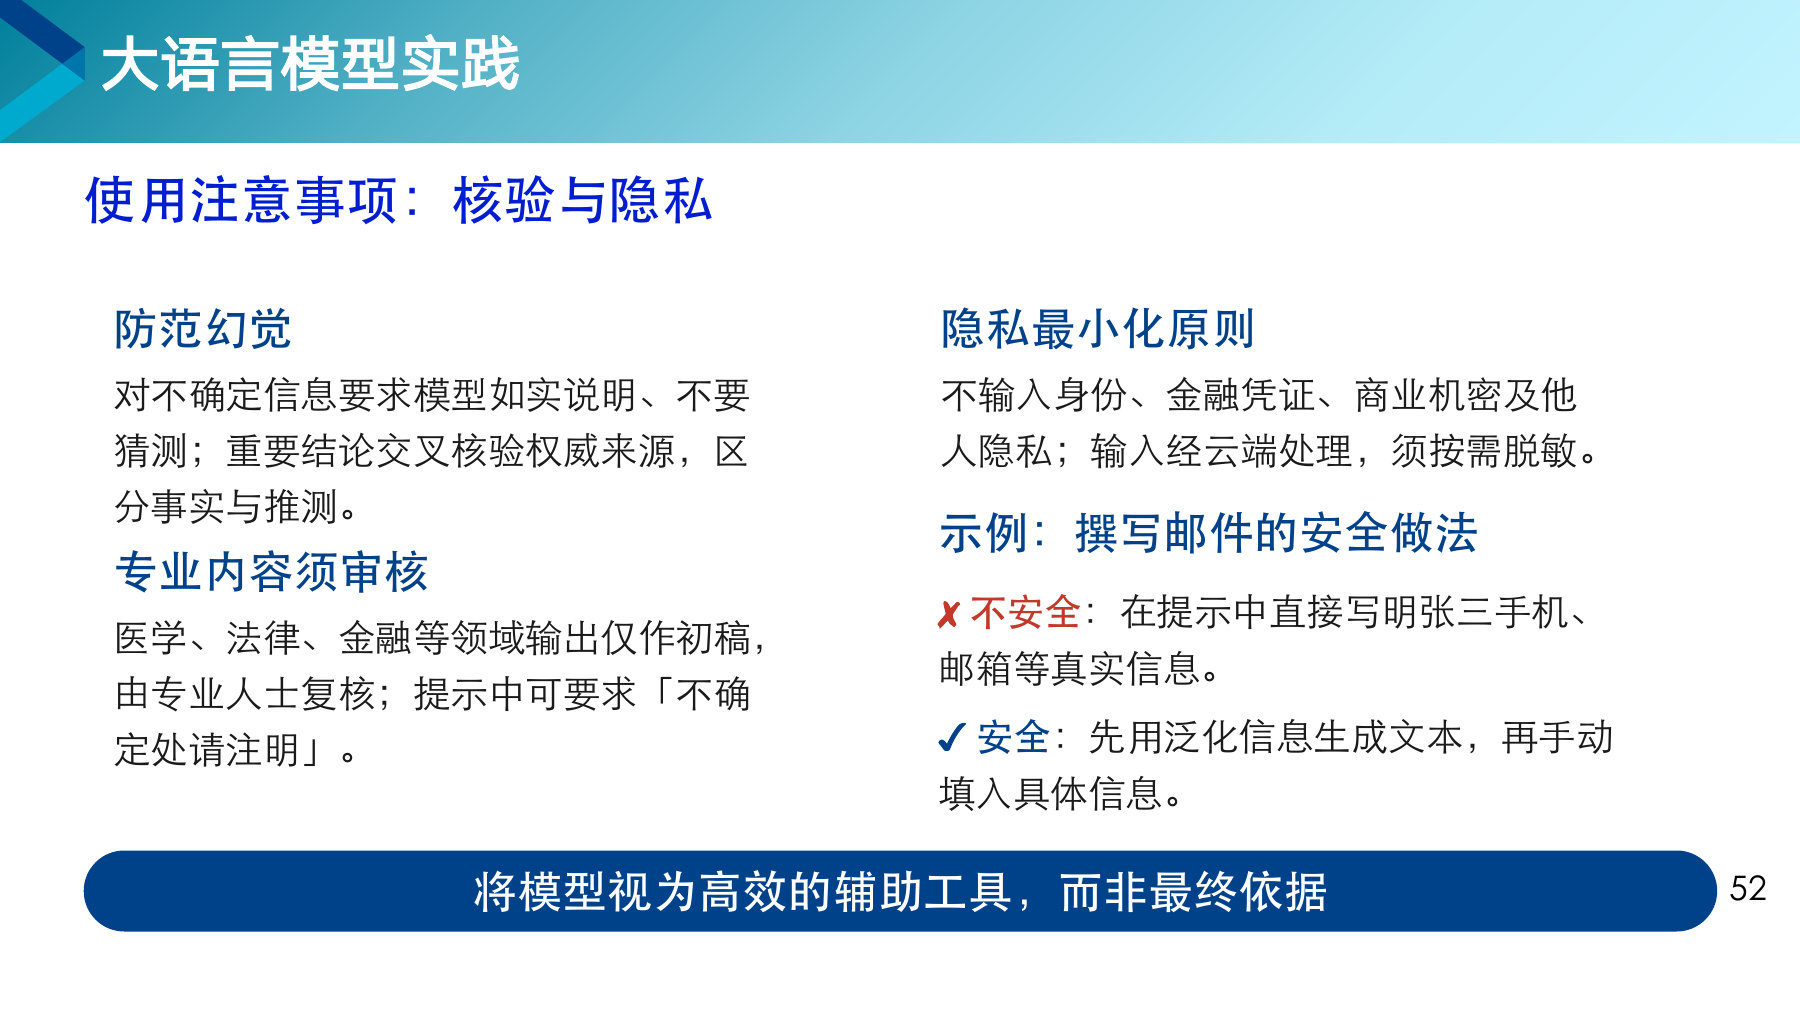
重要结论要核验,个人隐私不外传。

不确定的地方让模型说明,重要结论去查权威来源。医学、法律、金融方面的内容只当初稿,要专业人士把关。身份证号、银行卡、密码和别人的隐私不往里输。
请模型帮忙写一封给辅导员的请假邮件,可以先写成“我的姓名”“我的学号”这样的占位,生成好以后自己再填上真实信息。
用网页或 App 聊天时,你输入的文字要发到服务商的服务器上处理。输入之前先想一想,这段话能不能给陌生人看。
文字、图片、声音、视频,模型都能理解和生成。

基础识别回答“图里有什么”,比如一只猫、几行字。深度分析回答“这张图想表达什么”,比如气氛、画风、人物之间的关系。
拍一道没做出来的数学题上传,再问“第二步为什么这样变形”,模型会结合图里的题目和你的问题来回答。只发图或者只打字,它都不知道你卡在哪里。
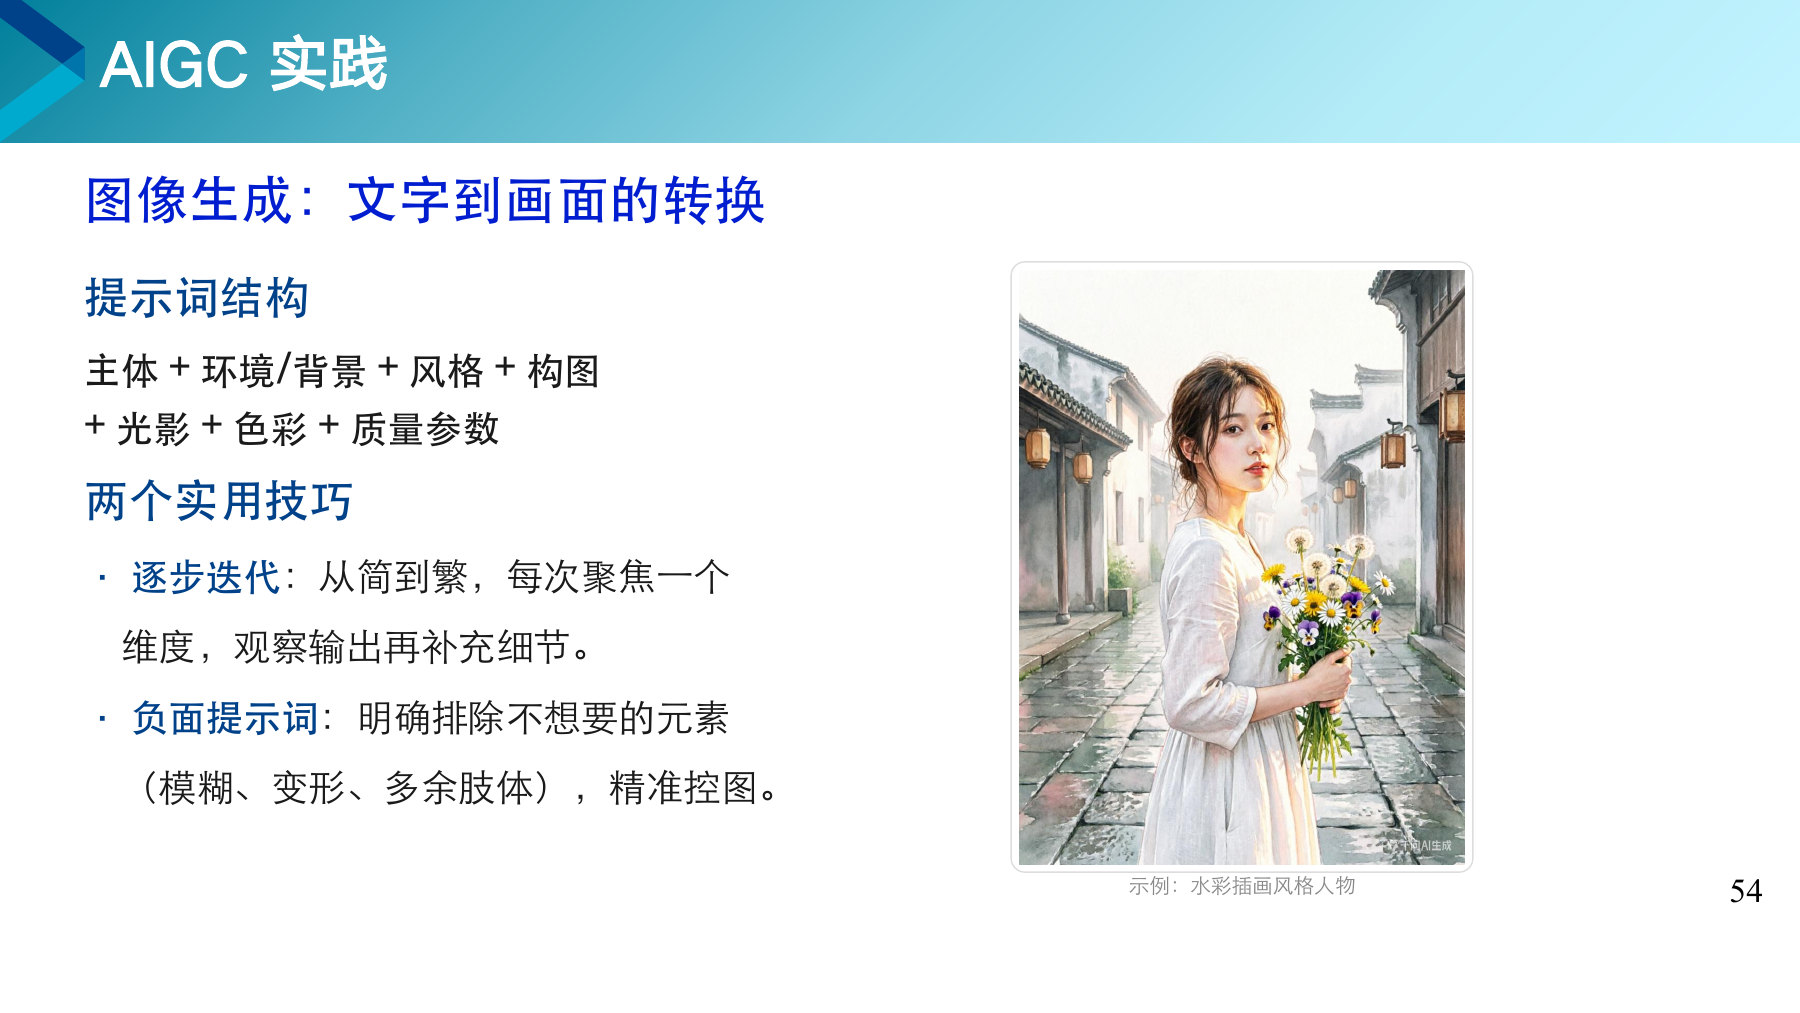
按主体、环境、风格等几段写提示词,逐步加细节。

主体是抱着一束野花的年轻女子,环境是雨后的江南小巷,风格是水彩插画,构图是人物站在画面中央,光影是阴天的柔光,色彩是淡雅的灰白色调。一段段写下来,画面的每一方面都交代到了。
逐步迭代像修照片:先调亮度,看看效果,再调颜色,再裁剪。一次把所有参数都改了,效果不好也不知道问题出在哪一步。
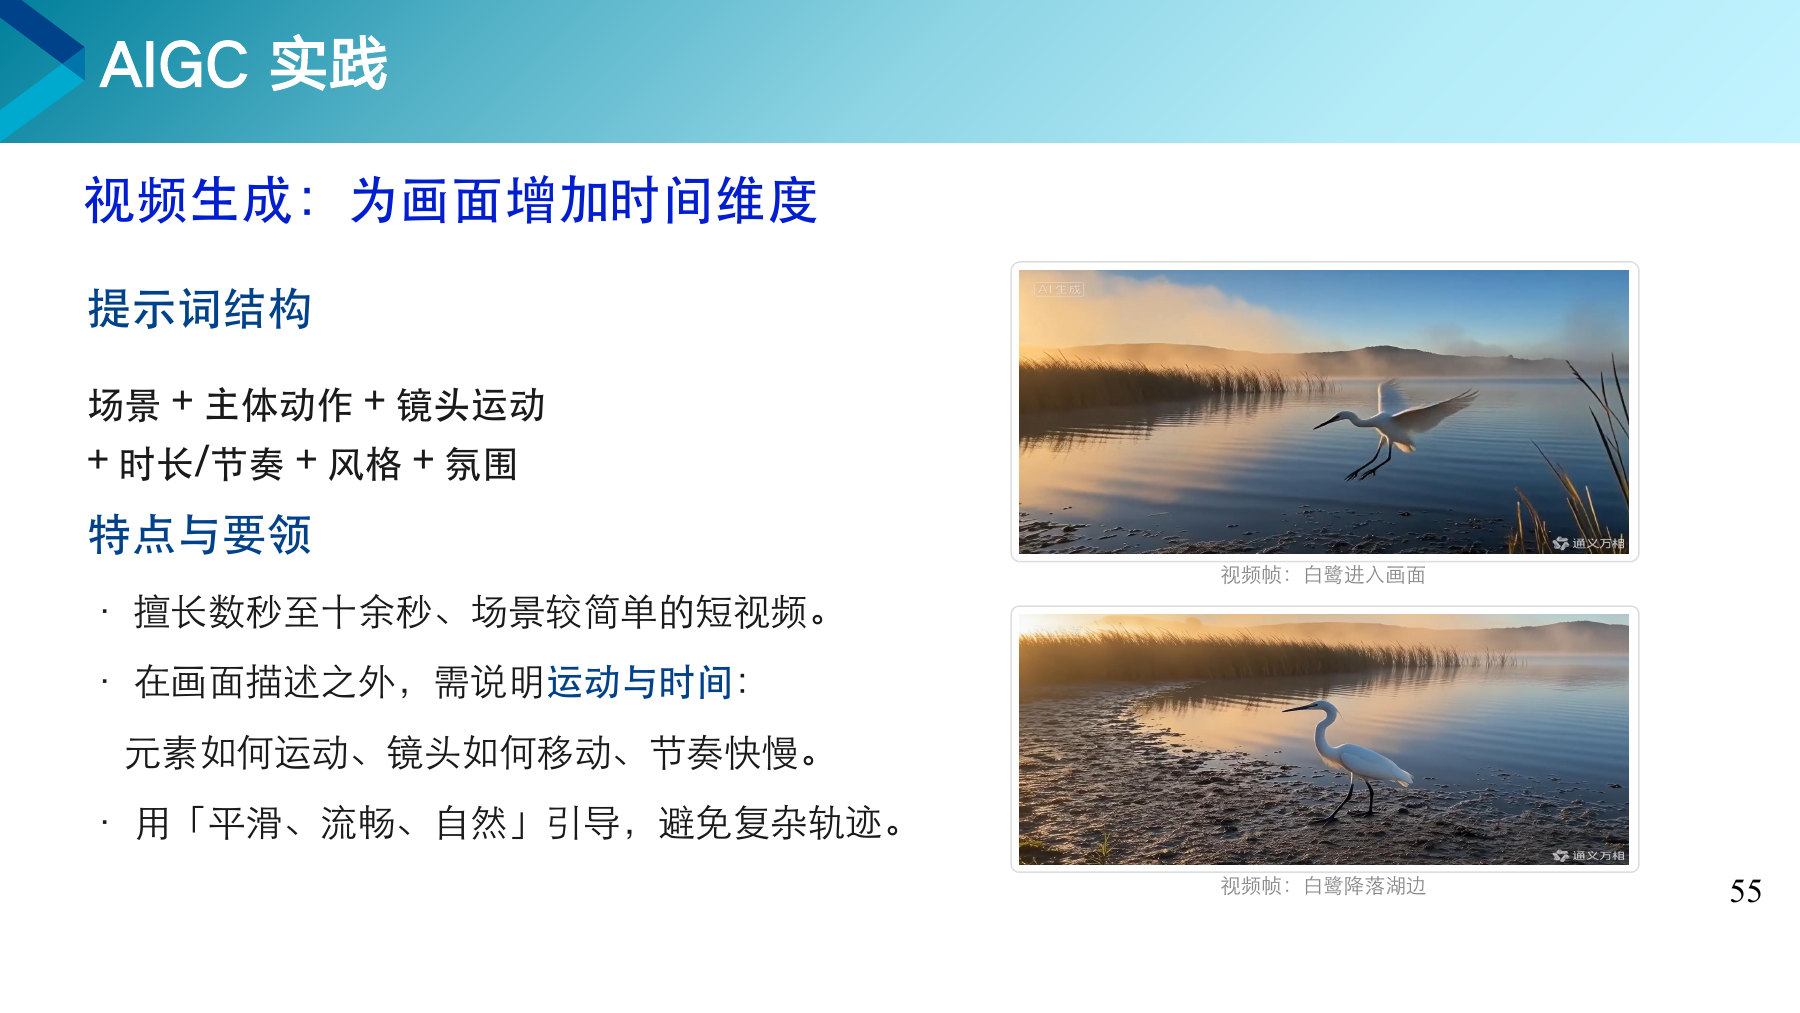
视频比图片多了一件事:说清东西怎么动。

和图片相比,视频提示词多了主体动作和镜头运动。右边两帧来自同一段视频,先是白鹭飞进画面,再落到湖边。写提示词就是把这样的动作顺序讲清楚。
生成视频比生成图片难得多,时间越长、动作越复杂,越容易出现人物变形、物体忽然消失。先写几秒钟、一两个平缓的动作,效果最稳。
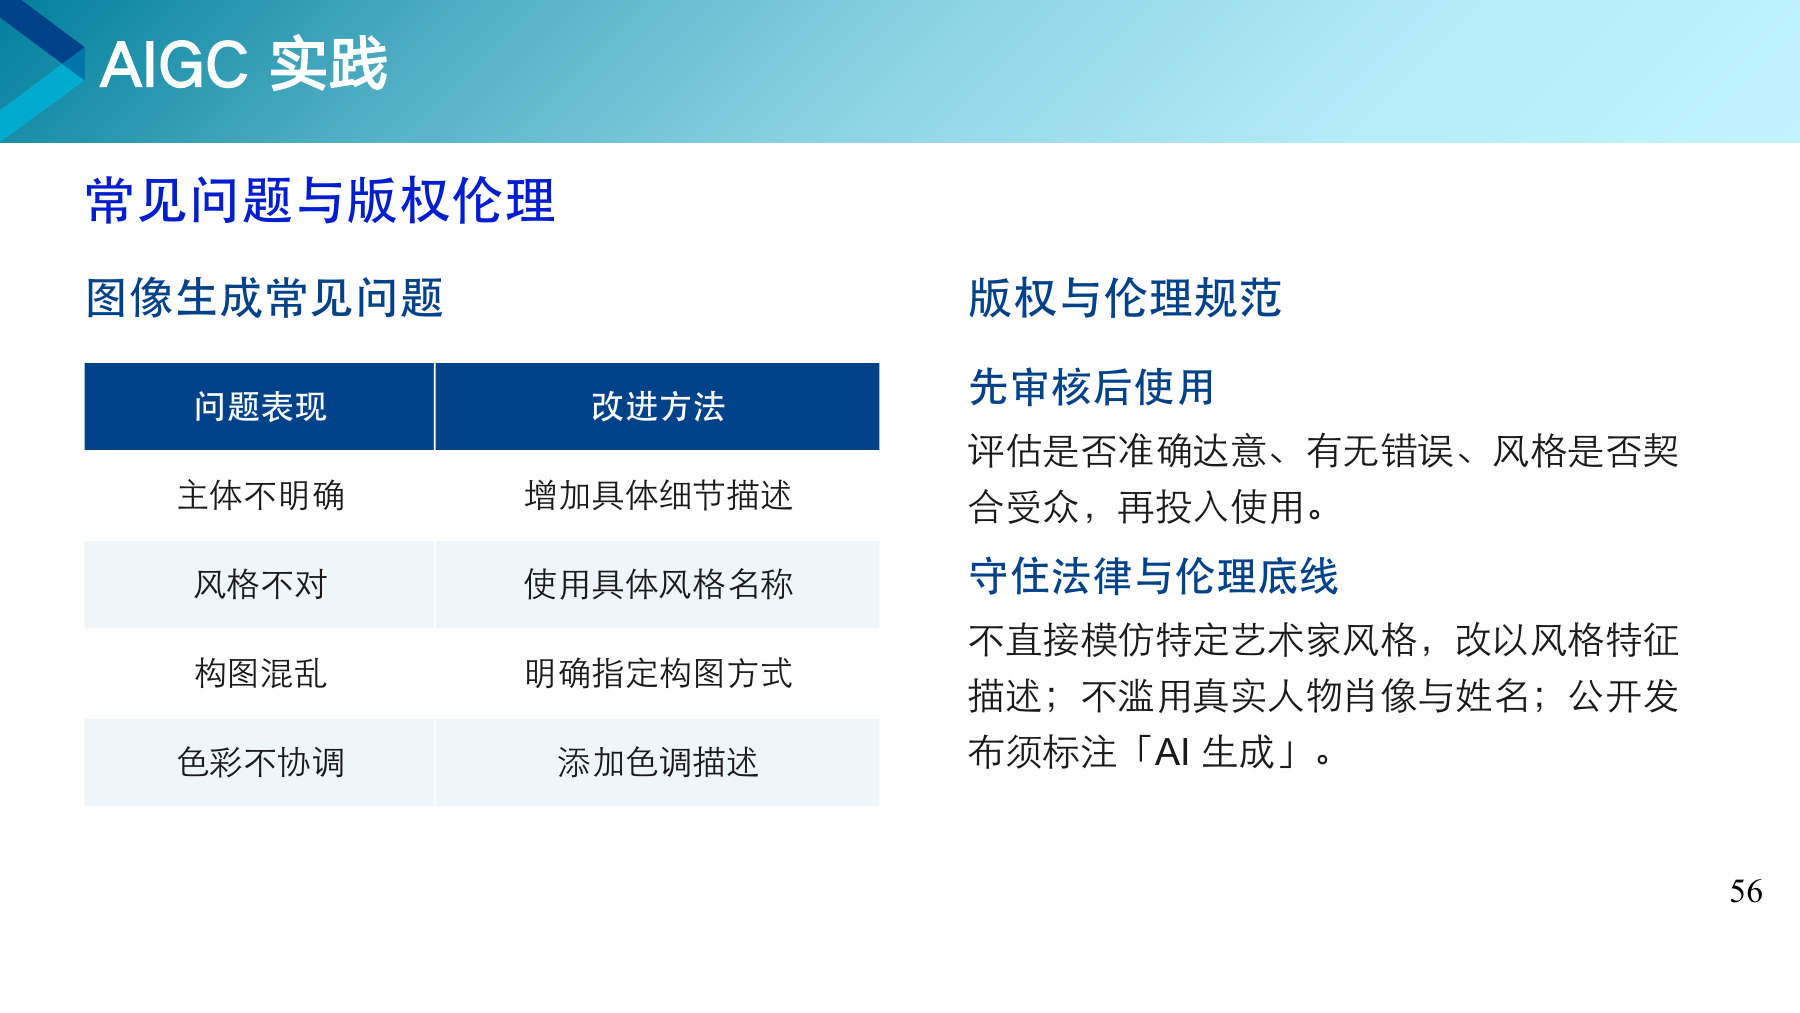
出图不对就把说法写具体,发布之前守住底线。

四类问题的改法有一个共同点:把模糊的说法换成具体的说法。“好看一点”换成“暖色调、逆光”,“有艺术感”换成“水彩画风”。
我国《人工智能生成合成内容标识办法》从 2025 年 9 月 1 日起施行,要求 AI 生成的文字、图片、音视频加上标识,用户发布时也要主动声明。
用 AI 画了一张海报,要发到学校公众号上。哪种做法合适?