监督学习与强化学习
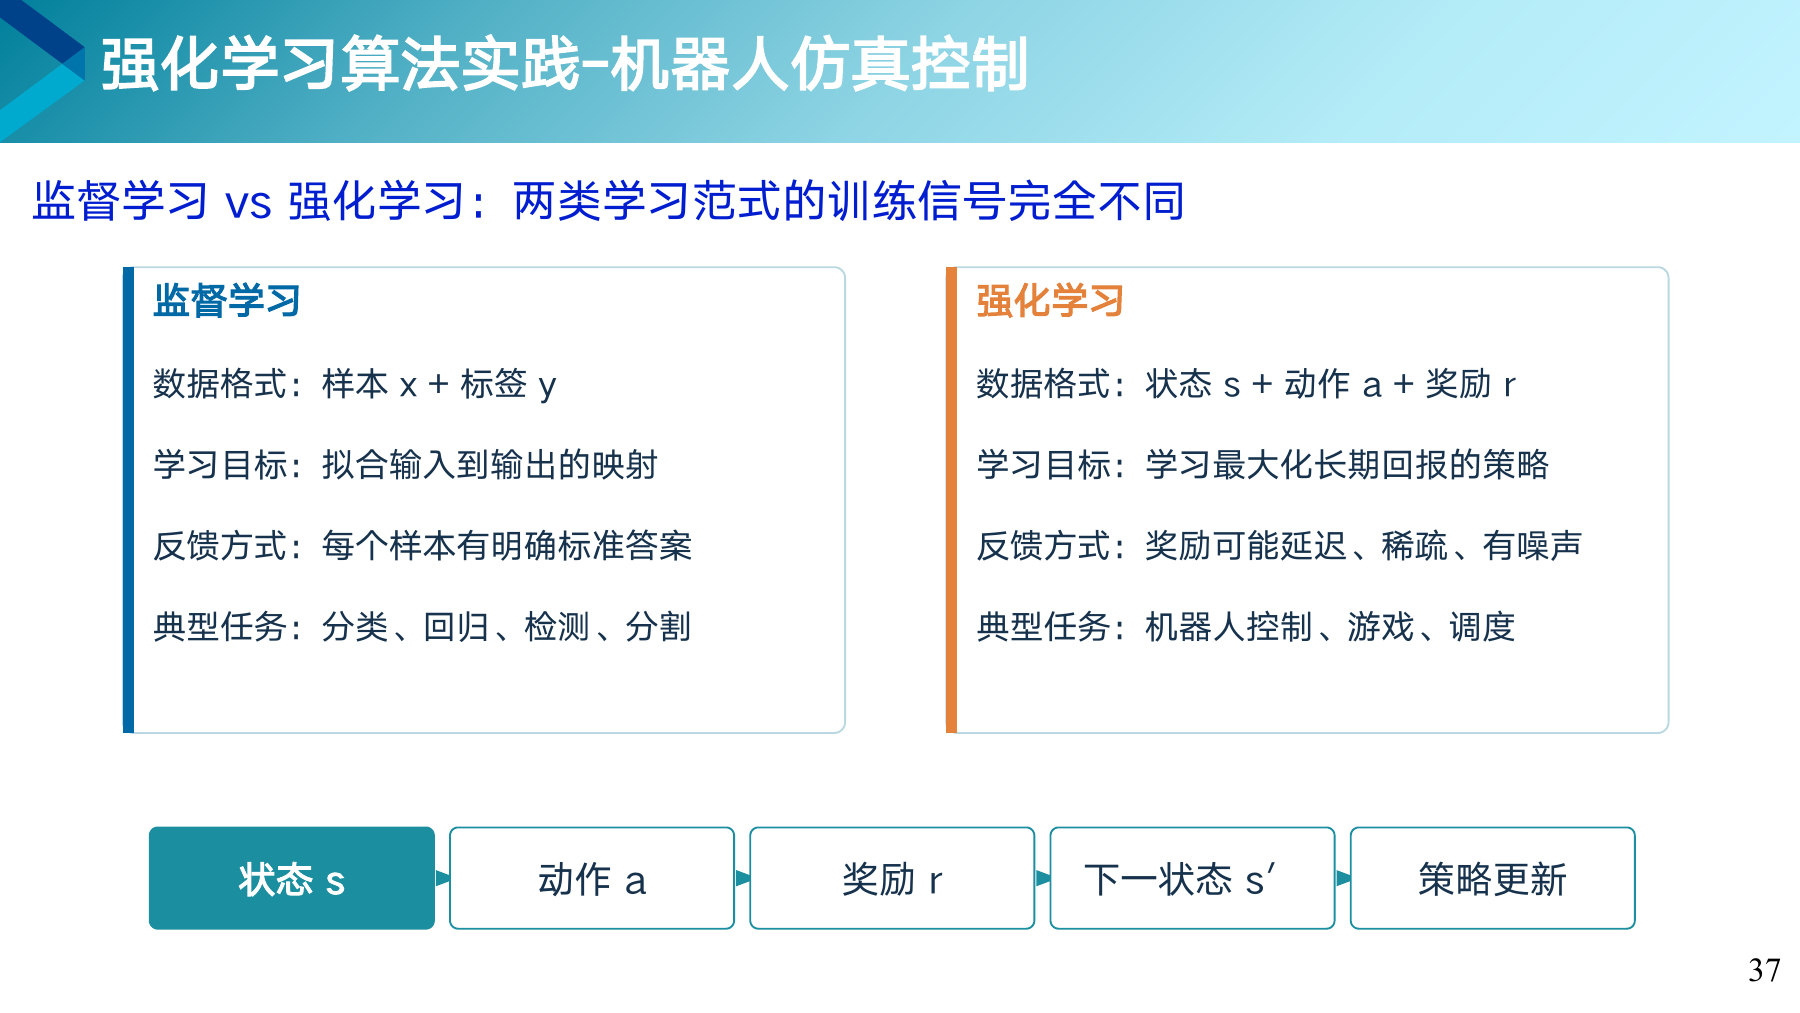
监督学习照着答案学,强化学习靠奖励自己摸索。

重 点差在训练信号上
监督学习的每条数据都配着标准答案。强化学习只有奖励,奖励可能来得很晚、很少,还夹着噪声。图下方那条链,就是第 3 章讲过的那个循环。
关键术语
打个比方
下一盘棋走两百步,最后才知道输赢,这是延迟。中间每一步都没有分数,只有终局一个结果,这是稀疏。到底哪一步走坏了,要自己慢慢琢磨。
监督学习照着答案学,强化学习靠奖励自己摸索。

监督学习的每条数据都配着标准答案。强化学习只有奖励,奖励可能来得很晚、很少,还夹着噪声。图下方那条链,就是第 3 章讲过的那个循环。
下一盘棋走两百步,最后才知道输赢,这是延迟。中间每一步都没有分数,只有终局一个结果,这是稀疏。到底哪一步走坏了,要自己慢慢琢磨。
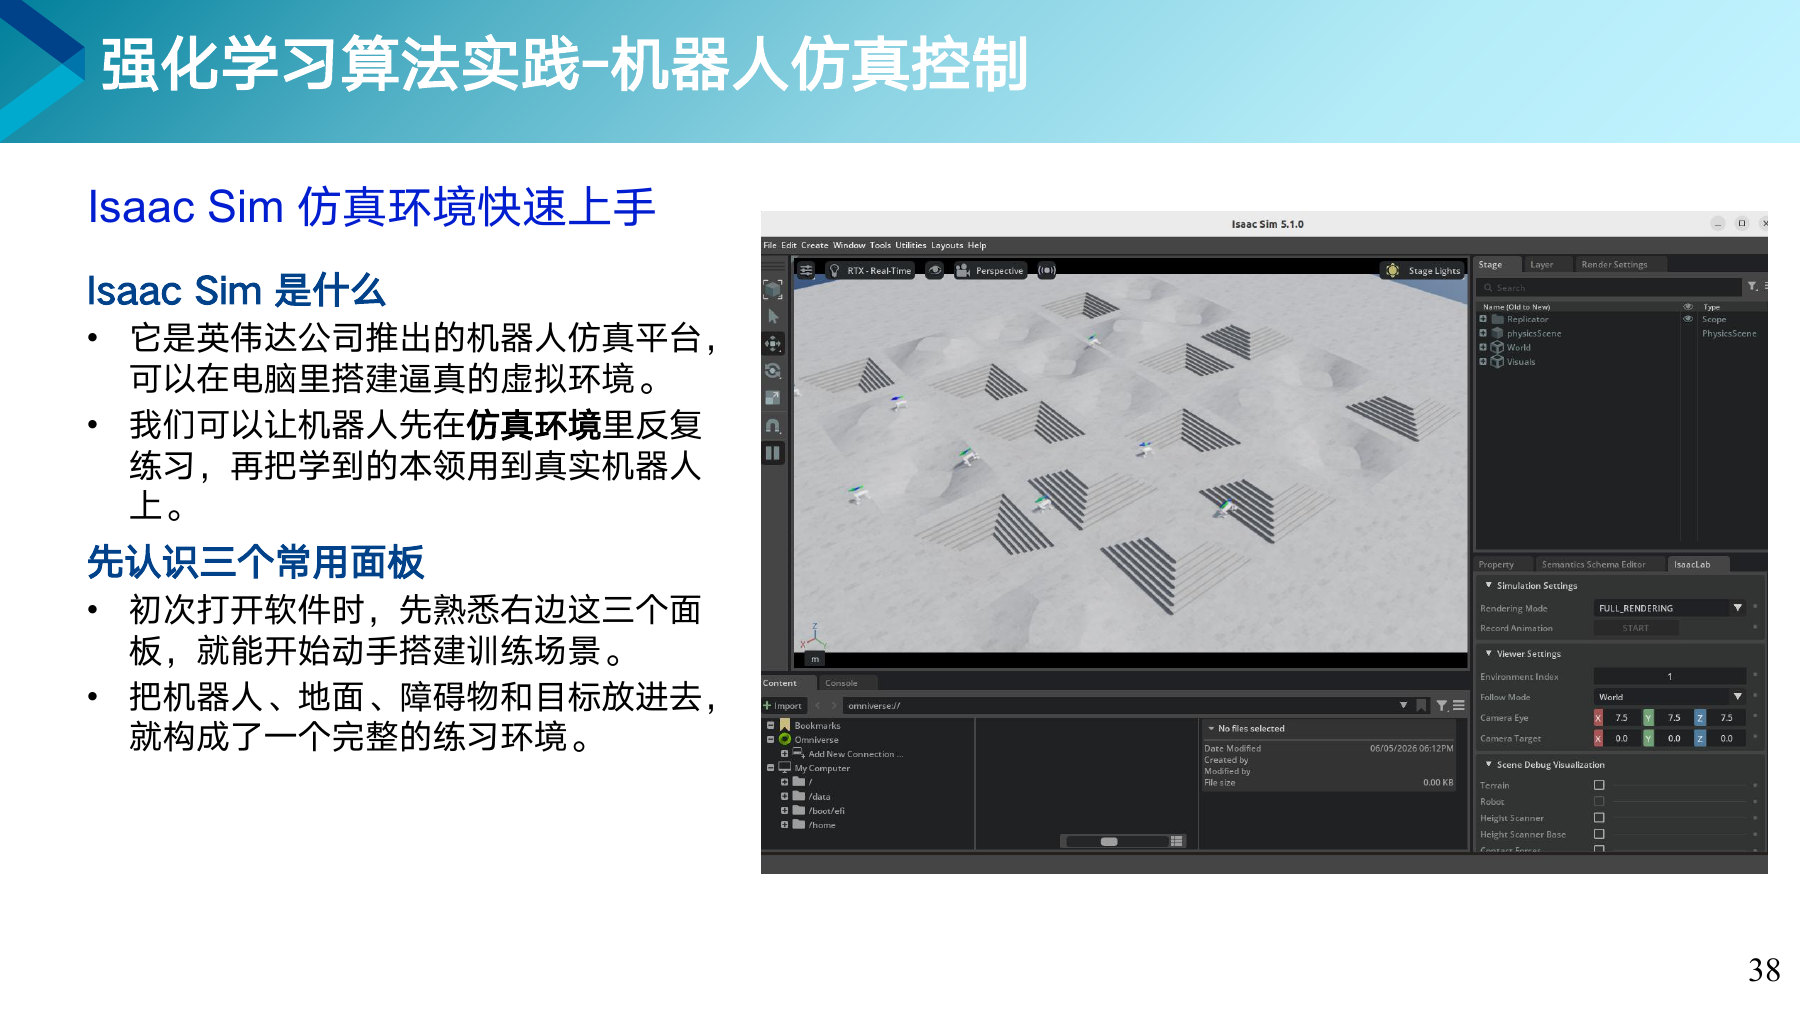
先在电脑里的虚拟世界练熟,再用到真机器人上。

强化学习要试错成千上万次。真机器人摔一次可能就坏了,在仿真里摔一百万次只花电费,还能同时开很多个环境一起练。
仿真和真实世界总有差别,比如地面的摩擦、电机的反应。仿真里学会的本领搬到真机器人上,常常还要再调一番。
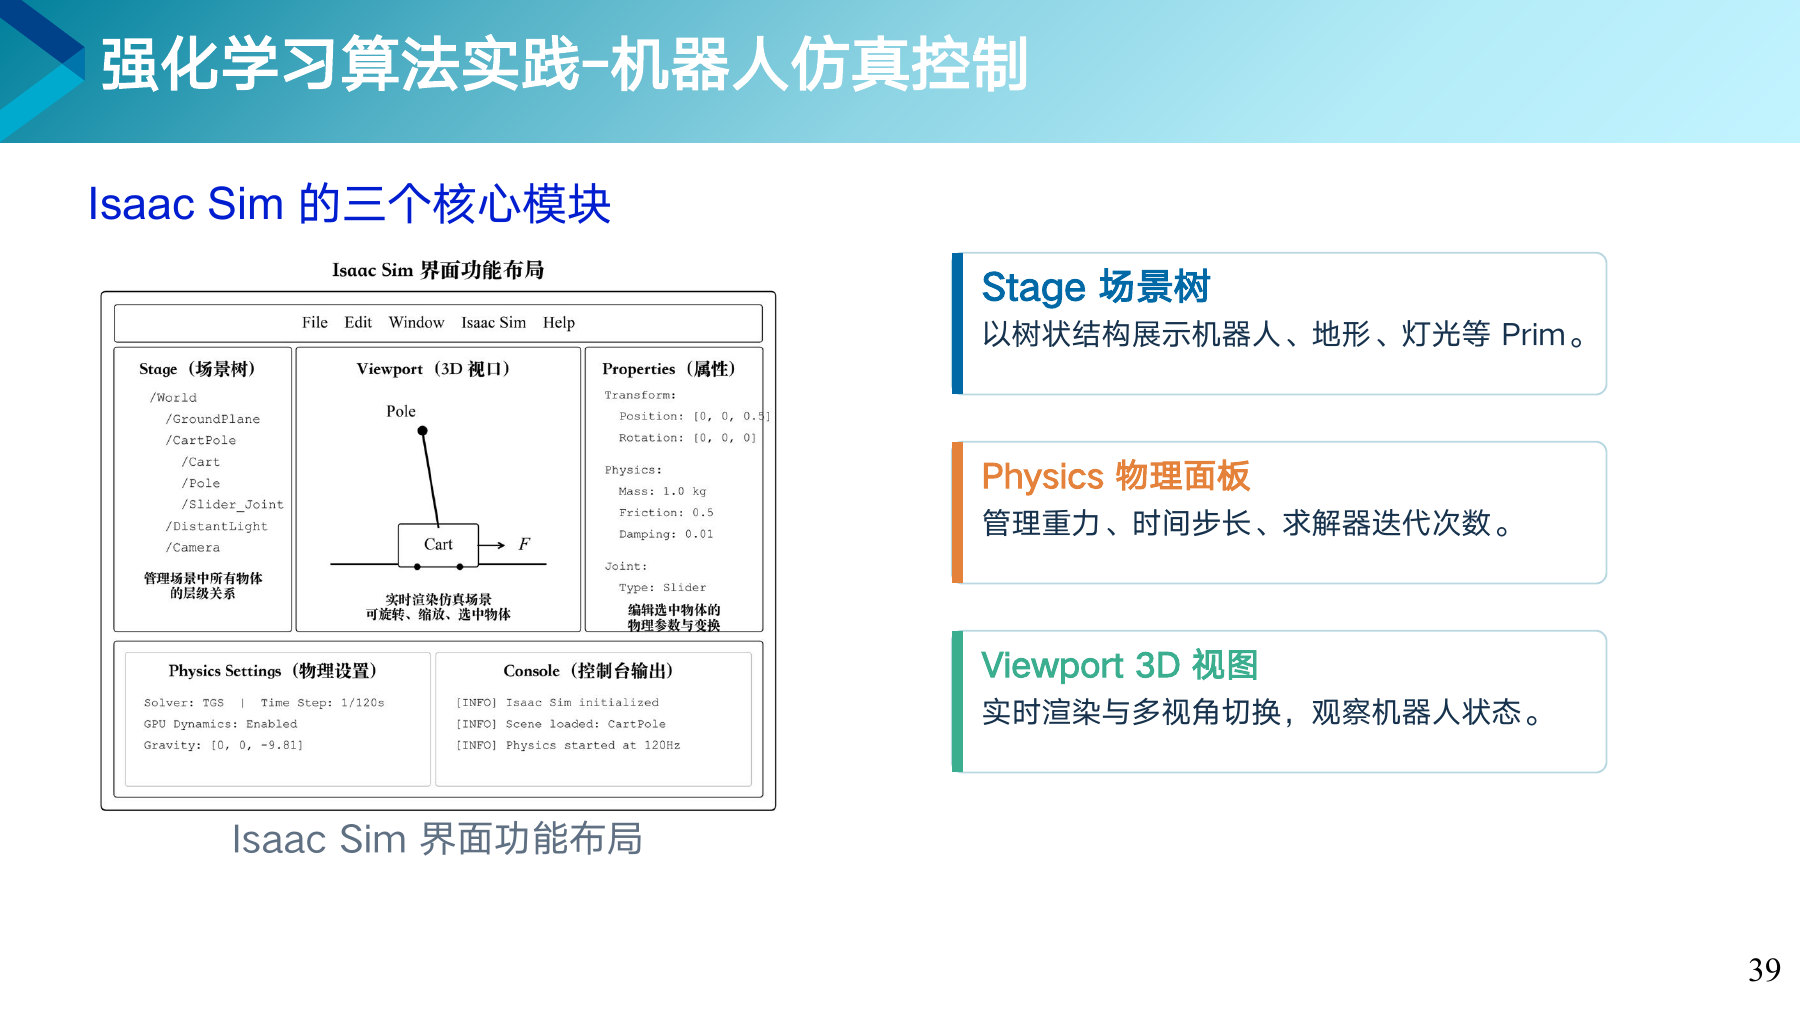
场景树管物体,物理面板管规则,视口负责看。

左栏的场景树把地面、小车、杆一层层挂起来,要改哪个物体就点哪一支。中间的视口实时画出小车和杆。右栏是选中物体的属性,比如质量 1 千克。
物理设置里的时间步长是 1/120 秒,仿真每算一步,世界就往前走这么久。步长太大,物体会穿墙乱跳,太小又算得很慢。
仿真里的重力、时间步长这些规则,在哪个面板里设置?
环境只要会“重新开始”和“走一步”,算法就能接上。
只要环境按这个规矩写好 reset 和 step,PPO、SAC 或者别的算法都能直接接上去训练,不用为每个环境重写算法。实验二的倒立摆,也是这样一个环境。
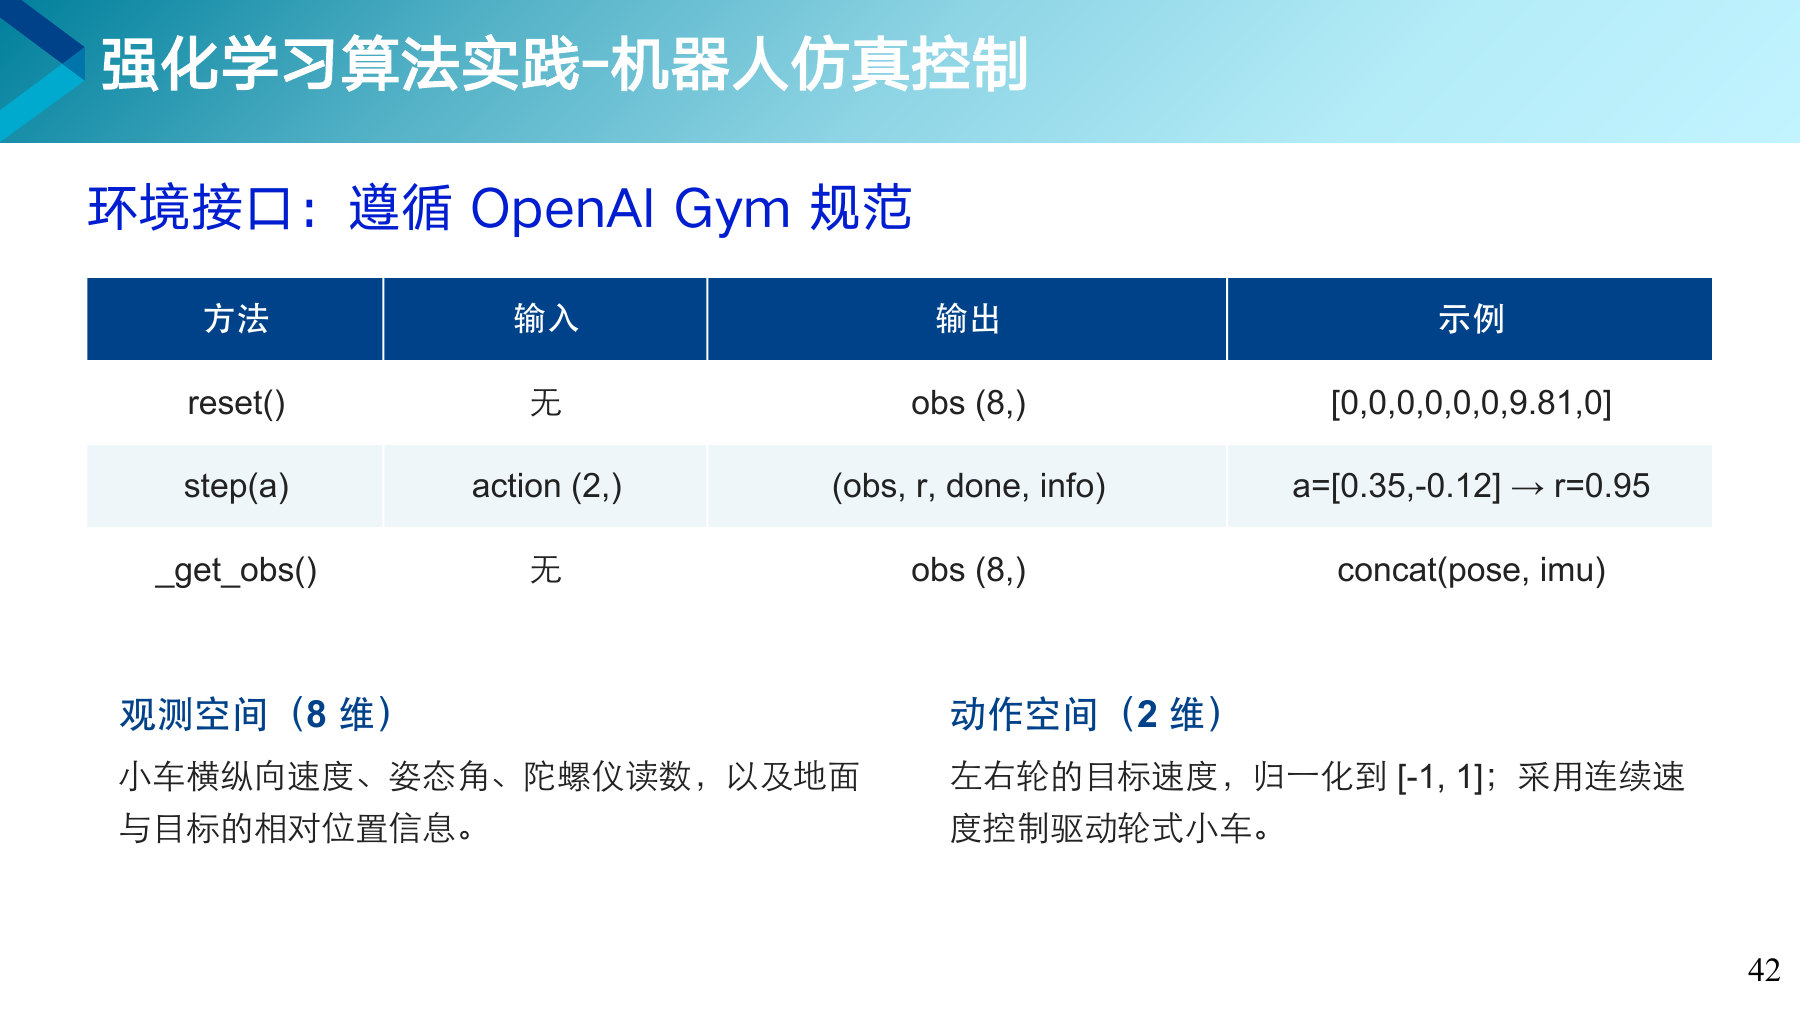
一张表写清每个方法要什么、交回什么。

reset 交回的第 7 个数是 9.81,那是静止时加速度计测到的重力。step 收到 [0.35, −0.12],左轮往前、右轮往后,小车边往前边向右转,这一步得到奖励 0.95。
调用 step 时,智能体要交给环境什么?
先试一段、打个分,再小步改进策略,一轮轮循环。
看到眼前的局面,决定下一步做什么动作。
不上场,只估计眼前这个局面能拿多少分。
学投篮时,教练发现你手腕太僵,只让你每次放松一点。要是一下子把整套投篮姿势推倒重来,原来会的也可能全乱套。PPO 每次只许策略改一点,防的也是这种情况。
训练聊天大模型时,常先让模型回答问题,再按人的评价打分,用 PPO 这类算法朝得分高的方向调整。第 3 章讲深度强化学习时提到过。
每一步经历都存进经验池,随机抽出来反复学。
篮球队每场比赛都录像,赛后从录像里挑几段反复看、反复琢磨。比赛只打一次,录像却能看很多遍。经验池就是这盘录像。
实验二里的 DQN 同样用了经验回放:把每一步的经历存起来,训练时随机抽出来反复学。
采集经验、算优势、小步更新,三步一轮。
和环境打交道很慢,每条经验都来之不易。收集一次反复学几遍,能省下很多试错。限定改动幅度,保证反复学也不会把策略带偏。
PPO 的缓冲区和 SAC 的经验池有什么不同?
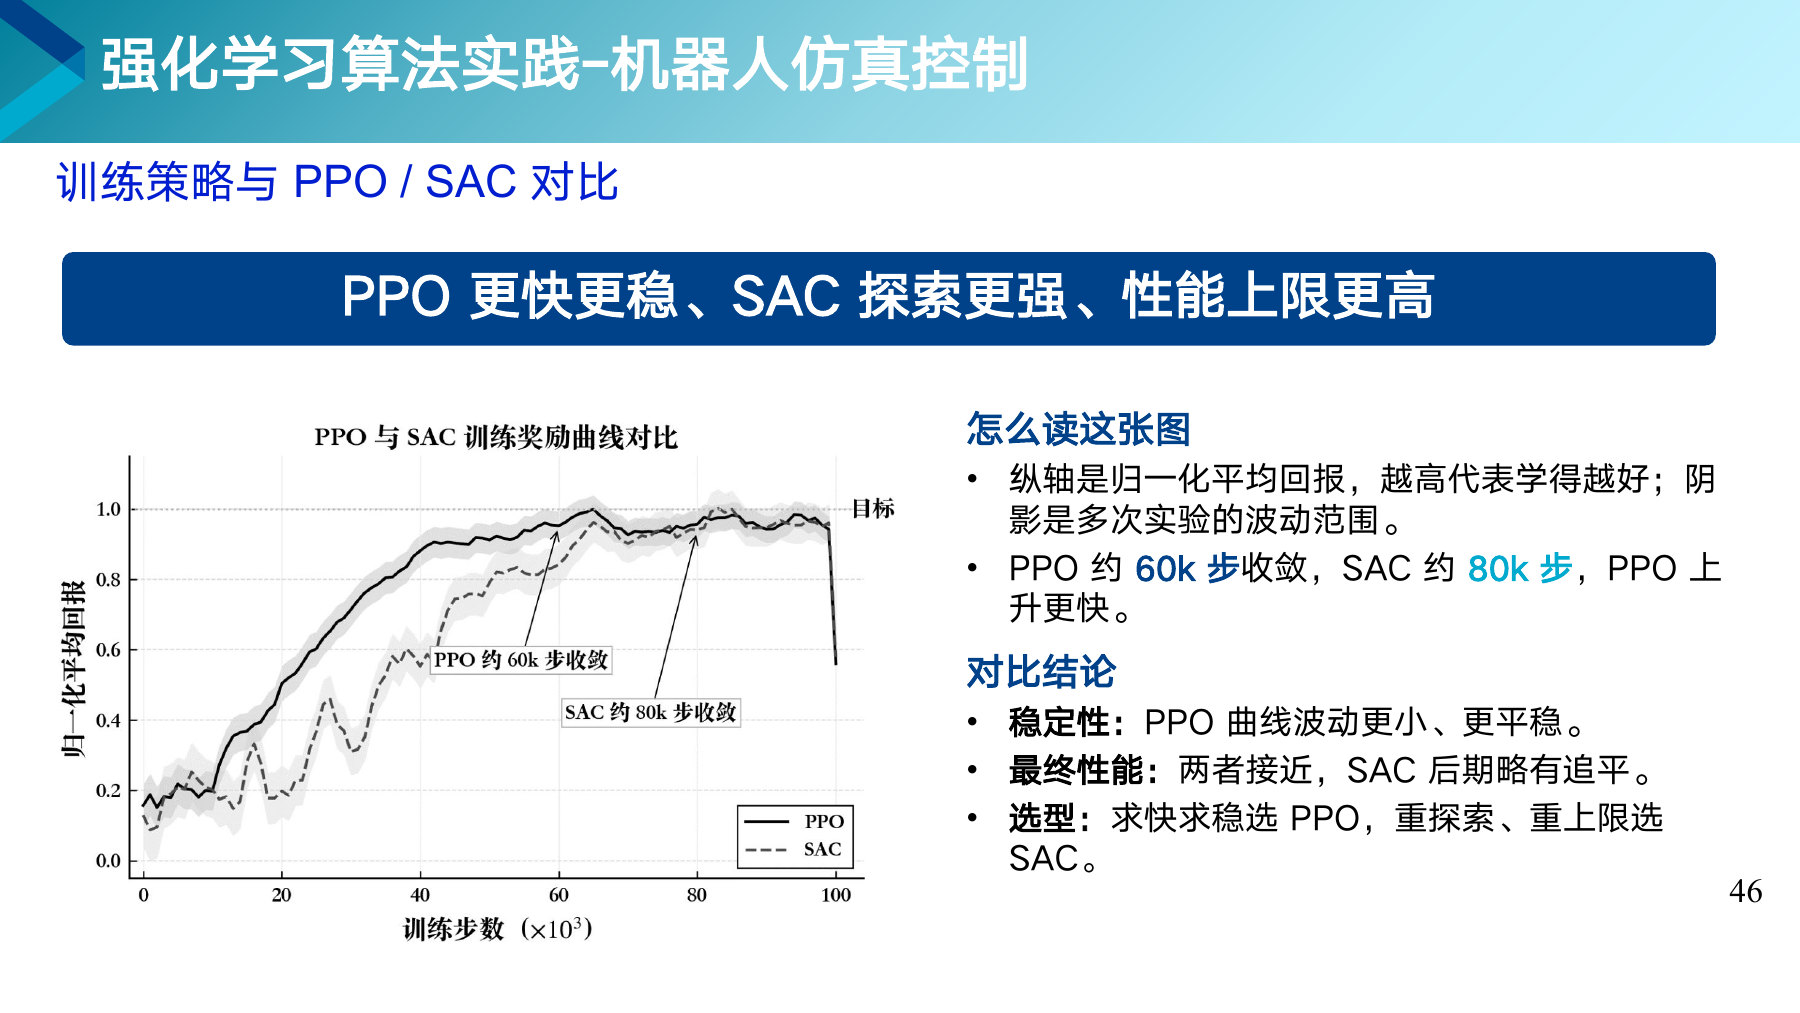
在这个任务上,PPO 上升更快更稳,SAC 后期追平。

横轴是训练步数,单位是千步,纵轴是平均回报,1.0 是目标水平。实线 PPO 约 6 万步收敛,虚线 SAC 约 8 万步。阴影是多次实验的波动范围。最右端两条线一起陡降,是画图时留下的瑕疵,读图时不用管它。
这是小车平衡任务上的一次对比。能同时开很多个仿真环境时,PPO 往往又快又稳。真实机器人试一次很贵,能反复利用旧经历的 SAC 常更省试错次数。
一个算法的平均曲线很高,阴影却很宽,说明什么?
奖励怎么给,机器人就学成什么样。
| 局面 | 存活 | 角度扣分 | 晃动扣分 | 这一步的奖励 |
|---|---|---|---|---|
| 站得很稳:倾角 0.02(约 1°),角速度 0.1 | 1 | −0.002 | −0.001 | 0.997 |
| 有点歪:倾角 0.2(约 11°),角速度 1 | 1 | −0.2 | −0.1 | 0.7 |
| 快要倒:倾角 0.6(约 34°),角速度 3 | 1 | −1.8 | −0.9 | −1.7 |
只给存活奖励、不扣角度分,机器人可能学会歪着身子硬撑,只要不倒就一直拿分。奖励里写进了什么,它就追求什么,没写进去的一概不管。
按这个奖励函数的三项规则,倾角 0.4 弧度、角速度为 0 时,这一步的奖励是多少?
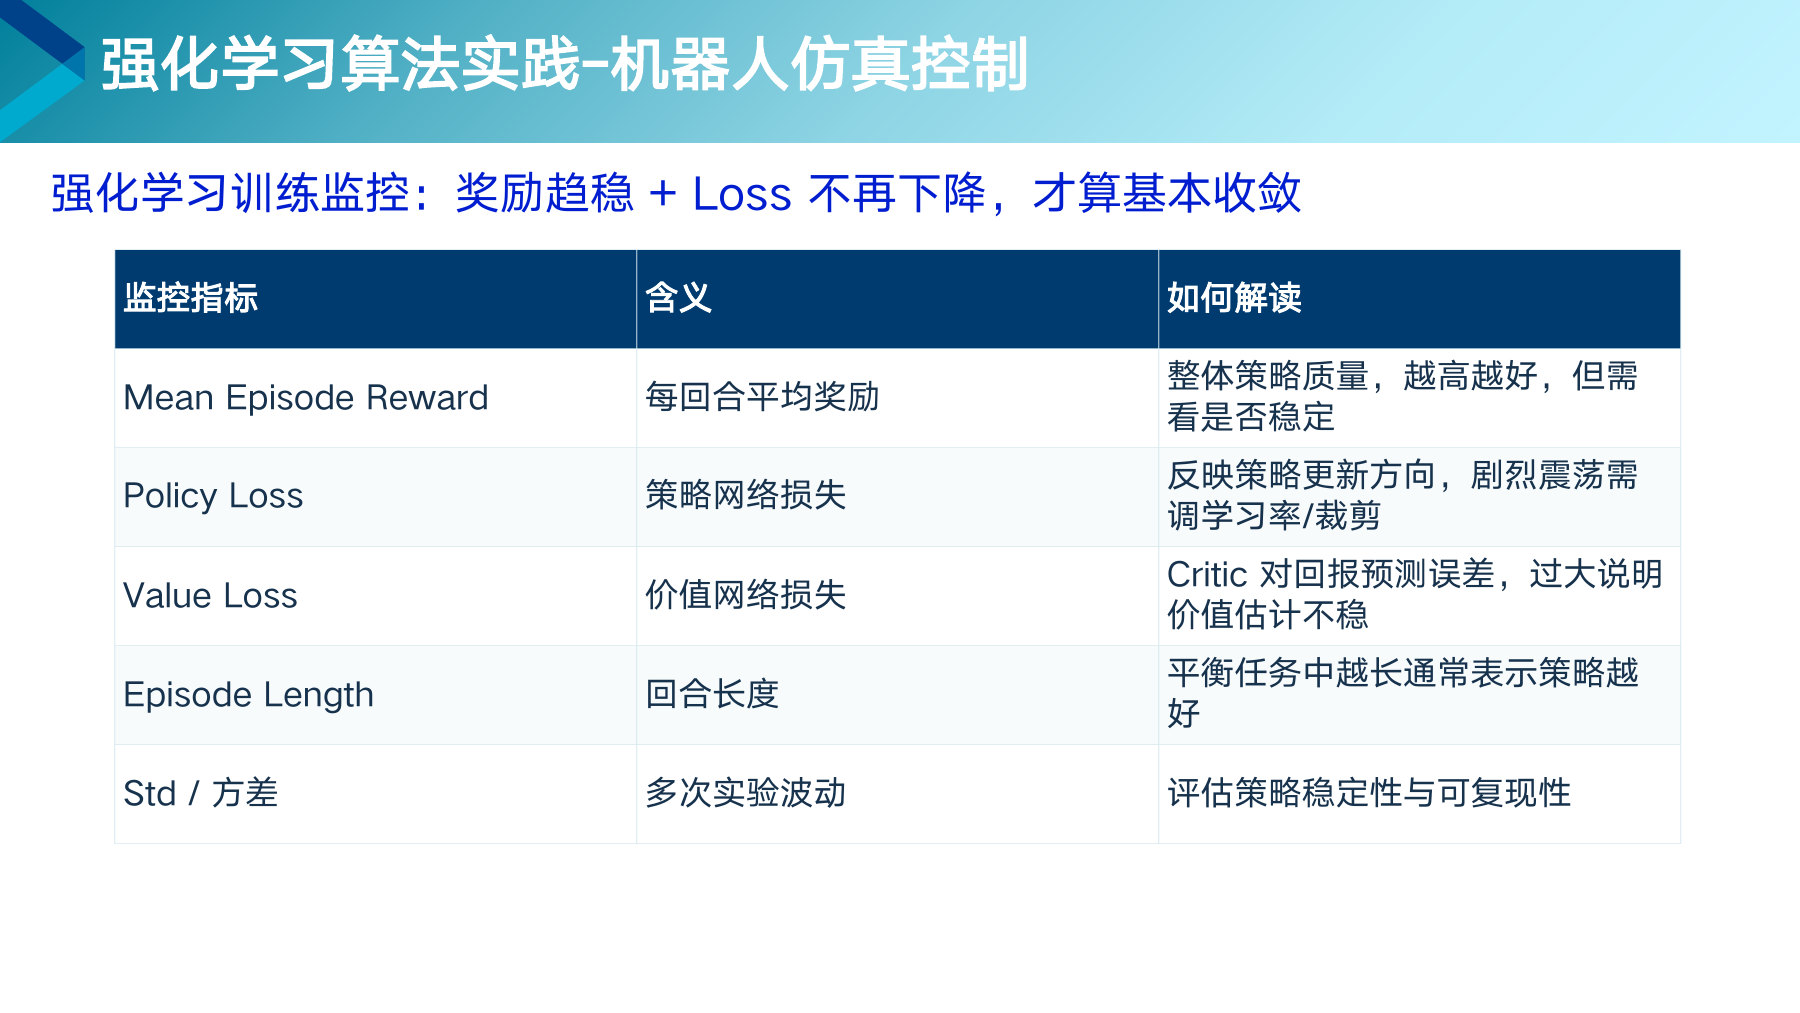
奖励趋稳、损失不再下降,才算基本练好。

奖励涨上去了,损失却还在剧烈抖动,说明策略还没稳住,随时可能掉下来。奖励平稳、损失不再下降,再加上几次实验的结果差不多,才能算练好了。
第二节看训练曲线时,要把损失曲线、验证指标和显卡利用率放在一起看。强化学习也一样,只盯一个数很容易被骗。