人工智能导论 第 7 章 · 第五节
课程 › 第 7 章 › 第五节 两种学习Isaac Sim三个面板环境接口接口规范PPOSACPPO 训练循环PPO 与 SAC奖励设计训练监控
第 7 章 人工智能实践 · 第五节

强化学习实践

在仿真里教小车保持平衡
本 节 知 识 点
  1. 37监督学习与强化学习
  2. 38Isaac Sim 仿真环境
  3. 39Isaac Sim 的三个主要面板
  4. 40Gym 风格的环境接口
  5. 42环境接口规范
  6. 43PPO:边试边改,每次改一点
  7. 44SAC:把经历存起来反复用
  8. 45PPO 的训练程序
  9. 46PPO 与 SAC 对比
  10. 47奖励函数设计
  11. 48训练监控指标
37
第 7 章 · 第五节

监督学习与强化学习

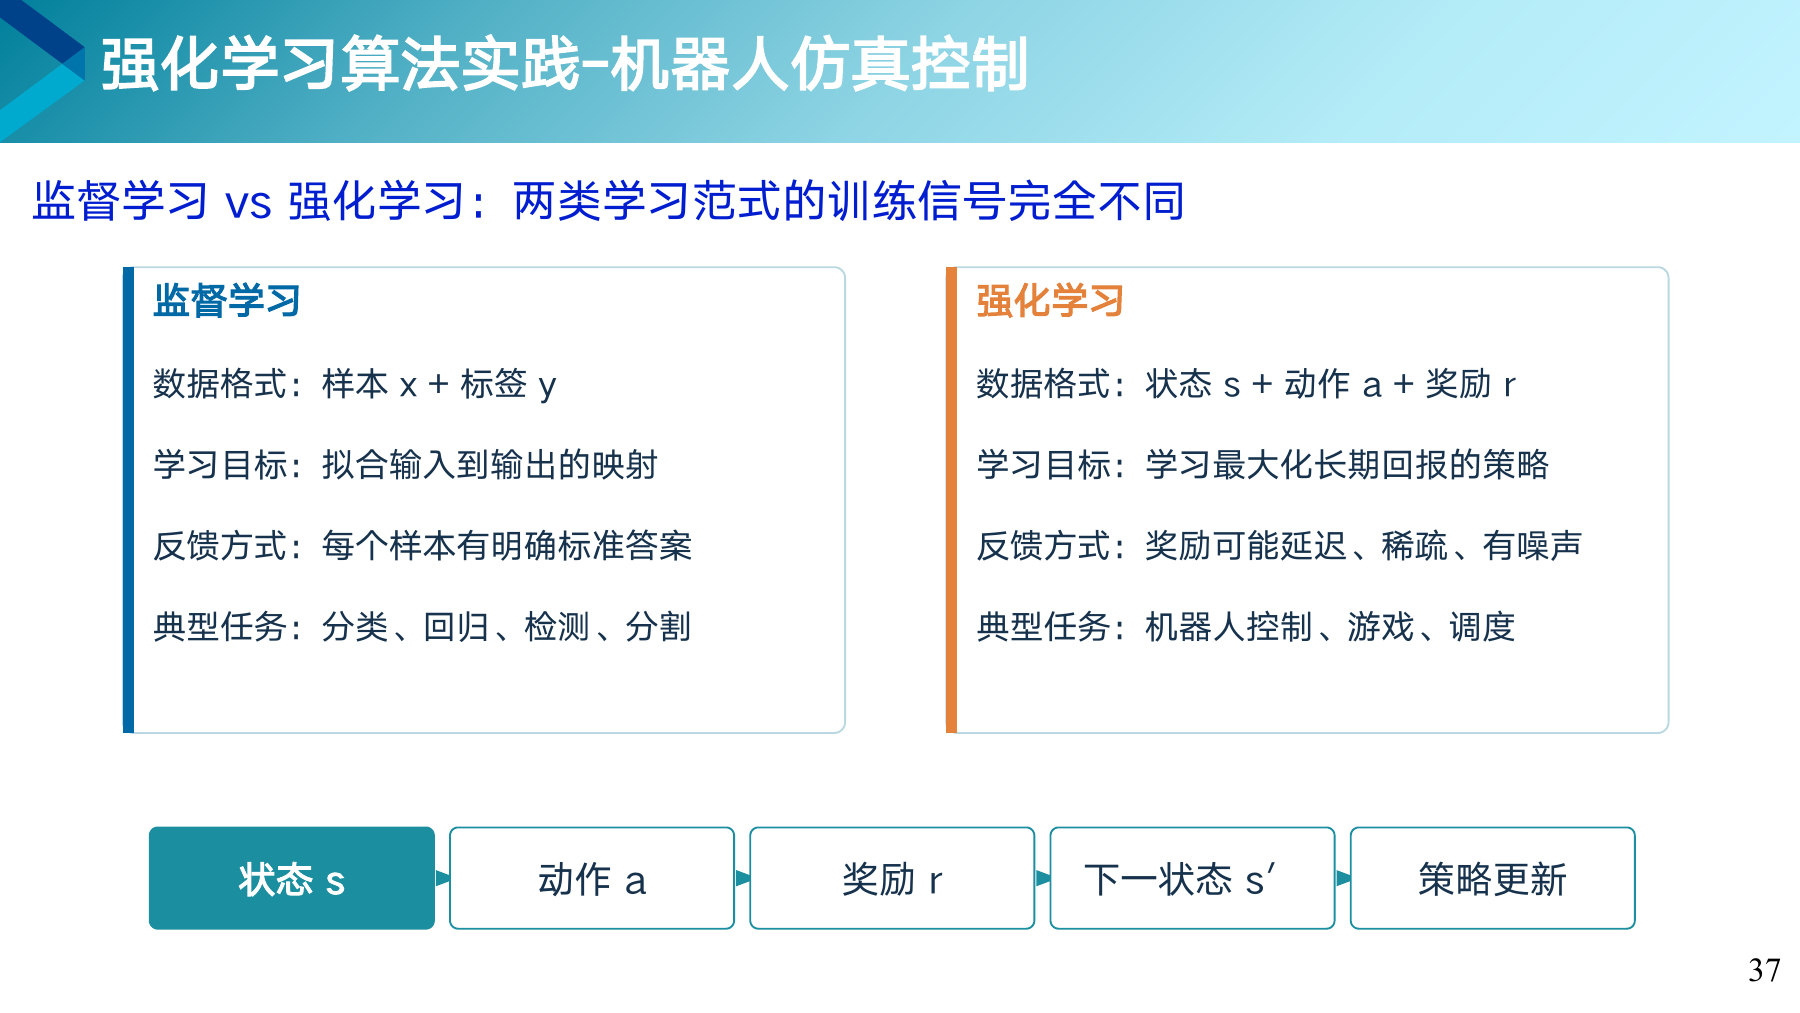
监督学习照着答案学,强化学习靠奖励自己摸索。
第 37 页课件

重 点差在训练信号上

监督学习的每条数据都配着标准答案。强化学习只有奖励,奖励可能来得很晚、很少,还夹着噪声。图下方那条链,就是第 3 章讲过的那个循环。

关键术语

延迟奖励Delayed Reward
做完动作以后过了很久,才知道这一步是好是坏。
稀疏奖励Sparse Reward
大多数时候奖励都是 0,只有少数时刻才有。

打个比方

下一盘棋走两百步,最后才知道输赢,这是延迟。中间每一步都没有分数,只有终局一个结果,这是稀疏。到底哪一步走坏了,要自己慢慢琢磨。
38
第 7 章 · 第五节

Isaac Sim 仿真环境

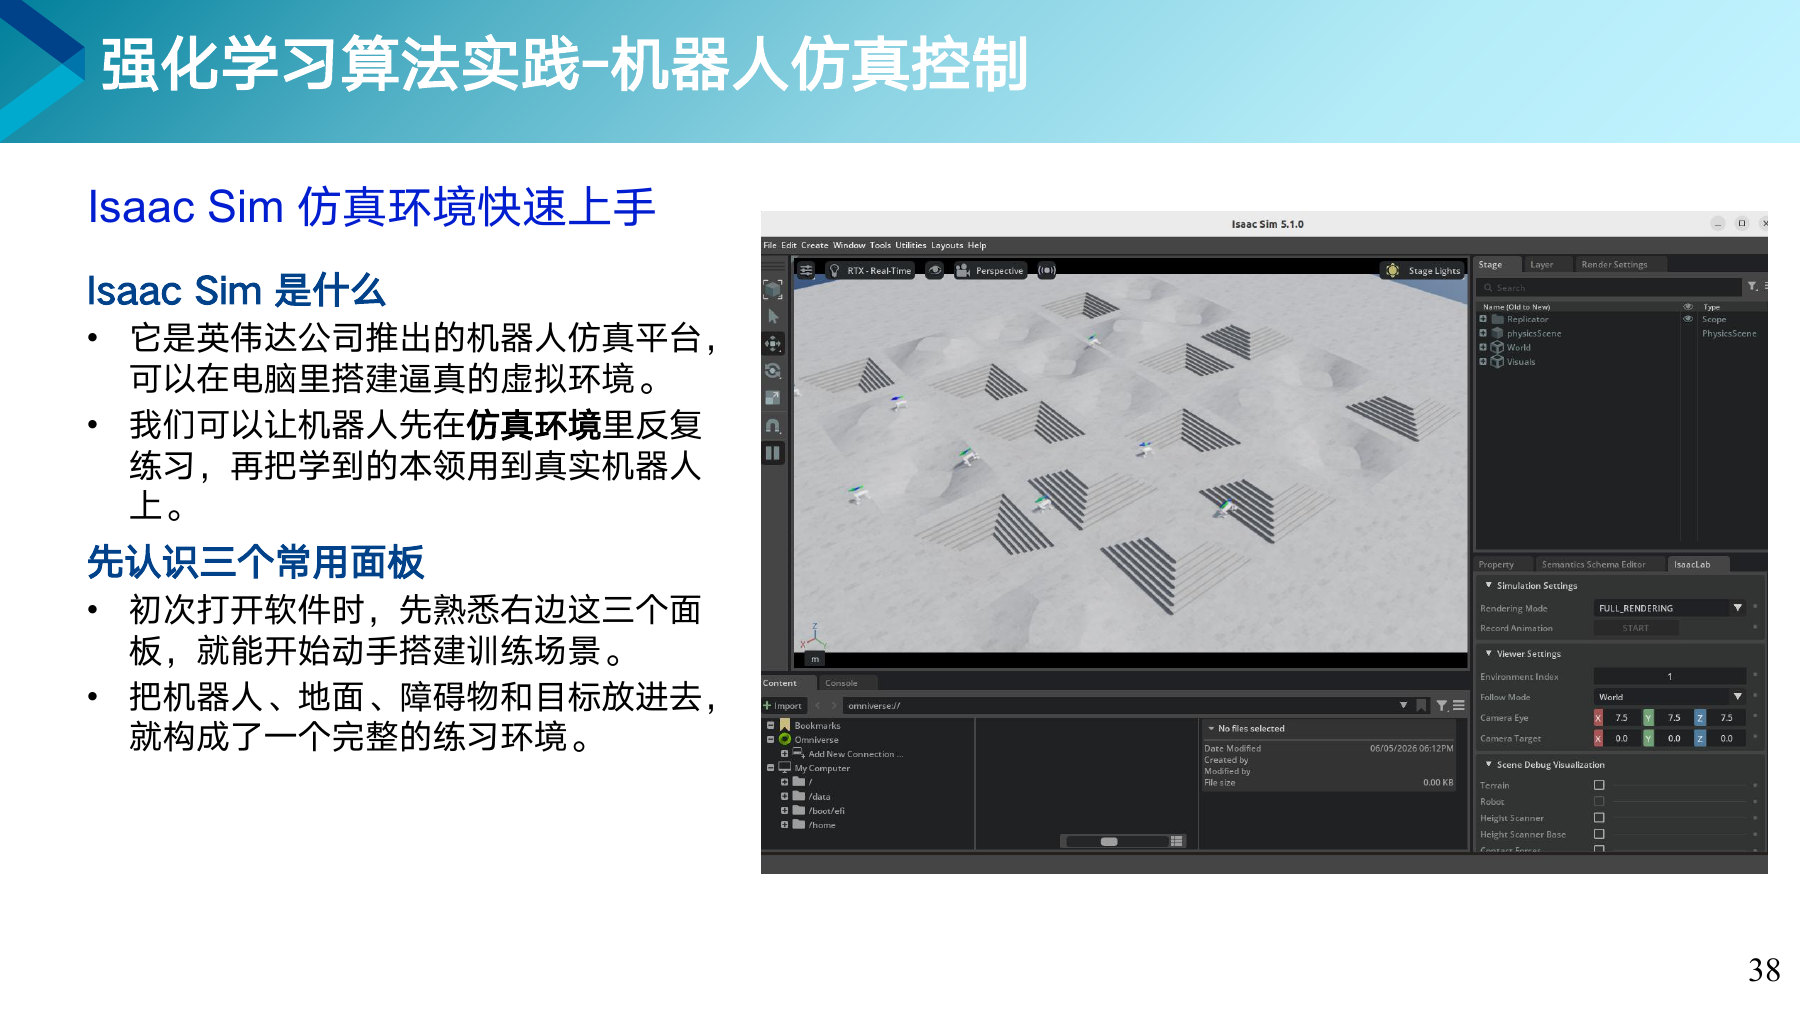
先在电脑里的虚拟世界练熟,再用到真机器人上。

第 38 页课件

关键术语

仿真Simulation
在电脑里按物理规律模拟出一个世界,机器人在里面动,和在真实世界里差不多。
Isaac SimNVIDIA Isaac Sim
英伟达的机器人仿真平台,能模拟重力、碰撞和摩擦。

重 点为什么先仿真

强化学习要试错成千上万次。真机器人摔一次可能就坏了,在仿真里摔一百万次只花电费,还能同时开很多个环境一起练。

知道更多从仿真到真实

仿真和真实世界总有差别,比如地面的摩擦、电机的反应。仿真里学会的本领搬到真机器人上,常常还要再调一番。

39
第 7 章 · 第五节

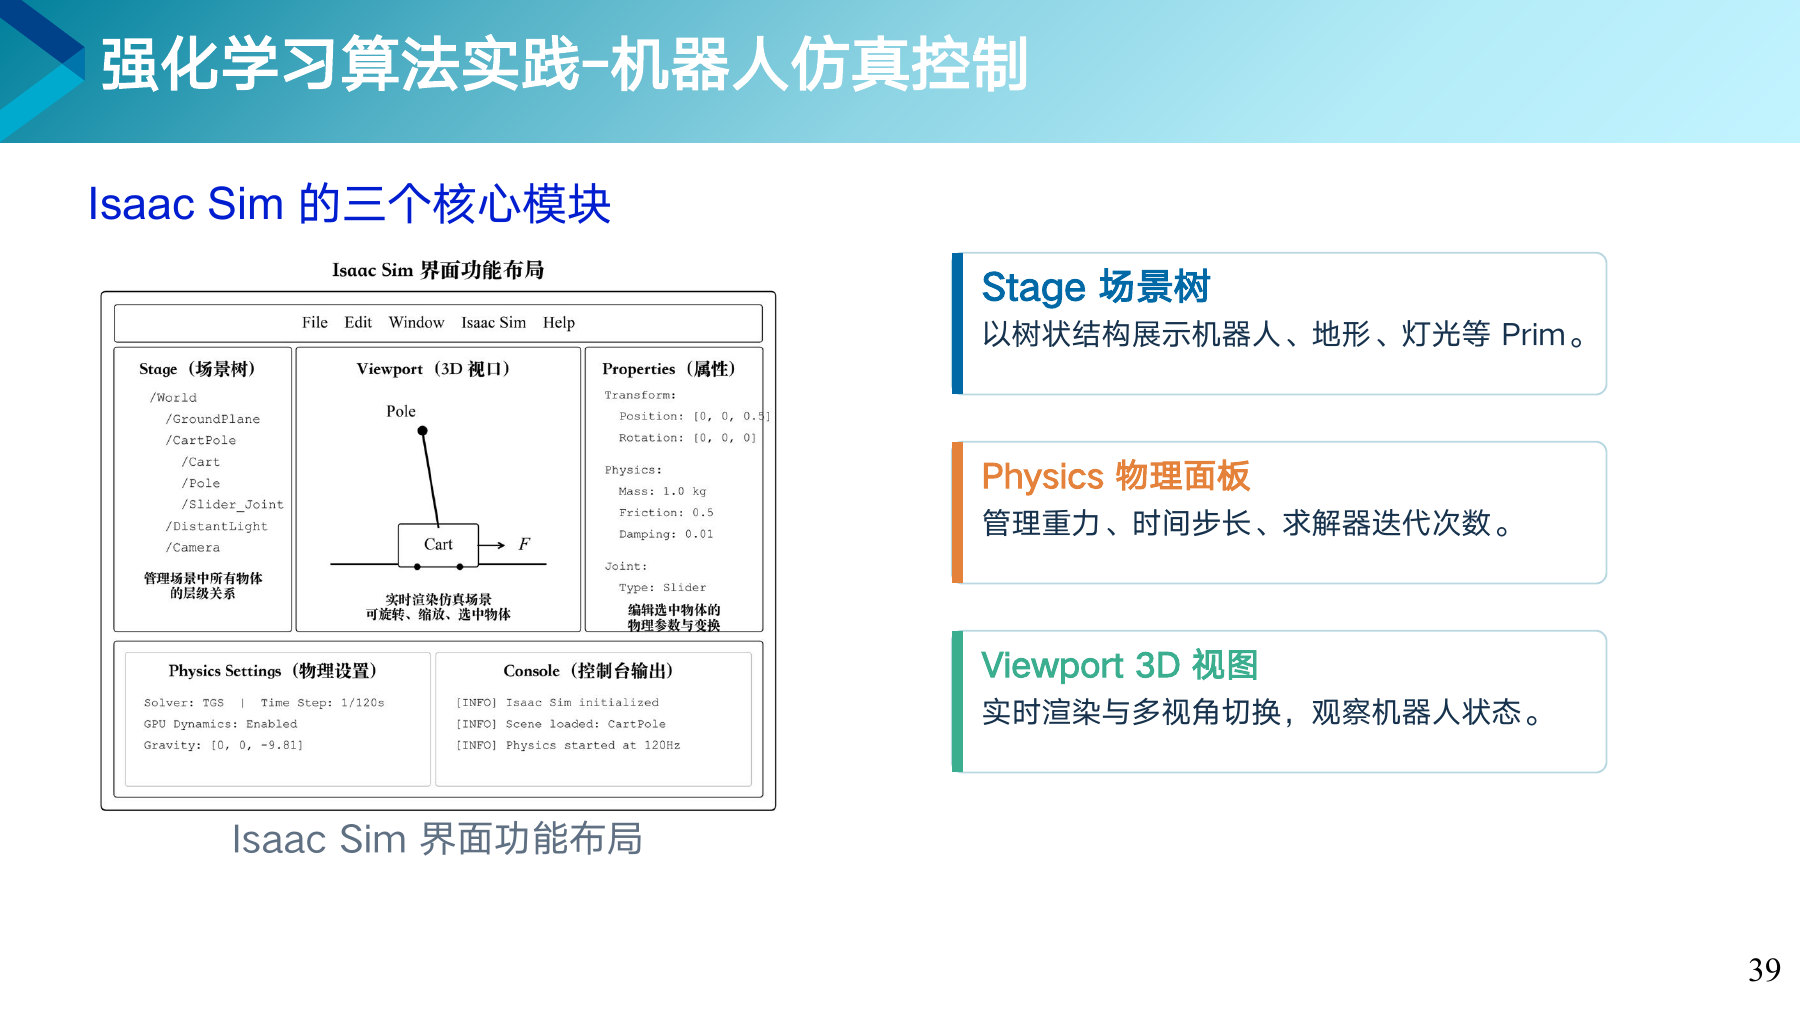
Isaac Sim 的三个主要面板

场景树管物体,物理面板管规则,视口负责看。

第 39 页课件

重 点左图的几块

左栏的场景树把地面、小车、杆一层层挂起来,要改哪个物体就点哪一支。中间的视口实时画出小车和杆。右栏是选中物体的属性,比如质量 1 千克。

知道更多时间步长

物理设置里的时间步长是 1/120 秒,仿真每算一步,世界就往前走这么久。步长太大,物体会穿墙乱跳,太小又算得很慢。

随堂练习

仿真里的重力、时间步长这些规则,在哪个面板里设置?

  1. 场景树 Stage
  2. 物理面板 Physics
  3. 视口 Viewport
  4. 控制台 Console
查看答案
答案 B。物理面板管重力、时间步长这些规则。场景树管有哪些物体,视口负责把画面画出来。
40
第 7 章 · 第五节

Gym 风格的环境接口

环境只要会“重新开始”和“走一步”,算法就能接上。

第 40 页 CartBalanceEnv 这段程序做了什么

算法和环境之间,只靠两个方法打交道

学习算法PPO、SAC 等环境仿真里的小车reset() 重新开始一局交回第一次观测(8 个数)step(动作) 交出左右轮速交回新观测、奖励、结束没有
  1. 开场准备 启动仿真,说明观测是 8 个数,动作是 2 个在 −1 到 1 之间的数。
  2. reset() 把小车摆回起点,交出第一次观测。每一局开头调用一次。
  3. step(动作) 把左右轮速交给仿真,往前推进一个时间步,交回新观测、这一步的奖励和这一局是否结束。
原课件第 41 页是同一段程序加上逐行注释,内容已经并入上面三步。

关键术语

Gym 接口Gym API
强化学习环境的一种通用写法,OpenAI 在 2016 年推出,现在由 Gymnasium 项目继续维护。
观测Observation
环境交给智能体的那几个数,也就是智能体眼里的状态。

重 点统一接口的好处

只要环境按这个规矩写好 reset 和 step,PPO、SAC 或者别的算法都能直接接上去训练,不用为每个环境重写算法。实验二的倒立摆,也是这样一个环境。

42
第 7 章 · 第五节

环境接口规范

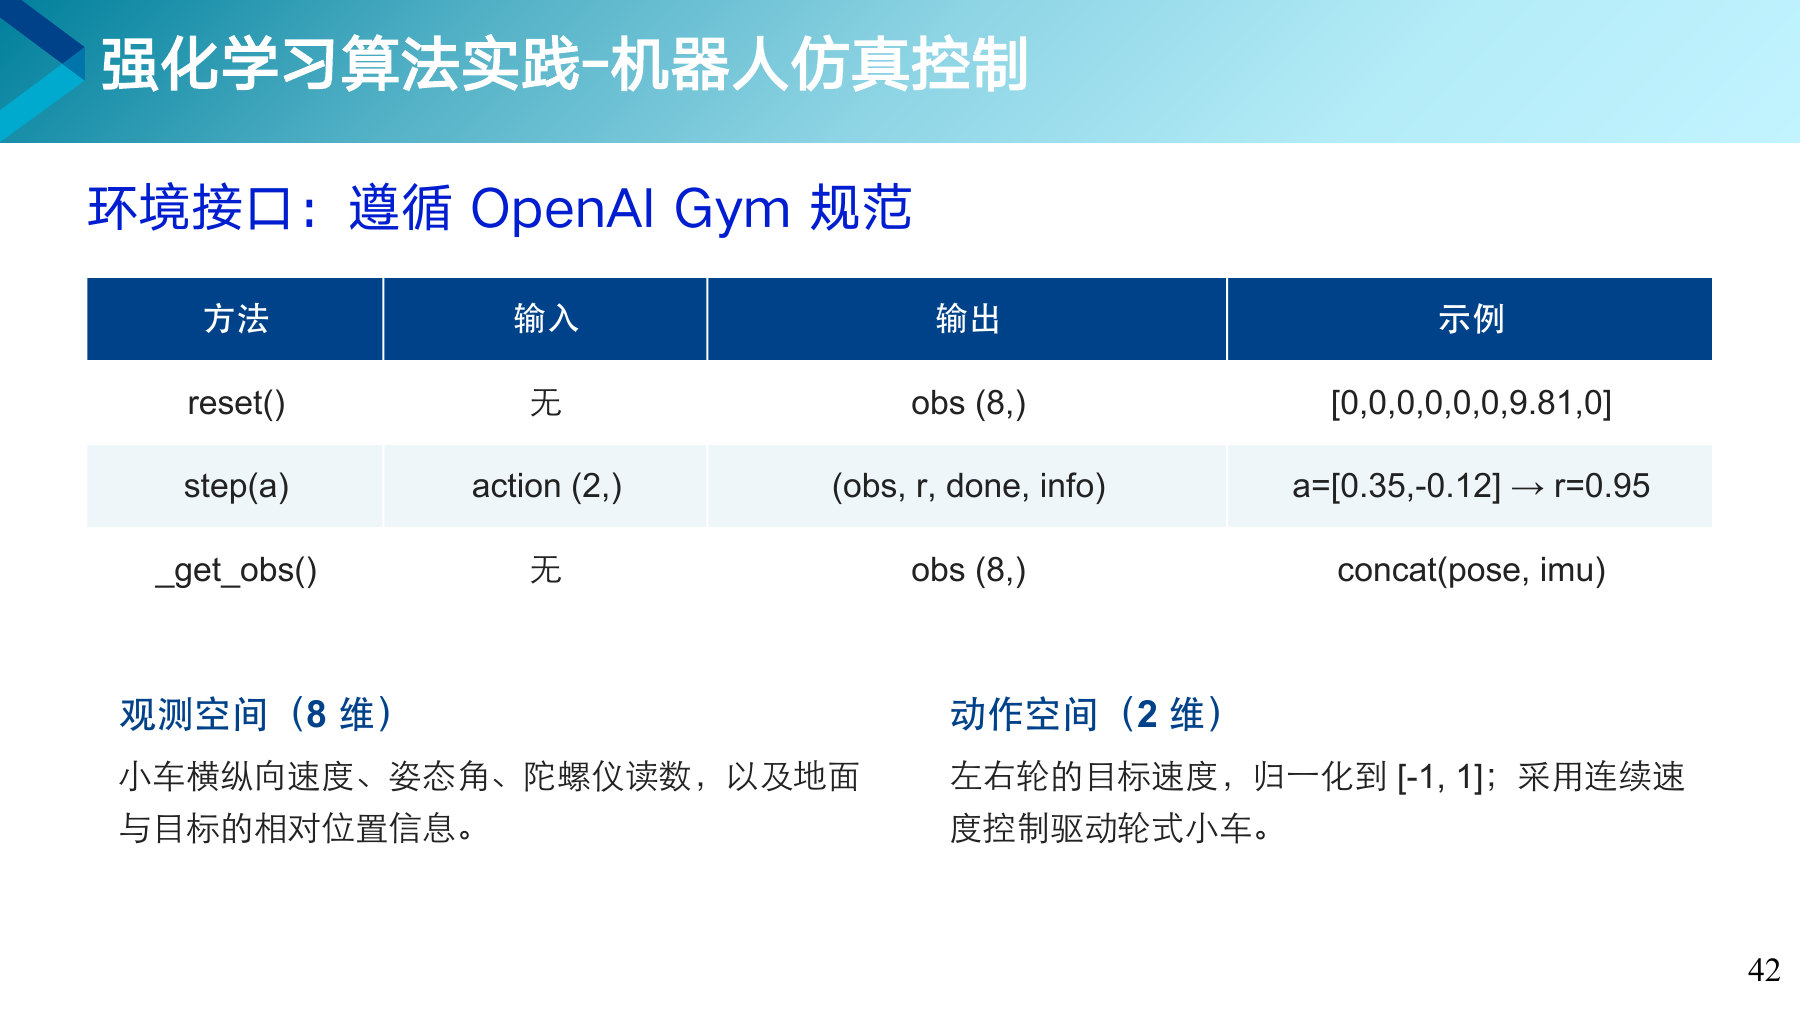
一张表写清每个方法要什么、交回什么。

第 42 页课件

重 点看示例那一列

reset 交回的第 7 个数是 9.81,那是静止时加速度计测到的重力。step 收到 [0.35, −0.12],左轮往前、右轮往后,小车边往前边向右转,这一步得到奖励 0.95。

关键术语

IMUInertial Measurement Unit
惯性测量单元,测加速度和转动快慢的小传感器,手机里也有。

随堂练习

调用 step 时,智能体要交给环境什么?

  1. 8 个数的观测
  2. 2 个数的动作
  3. 一个奖励值
  4. 什么都不用给
查看答案
答案 B。step 的输入是动作,这里是左右两个轮速。观测和奖励是环境交回来的东西。不需要输入的是 reset。
43
第 7 章 · 第五节

PPO:边试边改,每次改一点

先试一段、打个分,再小步改进策略,一轮轮循环。

第 43 页 PPO 在做什么

一个运动员,一个教练

试一段让小车在仿真里跑一段,
记下每一步
→
打分教练判断每个动作
比平常好还是差
→
小步改好动作多做,差动作少做,
每次不许改太多
Actor 运动员

看到眼前的局面,决定下一步做什么动作。

Critic 教练

不上场,只估计眼前这个局面能拿多少分。

适合什么任务 仿真里可以大量试错的任务。它训练稳定、好调,动作是几个选项或者是连续的数都能用,常被当成第一个尝试的算法。

关键术语

PPOProximal Policy Optimization
近端策略优化,OpenAI 在 2017 年提出。“近端”指每次只在原来的策略附近小改。

打个比方

学投篮时,教练发现你手腕太僵,只让你每次放松一点。要是一下子把整套投篮姿势推倒重来,原来会的也可能全乱套。PPO 每次只许策略改一点,防的也是这种情况。

知道更多它也用在大模型上

训练聊天大模型时,常先让模型回答问题,再按人的评价打分,用 PPO 这类算法朝得分高的方向调整。第 3 章讲深度强化学习时提到过。

44
第 7 章 · 第五节

SAC:把经历存起来反复用

每一步经历都存进经验池,随机抽出来反复学。

第 44 页 SAC 在做什么

一边拿高分,一边保持好奇

走一步记下局面、动作、
奖励、新局面
→
存进经验池大量经历
都存着
→
随机抽一批学旧的经历
也能反复用
  • 两个教练取保守分 两个评分网络各打一次分,取较低的那个,防止越估越高。
  • 保持好奇 除了奖励,还鼓励动作别太单一,多试试别的做法。
适合什么任务 动作是连续的数(轮速、关节角度),每试一次又很贵的任务,比如真实的机器人。一条经历能反复学很多次,试错的次数就省下来了。

关键术语

SACSoft Actor-Critic
常译作柔性演员-评论家算法,2018 年由加州大学伯克利分校的研究者提出。
经验回放Experience Replay
把交互记录存起来,训练时随机抽取,旧数据可以反复用。

打个比方

篮球队每场比赛都录像,赛后从录像里挑几段反复看、反复琢磨。比赛只打一次,录像却能看很多遍。经验池就是这盘录像。

知道更多实验二里也有

实验二里的 DQN 同样用了经验回放:把每一步的经历存起来,训练时随机抽出来反复学。

45
第 7 章 · 第五节

PPO 的训练程序

采集经验、算优势、小步更新,三步一轮。

第 45 页 这段程序做了哪几件事

每一轮做三件事,一共 1000 轮

  1. 采集经验 让小车跑一段,把每一步的观测、动作、奖励和教练的估分都存进缓冲区。
  2. 计算优势 回头看每个动作:实际拿到的分,比教练预估的多还是少。多了,说明这一步走得好。
  3. 小步更新 10 遍 用这一批经验把策略改 10 遍。某个动作被选中的可能性,变到原来的 0.8 倍以下或 1.2 倍以上,超出的部分不再算数,这样每次都改不了太多。
折扣因子取 0.99,奖励每晚一步拿到就打九九折。它和第 3 章走迷宫时取的 0.9 是同一个意思,只是更看重长远。

重 点同一批经验用 10 遍

和环境打交道很慢,每条经验都来之不易。收集一次反复学几遍,能省下很多试错。限定改动幅度,保证反复学也不会把策略带偏。

关键术语

优势Advantage
一个动作实际带来的回报比平均预期好多少,正数说明这一步走得好。
缓冲区Buffer
临时存放一批经验的地方,用完就清空,重新收集。

随堂练习

PPO 的缓冲区和 SAC 的经验池有什么不同?

  1. 两者一样
  2. PPO 用完就清空重收,SAC 长期存着反复抽
  3. PPO 不存数据
  4. SAC 用完就扔
查看答案
答案 B。PPO 每轮收集一批新经验,学完 10 遍就扔掉。SAC 把经历长期存在经验池里,随时抽出来学。
46
第 7 章 · 第五节

PPO 与 SAC 对比

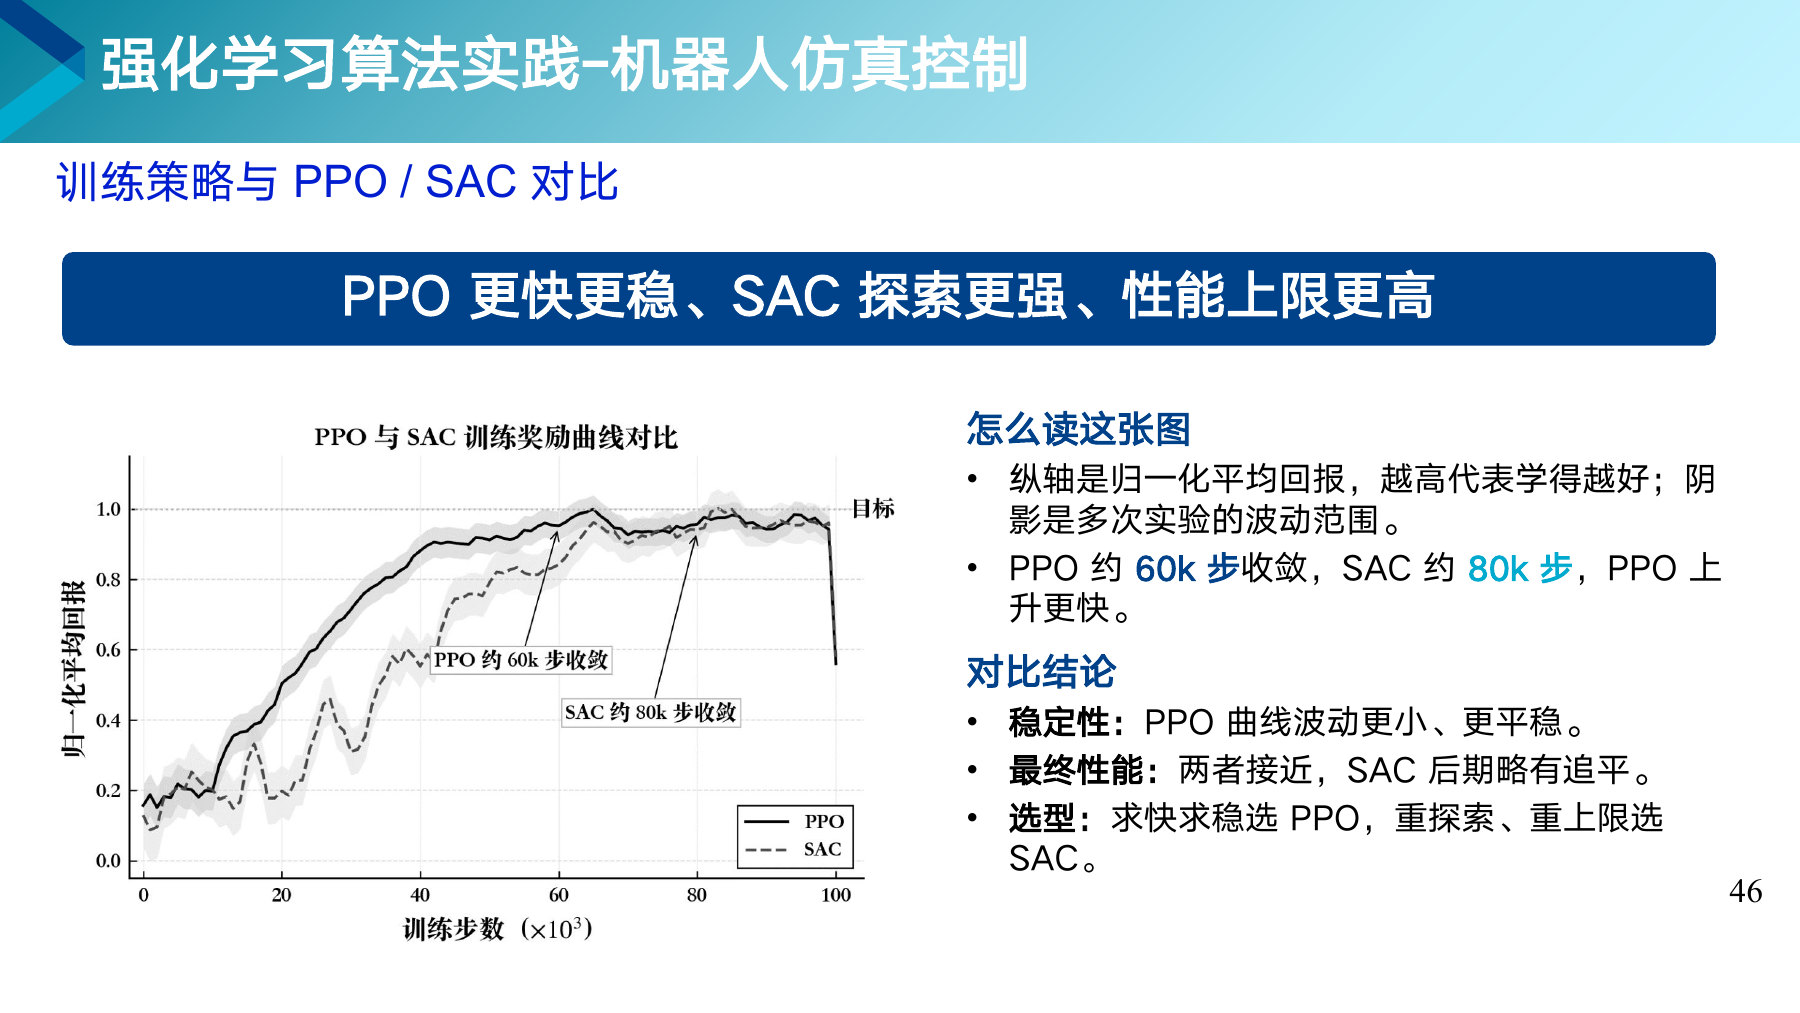
在这个任务上,PPO 上升更快更稳,SAC 后期追平。

第 46 页课件

重 点这张图怎么读

横轴是训练步数,单位是千步,纵轴是平均回报,1.0 是目标水平。实线 PPO 约 6 万步收敛,虚线 SAC 约 8 万步。阴影是多次实验的波动范围。最右端两条线一起陡降,是画图时留下的瑕疵,读图时不用管它。

知道更多换个任务,结论可能不同

这是小车平衡任务上的一次对比。能同时开很多个仿真环境时,PPO 往往又快又稳。真实机器人试一次很贵,能反复利用旧经历的 SAC 常更省试错次数。

随堂练习

一个算法的平均曲线很高,阴影却很宽,说明什么?

  1. 每次跑都一样好
  2. 每次跑出来的结果差别很大,不够稳定
  3. 训练步数不够
  4. 阴影越宽越好
查看答案
答案 B。阴影宽,说明同样的设置跑几次,结果时好时坏,做工程时不太让人放心。
47
第 7 章 · 第五节

奖励函数设计

奖励怎么给,机器人就学成什么样。

第 47 页 奖励函数:三项加起来

每一步的奖励 = 存活奖励 + 角度扣分 + 晃动扣分

  • 存活奖励 每撑住一步加 1 分。
  • 角度扣分 −5 × 倾角 × 倾角,倾角用弧度计,歪得越多扣得越狠。
  • 晃动扣分 −0.1 × 角速度 × 角速度,角速度按每秒转过几弧度计,晃得越快扣得越多。
局面存活角度扣分晃动扣分这一步的奖励
站得很稳:倾角 0.02(约 1°),角速度 0.11−0.002−0.0010.997
有点歪:倾角 0.2(约 11°),角速度 11−0.2−0.10.7
快要倒:倾角 0.6(约 34°),角速度 31−1.8−0.9−1.7
用平方,大问题会被重罚:倾角从 0.2 变成 0.4,角度扣分从 0.2 涨到 0.8,变成原来的四倍。机器人会先把大的倾斜纠正过来。

重 点奖励设错了,它会钻空子

只给存活奖励、不扣角度分,机器人可能学会歪着身子硬撑,只要不倒就一直拿分。奖励里写进了什么,它就追求什么,没写进去的一概不管。

关键术语

弧度Radian
另一种量角度的单位,1 弧度约等于 57 度。

随堂练习

按这个奖励函数的三项规则,倾角 0.4 弧度、角速度为 0 时,这一步的奖励是多少?

  1. 1
  2. 0.2
  3. −0.8
  4. 0.6
查看答案
答案 B。存活加 1,角度扣 5 × 0.4 × 0.4 = 0.8,晃动扣 0,合计 1 − 0.8 = 0.2。
48
第 7 章 · 第五节

训练监控指标

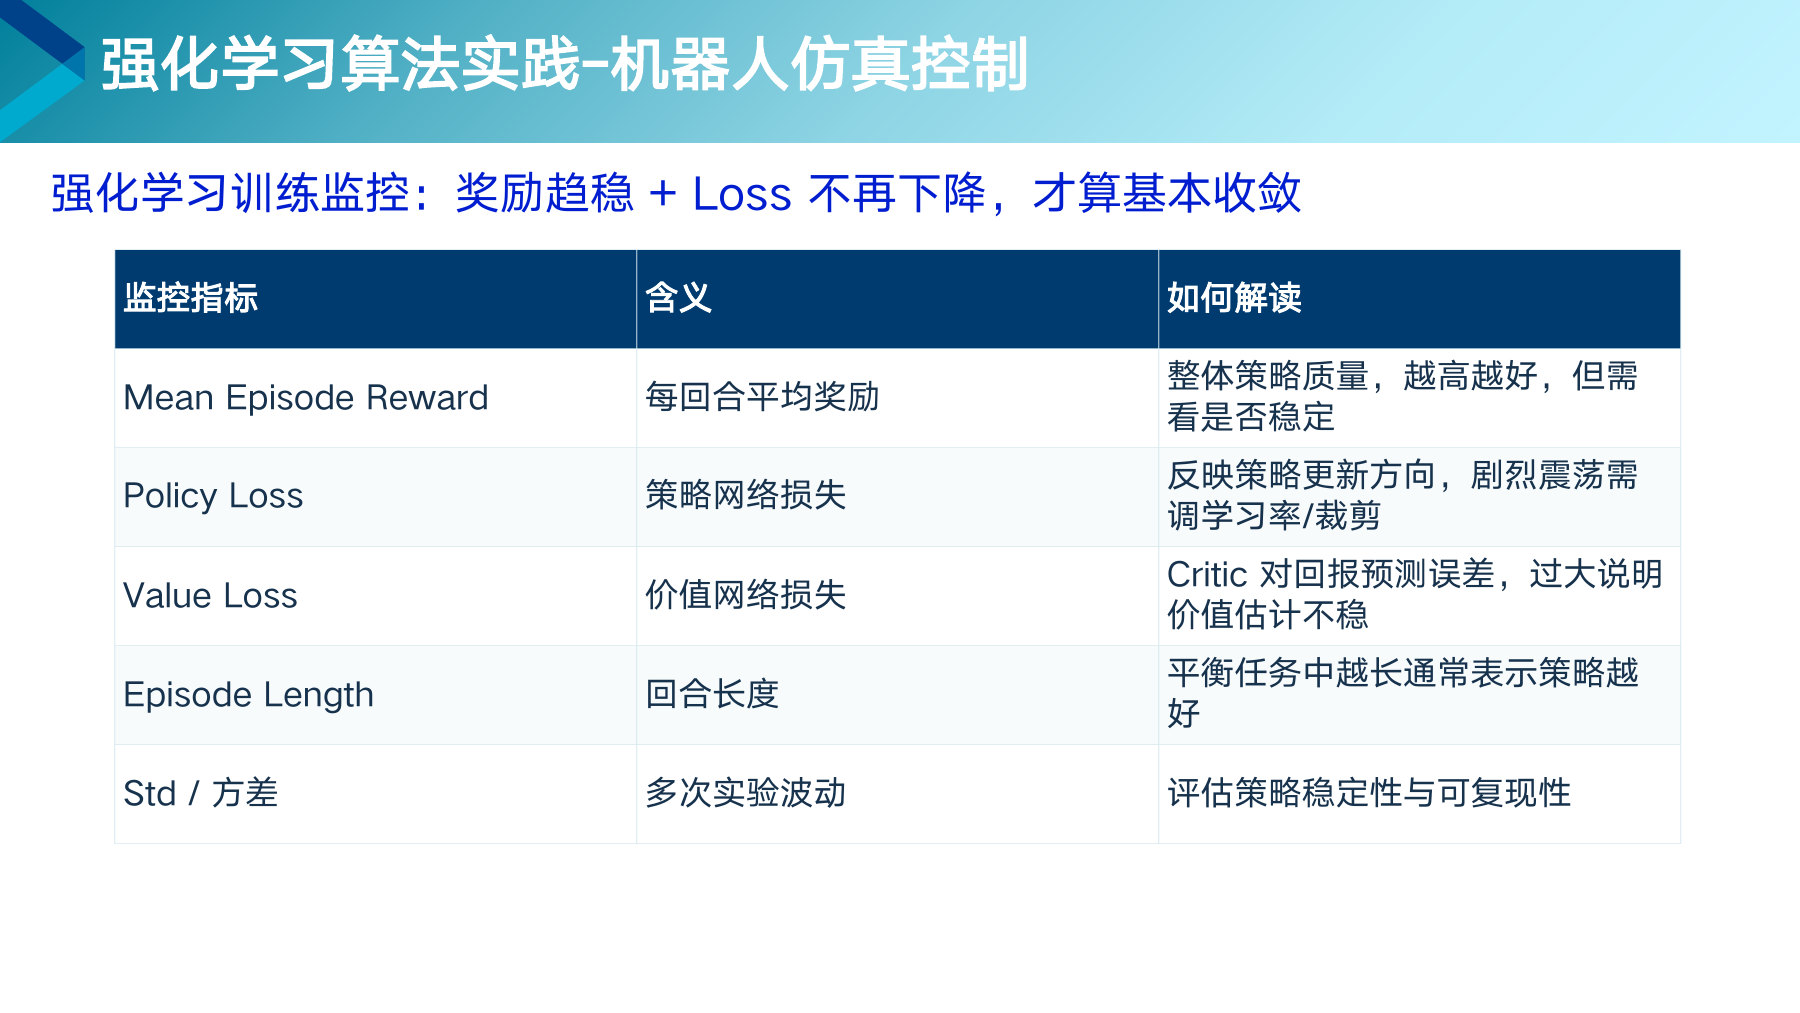
奖励趋稳、损失不再下降,才算基本练好。

第 48 页课件

关键术语

回合Episode
从开始到结束的一整局,第 3 章叫“幕”。
策略损失Policy Loss
训练运动员那部分网络时要压低的那个数。
价值损失Value Loss
教练的估分和实际回报之间的差距。

重 点几个指标一起看

奖励涨上去了,损失却还在剧烈抖动,说明策略还没稳住,随时可能掉下来。奖励平稳、损失不再下降,再加上几次实验的结果差不多,才能算练好了。

知道更多和第二节是一个道理

第二节看训练曲线时,要把损失曲线、验证指标和显卡利用率放在一起看。强化学习也一样,只盯一个数很容易被骗。

保山学院·人工智能教研室·曹鼎鼎