人工智能导论 第 7 章 · 第四节
课程 › 第 7 章 › 第四节 任务定义数据准备七个字段多步预测单变量与多变量DLinear序列分解训练五步验证与早停早停训练流水线
第 7 章 人工智能实践 · 第四节

深度学习实践

预测变压器油温,走一遍完整训练
本 节 知 识 点
  1. 25时间序列预测:任务定义
  2. 26数据准备与预处理
  3. 27ETT 数据的七个字段
  4. 28一口气报完,还是一步步推
  5. 29单变量与多变量
  6. 30DLinear 模型介绍
  7. 31序列分解与两个线性层
  8. 33深度学习训练的标准流程
  9. 34训练验证与可视化评估
  10. 35早停:不再进步就收手
  11. 36完整的训练流水线
25
第 7 章 · 第四节

时间序列预测:任务定义

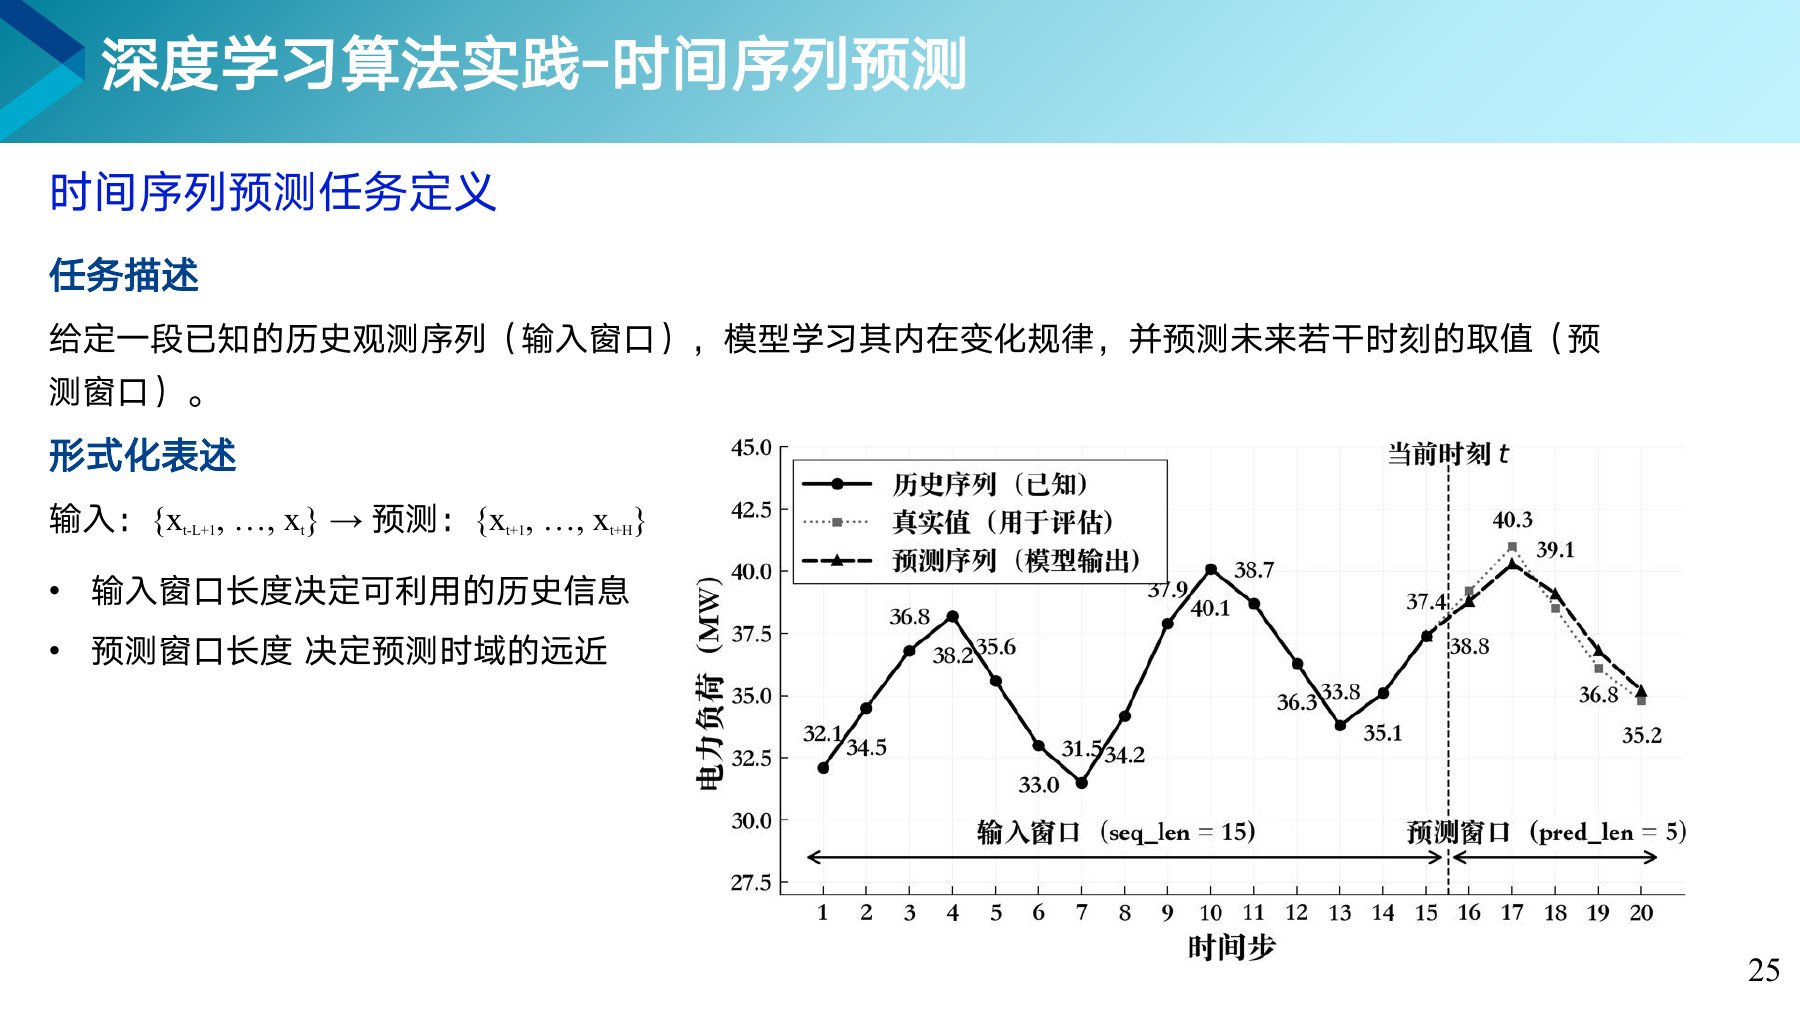
看一段历史,预测接下来几个时刻的值。
第 25 页课件

重 点两个窗口

竖虚线左边是输入窗口,图上是 15 个时间步,模型只能看这一段。右边是预测窗口,图上是 5 步,要猜出这 5 个数。两个窗口开多长,都要人事先定好。

打个比方

看了最近半个月每天的气温,猜接下来五天的气温。半个月是输入窗口,五天是预测窗口。

知道更多生活里到处是时间序列

明天的用电量、下周的销量、下个月的客流、未来一小时的车流,都是按时间排好的一串数,过去的规律对未来有参考价值。
26
第 7 章 · 第四节

数据准备与预处理

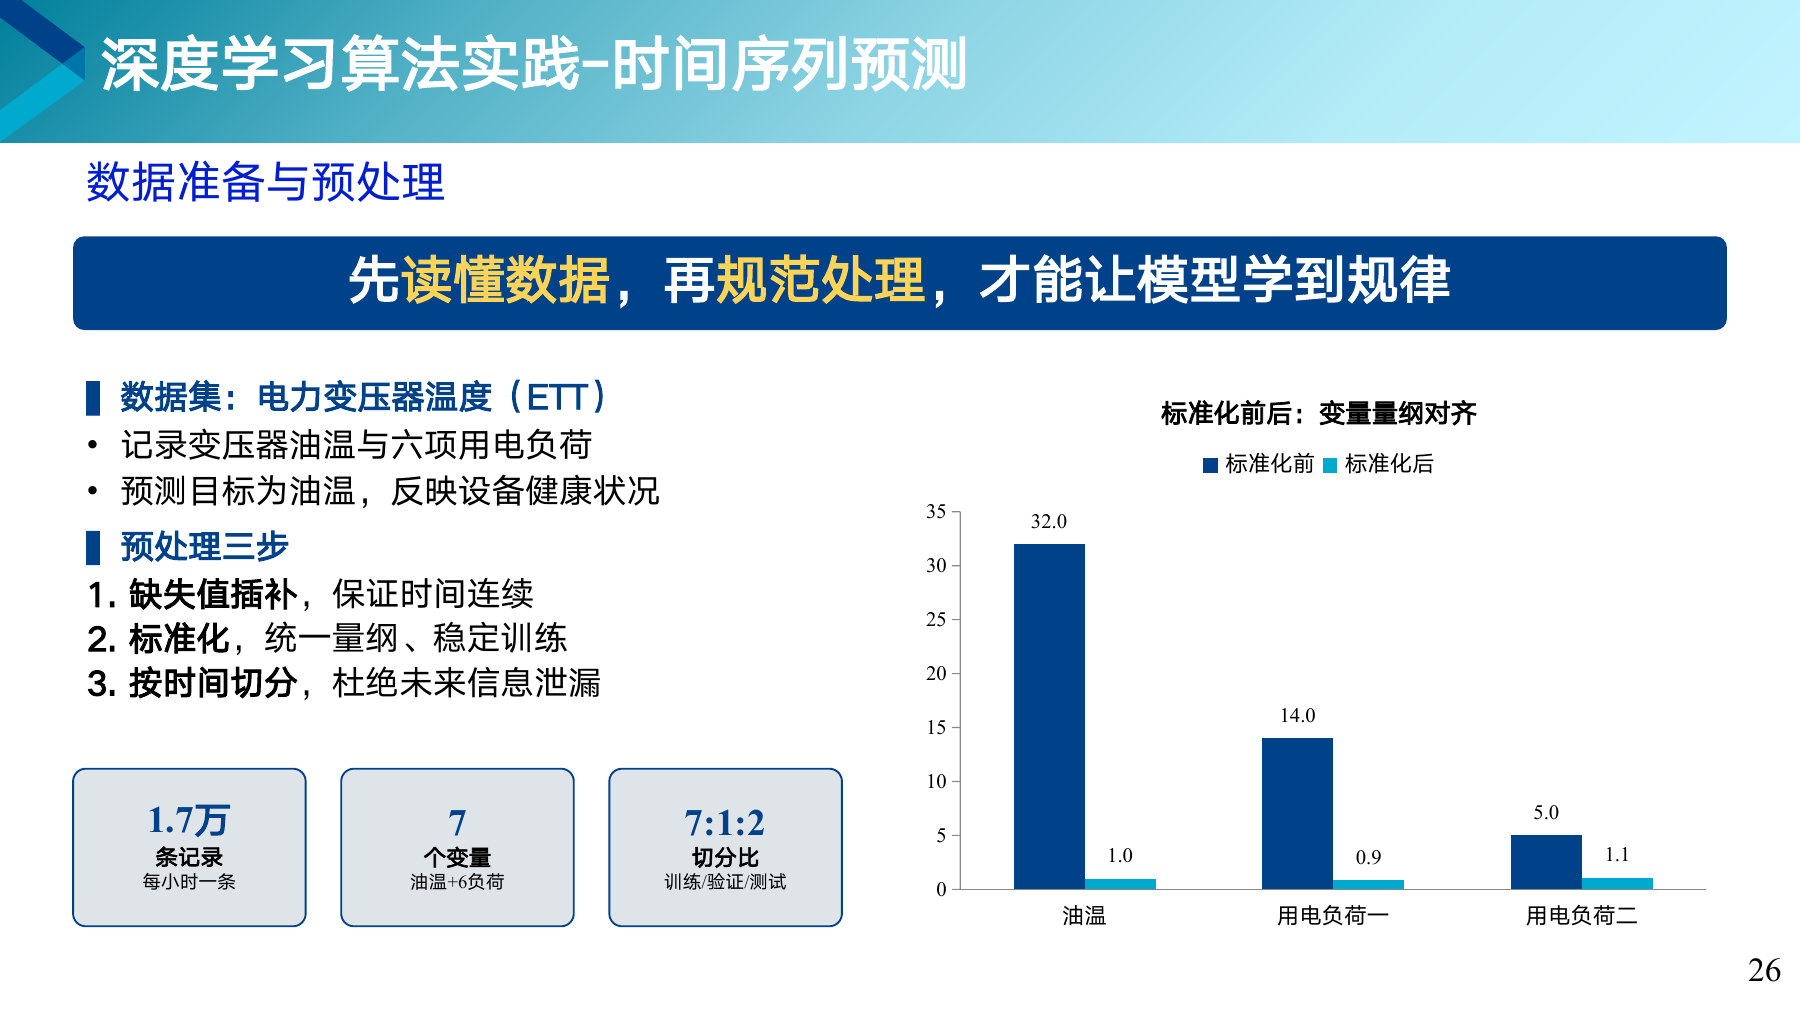
先读懂数据,再补缺、统一尺度、按时间切分。

第 26 页课件

关键术语

ETT 数据集Electricity Transformer Temperature
中国两个地区电力变压器两年的记录,每小时一条,常用来练习时间序列预测。
标准化Standardization
每个数减去这一列的平均值,再除以这一列的波动幅度。处理完,每一列的平均值是 0,波动幅度是 1。

打个比方

油温三十多度,负荷才几点几。不统一尺度,数值大的那一列就会压过别的列,像把用米和用毫米记的数放在一起比。

重 点一个容易出错的细节

标准化用的平均值和波动幅度,只能从训练那一份里算,再套到验证和测试上,否则就是第一节讲的全量统计泄露。

27
第 7 章 · 第四节

ETT 数据的七个字段

六项负荷加上油温,一共七列,油温是预测目标。

第 27 页 字段说明与缺失值插补

每小时记下七个数

字段意思第一条记录的值
HUFL高压有功负荷5.827
HULL高压无功负荷2.009
MUFL中压有功负荷1.599
MULL中压无功负荷0.462
LUFL低压有功负荷4.203
LULL低压无功负荷1.340
OT油温(预测目标)30.531
时刻04:0005:0006:00
记录的油温30.46没记下32.78
线性插值补上30.4631.6232.78
上表是 2016 年 7 月 1 日 0 点的第一条记录。下表取 7 月 5 日凌晨的三条记录,假设 05:00 那一条没记下来。它的真实油温是 31.38,补出来的数只差 0.24 度,油温变化平缓,这样的误差可以接受。

关键术语

有功负荷Useful Load
被用电设备消耗掉、做了功的那部分电。
无功负荷Useless Load
在线路和设备之间来回倒腾、没有对外做功的那部分电。
线性插值Linear Interpolation
缺了中间一个数,就在前后两个数之间连一条直线,取线上的值补上。

重 点三份按时间切

数据按时间先后切成 7:1:2,前七成训练,中间一成验证,最后两成测试。时间序列不能随机打乱,打乱了就等于拿未来去预测过去。

28
第 7 章 · 第四节

一口气报完,还是一步步推

一次报出整段未来,误差不会一步步累积。

第 28 页 多步预测的两种策略

要预测未来 96 个小时

直接预测历史 96 小时模型未来 96 小时,一次全部给出滚动预测历史 + 已猜的模型下一小时把猜的当成已知,再猜下一小时重复 96 次误差一路带下去
直接预测(推荐)

每个数都直接从真实的历史算出来,误差不会传下去,一次算完,速度也快。

滚动预测

符合一步接一步的直觉,但每一步的误差都会带进下一步,越往后越不准。

预测得越远,两种策略的差距越明显。长序列预测一般用直接预测。

打个比方

传话游戏里,第一个人听错一个字,第二个人在错的基础上再听错一点,传到第十个人,意思已经面目全非。滚动预测每一步都把上一步的猜测当真,越往后越不准。

重 点直接预测的代价

一次报出 96 个数时,模型不太顾得上这 96 个数彼此之间连不连贯。好在长序列预测里,误差不累积带来的好处通常更大。

随堂练习

滚动预测为什么越往后越不准?

  1. 模型越算越慢
  2. 每步都把上一步的预测当真,误差累积
  3. 数据越往后越少
  4. 显存不够
查看答案
答案 B。第 2 步用的是第 1 步的猜测值,第 3 步又用第 2 步的,误差一路带下去。直接预测没有这个问题。
29
第 7 章 · 第四节

单变量与多变量

一批数据的形状是三个数:几段、多长、几列。

第 29 页 张量的形状

(32, 96, 7) 这三个数各是什么

六项负荷油温第 1 小时第 2 小时第 3 小时⋮第 95 小时第 96 小时一段样本:96 行 × 7 列一共叠了 32 段(32, 96, 7)32:一批有 32 段96:每段 96 个小时7:每小时 7 个数只留油温那一列就变成 (32, 96, 1)
模式用哪些列输入形状输出形状
单变量只用油温(32, 96, 1)(32, 96, 1)
多变量七列全用(32, 96, 7)(32, 96, 7)
输出形状和输入一样:用过去 96 个小时的数,预测未来 96 个小时的数。

关键术语

张量Tensor
按几个方向排好的一大块数。表格有行和列两个方向,这里多了“第几段”,是三个方向。
通道Channel
每个时刻记了几个变量。单变量是 1,多变量是 7。

重 点多用几列不一定更好

多变量给了模型更多线索,也带进了更多噪声和参数。用电负荷对预测油温有没有帮助,要在验证集上实际比一比才知道。

知道更多程序里的三个字母

时间序列的程序里常把这三个数写成 B、L、C,分别是批大小(Batch)、序列长度(Length)和通道数(Channel)。读程序时看到这三个字母,就知道说的是哪一个数。

30
第 7 章 · 第四节

DLinear 模型介绍

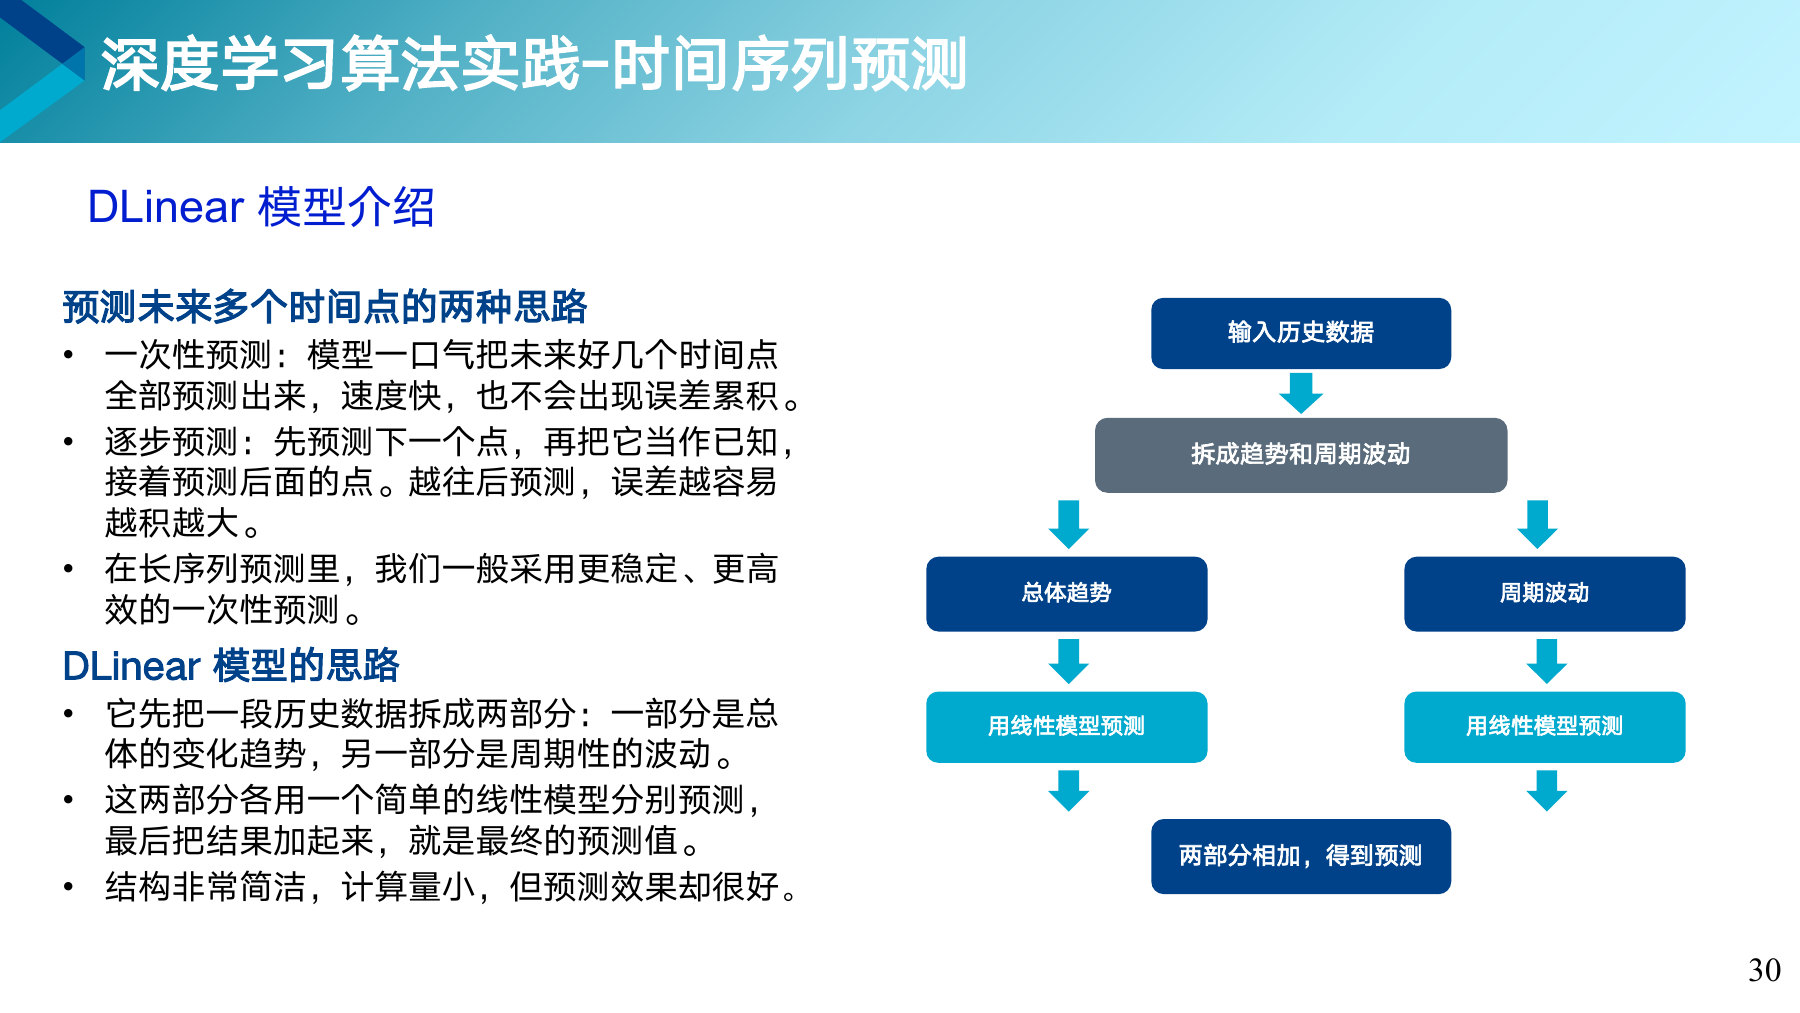
拆成趋势和周期两部分,各用线性模型预测再相加。

第 30 页课件

重 点右边这张流程图

历史数据先拆成两部分:总体趋势和周期波动。两部分各交给一个线性模型去预测,最后把两个预测加起来。线性模型给每个输入配一个权重再加起来,和逻辑回归里加权求和的那一步一样。

打个比方

一年的气温,可以看成一条慢慢升上去又降下来的季节走势,加上每天白天热、夜里凉的起伏。分开来看,两部分都比原来那条线好猜。

知道更多一个很简单的模型

DLinear 出自 2023 年发表的一篇论文。这个只做加权求和的小模型,在好几个长序列预测数据集上,效果超过了当时不少复杂得多的模型。

31
第 7 章 · 第四节

序列分解与两个线性层

移动平均提出趋势,原序列减去趋势就是周期波动。

第 31 页 DLinear 的程序做了哪几件事

原序列 = 趋势 + 周期波动

原序列趋势周期波动=+每点取前后 25 小时的平均原序列减去趋势4 天、96 个小时
  1. 算趋势 每个时刻取它前后共 25 个小时的平均值,曲线被抹平,剩下大方向。
  2. 算周期 原序列减去趋势,剩下的就是一天之内来回起伏的那部分。
  3. 各自预测 两部分各接一个线性层,拿过去 96 个数加权求和,算出未来 96 个数。
  4. 相加输出 两个预测加起来,就是最后的结果。
原课件第 32 页是同一段程序加上逐行注释,内容已经并入上面四步。

关键术语

移动平均Moving Average
让一个固定宽度的窗口沿着曲线滑动,每到一处就取窗口里的平均值。
线性层Linear Layer
给每个输入配一个权重,加权求和得到输出。要几个输出,就配几组权重。

打个比方

股票软件上的“均线”就是移动平均。天天上下跳的股价,取 20 天平均画出来,就变成一条平滑的线,看得出是在涨还是在跌。

知道更多一个稳当的起点

线性层的权重一开始都设成九十六分之一,相当于先拿历史的平均值当预测。从这个稳当的起点出发,开头几轮不会报出奇怪的数。

33
第 7 章 · 第四节

深度学习训练的标准流程

清零、前向、算损失、反向传播、更新,一批一批地转。

第 33 页 深度学习训练的标准流程

每一批数据都走这五步

  1. 梯度清零 把上一批留下的调整量清掉,免得和这一批的混在一起。
  2. 前向计算 把这一批 32 段历史送进模型,得到预测。
  3. 计算损失 用均方误差 MSE 算预测和真实值差了多少。
  4. 反向传播 算出每个参数往哪个方向调、调多少,能让损失变小。
  5. 参数更新 优化器 Adam 按算出的方向把参数挪一小步。
这就是第 2 章的梯度下降:看看脚下哪边低,往那边迈一小步。整个训练,就是把这五步重复成千上万次。

打个比方

做练习时先擦干净草稿纸,再做题、对答案、找错在哪一步、改正。擦草稿纸就是梯度清零,漏了这一步,上一题的草稿会搅乱这一题。

关键术语

反向传播Backpropagation
从损失出发往回算,求出每个参数对损失有多大影响。
AdamAdaptive Moment Estimation
一种常用的优化器,会给每个参数自动调整步子大小,通常比普通梯度下降收敛得快。

随堂练习

五步里,哪一步改动了模型的参数?

  1. 梯度清零
  2. 前向计算
  3. 计算损失
  4. 参数更新
查看答案
答案 D。前三步只是在算,反向传播算出该怎么调,到了参数更新这一步,参数才被挪动。
34
第 7 章 · 第四节

训练验证与可视化评估

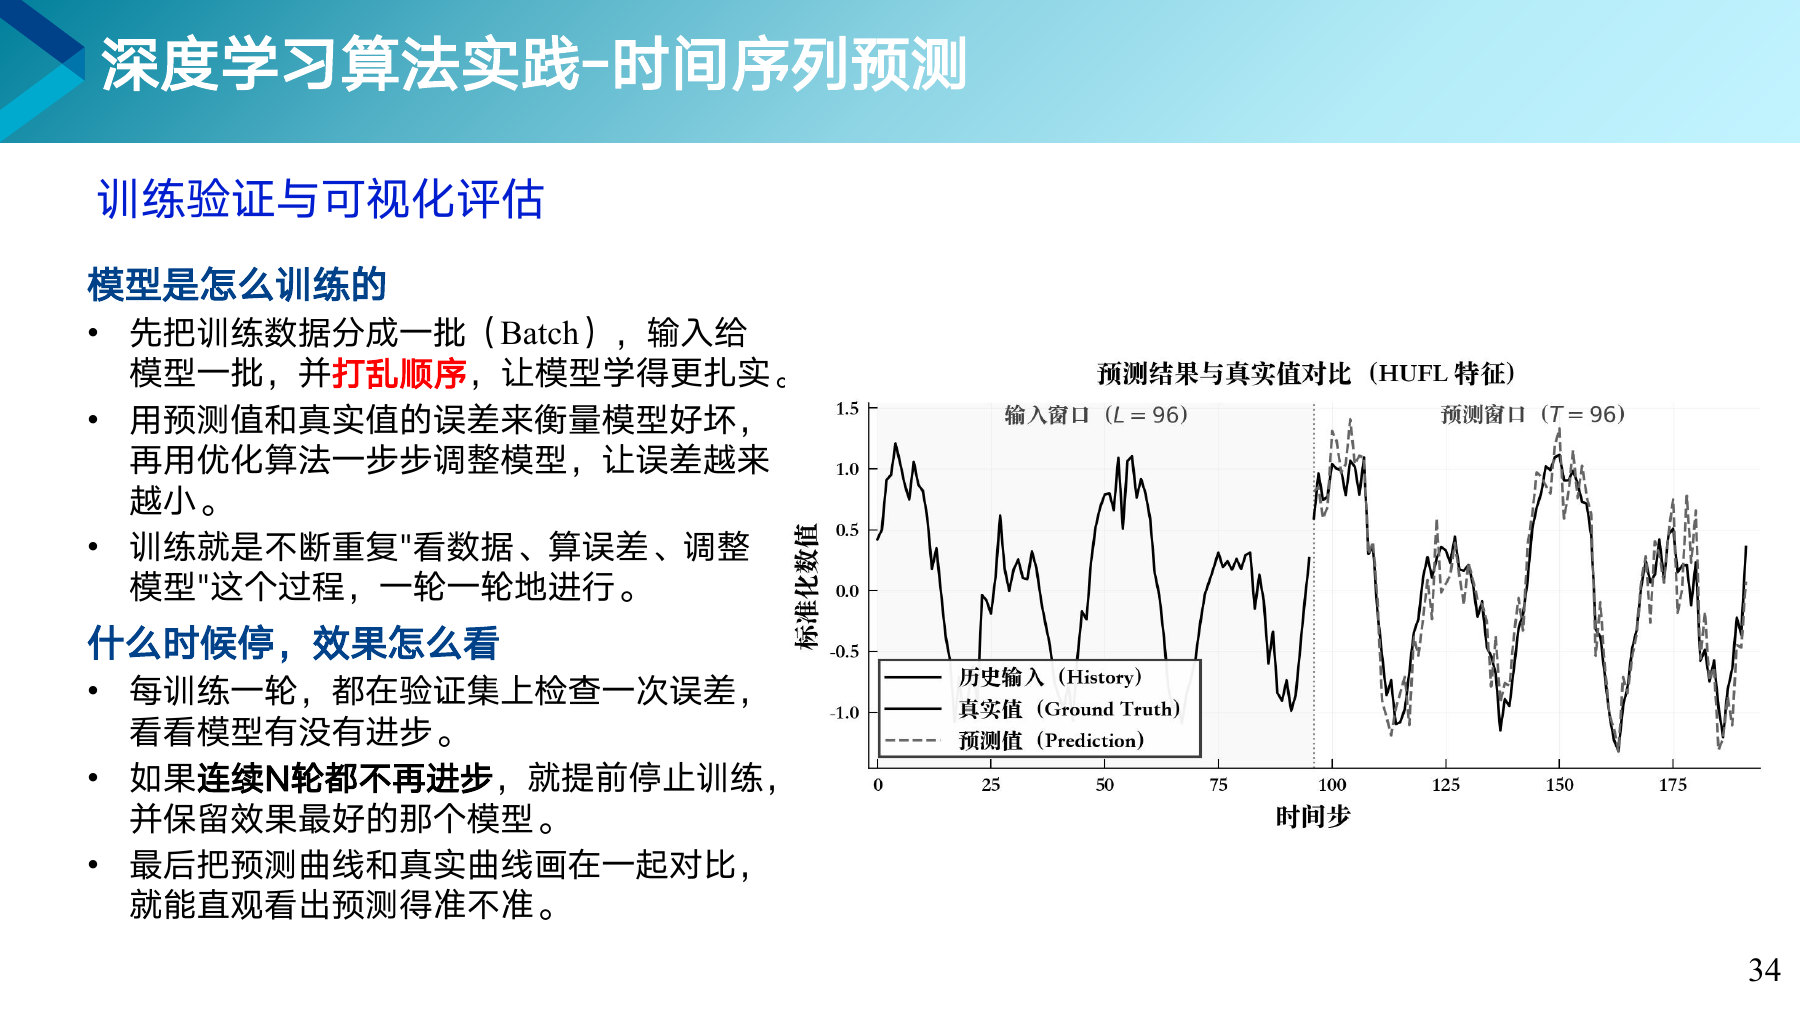
每练一轮就在验证集上考一次,考不好了就停。

第 34 页课件

重 点右图怎么读

竖虚线左边是模型看到的 96 步历史,右边是它预测的 96 步。实线是真实值,虚线是预测值,两条线贴得越紧,预测越准。这张图画的是其中一列负荷 HUFL。

知道更多为什么要打乱顺序

每一轮开始前,把训练样本的先后顺序打乱,再分批送进去。要是总按时间先后喂,连着好几批都是夏天的样本,参数先被拉向夏天,再被拉向冬天,来回摇摆。打乱的是各段样本的先后,每一段内部的时间顺序不动。

35
第 7 章 · 第四节

早停:不再进步就收手

验证误差连续几轮不降就停下,留最好的那一版。

第 35 页 早停机制

验证误差先降后升,最低点那一轮最好

误差训练轮数123456789第 6 轮最低把这一版存下来之后连续 3 轮没有更低,第 9 轮结束后停下验证误差训练误差
  • 每一轮 在验证集上算一次误差,比历史最好还低,就把这一版模型存下来。
  • 耐心值 连续 3 轮都没有刷新最好成绩,就停止训练。
  • 收尾 测试时读回存下来的最好那一版,停下时手里的那一版已经练过了头。

关键术语

早停Early Stopping
验证集上的成绩不再提高时,提前结束训练。
耐心值Patience
最多容忍连续几轮没有进步,图里取 3。

重 点验证误差为什么会回升

训练误差一直在降,说明模型越来越熟悉训练数据。验证误差先降后升,说明从某一轮起它开始死记训练数据里的细节,对新数据反而不准了,这就是过拟合。早停就停在过拟合开始的地方。

知道更多实验二也会看到

实验二里同一份倒立摆程序,只换一个随机种子,练出来的成绩能差好几倍,有的一次涨上去又掉回来。训练结果有起伏,所以要边练边检查,把表现最好的那一版存下来。

36
第 7 章 · 第四节

完整的训练流水线

五块程序,从读数据一直做到算出成绩。

第 36 页 这段程序做了哪几件事

一份可以反复套用的训练模板

  1. 准备数据 按时间读成训练、验证、测试三份,每份切成一段段 96 小时的样本。
  2. 准备模型 建好 DLinear 模型,配上优化器 Adam 和损失函数 MSE。
  3. 训练加早停 一轮轮训练,每批走一遍第 33 页的五步,每轮结束在验证集上检查一次。
  4. 读回最好的一版 训练停下后,把验证集上最好的那一版模型读回来。
  5. 测试打分 在测试集上预测,算出 MSE 和 MAE。
model = Model(args).to(device)          # 这一行可以换成别的模型
model.load_state_dict(best_checkpoint)  # 读回最好的一版
mse, mae = compute_metrics(preds, trues)

重 点换模型只改一行

整条流水线和具体用哪个模型无关。把 DLinear 换成别的时间序列模型,只要改建模型那一行,读数据、训练、早停、测试都不用动。

关键术语

MAEMean Absolute Error
平均绝对误差,每次差多少取平均,第 3 章用天气预报算过。
检查点Checkpoint
训练过程中存下来的一份模型参数,之后随时可以读回来。

随堂练习

早停后要把“最好的一版”读回来,原因是?

  1. 停下时那一版多练了几轮,可能已经变差
  2. 读回来训练更快
  3. 不读回来没法预测
  4. 测试集规定这样做
查看答案
答案 A。早停要等连续几轮没有进步才停,这几轮里模型已经开始变差,所以要读回之前存下的最好版本。
保山学院·人工智能教研室·曹鼎鼎