人工智能导论 第 7 章 · 第三节
课程 › 第 7 章 › 第三节 任务定义特征编码时间与空间预处理与分类器Pipeline评估方法评估结果
第 7 章 人工智能实践 · 第三节

经典机器学习实践

给旧金山的案件分类,功夫在特征上
本 节 知 识 点
  1. 18犯罪分类:任务是什么
  2. 19不同的特征,不同的编码
  3. 20时间与空间特征
  4. 21预处理器与分类器
  5. 22Pipeline 与训练评估
  6. 23评估方法与三个指标
  7. 24三个模型的评估结果
18
第 7 章 · 第三节

犯罪分类:任务是什么

给一起案件的时间和地点,猜它属于哪一类。

第 18 页 旧金山犯罪分类:任务定义

输入一条案件记录,输出每一类的概率

字段意思例子
Dates发生时间2015/5/13 23:53
DayOfWeek星期几Wednesday(星期三)
PdDistrict所属警区NORTHERN(北区)
Address大致地址OAK ST / LAGUNA ST
X、Y经度、纬度−122.43、37.77
Descript案情描述 案发后才填WARRANT ARREST(执行逮捕令)
Resolution处理结果 案发后才填ARREST, BOOKED(逮捕并登记)
模型对某一起案件报出的概率(示意)盗窃0.42其他违法0.18非刑事0.12伤害0.10其余 35 类合计0.18最大,就猜它

重 点两列不能当输入

案情描述和处理结果都是警员处理案件时才填的。“执行逮捕令”这样的描述几乎直接说出了类别。刚接到报警时手里只有时间和地点,这两列还是空的,比赛的测试数据里也没有,训练时必须删掉。

关键术语

多分类Multi-class Classification
答案有很多类可选,每条数据只属于其中一类。这份数据有 39 类。

知道更多这份数据

它来自 Kaggle 上的一场练习赛,记录了旧金山警方十多年的案件,训练集有八十多万条。最常见的一类是盗窃,大约占两成。
19
第 7 章 · 第三节

不同的特征,不同的编码

先把各种字段都变成数,还不能让模型误会。

第 19 页 特征编码策略

每一类字段有自己的变法

字段类型例子怎么变成数
数值型经度、纬度、距离统一尺度,或者保留原值
是否型是不是周末是记 1,否记 0
无序类别星期几、警区独热编码,见下表
要预测的类别盗窃、伤害……按顺序编号 0、1、2……
文字地址OAK ST / LAGUNA ST提取出是不是路口、街道类型等几列
周一周二周三周四周五周六周日
星期三0010000
星期日0000001
要是直接把周一到周日记成 1 到 7,模型会以为“周日比周一大 6”,这没有意义。独热编码把一列拆成七列,大小关系就不存在了。

关键术语

独热编码One-Hot Encoding
有几种取值就拆成几列,属于哪一种,哪一列记 1,其余记 0。
特征工程Feature Engineering
把原始数据加工成模型好用的数。

重 点答案可以直接编号

要预测的类别编成 0 到 38,模型只把它当“第几类”的名字,不比大小,所以不用独热。

随堂练习

“血型”有 A、B、AB、O 四种,当作特征时最合适的编码方式是?

  1. 记成 1、2、3、4
  2. 独热编码,拆成四列
  3. 统一尺度
  4. 删掉不用
查看答案
答案 B。血型没有大小之分,记成 1 到 4 会让模型以为 O 型比 A 型大 3。拆成四列,每人只在自己那一列记 1。
20
第 7 章 · 第三节

时间与空间特征

把一天绕成一个圆,23 点和 0 点就挨在一起了。

第 20 页 时间与空间特征

把 24 个小时排成一圈

绕成圆:用正弦、余弦两个数0612182323 点和 0 点只隔 0.26排成直线:直接用 0 到 230612182323 点和 0 点隔着 23模型会以为深夜和凌晨相差最远,其实只差一小时
时刻正弦值余弦值在圆上离 0 点多远
0 点010
23 点−0.260.970.26
12 点0−12(最远)
空间特征也要加工:把经纬度统一尺度,把坐标轴转几个角度,再算出到几个地标的距离。

重 点一个数拆成两个数

把 24 个小时均匀摆在钟面上,每个时刻用它在钟面上的横、竖两个位置来表示,这两个数就是正弦和余弦。钟面上挨着的时刻,这两个数也挨着。实验一会亲手比较小时的两种写法。

打个比方

钟表上 11 点和 1 点隔着两格,谁都不会说它们差了 10 个小时。星期几、月份、风向也都是首尾相接的量,都可以这样绕成圆。

知道更多为什么要转坐标轴

决策树切分数据时只会横着切或竖着切。把经纬度转几个角度,多出几列斜着的坐标,它就能切出斜线,贴合斜着走的街道。

21
第 7 章 · 第三节

预处理器与分类器

不同类型的列走不同的处理,再交给分类器。

第 21 页 这段程序做了哪几件事

先分组处理,再交给分类器

  1. 把列分成三组 数值列(经纬度、距离),是否列(是不是周末),类别列(星期几、警区)。
  2. 每组各用各的办法 数值列统一尺度,是否列保持 0 和 1,类别列做独热编码。
  3. 拼回一张表 三组处理完自动并排拼好,交给后面的分类器。
  4. 准备分类器 选梯度提升树:一共 100 轮,每轮种一批树,每次只往前修正一小步(步长 0.1),随机种子固定为 42。
preprocessor = ColumnTransformer([
    ('num', numeric_transformer, numeric_features),
    ('bin', binary_transformer, binary_features),
    ('cat', categorical_transformer, categorical_features)])
clf = HistGradientBoostingClassifier(max_iter=100, learning_rate=0.1)

关键术语

梯度提升树Gradient Boosting Trees
一批接一批地种决策树,每批新树专门去改正前面那些树还没改好的错误。
预处理Preprocessing
数据进模型之前的整理工作,比如统一尺度、编码。

知道更多为什么固定随机种子

训练中有几处要随机抽样,种子不固定,每次结果会略有不同。固定成 42 之后,谁来跑都得到同样的结果。42 这个数本身没有特别的含义,只是很多人的习惯。

22
第 7 章 · 第三节

Pipeline 与训练评估

预处理和模型接成一条管道,训练和预测不会走岔。

第 22 页 Pipeline 与训练评估

同一条管道,训练和预测各走一遍

训练时预测时训练数据案件和答案预处理从这里学规则分类器从这里学参数新的案件没有答案同一套预处理规则直接套用分类器参数直接套用39 个概率取最大的一类学好的东西原样带下来
  • pipeline.fit(X, y) 训练:数据先过预处理,再进分类器,两边的规则都只从训练数据里学。
  • log_loss 看报出的概率靠不靠谱,越小越好。
  • argmax 和 accuracy_score 取概率最大的那一类当答案,再算猜对的比例。

重 点防住两种错误

一是训练时统一了尺度,预测时却忘了做。二是切分之前就用全部数据算平均数,造成泄露。管道把规则锁在训练数据上,两种错误都能避免。

关键术语

管道Pipeline
把几个处理步骤按顺序接成一个整体,调用一次就依次做完。

随堂练习

训练时把经纬度统一了尺度,上线预测时忘了这一步,会发生什么?

  1. 没有影响
  2. 模型拿到的数尺度不对,预测会出错
  3. 模型会自动补上
  4. 准确率会提高
查看答案
答案 B。模型只认识训练时的那种尺度。预测时换了尺度,就像拿厘米数去查以米为单位的表。管道能保证两边处理一致。
23
第 7 章 · 第三节

评估方法与三个指标

准确率看猜没猜对,LogLoss 看概率报得准不准。

第 23 页 评估方法与指标

分层 K 折交叉验证,看三个数

指标问的是什么好坏
准确率 Accuracy排第一的那一类猜对没有越高越好
对数损失 LogLoss给正确答案报了多大的概率越低越好
标准差 StdK 次成绩之间相差多少越低越稳
给正确那一类报的概率0.90.50.10.01
这一条的 LogLoss0.110.692.304.61
LogLoss 是每一条罚分的平均。概率每缩小到原来的十分之一,罚分就多出 2.3。给正确那一类只报 0.01 的一次错判,罚分相当于四十多次报 0.9 的答对。

重 点分层是加了一条要求

K 折交叉验证第 3 章讲过。分层是要求每一折里各类案件的比例都和整体差不多,否则某一折里可能一件少见的案子都没有,那一折的成绩就没有参考价值。

打个比方

天气预报说明天降水概率 90%,结果一滴没下,你会觉得它很不靠谱。说 50% 没下,还能接受。LogLoss 就是这样打分的,越有把握地说错,罚得越重。

24
第 7 章 · 第三节

三个模型的评估结果

三个模型各有长处,没有哪一个全面占优。

第 24 页课件

重 点这张表怎么读

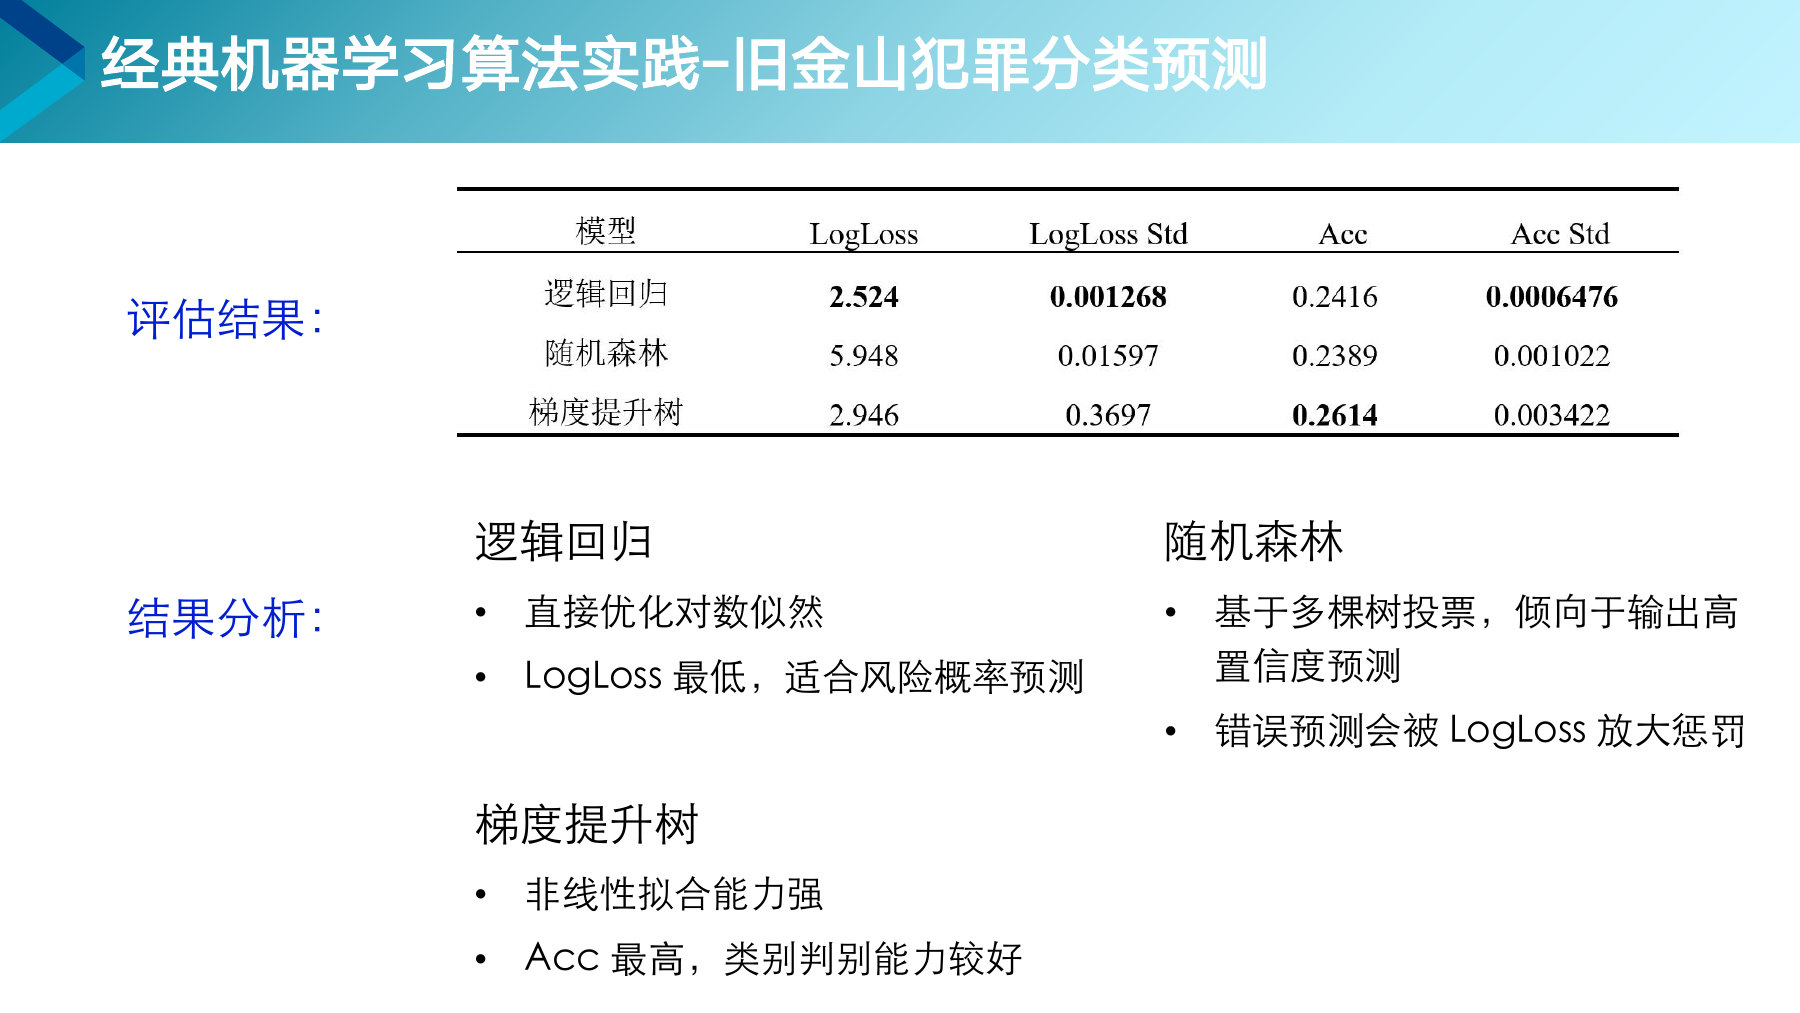
逻辑回归的 LogLoss 最低(2.524),波动也最小,报的概率最靠谱。梯度提升树的准确率最高(0.2614),LogLoss 却波动最大。随机森林两项都不占优,LogLoss 高达 5.948。

关键术语

随机森林Random Forest
种很多棵决策树投票。所有树意见一致时,它会报出百分之百的把握,猜错时罚分极重。

随堂练习

这个任务有 39 类,最常见的盗窃约占两成。准确率 0.26 该怎么看?

  1. 很差,不到一半
  2. 比全押盗窃只高几个点,任务本身很难
  3. 接近满分
  4. 和乱猜差不多
查看答案
答案 B。乱猜只能对 1/39,约 2.6%,全押盗窃能对两成。光靠时间和地点,本来就很难猜准。
保山学院·人工智能教研室·曹鼎鼎