人工智能导论 第 7 章 · 第二节
课程 › 第 7 章 › 第二节 软件栈GPU 配置容器化可复现框架与生态训练流程
第 7 章 人工智能实践 · 第二节

开发环境与工具箱

环境怎么配,工具怎么选,从哪里起步
本 节 知 识 点
  1. 12环境问题是多层软件栈问题
  2. 13GPU 环境配置
  3. 14容器化:能带走什么
  4. 15运行与可复现
  5. 16框架与生态
  6. 17模型通用训练流程
12
第 7 章 · 第二节

环境问题是多层软件栈问题

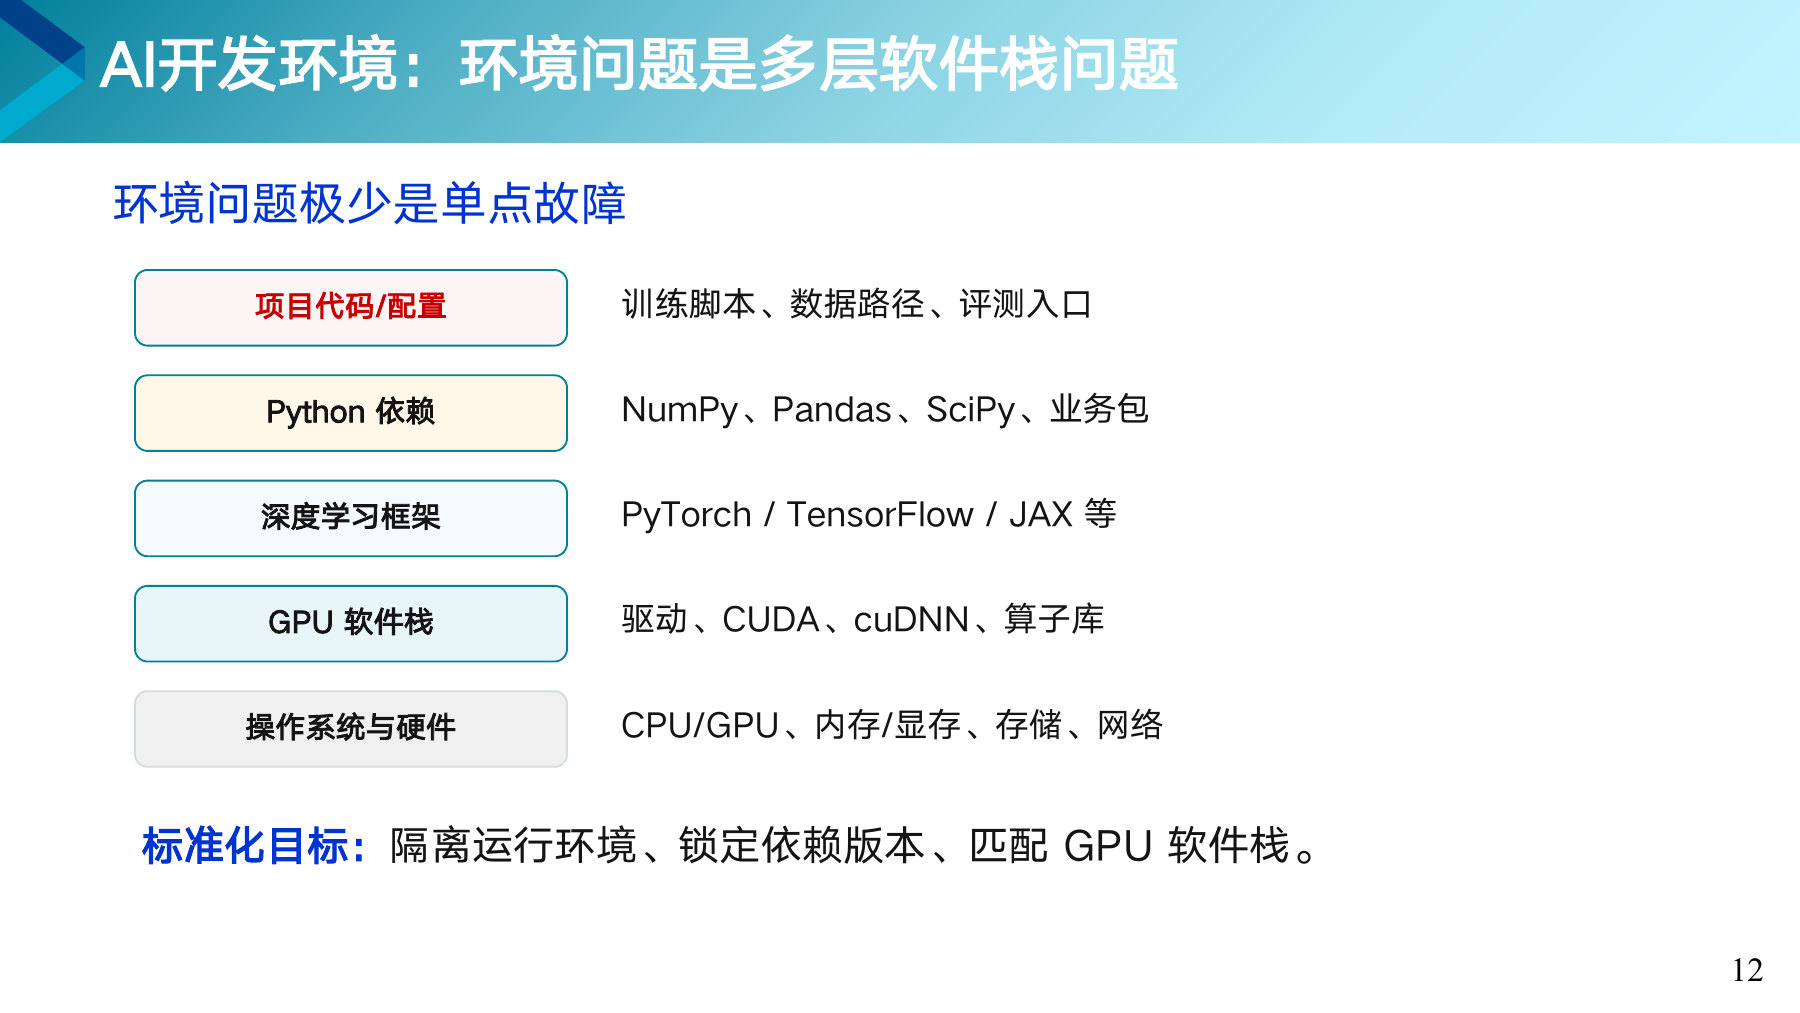
软件一层叠一层,出错的地方常常不在报错那一层。
第 12 页课件

重 点从下往上五层

从机器和操作系统往上,依次是驱动和 CUDA、PyTorch 这类框架、各种 Python 包,最上面是自己写的代码。上一层要靠下一层才能运行。

打个比方

楼上的墙裂了缝,毛病可能在地基。程序报“找不到某个文件”,原因可能是下面几层的版本对不上。

关键术语

依赖Dependency
一个程序运行时要用到的其他软件包。
CUDACompute Unified Device Architecture
英伟达显卡的通用计算平台,让显卡能做画图以外的计算。
cuDNNCUDA Deep Neural Network library
英伟达写好的深度学习常用运算,比如卷积。
13
第 7 章 · 第二节

GPU 环境配置

显卡用不起来,多半是几层版本没对上。

第 13 页 GPU 环境的三步检查

三条命令,从下往上查

  1. nvidia-smi 问电脑:有没有英伟达显卡,装的驱动是哪一版。这一步看不到显卡,就要先装或升级驱动。
  2. nvcc --version 问电脑:装的 CUDA 工具包是哪一版。也可以在框架里查它用的是哪一版 CUDA。
  3. pip list 或 conda list 列出装了哪些 Python 包、各是哪一版,确认框架的版本和 CUDA 对得上。
import torch
print(torch.cuda.is_available())   # 打印 True,说明框架找到了显卡
驱动要够新:新驱动带得动旧版 CUDA,旧驱动带不动新版 CUDA。

关键术语

驱动Driver
让操作系统能指挥显卡干活的程序。

知道更多框架常自带 CUDA

用 pip 装的 PyTorch 通常自带所需的 CUDA 运行库,只要显卡驱动够新就能用。

随堂练习

nvidia-smi 能看到显卡,torch.cuda.is_available() 却打印 False。问题最可能在哪一层?

  1. 显卡坏了
  2. 框架装错了版本,或者和 CUDA 不匹配
  3. 硬盘满了
  4. 操作系统太新
查看答案
答案 B。能看到显卡,说明显卡和驱动都装好了。毛病多半在上面的框架这一层,常见的是装成了只支持 CPU 的版本,或者框架要的 CUDA 比驱动支持的还新。
14
第 7 章 · 第二节

容器化:能带走什么

Docker 把软件环境打包带走,带不走硬件。

第 14 页 容器化的用处和边界

装进镜像的,换台机器照样能用

项目代码与配置Python 和各种包深度学习框架CUDA 运行库显卡驱动操作系统显卡、硬盘、网络Docker 镜像里装的换一台机器,照样带走机器本身的镜像带不走
适合用来

统一大家的软件环境,把项目连同环境一起交给别人,出了问题能退回上一版。

不能指望它

代替机器上的显卡驱动,解决硬盘读得慢、网络慢,管理一大群服务器。

关键术语

DockerDocker
最常用的容器工具,2013 年发布。
镜像Image
打包好的一整套软件环境,像一个装好东西的箱子。
容器Container
镜像运行起来以后的样子,像把箱子打开开始干活。

打个比方

搬家时把锅碗瓢盆装进纸箱,到了新家打开就能做饭。可新家有没有通燃气、水压够不够,纸箱管不了。Docker 装的是软件,驱动、硬盘、网络属于房子本身。

15
第 7 章 · 第二节

运行与可复现

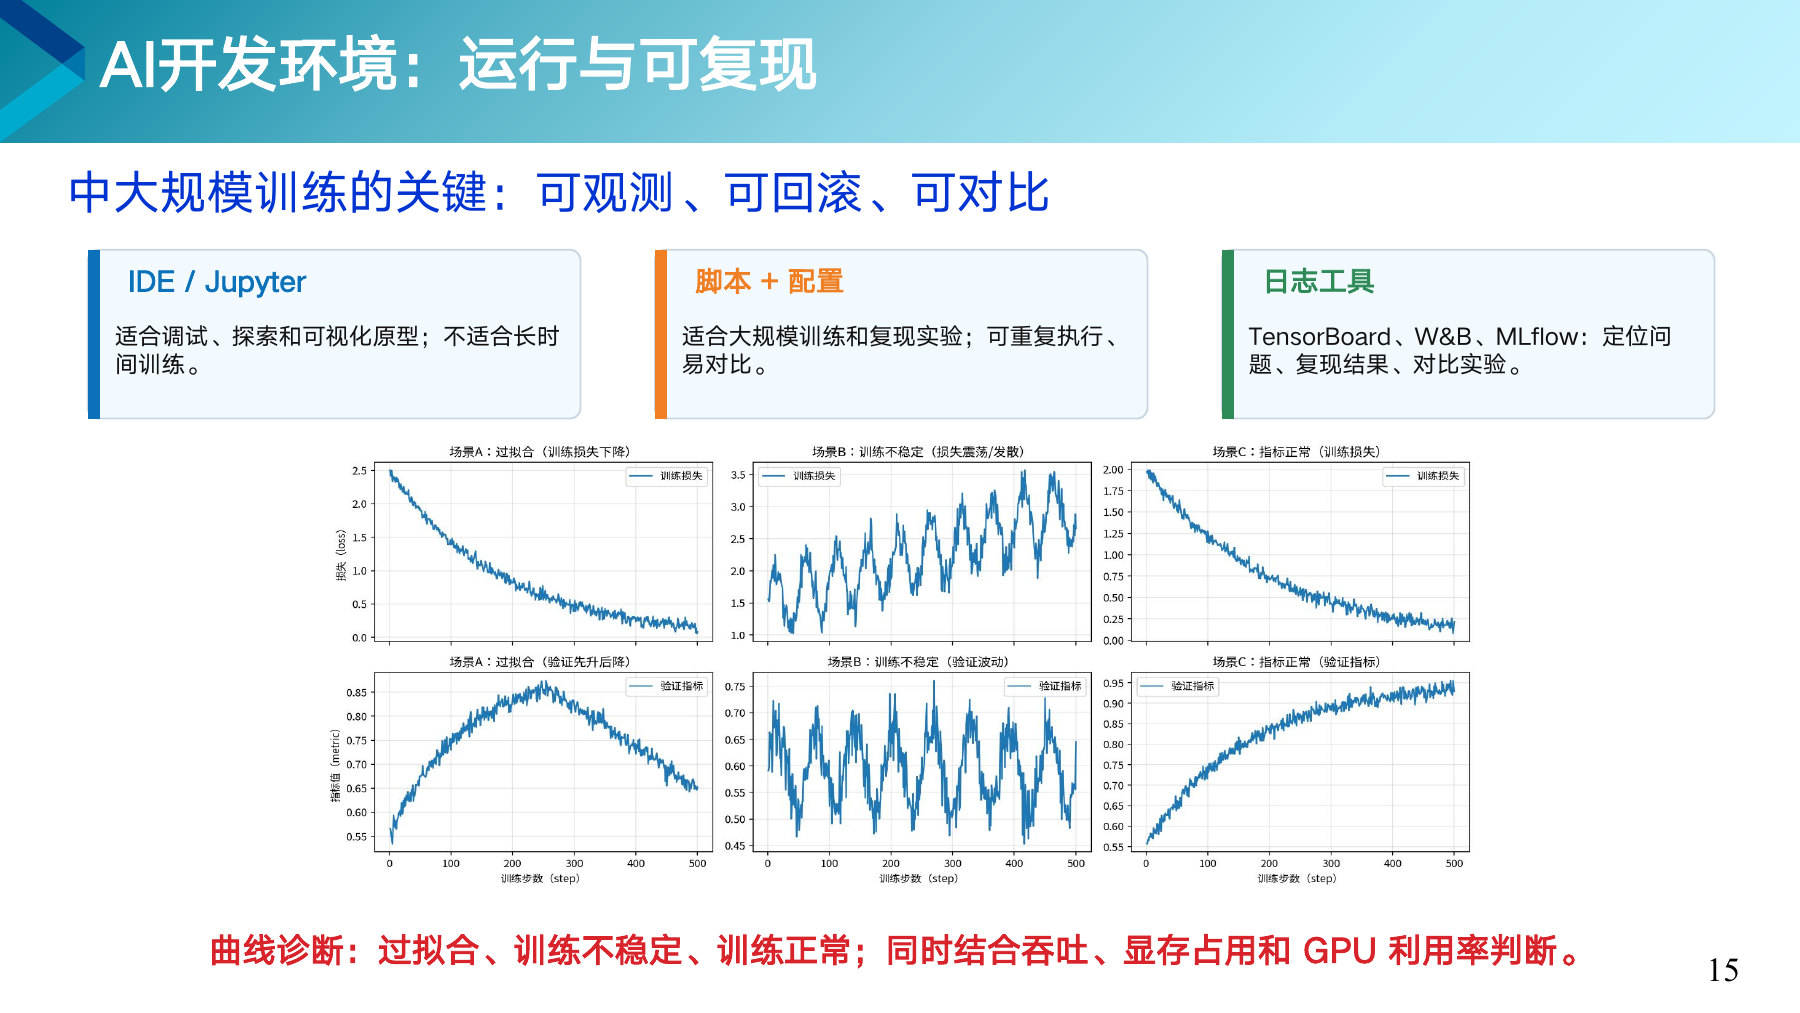
长时间训练要看得见过程,还要能对比、能回退。

第 15 页课件

重 点六张曲线怎么读

上排是训练损失,下排是验证指标。左列损失一路下降,验证指标却先升后降,这是过拟合。中列两条线都乱跳,是训练不稳定。右列是正常的样子。

关键术语

JupyterJupyter Notebook
在浏览器里一段段写代码、马上看结果,适合试验和画图。
日志工具Logging Tool
把损失和指标自动记下来画成曲线,比如 TensorBoard。

随堂练习

训练损失一直在下降,验证指标却从某一轮开始变差,最可能是什么情况?

  1. 训练正常
  2. 过拟合
  3. 显卡坏了
  4. 学习率设成了零
查看答案
答案 B。训练数据上越练越好,没见过的数据上反而变差,这就是第 2 章讲的过拟合。
16
第 7 章 · 第二节

框架与生态

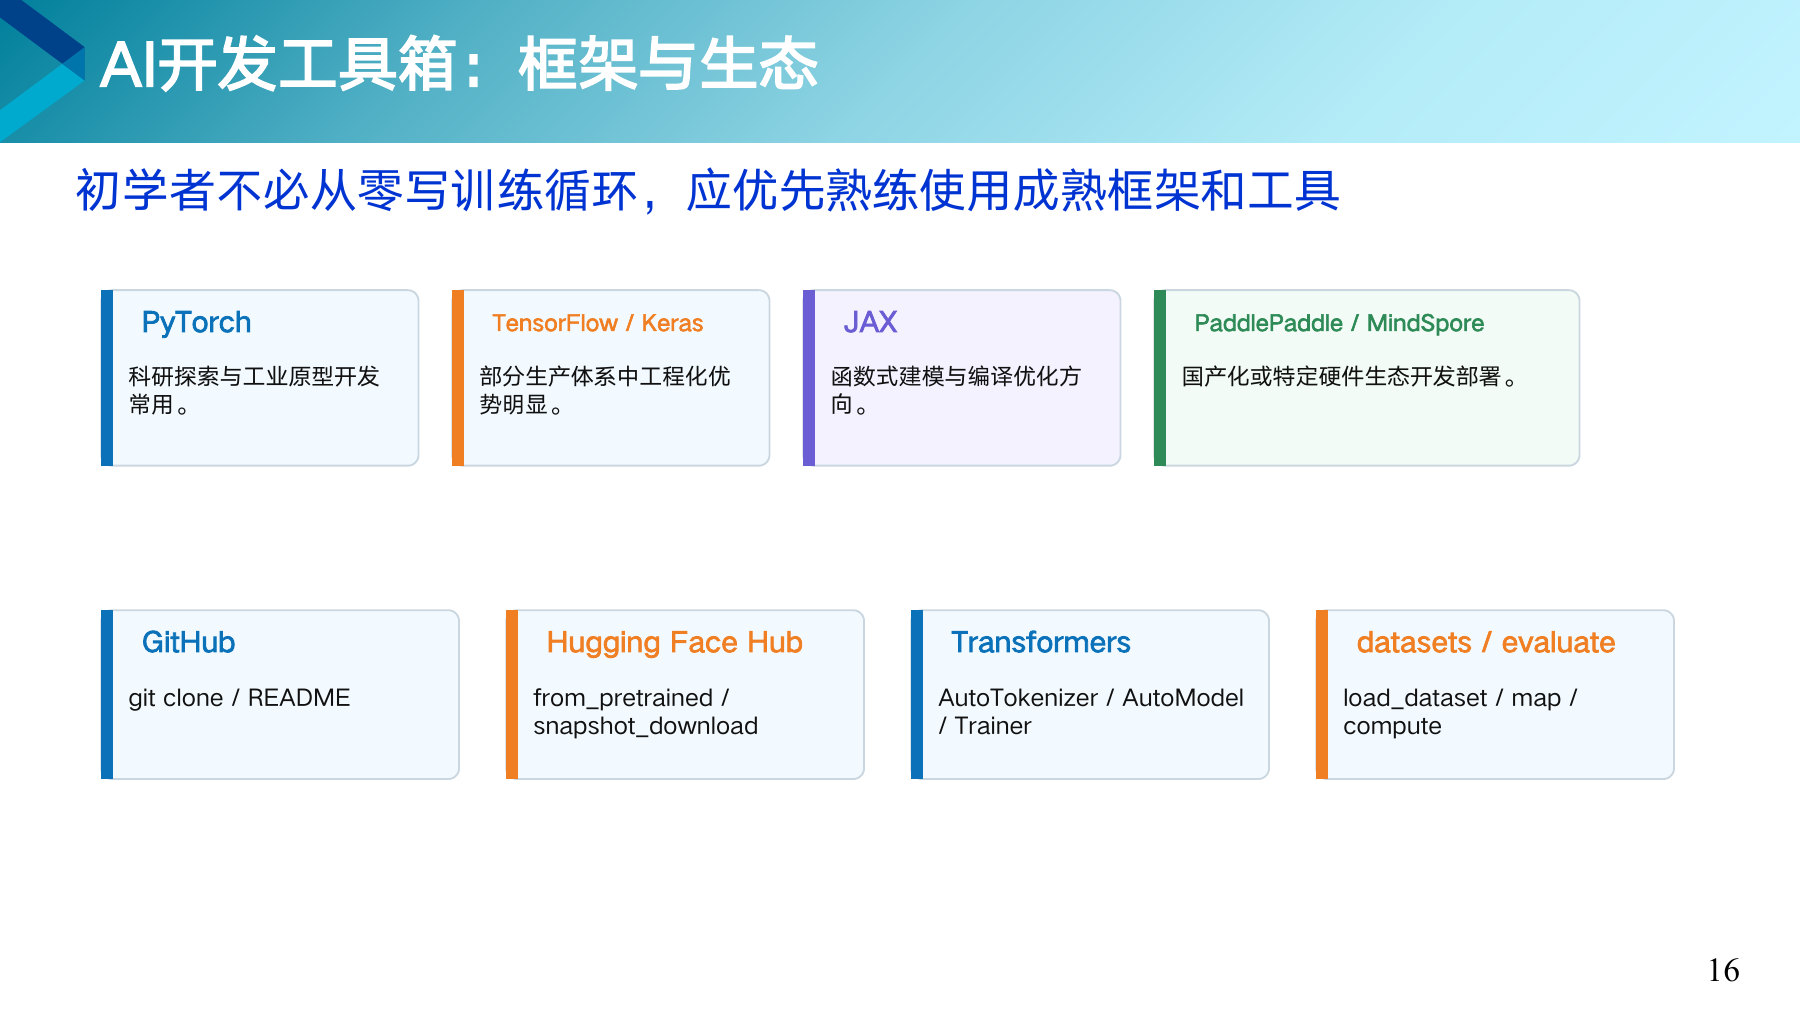
初学者先学会用现成的框架和模型。

第 16 页课件

知道更多上排四个框架的来历

PyTorch 由 Facebook(现在的 Meta)推出,TensorFlow 和 JAX 出自谷歌,飞桨来自百度,昇思来自华为。

关键术语

Hugging FaceHugging Face Hub
存放和分享预训练模型、数据集的网站,一行代码就能下载别人的模型。
预训练模型Pretrained Model
别人已经在大量数据上训练好的模型,可以直接拿来用,或者稍作调整。

打个比方

做饭不必从种菜开始,买来洗好切好的菜,自己专心调味就行。框架和预训练模型就是现成的菜。

17
第 7 章 · 第二节

模型通用训练流程

先用最小的规模把整条路走通,再慢慢加码。

第 17 页 模型通用训练流程

先打通闭环,再逐步加复杂度

  1. 定义任务 说清输入是什么、输出是什么、用哪个指标打分。
  2. 选基线 挑一个成熟、有预训练版本的模型当起点,后面的改进都和它比。
  3. 固定代码框架 读数据、训练、评测各写成固定的模块,换模型时只改一处。
  4. 最小训练跑通 用一小份数据、一张卡、训几轮,只确认程序不报错。
  5. 最小评测验证 确认指标算得出来,数值大致合理。
  6. 端到端推理 从一条原始数据输入到拿到结果完整走一遍,确认训练和使用时的处理完全一致。
图像、文本、生成等不同的任务,各有常用的工具包,比如图像常用 torchvision,文本常用 Transformers。换了任务,这六步不变。

重 点最小跑通是什么意思

先用一百条数据、训两三轮,把整条路走一遍。这一步不追求效果,只看数据读得进来、程序不报错、指标算得出来。路通了再上全部数据,出了错要查的范围小得多。

关键术语

基线Baseline
一个简单可靠的起点方案,用来衡量后面的改进到底有没有用。

打个比方

照着新菜谱做菜,第一次别请十桌客人。先做一小份尝尝,火候和调料都对了,再放开手做。

保山学院·人工智能教研室·曹鼎鼎