第 7 章 · 第一节
第七章 人工智能实践
前六章讲原理,这一章讲怎样把项目做出来。
知道更多这一章讲什么
前面六章回答“AI 是怎么学会的”,这一章回答“一个 AI 项目怎样从零做到上线”。先讲数据、算力、算法三样准备,再依次动手做经典机器学习、深度学习、强化学习、大模型、部署和竞赛,最后看各行各业怎么用。
前六章讲原理,这一章讲怎样把项目做出来。
前面六章回答“AI 是怎么学会的”,这一章回答“一个 AI 项目怎样从零做到上线”。先讲数据、算力、算法三样准备,再依次动手做经典机器学习、深度学习、强化学习、大模型、部署和竞赛,最后看各行各业怎么用。
训练出模型只是一段,项目还要能复现、能上线、能改进。
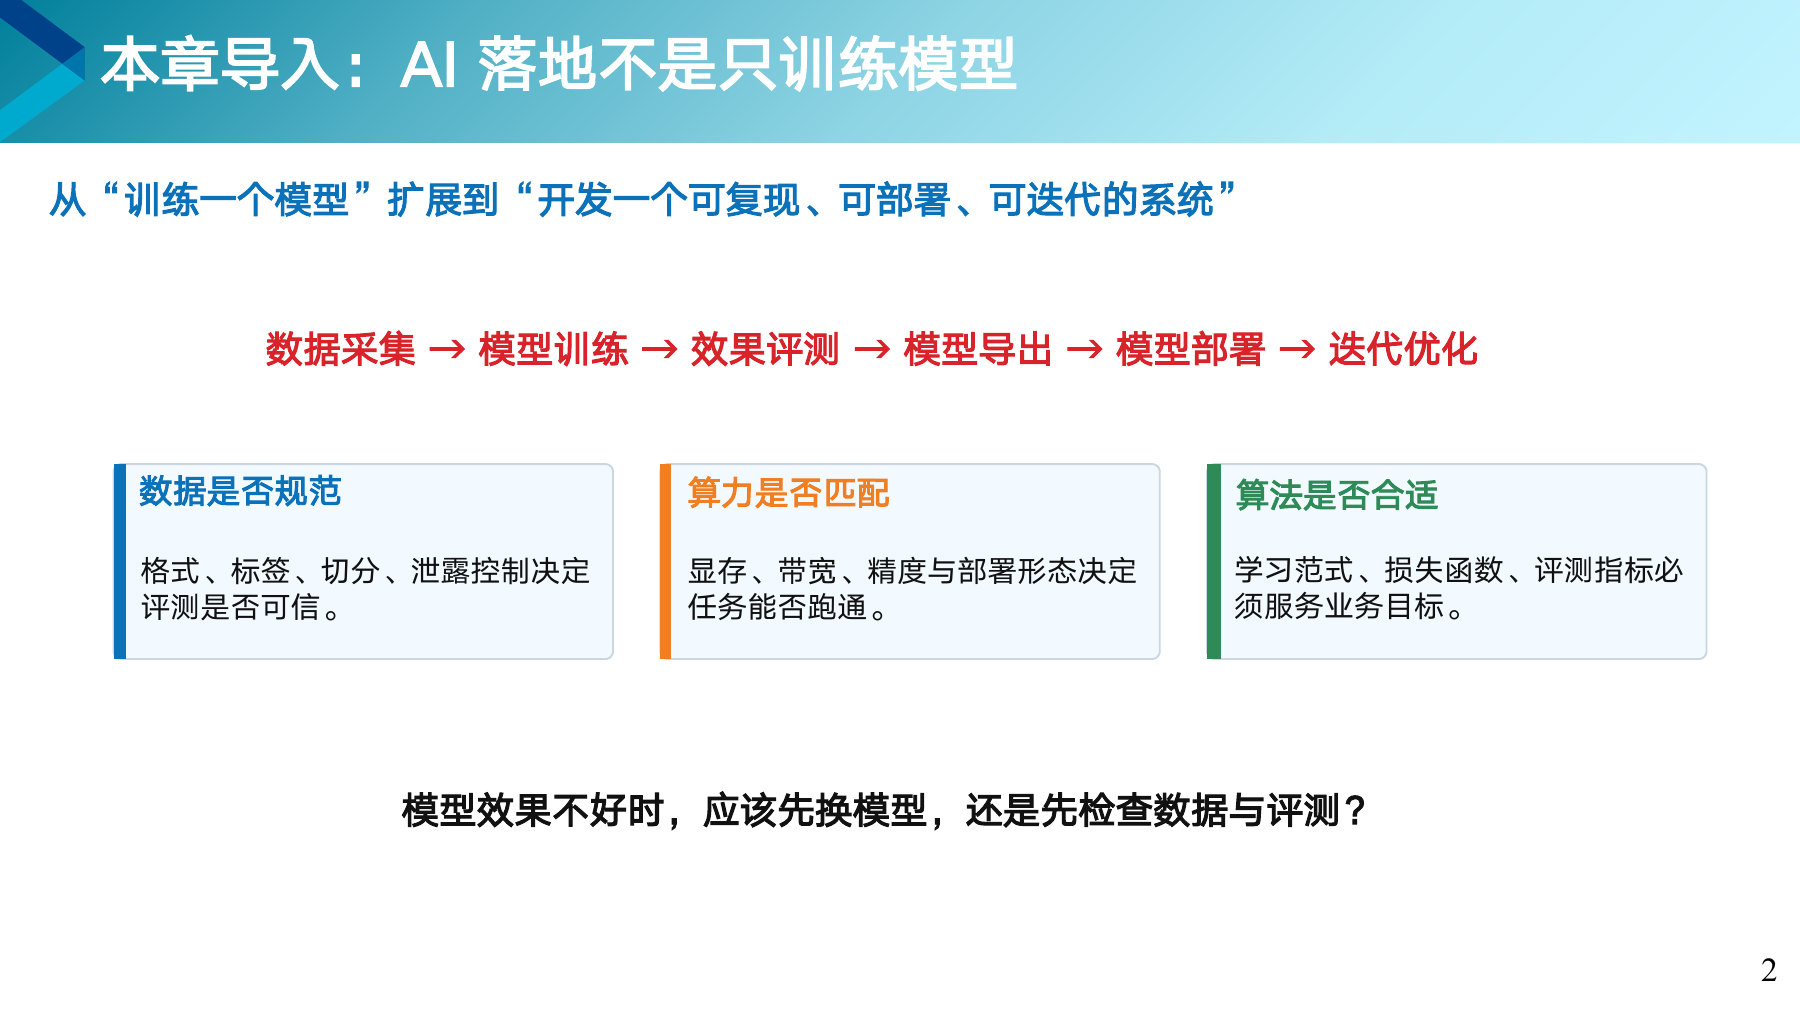
数据采集、模型训练、效果评测、模型导出、模型部署、迭代优化,这六步首尾相接。后面几节的实践,大多落在这条线的某一段上。
模型效果不好时,新手常急着换更复杂的模型。更常见的毛病是数据标错、切分漏题、评测方法不对,这些要先查。
每走一步都留下记录,出了问题才查得回去。
| 记录 | 记下什么 |
|---|---|
| 数据版本 | 用的是哪一批数据,怎样清洗、怎样标注 |
| 训练配置 | 用了哪些参数、什么软件环境、随机种子是几 |
| 评测报告 | 用什么指标、在哪批数据上测、错在哪些样本上 |
| 模型文件 | 导出成什么格式,导出后结果有没有变 |
| 部署镜像 | 上线时的整套运行环境,出了问题能退回上一版 |
训练里有不少随机的环节,比如参数的初始值、数据打乱的顺序。不固定随机种子、不记下用的是哪一批数据,同一份代码跑两次结果就可能不一样,也就说不清一次改动到底有没有用。
做化学实验要写实验记录:用了哪瓶试剂、温度多少、加热几分钟。结果做好了却没有记,下次就照不出来。数据版本和训练配置就是 AI 项目的实验记录。
数据、算力、算法三样要互相配得上。
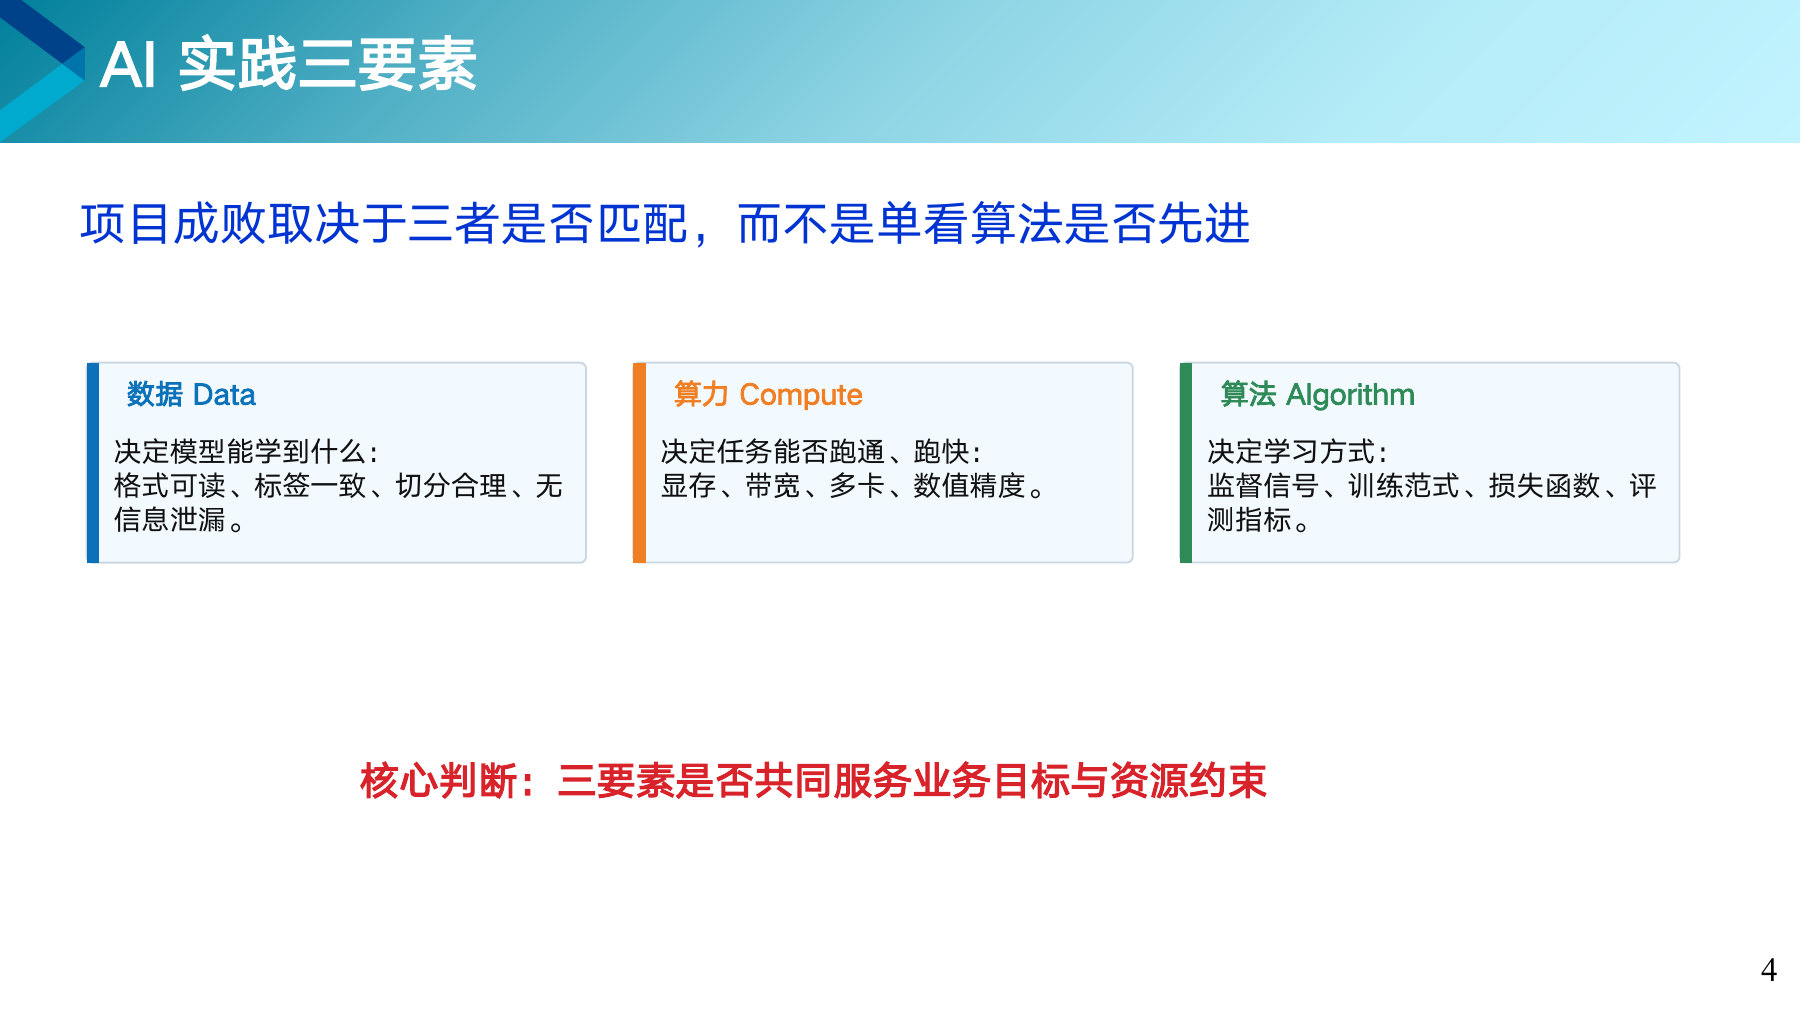
做一桌菜,数据是食材,算力是灶具,算法是菜谱。食材不新鲜,菜谱再好也做不出好菜。手边只有一个小电磁炉,就别照着大饭店的菜谱去炖一整锅。
手上有多少数据、能用什么机器、要解决什么问题,这三样一起决定了该选什么方法。
一个小组只有 200 张标好的照片和一台普通笔记本。哪种做法最合适?
手上有数据,不等于能直接拿来训练。
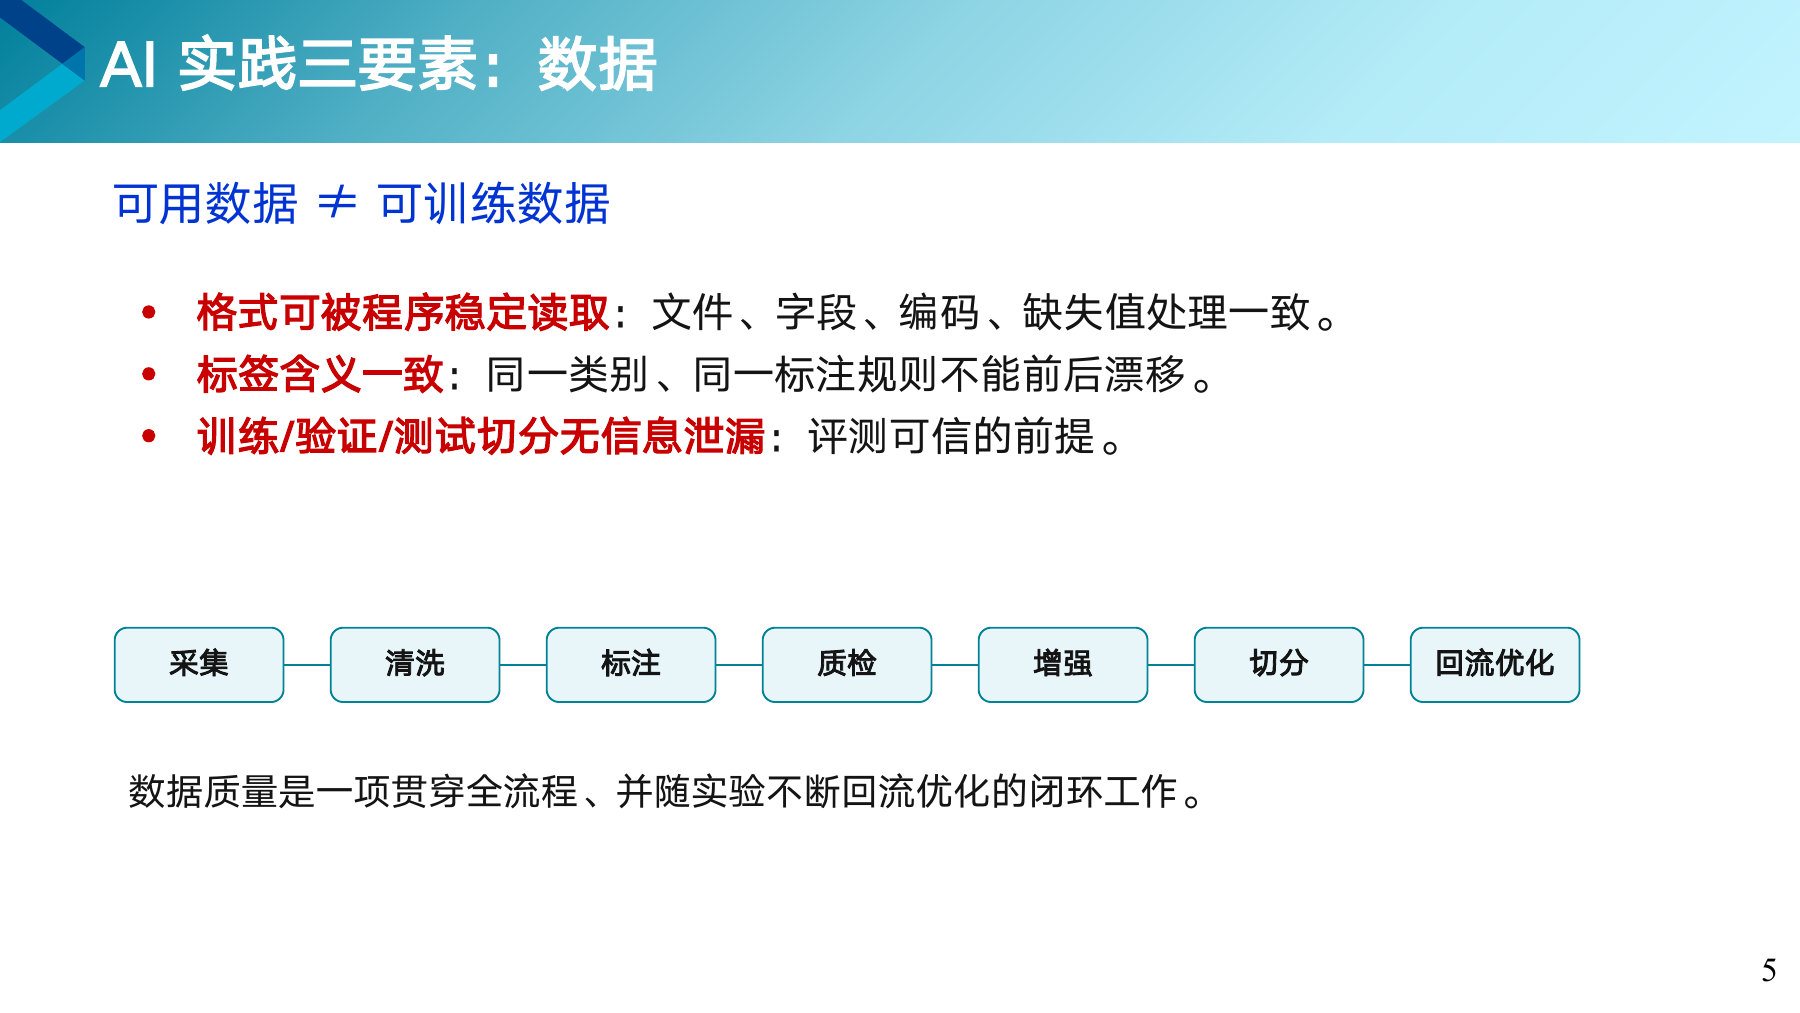
程序每次都能正确读进来,同一个标签从头到尾是同一个意思,三份数据之间不漏题。缺了任何一条,后面的训练和评测都靠不住。
请两位同学标注照片。一位把小猫也标成“猫”,另一位单独标成“小猫”。合在一起训练,模型看到的规则前后矛盾,怎么学都学不明白。这就是标签不一致。
图中那条链的最后一环是回流优化:看模型错在哪些样本上,再回头补数据、改标注,一轮一轮地改进。
三份数据各管一件事,切法要看数据的来历。
| 切法 | 怎么切 | 适合的例子 |
|---|---|---|
| 随机按比例 | 全部打乱,按 7:1:2 分成三份 | 一万张猫狗照片 |
| 分层随机 | 打乱时保持各类的比例不变 | 一千封邮件里只有 50 封垃圾邮件 |
| 按时间 | 早的数据训练,晚的数据测试 | 用前十个月的销量预测后两个月 |
| 滚动验证 | 时间窗口一段段往后挪,多验证几次 | 1 至 6 月训练、7 月验证,再 1 至 7 月训练、8 月验证 |
| 按组划分 | 同一个人的数据只进其中一份 | 同一位病人的几张 X 光片 |
训练集学参数,验证集挑方案、调设置,测试集只在最后考一次。看过测试集的成绩再回去改模型,最后的分数就不可信了。
分层像分组抽签:全班 40 人里只有 4 位女生,分两组时最好每组各 2 位。少见的那一类,每一份数据里都要有。
用一家超市三年的销量预测明年的销量,该怎样切分数据?
测试集的信息偷偷流进训练,分数就会虚高。
| 泄露方式 | 例子 |
|---|---|
| 重复样本 | 同一张照片存了两份,一份分进训练集,一份分进测试集。模型只要记住它,就能答对。 |
| 同一对象 | 同一位病人的五张片子,三张在训练集,两张在测试集。模型认出了这个人,没有学会看病。 |
| 时间倒流 | 用明年才公布的数据去“预测”今年。真要用的时候,明年的数据还不存在。 |
| 全量统计 | 先用全部数据算平均数,再切分。测试集的信息已经悄悄混进了这个平均数。 |
有泄露的程序照样能跑,只会让分数变得好看。线下测出九成的准确率,上线以后可能只剩六成。分数好得不像话时,先怀疑是不是漏了题。
老师考前给大家划重点。要是划重点时已经看过了期末试卷,重点里自然带上了考题,大家考得再好也说明不了什么。先切分,就是划重点时不许看试卷。
实验一的数据里有一列案情描述,是案发以后警员才填的。把它当成特征,分数会好得离谱,这就是时间倒流式的泄露。
四种硬件各有所长,要按手上的任务来挑。
| 硬件 | 擅长什么 | 常用在哪里 |
|---|---|---|
| CPU 中央处理器 | 什么都能算,但同时算的数量有限 | 读数据、整理数据、运行小模型 |
| GPU 图形处理器 | 几千个计算单元同时算同一类题 | 训练和运行深度学习模型 |
| TPU 张量处理器 | 谷歌专为神经网络设计,在云上租用 | 云上的大规模训练 |
| NPU 神经网络处理器 | 省电,装在手机、摄像头等设备里 | 手机上的识别、国产硬件上的部署 |
一次能装下多少数据,算得有多快,能不能多张卡一起算。
用户要等多久,会不会出错,能不能装进手机或摄像头。
CPU 像几位什么题都会做的数学老师,GPU 像几千名只会加减乘除的小学生。算一万道乘法,几千名小学生一起算要快得多,神经网络里正是海量的乘法和加法。
模型里的数平时用 32 位存,部署时改用 8 位整数存,体积缩到四分之一,准确率通常只掉一点。这叫量化,第 4 章讲轻量化时介绍过。
出了问题先查显存和数据,别急着换模型。
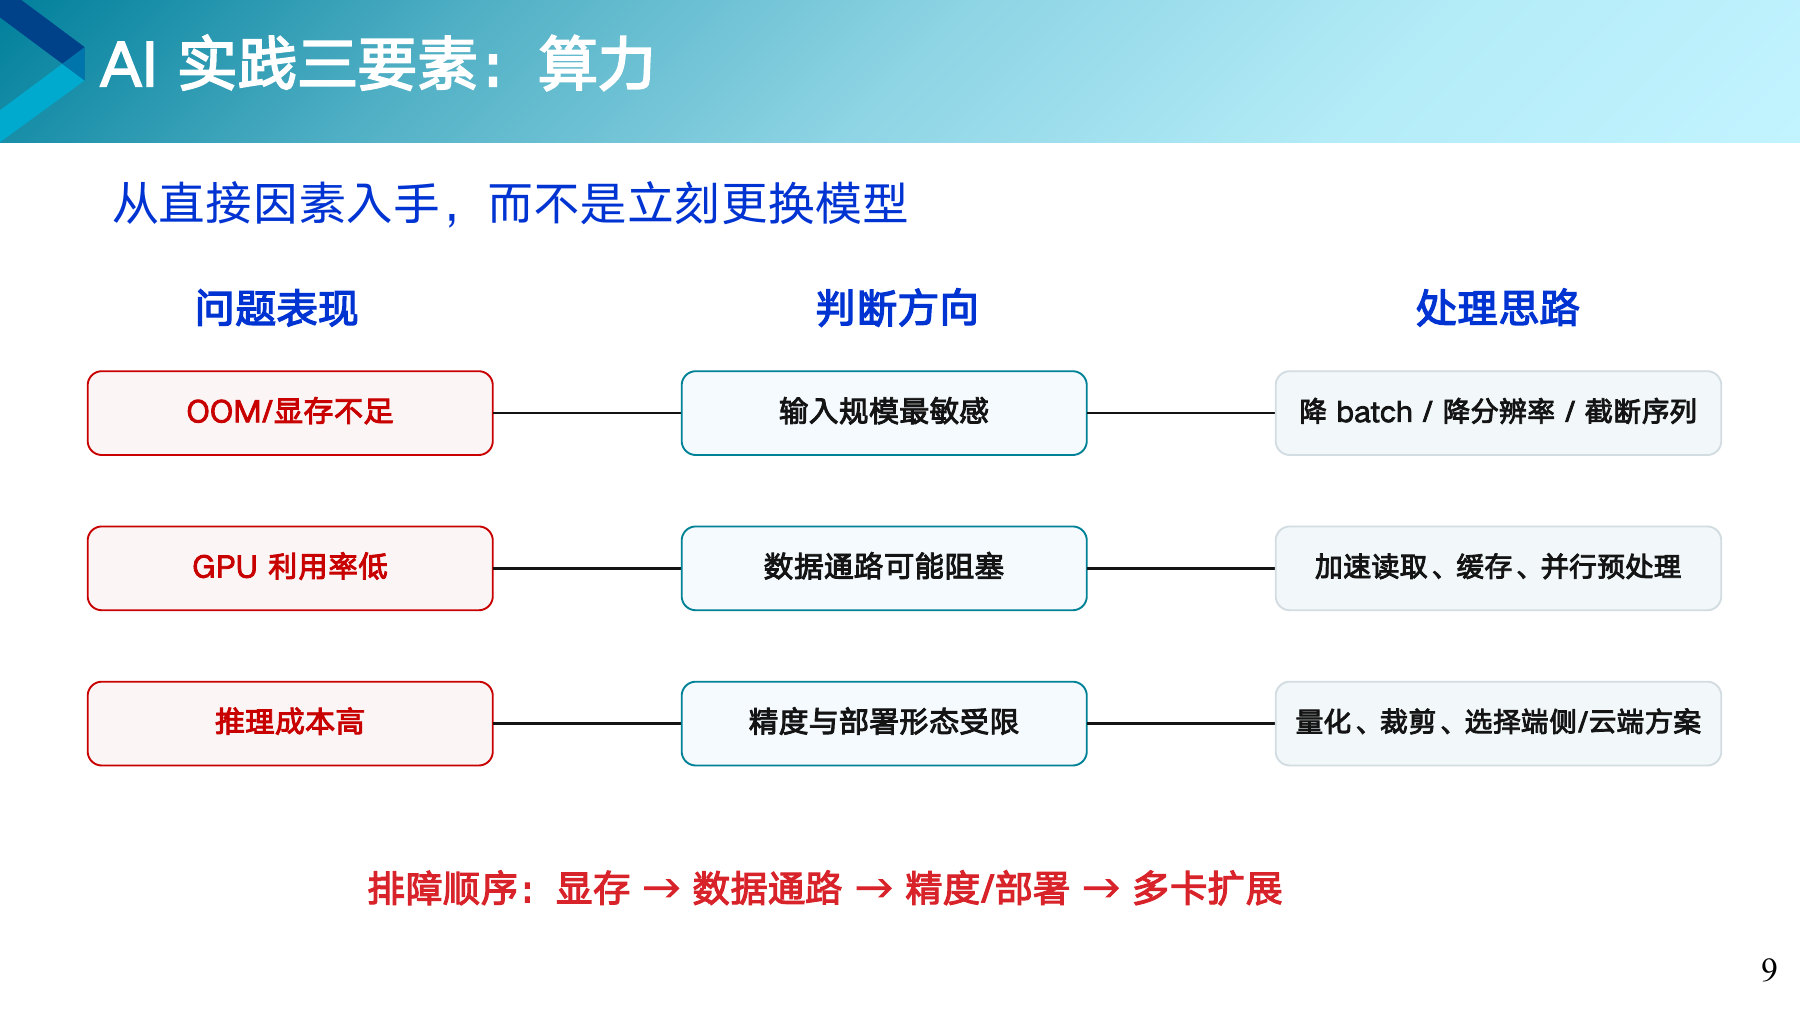
GPU 利用率低,像厨师站在灶台前干等,菜还没洗好切好。换一位更厉害的厨师没有用,要让洗菜切菜跟上。数据读得慢,显卡就只能空转。
训练时显卡利用率只有 20%,最先该查什么?
标签有多少、贵不贵,决定选哪一种学习方式。
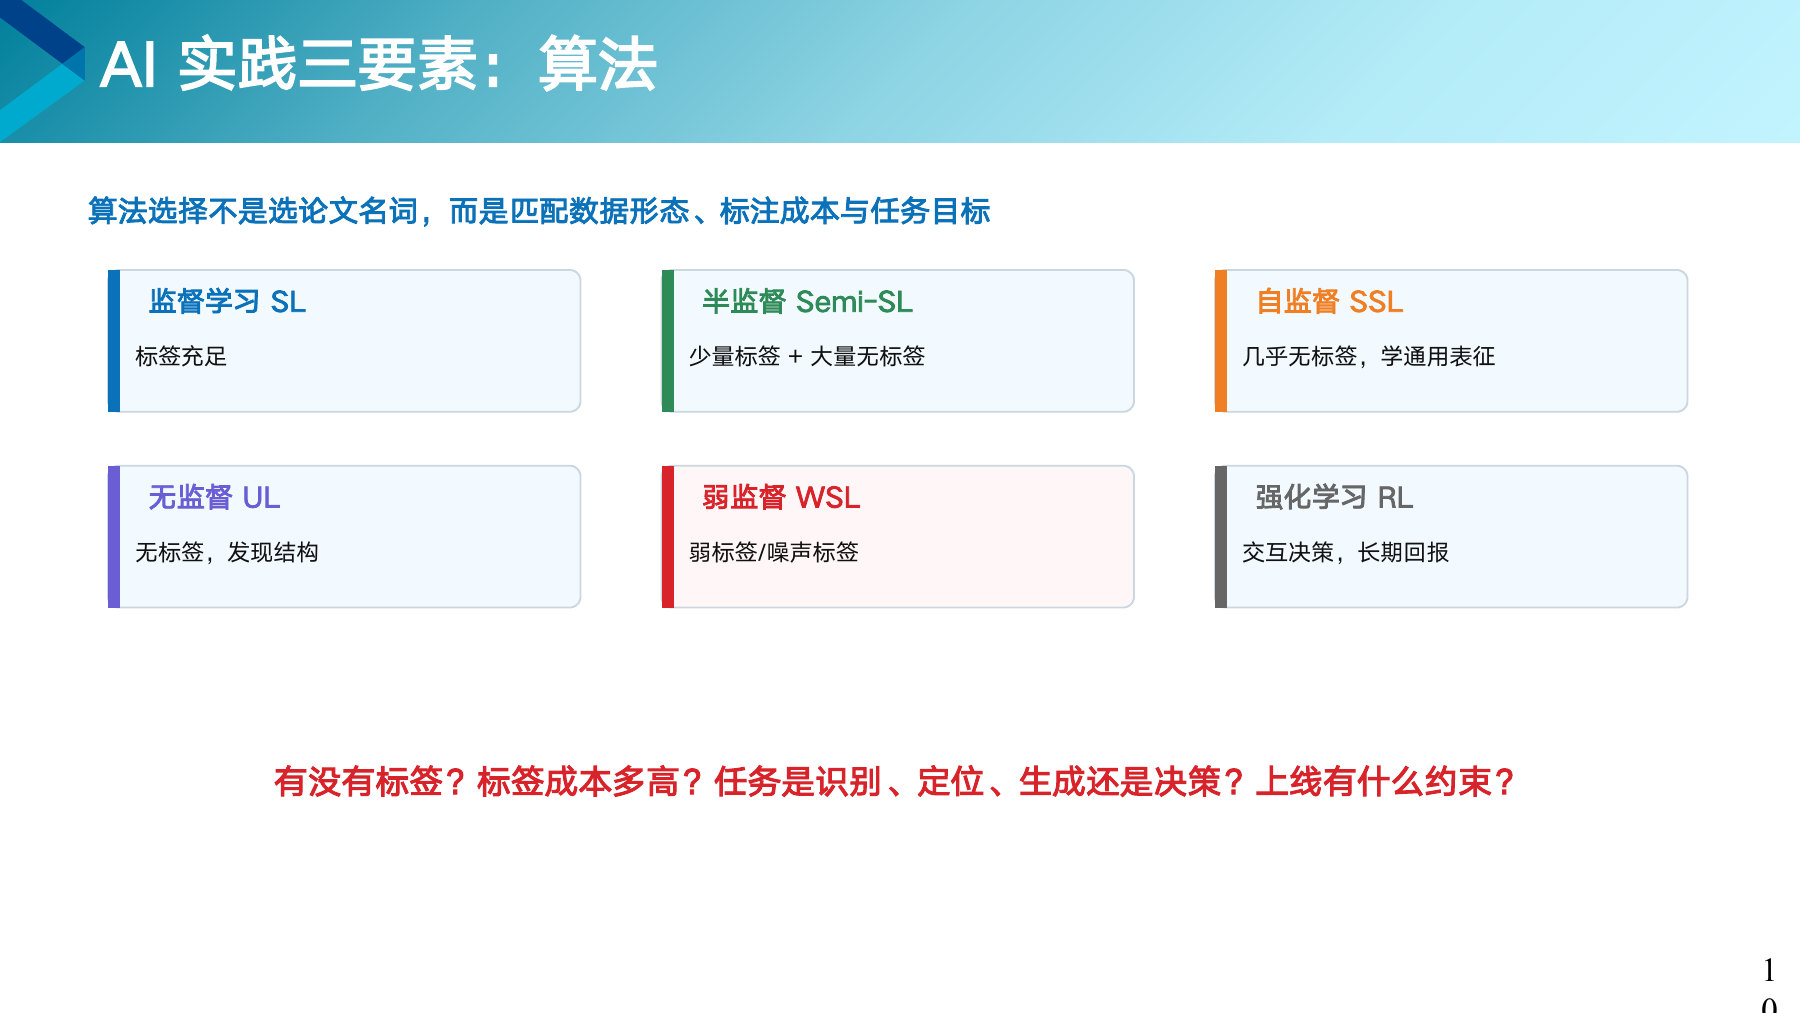
医院有十万张 X 光片,只有 500 张请医生标注过。最适合哪种学习方式?
要选的东西很多,评测也不只看一个分数。
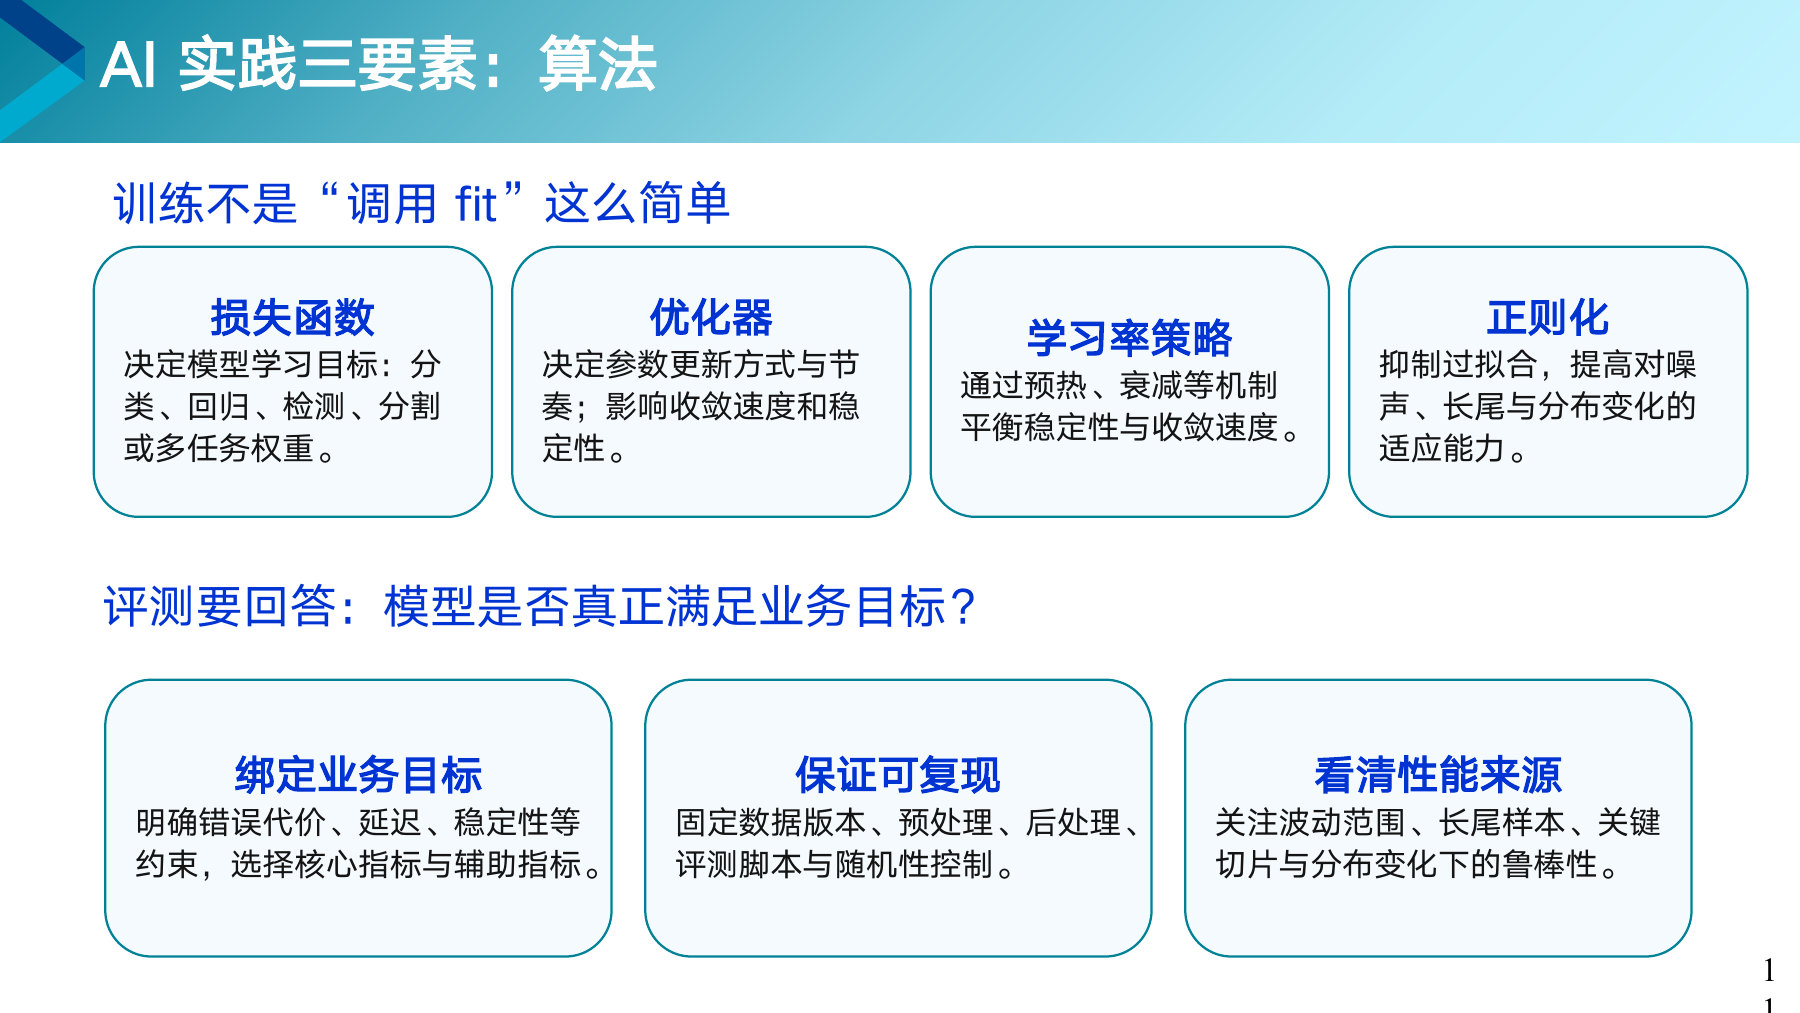
整体准确率九成听着不错,可剩下一成的错如果全落在最要紧的那一类上,比如把重病判成健康,模型就不能用。评测要把错误拆开看。
驾校总在同一个晴天、同一条路上考,你次次都能过。真上了路,遇到雨夜和学校门口,才发现还有很多没练过。长尾样本和关键切片,说的就是这些少见但要紧的情况。