环境问题是多层软件栈问题
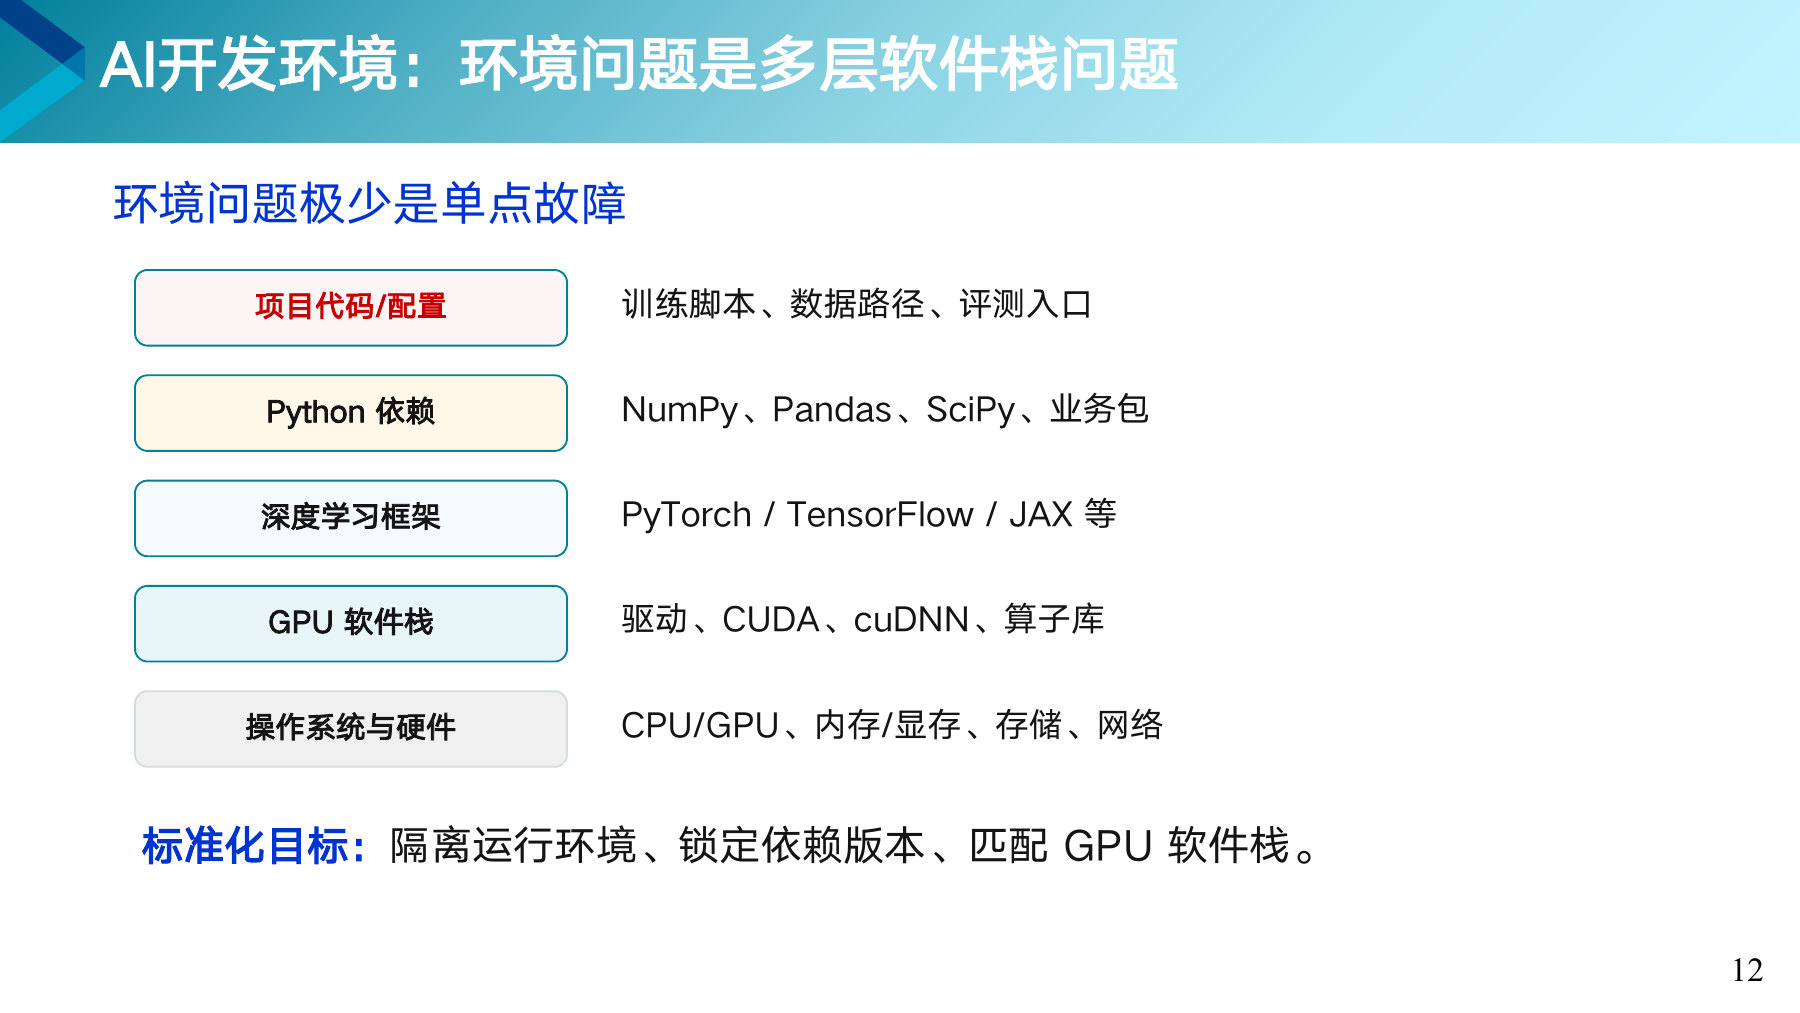
软件一层叠一层,出错的地方常常不在报错那一层。

重 点从下往上五层
从机器和操作系统往上,依次是驱动和 CUDA、PyTorch 这类框架、各种 Python 包,最上面是自己写的代码。上一层要靠下一层才能运行。
打个比方
楼上的墙裂了缝,毛病可能在地基。程序报“找不到某个文件”,原因可能是下面几层的版本对不上。
软件一层叠一层,出错的地方常常不在报错那一层。

从机器和操作系统往上,依次是驱动和 CUDA、PyTorch 这类框架、各种 Python 包,最上面是自己写的代码。上一层要靠下一层才能运行。
楼上的墙裂了缝,毛病可能在地基。程序报“找不到某个文件”,原因可能是下面几层的版本对不上。
显卡用不起来,多半是几层版本没对上。
import torch print(torch.cuda.is_available()) # 打印 True,说明框架找到了显卡
用 pip 装的 PyTorch 通常自带所需的 CUDA 运行库,只要显卡驱动够新就能用。
nvidia-smi 能看到显卡,torch.cuda.is_available() 却打印 False。问题最可能在哪一层?
Docker 把软件环境打包带走,带不走硬件。
统一大家的软件环境,把项目连同环境一起交给别人,出了问题能退回上一版。
代替机器上的显卡驱动,解决硬盘读得慢、网络慢,管理一大群服务器。
搬家时把锅碗瓢盆装进纸箱,到了新家打开就能做饭。可新家有没有通燃气、水压够不够,纸箱管不了。Docker 装的是软件,驱动、硬盘、网络属于房子本身。
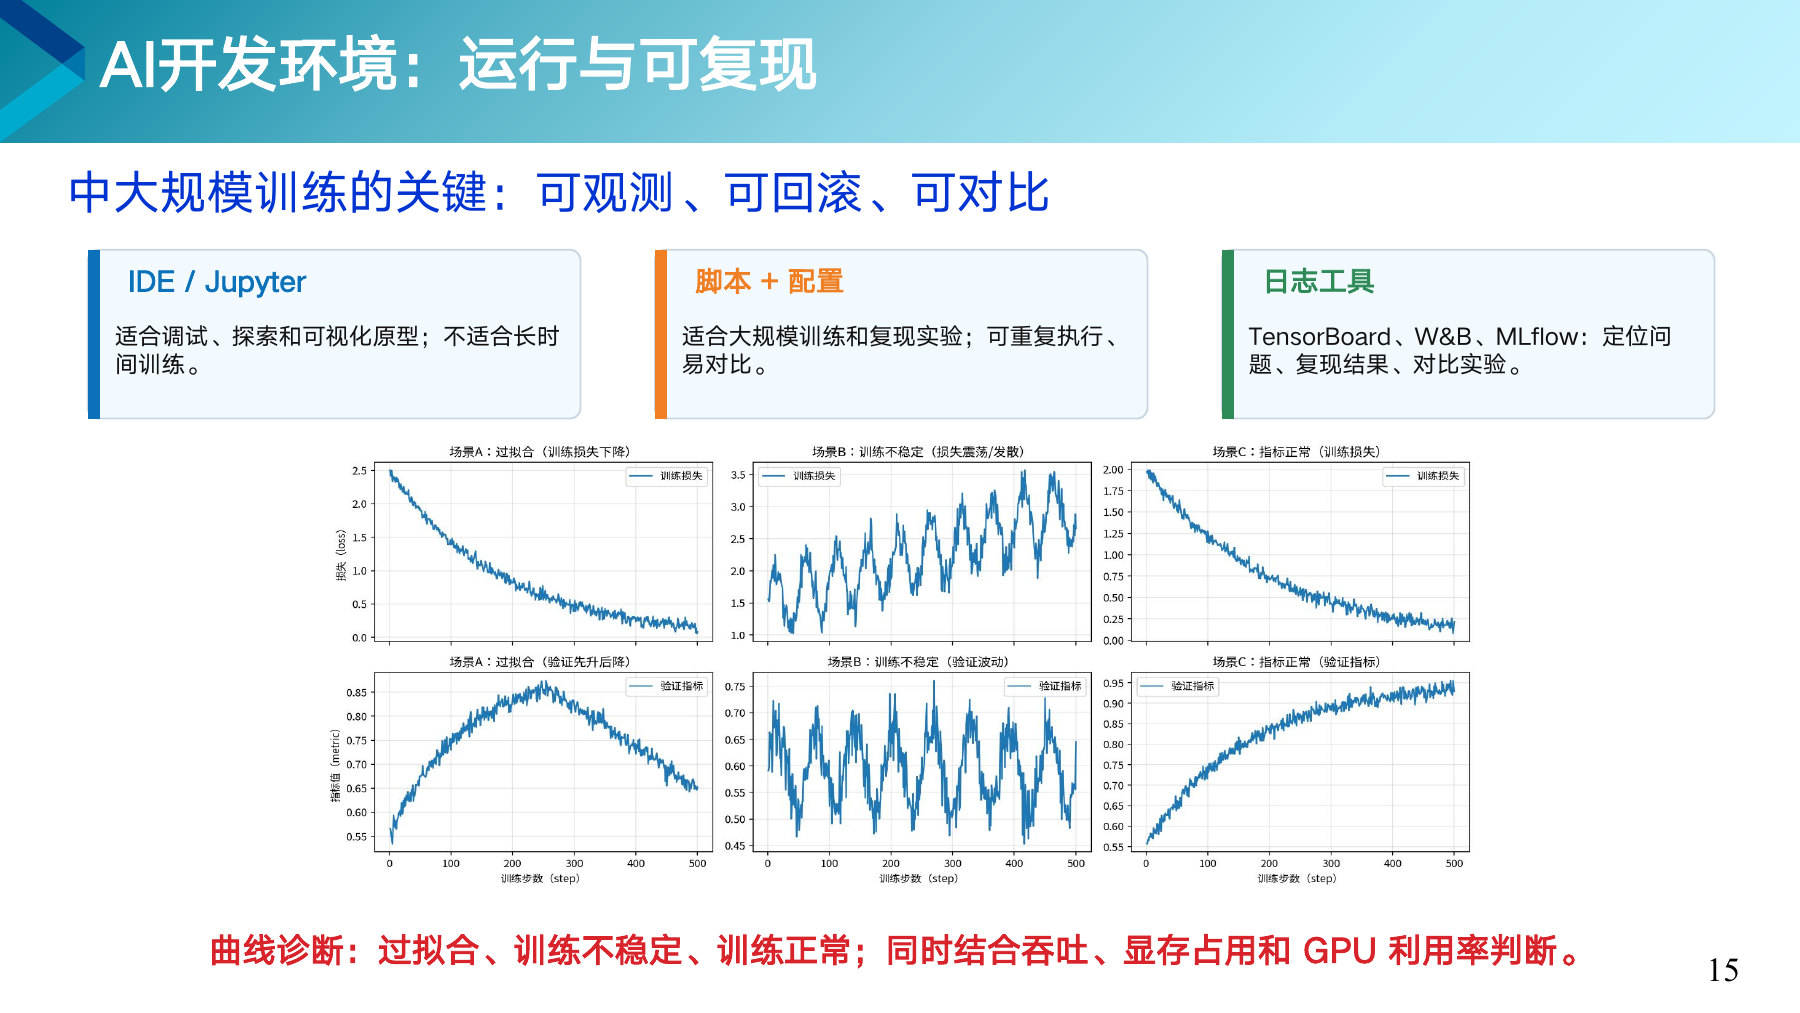
长时间训练要看得见过程,还要能对比、能回退。

上排是训练损失,下排是验证指标。左列损失一路下降,验证指标却先升后降,这是过拟合。中列两条线都乱跳,是训练不稳定。右列是正常的样子。
训练损失一直在下降,验证指标却从某一轮开始变差,最可能是什么情况?
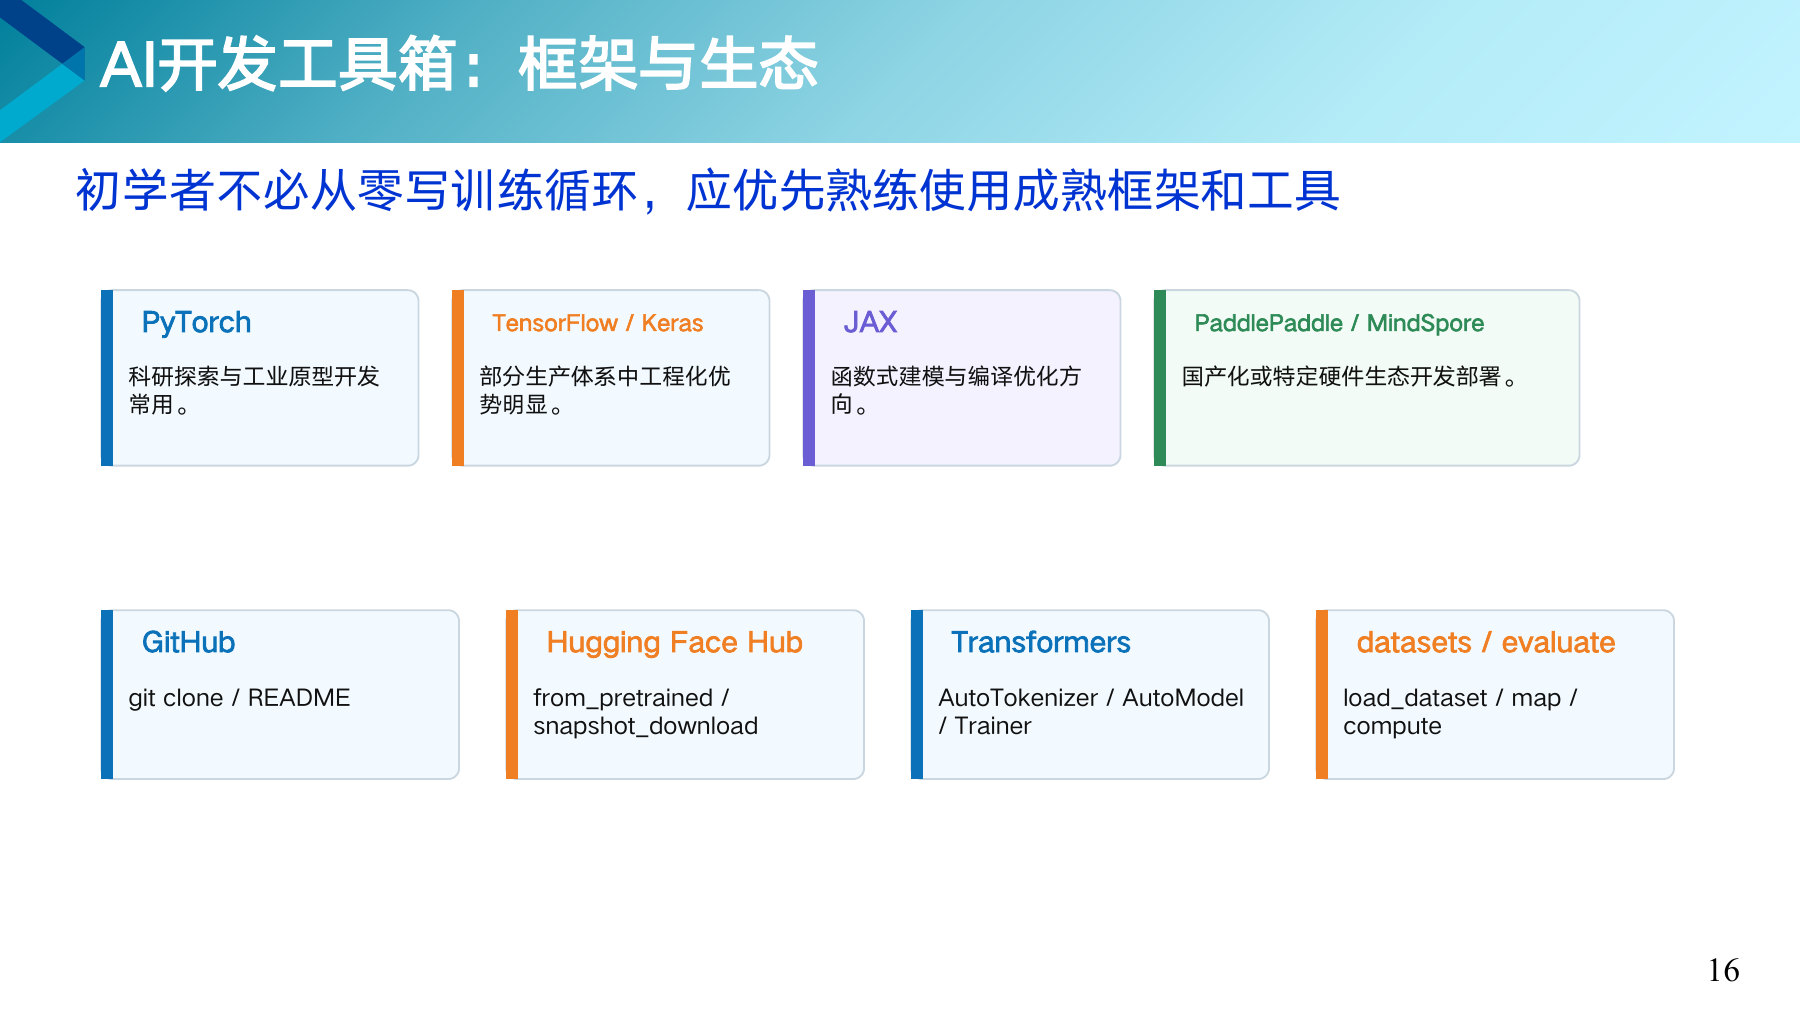
初学者先学会用现成的框架和模型。

PyTorch 由 Facebook(现在的 Meta)推出,TensorFlow 和 JAX 出自谷歌,飞桨来自百度,昇思来自华为。
做饭不必从种菜开始,买来洗好切好的菜,自己专心调味就行。框架和预训练模型就是现成的菜。
先用最小的规模把整条路走通,再慢慢加码。
先用一百条数据、训两三轮,把整条路走一遍。这一步不追求效果,只看数据读得进来、程序不报错、指标算得出来。路通了再上全部数据,出了错要查的范围小得多。
照着新菜谱做菜,第一次别请十桌客人。先做一小份尝尝,火候和调料都对了,再放开手做。