第 6 章 · 第四节
决策:从候选路径到当前动作
计划给出一整条路,决策回答此刻先迈哪一步。
重 点规划和决策的区别
规划排出整条路线。决策只管眼前这一步,在几个都能做的动作里挑出最合适的一个。班会的人数统计完以后,订教室和申请经费都能做,决策要选出先做哪一件。
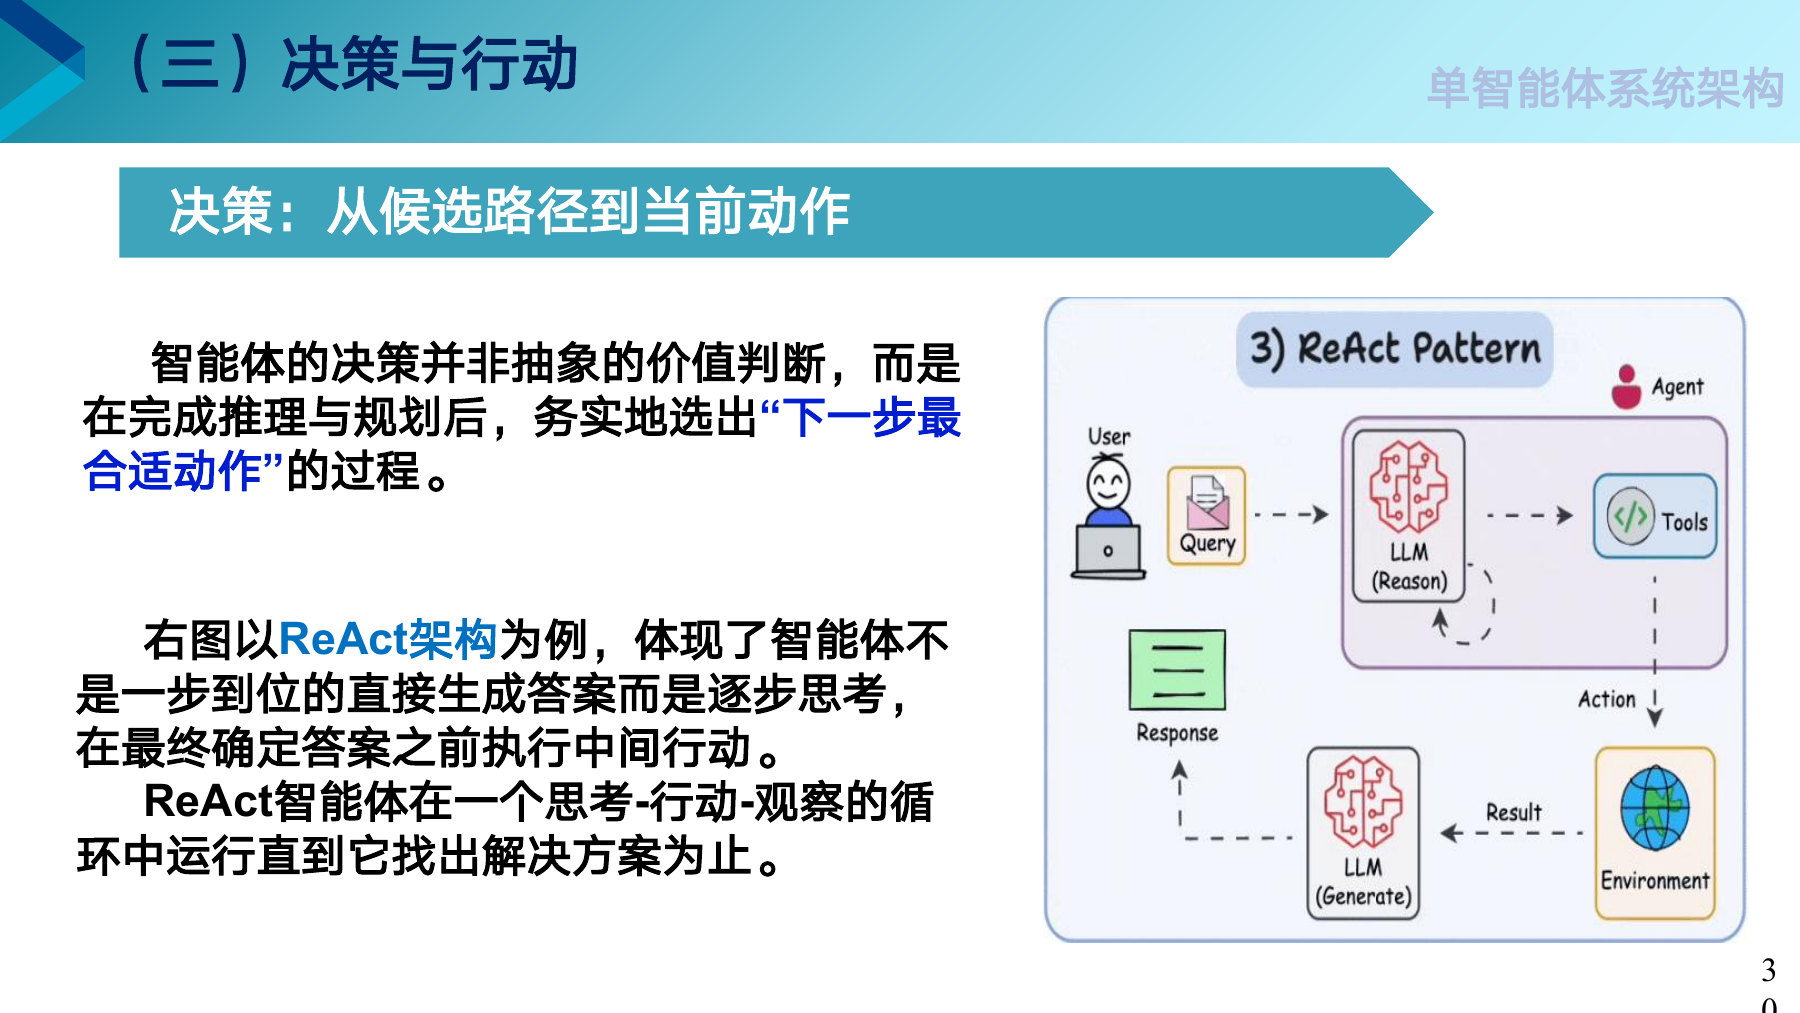
知道更多右图就是第 21 页讲过的 ReAct
用户提出问题,模型先推理,再调用工具,拿到结果后接着推理,这样循环下去,直到找出解决办法,最后由模型生成回答。每转一轮,都要做一次决策。
计划给出一整条路,决策回答此刻先迈哪一步。
规划排出整条路线。决策只管眼前这一步,在几个都能做的动作里挑出最合适的一个。班会的人数统计完以后,订教室和申请经费都能做,决策要选出先做哪一件。
用户提出问题,模型先推理,再调用工具,拿到结果后接着推理,这样循环下去,直到找出解决办法,最后由模型生成回答。每转一轮,都要做一次决策。
决策回答做哪一步,行动回答怎样把这一步落到实处。
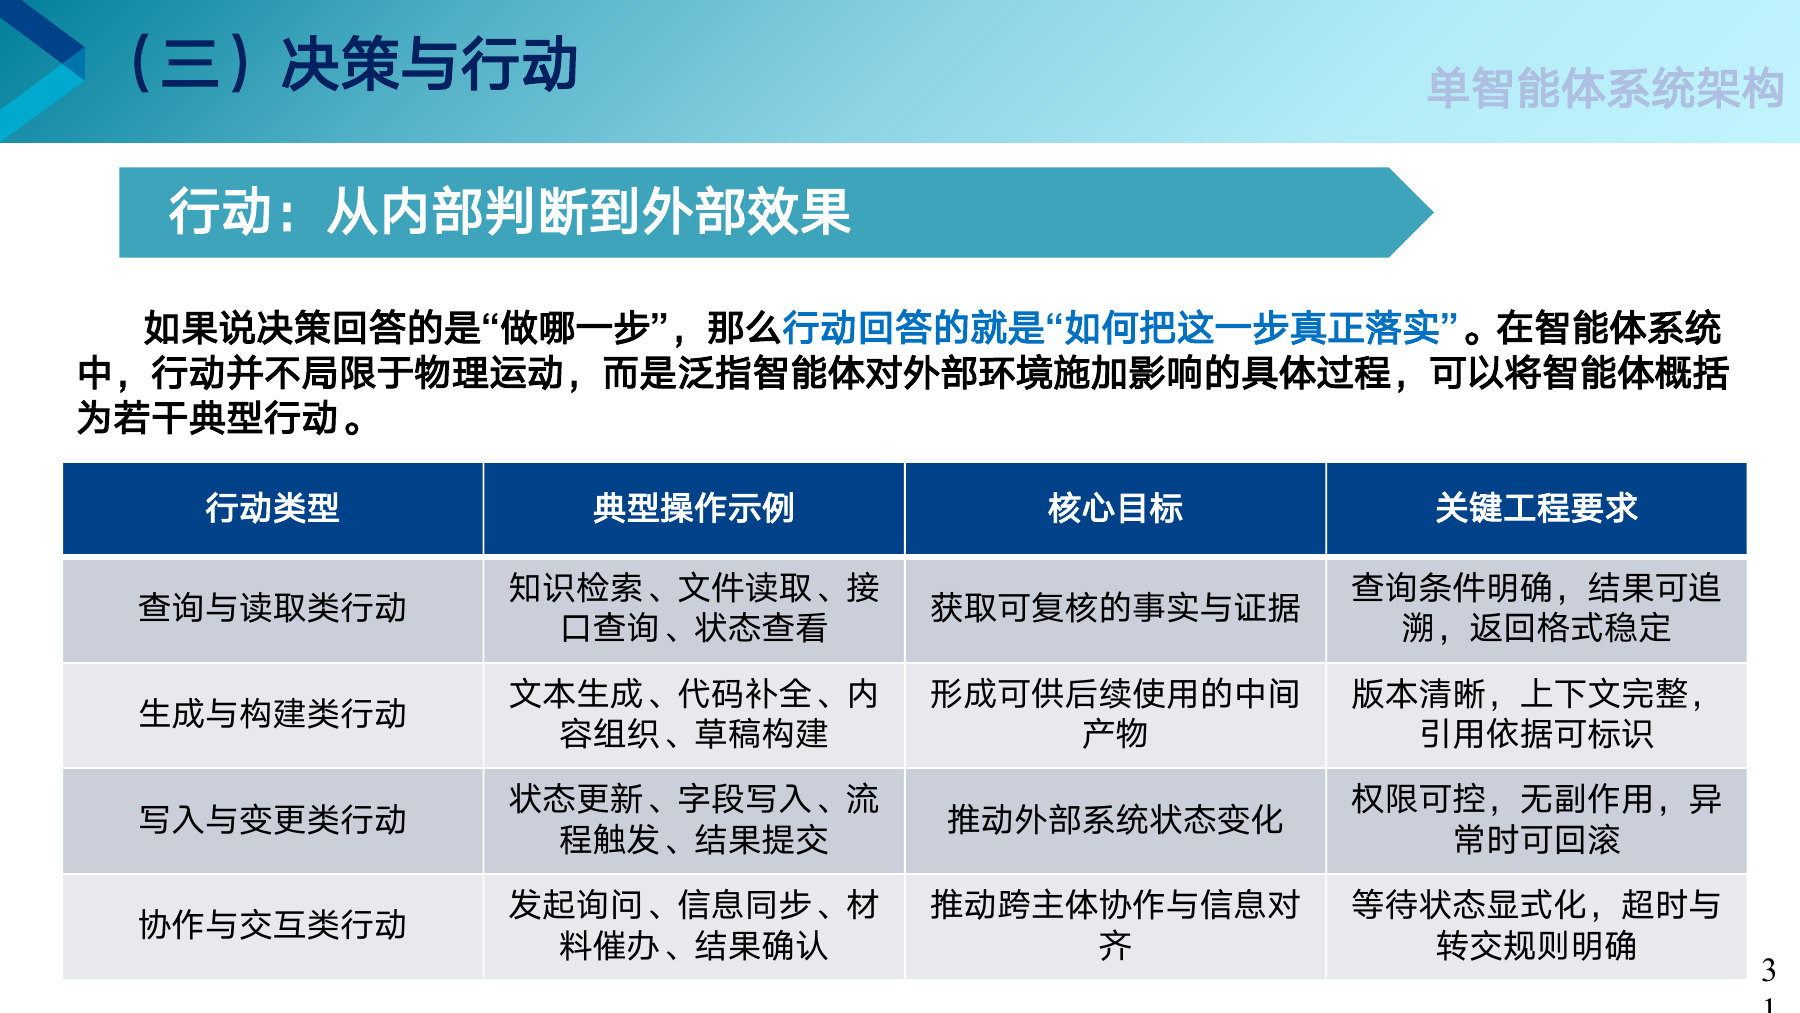
用办班会对一遍。查询读取:查课表、查报名人数。生成构建:写好班会通知的草稿。写入变更:提交教室申请和经费申请。协作交互:在群里催还没报名的同学,等辅导员确认。
前两类只是读资料、写草稿,出错了重写就行。写入变更类会改动别人的系统,比如占掉一间教室、花掉一笔钱,所以要控制权限,出错时还要能撤回。
下面哪个动作属于“写入与变更类”?
决定做什么以后,先要把它写成机器能执行的一张单子。
动作类型 提交借用申请
目标对象 教务处的教室借用系统
参数 下周三、19:00 至 20:30、402 教室、38 人
动作类型 抓取,再移动
目标对象 桌子左边那只蓝色杯子
参数 杯子的位置、手爪张开多大、用多大的力
去奶茶店说“来一杯好喝的”,店员没法做。说“一杯中杯珍珠奶茶,少冰,三分糖”,店员马上就能做。后一种说法就是动作表示。
动作要有人管着执行,出了错要能兜住。
| 管什么 | 订教室时的例子 |
|---|---|
| 权限 | 借用教室可以直接提交,交押金、付钱必须先问班长 |
| 异常 | 教务系统没有响应,不能当作已经订好 |
| 重试 | 隔一分钟再提交一次,最多试三次,还不行就告诉班长 |
| 回执 | 拿到“预订成功,编号 0927”才算这一步完成 |
Harness 原意是套在马身上的挽具。有了它,马的力气能用来拉车,马也不会乱跑。执行框架对模型也是这样,让它能动手,又不让它越界。
如果系统没有响应,执行控制却当成“订好了”,接下来的通知就会把一间没订到的教室发给全班。
用户说的、日志记的、环境变的,三路反馈一起看。
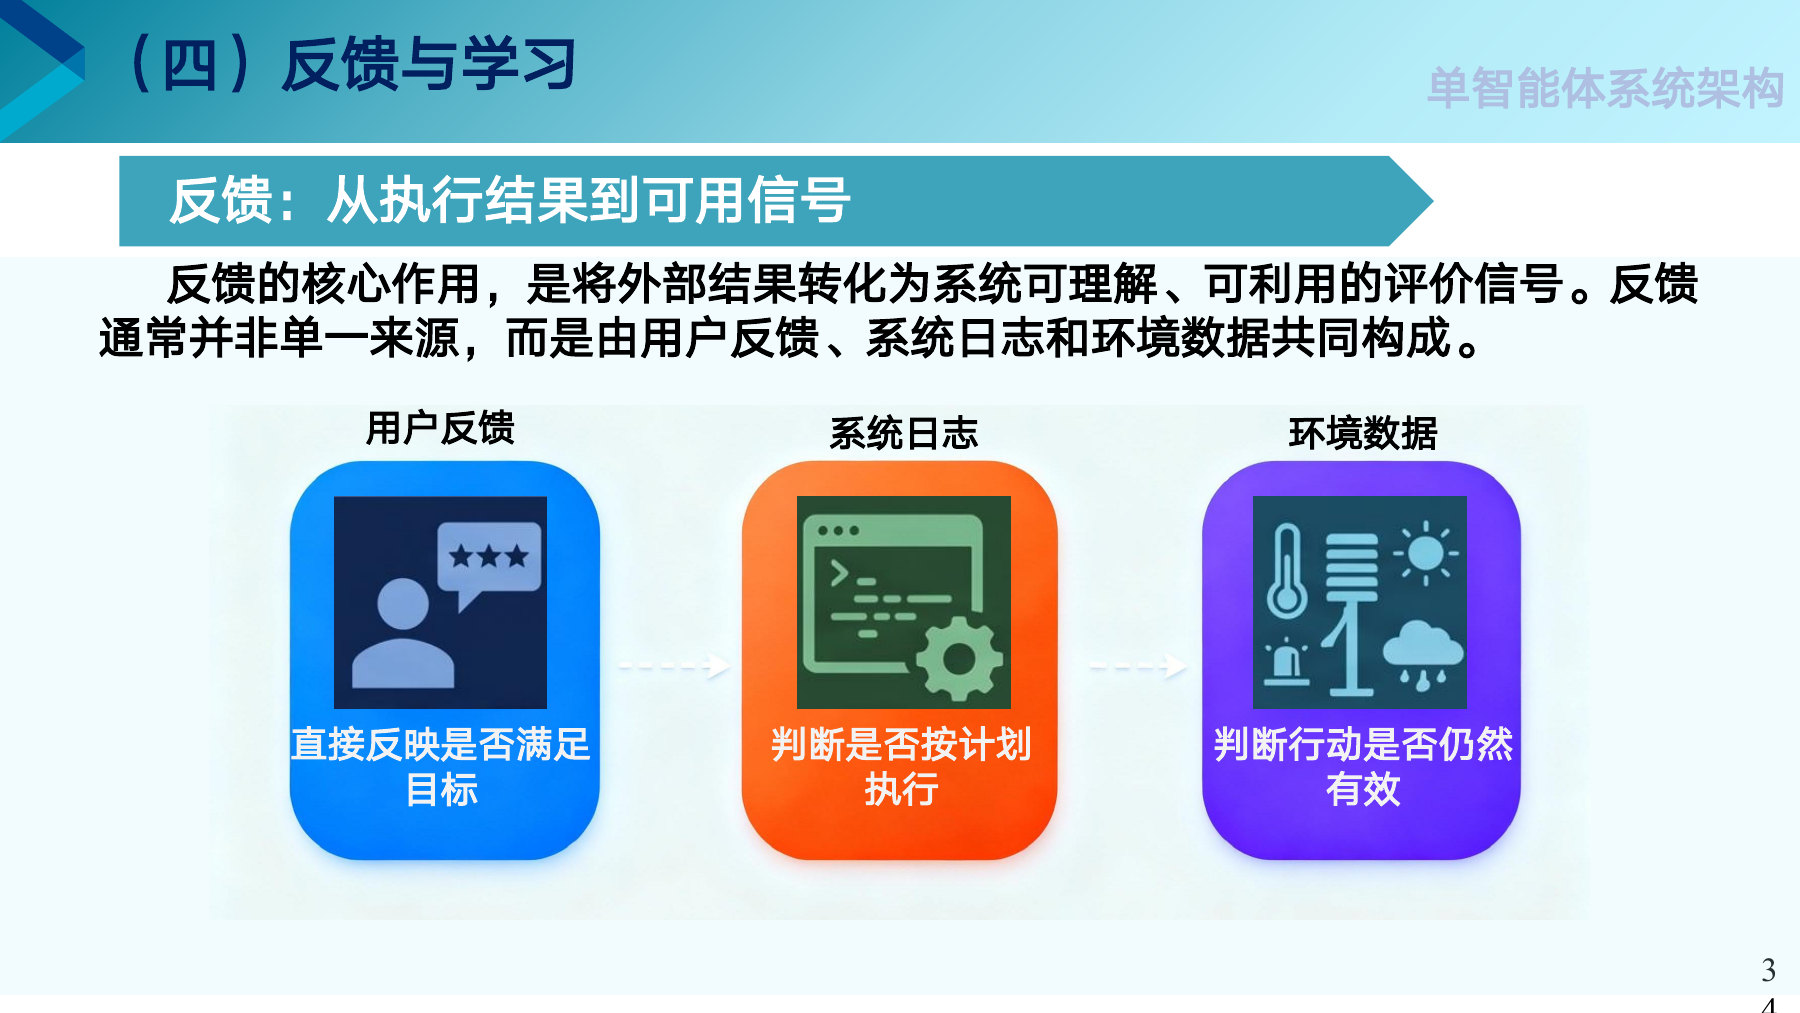
办班会时的三路反馈。用户反馈:班长说节目单太长了。系统日志:通知发给了 42 人,有 3 人没收到。环境数据:天气预报说周三有大雨,原定在操场的游戏要改到室内。
班长说满意,可能只是没细看。日志显示执行成功,可能是成功地做了一件错事。环境变了,原来对的安排也可能不再合适。三路互相印证,才知道这一步做得怎么样。
智能体从系统日志里发现有 3 位同学没收到通知。这条反馈回答的是哪个问题?
手里有标准答案时,就照着答案学。
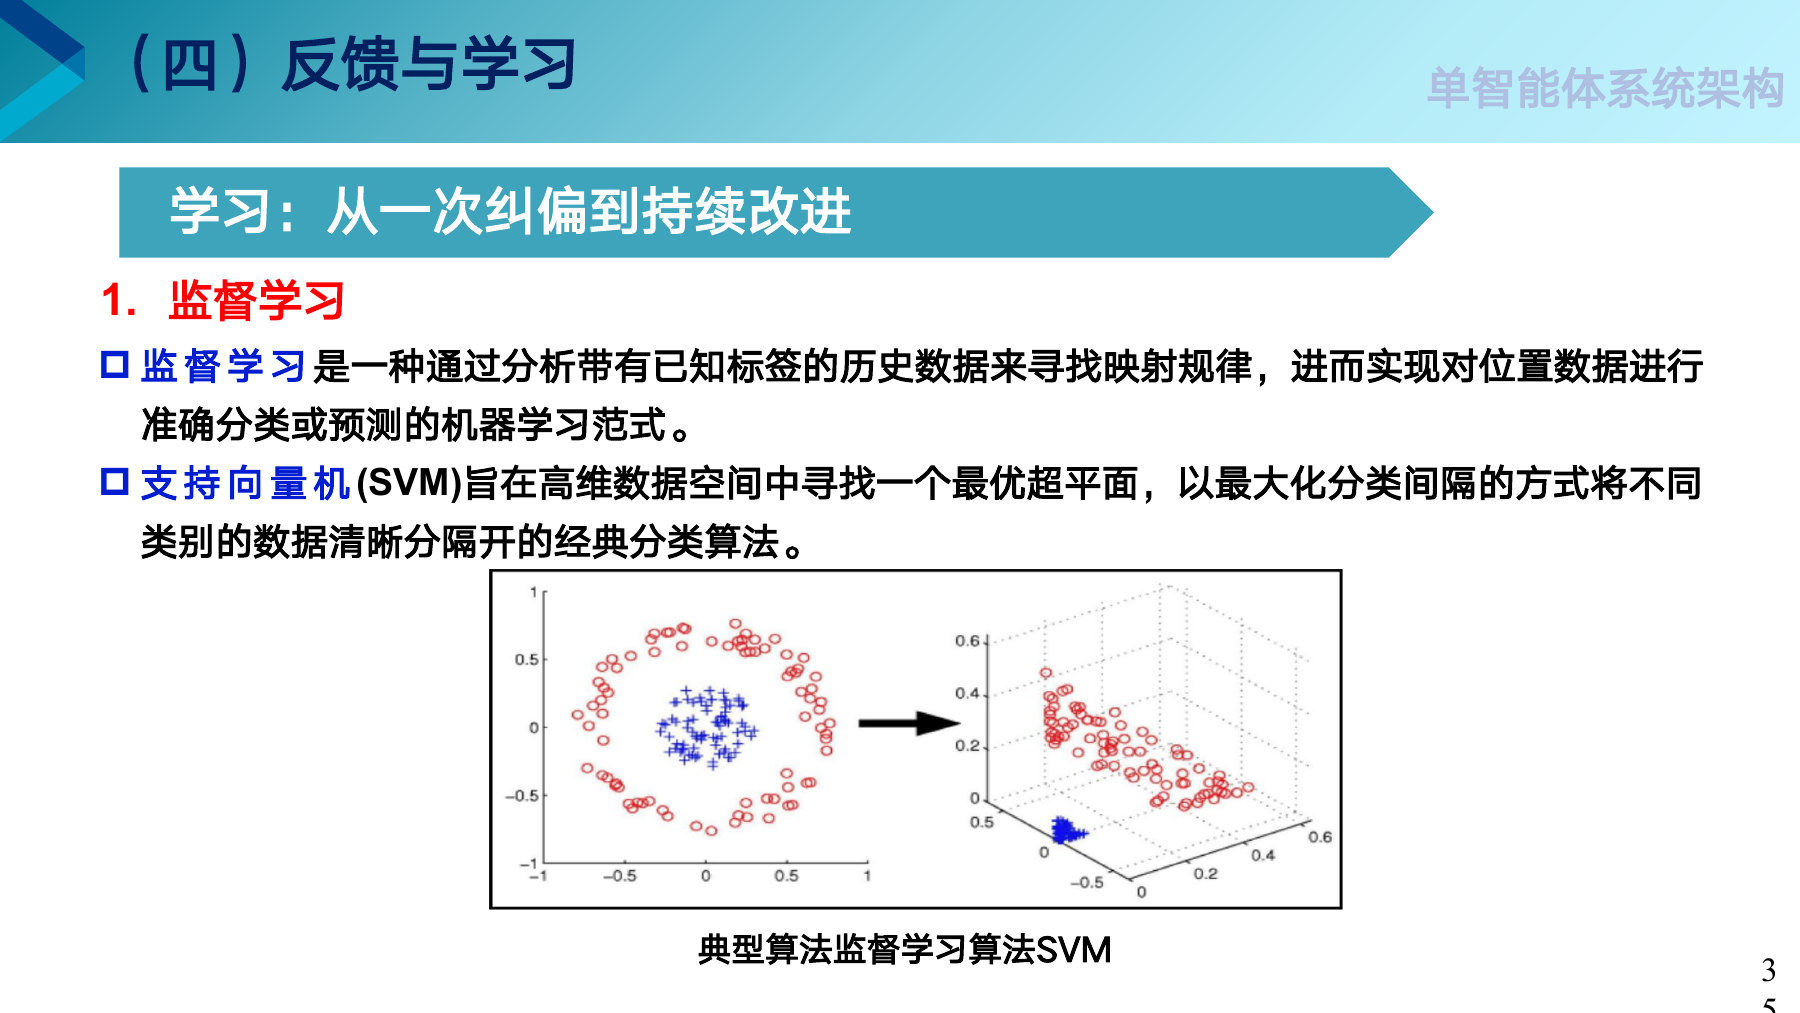
监督学习用带标签的数据来学。下图是第 3 章讲过的支持向量机:左边红点围着蓝点一圈,一条直线分不开,把数据升到三维以后,一个平面就能把它们分开。定义里的“位置数据”应为“未知数据”。
智能体每天办很多事,哪些结果被用户采纳了,哪些被退了回来,都会记在日志里。这些记录自带“对”或“错”的标签,可以拿来训练,让它下次判断得更准。
没有标准答案,就靠试错和奖励自己摸索。
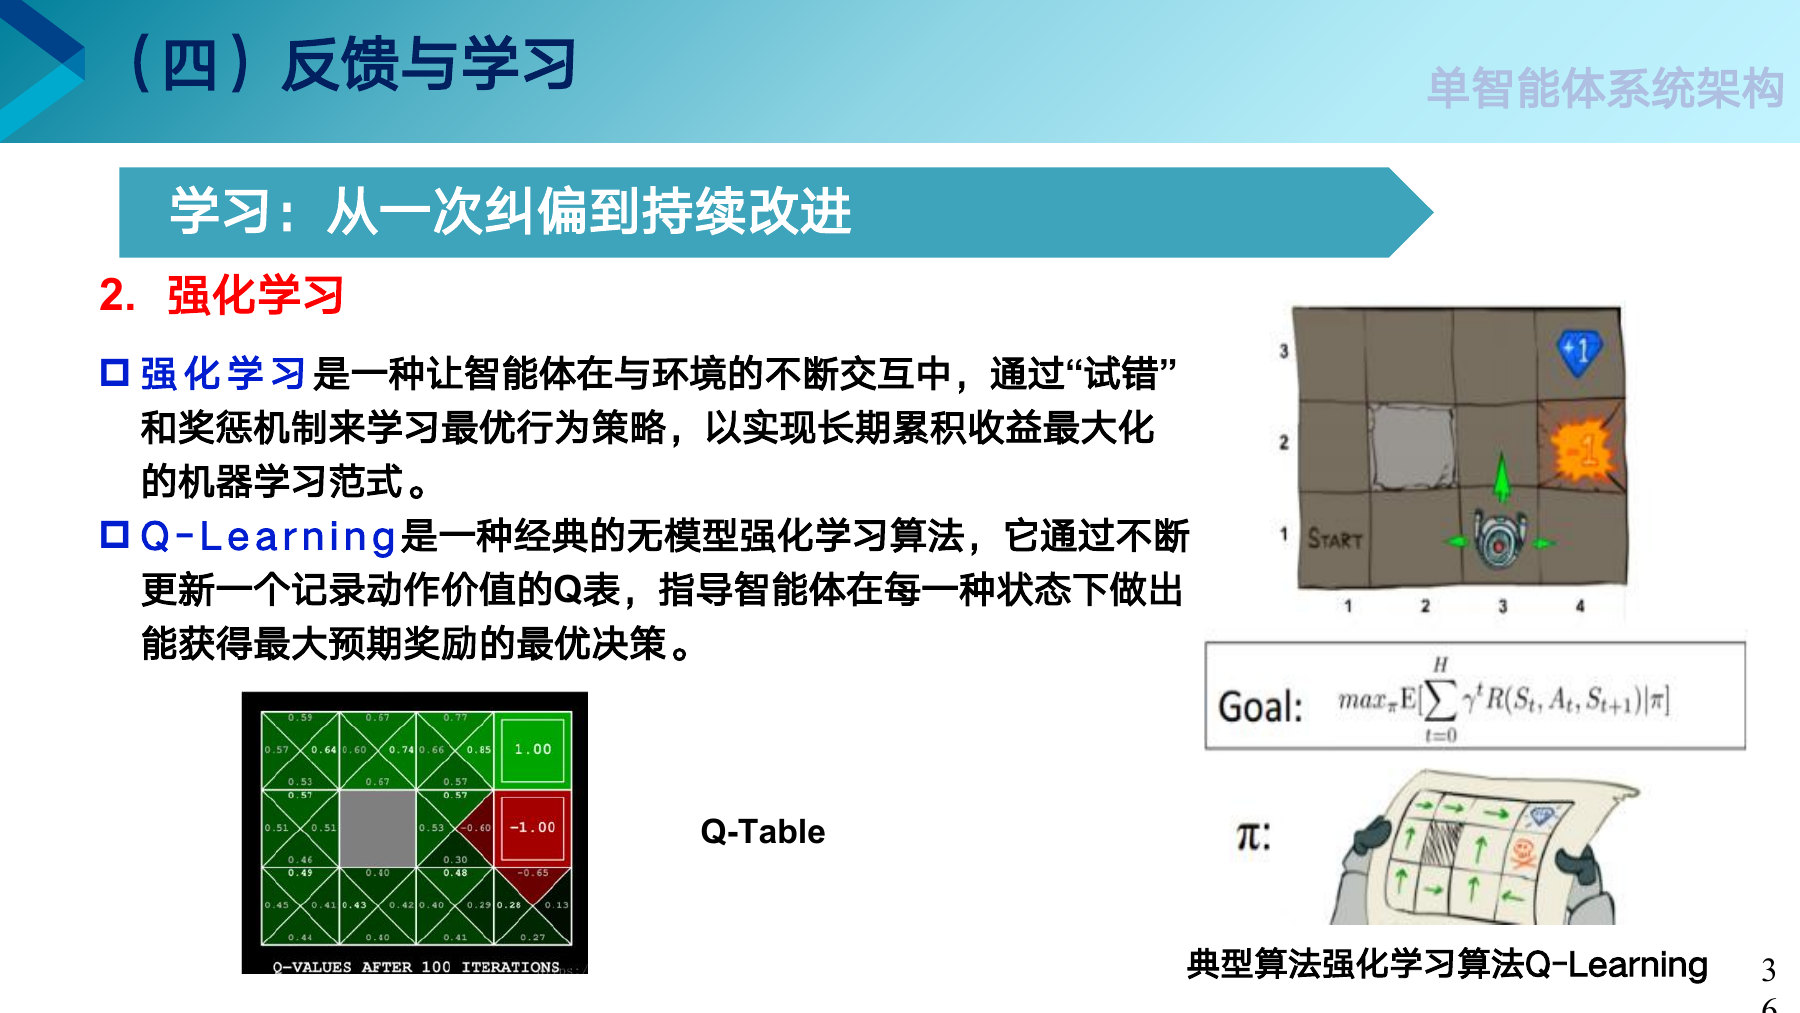
在所有策略里挑一个,让从第 0 步到第 H 步拿到的奖励打完折以后加起来,平均值最大。H 是一局最多走几步。γ 是第 3 章讲过的折扣因子,比如取 0.9,越晚拿到的奖励打折越多。
每一格被分成四个三角,各记着往上、下、左、右走的价值。走了 100 轮以后,靠近右上角宝石(加 1 分)的格子数值高,靠近火焰(减 1 分)的格子数值低,路线自然就显出来了。
没有标签,就让算法自己看出数据分成几堆。
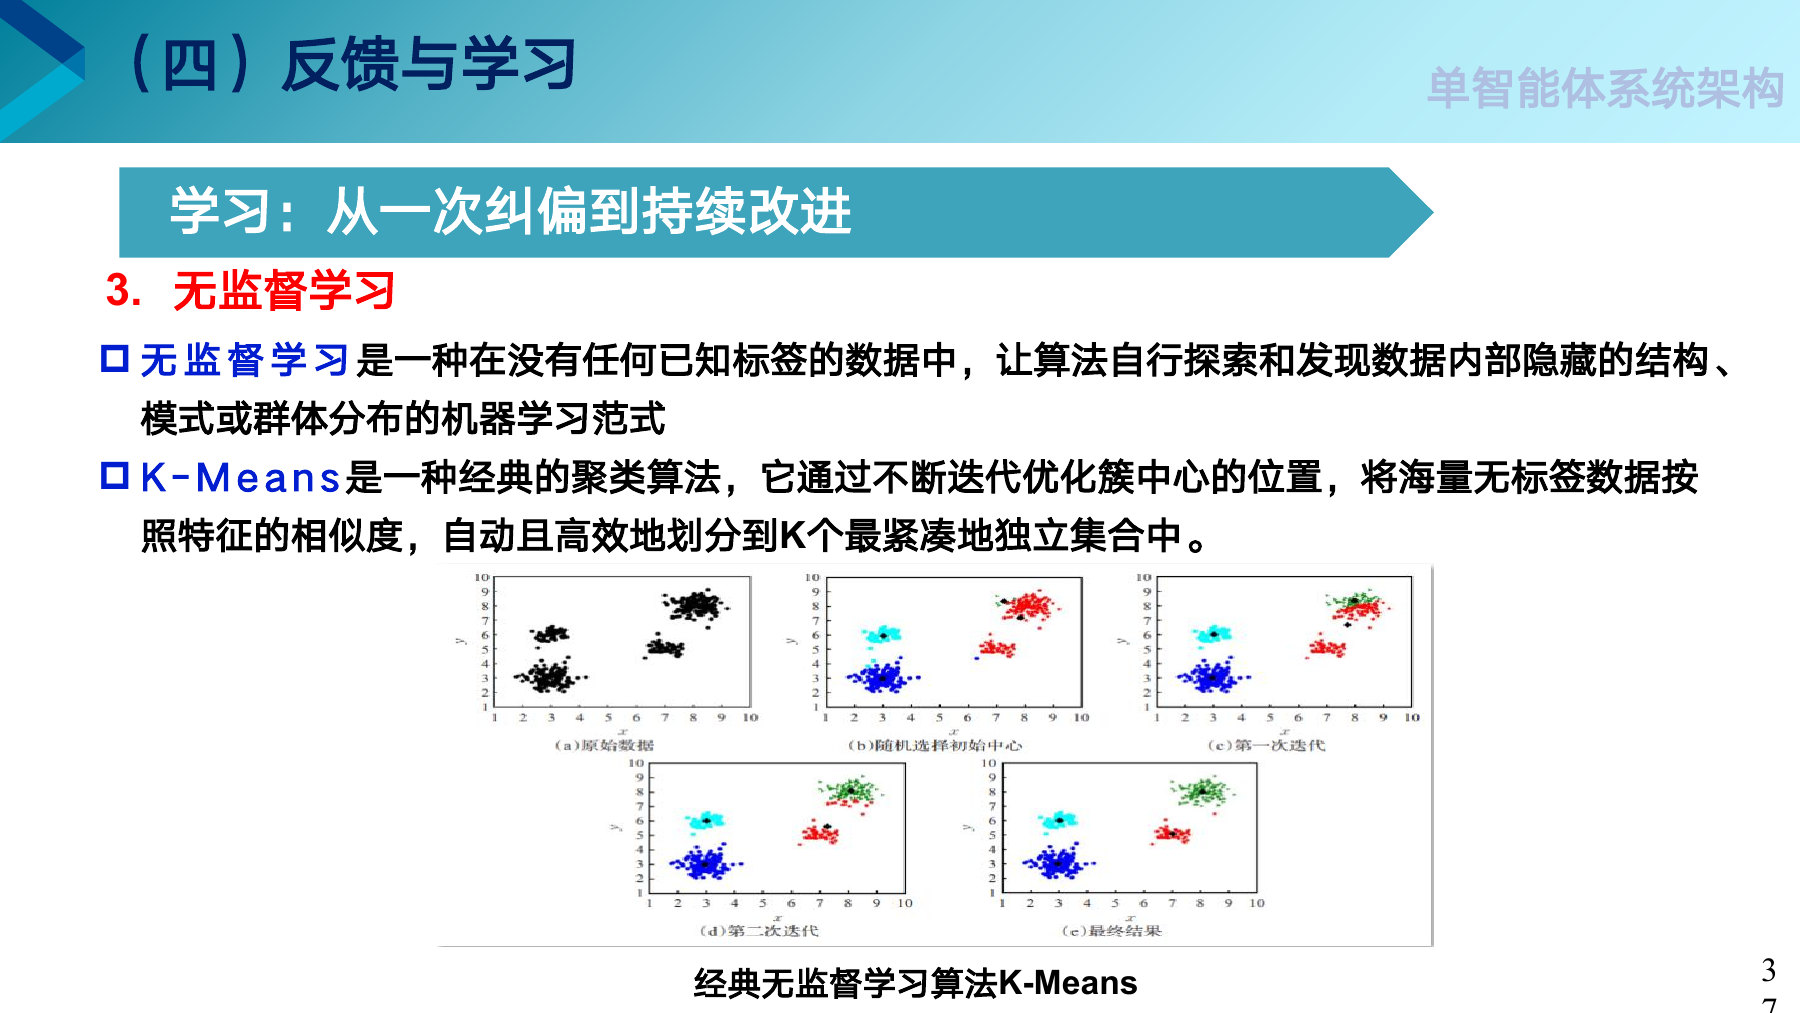
依次是原始数据、随机选初始中心、第一次迭代、第二次迭代、最终结果。每一轮先让每个点归到离它最近的中心那一组,再把中心挪到这组点的正中间,中心不再动了就停下。第 3 章实验三做过同样的事。
智能体收到过上万条用户请求,没有人给它们分过类。用 K-Means 分一分,可能发现一大半都在问课表和作业,就可以给这几类请求准备专门的工具。
K-Means 为什么属于无监督学习?
学过的本事搬过来用,不必每次从零开始。
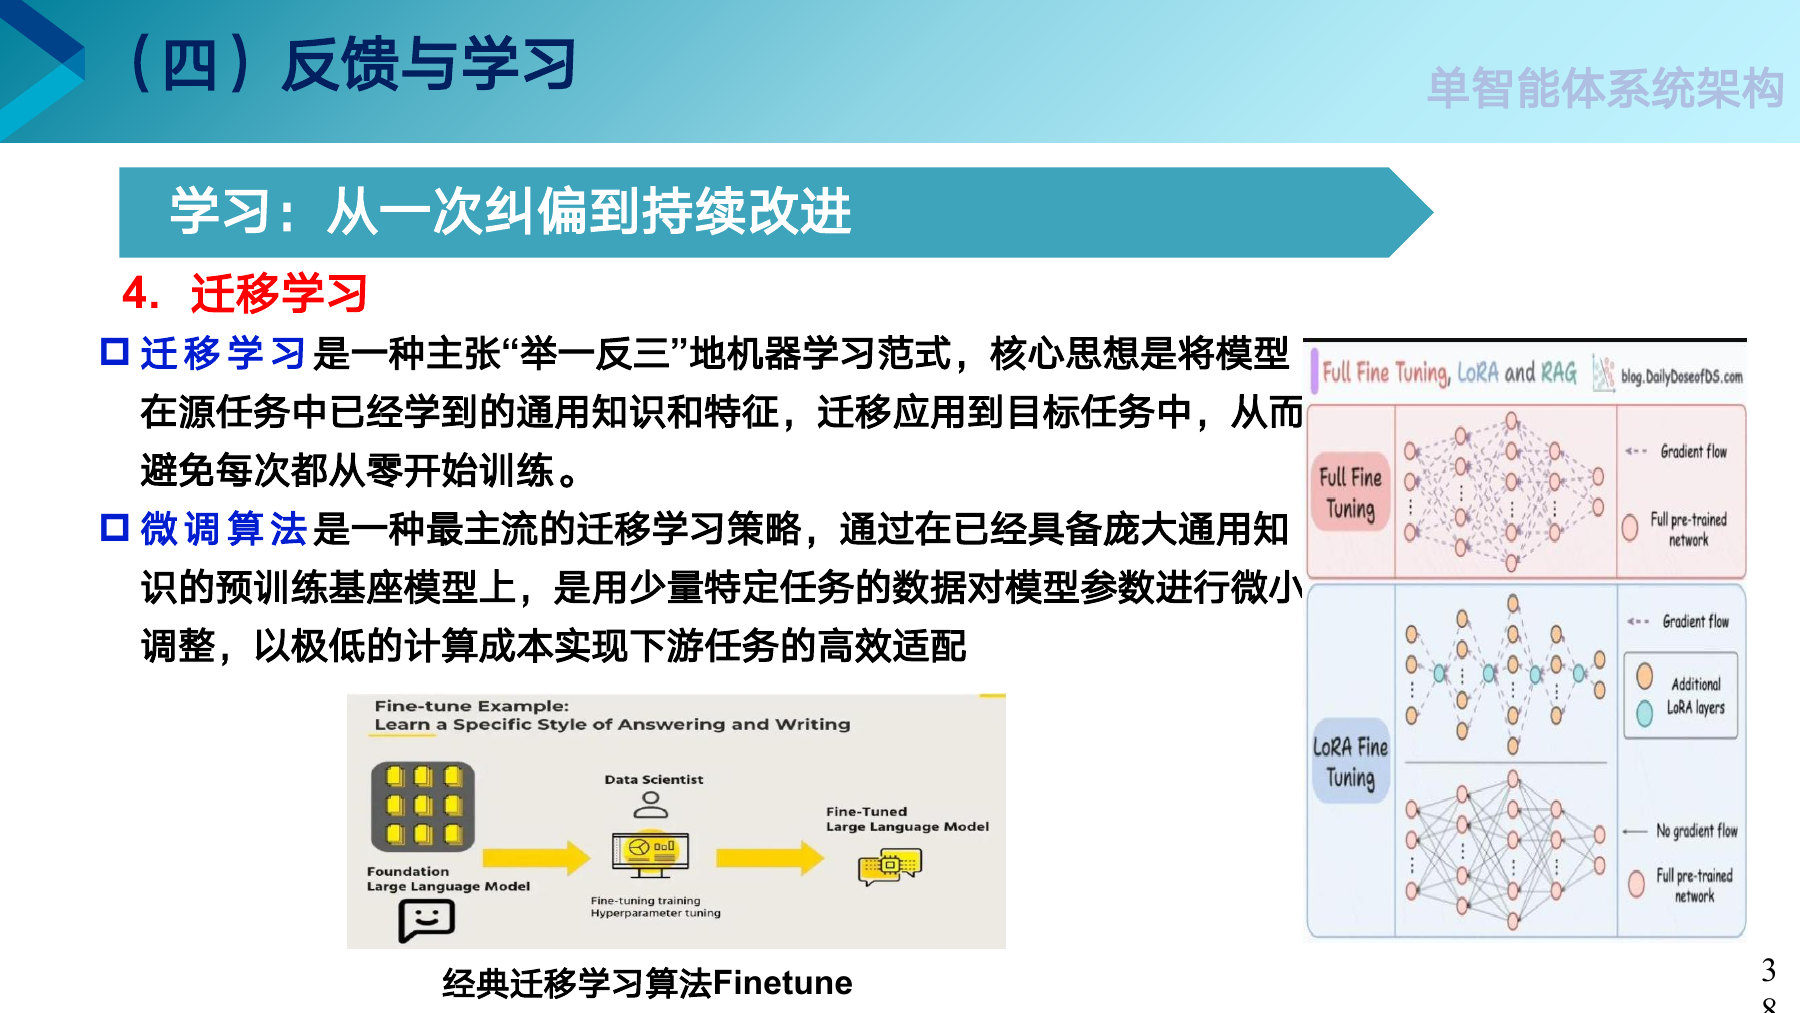
上面是全参数微调,整个网络的参数都跟着改,效果好但很费算力。下面是 LoRA,原网络不动,只训练旁边新加的一小块,省下大量算力,效果往往相差不多。
元学习练的是快速学会新任务的本事。
盯着一个任务反复练,练成以后这个任务做得很好。换一个新任务,往往要从头练很久。
在很多个不同的小任务上轮流练,找一个离每个任务都不远的起点。新任务来了,调一两步就能上手。
新生学会了记笔记、查资料、安排时间这些通用的学习方法,以后不管遇到哪门新课,都能很快上手。元学习练的就是这种上手快的本事。
元学习的目标最接近下面哪一项?