人工智能导论 第 6 章 · 第二节
课程 › 第 6 章 › 第二节 认知中枢三大能力Gemini一体化模型感知泛化长序列规划ReAct
第 6 章 智能体系统 · 第二节

智能体与大语言模型

大模型负责想,运行时系统负责做
本 节 知 识 点
  1. 14大语言模型是认知中枢
  2. 16大模型拓展智能体的三大能力
  3. 17以 Gemini 为例看大模型智能体
  4. 18一体化感知决策行动大模型
  5. 19大模型提升感知泛化性
  6. 20多阶段任务规划与 VLA
  7. 21ReAct 范式与思维树
14
第 6 章 · 第二节

大语言模型是认知中枢

大模型负责想,运行时系统负责做,两者合起来才是智能体。

第 14 页 大模型是认知中枢

智能体 = 大语言模型 + 运行时系统

大语言模型:负责想

听懂意思,问清意图,推理分析,拆出计划,选择工具,把结果说清楚。

运行时系统:负责做

记住进度,实际去调用工具,检查结果对不对,处理出错、权限和安全问题。

办班会时的一件事谁来做
弄清“下周”指哪几天、要不要请班主任大语言模型
想出八件要办的事,排好先后大语言模型
打开教务系统,提交教室借用申请运行时系统
记住“通知已发出,报名 38 人”运行时系统
申请被拒以后换一间教室再申请两者配合
只有大模型时,它的回答可能出错,记不住长任务办到了哪里,也处理不了出错、权限这些问题。所以要在外面配一套运行时系统。

重 点为什么叫认知中枢

中枢就是指挥中心。理解意思、推理分析、制定计划都是动脑的事,交给大模型。想好以后,动手的部分交给运行时系统。

关键术语

意图澄清Intent Clarification
弄清用户到底想要什么。话没说清时,先问一句再动手。

打个比方

大模型像一位很聪明的参谋,能想清楚整件事该怎么办,可他没有手,也不记账。运行时系统像他身边的助手,负责跑腿、记账、核对。
16
第 6 章 · 第二节

大模型拓展智能体的三大能力

有了大模型,智能体看得更全,想得更深,做得更远。

第 16 页课件

重 点三处增强

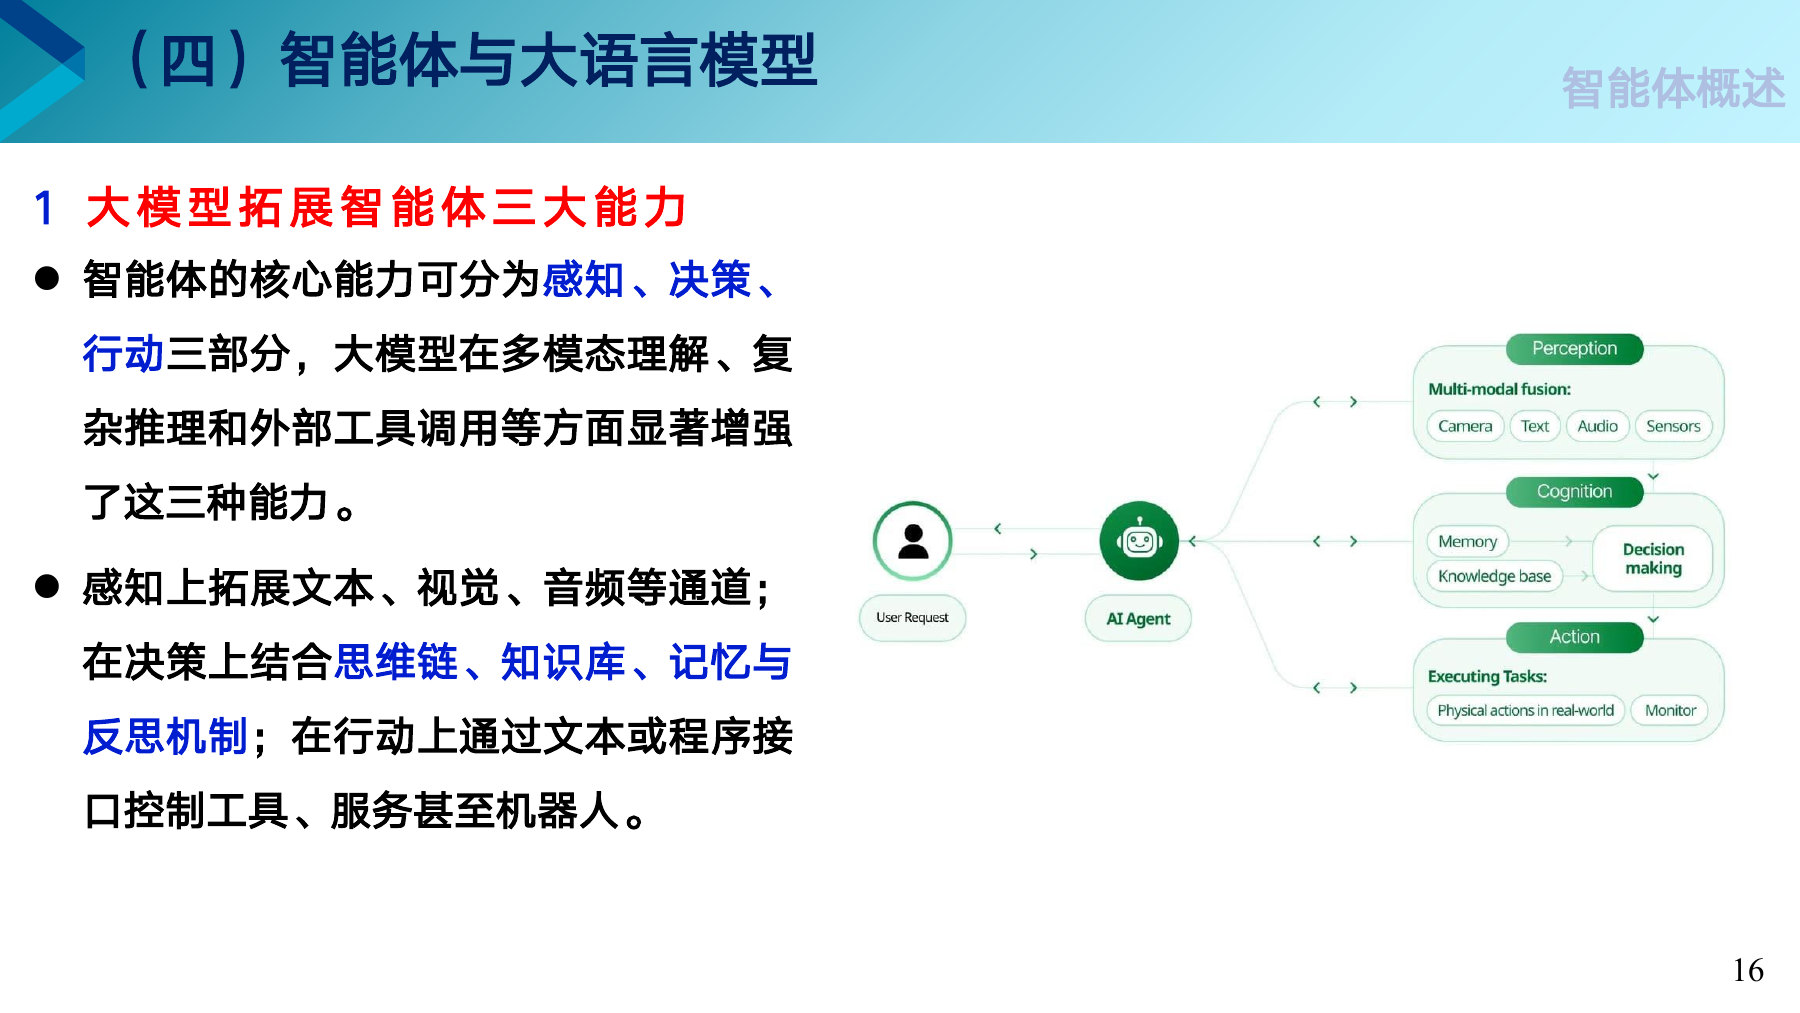
感知上,除了文字,还能看图片、听声音。决策上,会一步步推理,会查知识库,还能参考以前的记忆。行动上,能通过接口(软件留给别的程序调用的入口)去操作软件,甚至控制机器人。

关键术语

多模态Multimodal
同时处理文字、图像、声音等多种形式的信息。
思维链Chain of Thought
把推理过程一步步写出来再下结论。第 5 章讲过,本章第 27 页还会用到。

随堂练习

智能体记得“班长上次说过不要订周五”,于是没有订周五的教室。这用到了三大能力里的哪一项?

  1. 感知
  2. 决策
  3. 行动
  4. 都没有用到
查看答案
答案 B。记忆属于决策这一部分,它让智能体做决定时能参考以前的经验。感知是获取眼前的信息,行动是对外界动手。
17
第 6 章 · 第二节

以 Gemini 为例看大模型智能体

谷歌把智能体分成三类,其中一类按事先画好的流程走。

第 17 页 以 Gemini 为例

谷歌的智能体开发工具包 2025 年发布时,把智能体分成三类

类型谁决定下一步适合什么活
大模型智能体大模型自己判断步骤说不准、要随机应变的任务
工作流智能体事先画好的流程步骤固定、每次都一样的任务
自定义智能体开发者写的程序有特殊规则的任务
顺序执行定时间发通知统计人数一件接一件同时执行统计人数订教室申请经费两件事一起推进循环执行排节目单班长审阅定稿不满意满意不满意就重来一遍
工作流智能体又分三种:一件接一件地做,几件同时做,循环着做。上图用办班会里的几件事各举一例。

知道更多Gemini 和 Gemini CLI

Gemini 是谷歌的大语言模型系列,Gemini 2.5 在 2025 年推出。Gemini CLI 是谷歌同年开源的命令行智能体,在靠打字输入命令的终端窗口里,就能让它读文件、写代码、上网搜索。

关键术语

智能体开发工具包Agent Development Kit, ADK
谷歌在 2025 年开源的一套搭建智能体的程序工具,左边的三类是它发布时的分法。

重 点简单题少想,难题多想

Gemini 2.5 能按问题的难易决定花多少计算量去想,这种做法叫动态算力调度。第 5 章讲过的快思维和慢思维,在产品里就是这样用上的。

18
第 6 章 · 第二节

一体化感知决策行动大模型

与其分四段接力,不如用一个网络从输入直接算到动作。

第 18 页 一体化感知决策行动大模型

四段流水线,还是一个网络直接到底

流水线:四个模块各自训练,前一段的输出交给后一段摄像头感知对 95%预测对 95%规划对 95%控制对 95%方向盘四段全做对:95% × 95% × 95% × 95% ≈ 81%一体化:一个网络从画面直接算到动作摄像头一个端到端的大模型方向盘
假如每段都有 5% 的情况出错,错误又会一路传下去。100 次里,第一段做对 95 次,其中第二段又只做对 95%,约 90 次,四段下来约 81 次全对。一体化模型省掉了中间交接,这种累积也就少了。
自动驾驶领域的 UniAD、机器人领域的视觉语言动作模型,走的都是这条路。

关键术语

端到端End-to-End
从最开头的输入直接学到最末尾的输出,中间不拆成人为设计的几段。
视觉语言动作模型Vision-Language-Action, VLA
看图像、听指令,直接输出机器人动作的模型,第 5 章提到过。
UniADUnified Autonomous Driving
2022 年底提出的自动驾驶模型,把感知、预测、规划放进一个网络,2023 年获计算机视觉会议 CVPR 的最佳论文。

打个比方

传话游戏里,一句话经过四个人转述,每个人都走一点样,传到最后可能面目全非。让第一个人直接对最后一个人说,就不会层层走样。

19
第 6 章 · 第二节

大模型提升感知泛化性

见过的东西够多,没见过的场景也能应付。

第 19 页课件

重 点什么是泛化,右图怎样读

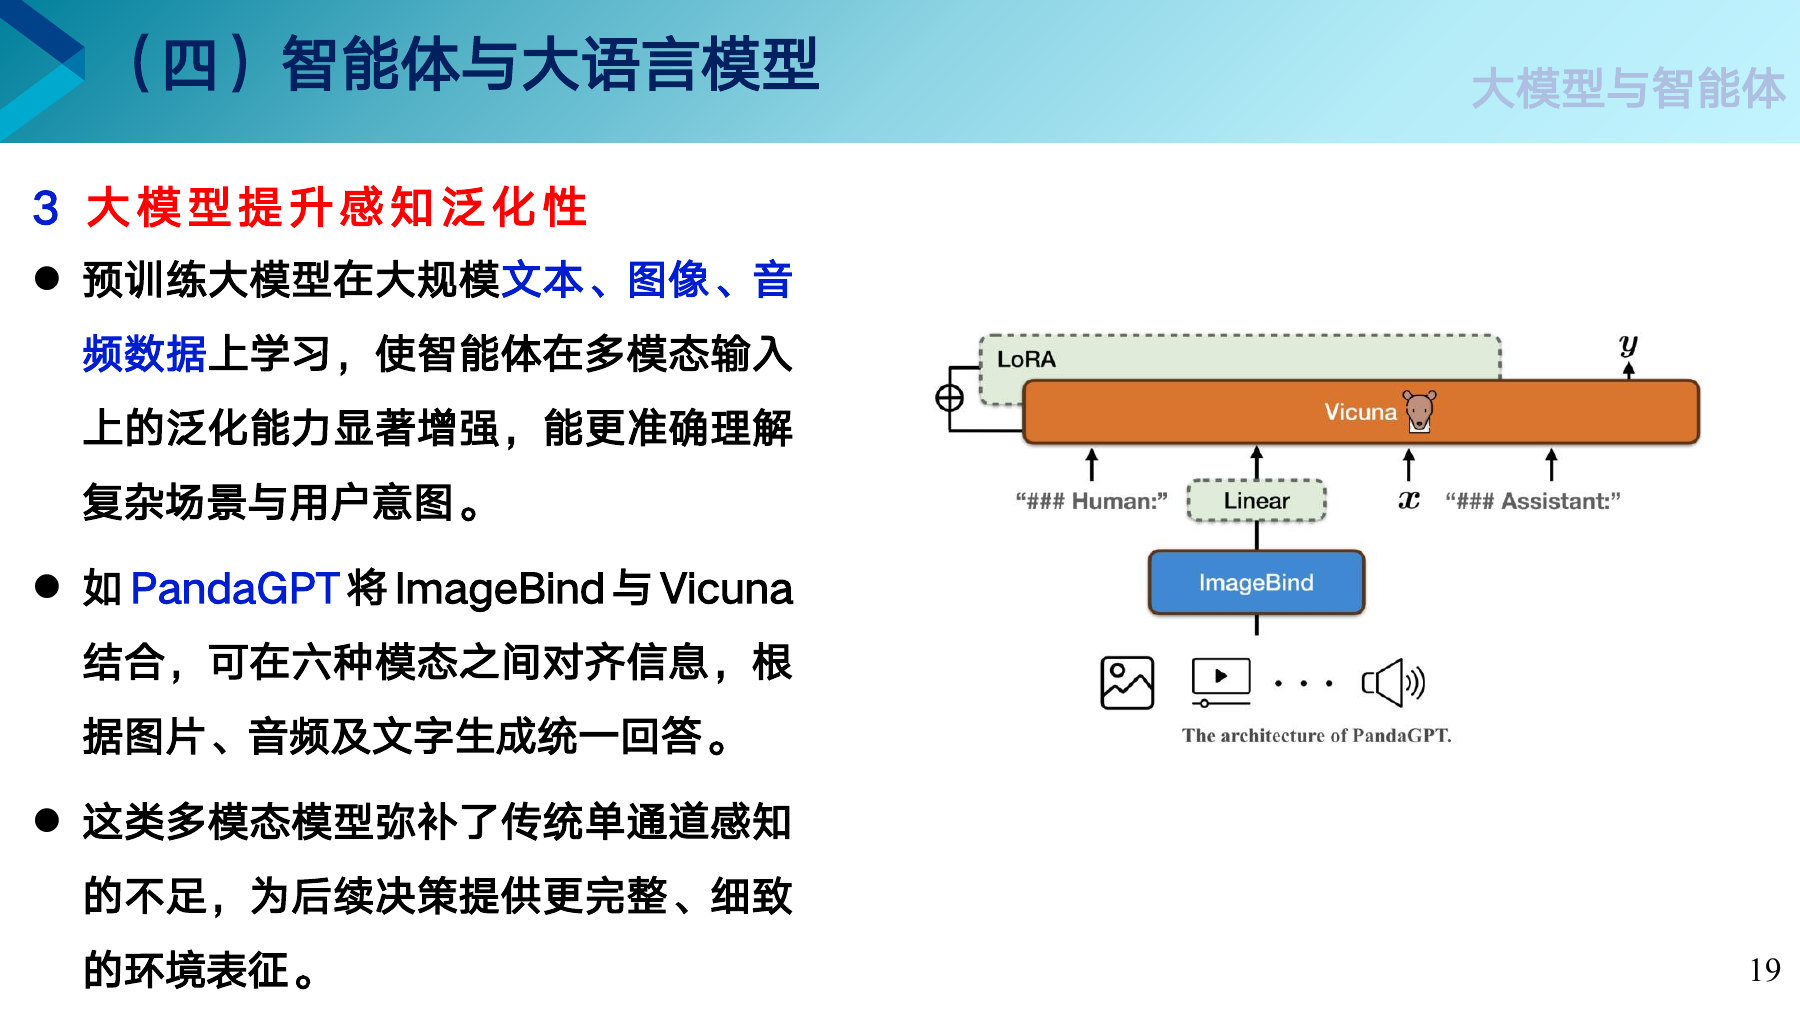
泛化指的是在没见过的新情况上也能做对。右图里,图片、声音等信号先交给最下面的 ImageBind,翻译成同一种内部表示,再经过一个叫 Linear 的小转换层把格式对齐,交给上面的 Vicuna 写出回答。

关键术语

ImageBindImageBind
Meta 在 2023 年发布的模型,能对齐图像、文字、声音等六种信号。
VicunaVicuna
一个开源的聊天大模型。
LoRALow-Rank Adaptation
一种省力的微调方法,第 38 页会讲到。
20
第 6 章 · 第二节

多阶段任务规划与 VLA

机器人要做好一连串动作,先得把步骤排好。

第 20 页课件

重 点看懂、听懂、去执行

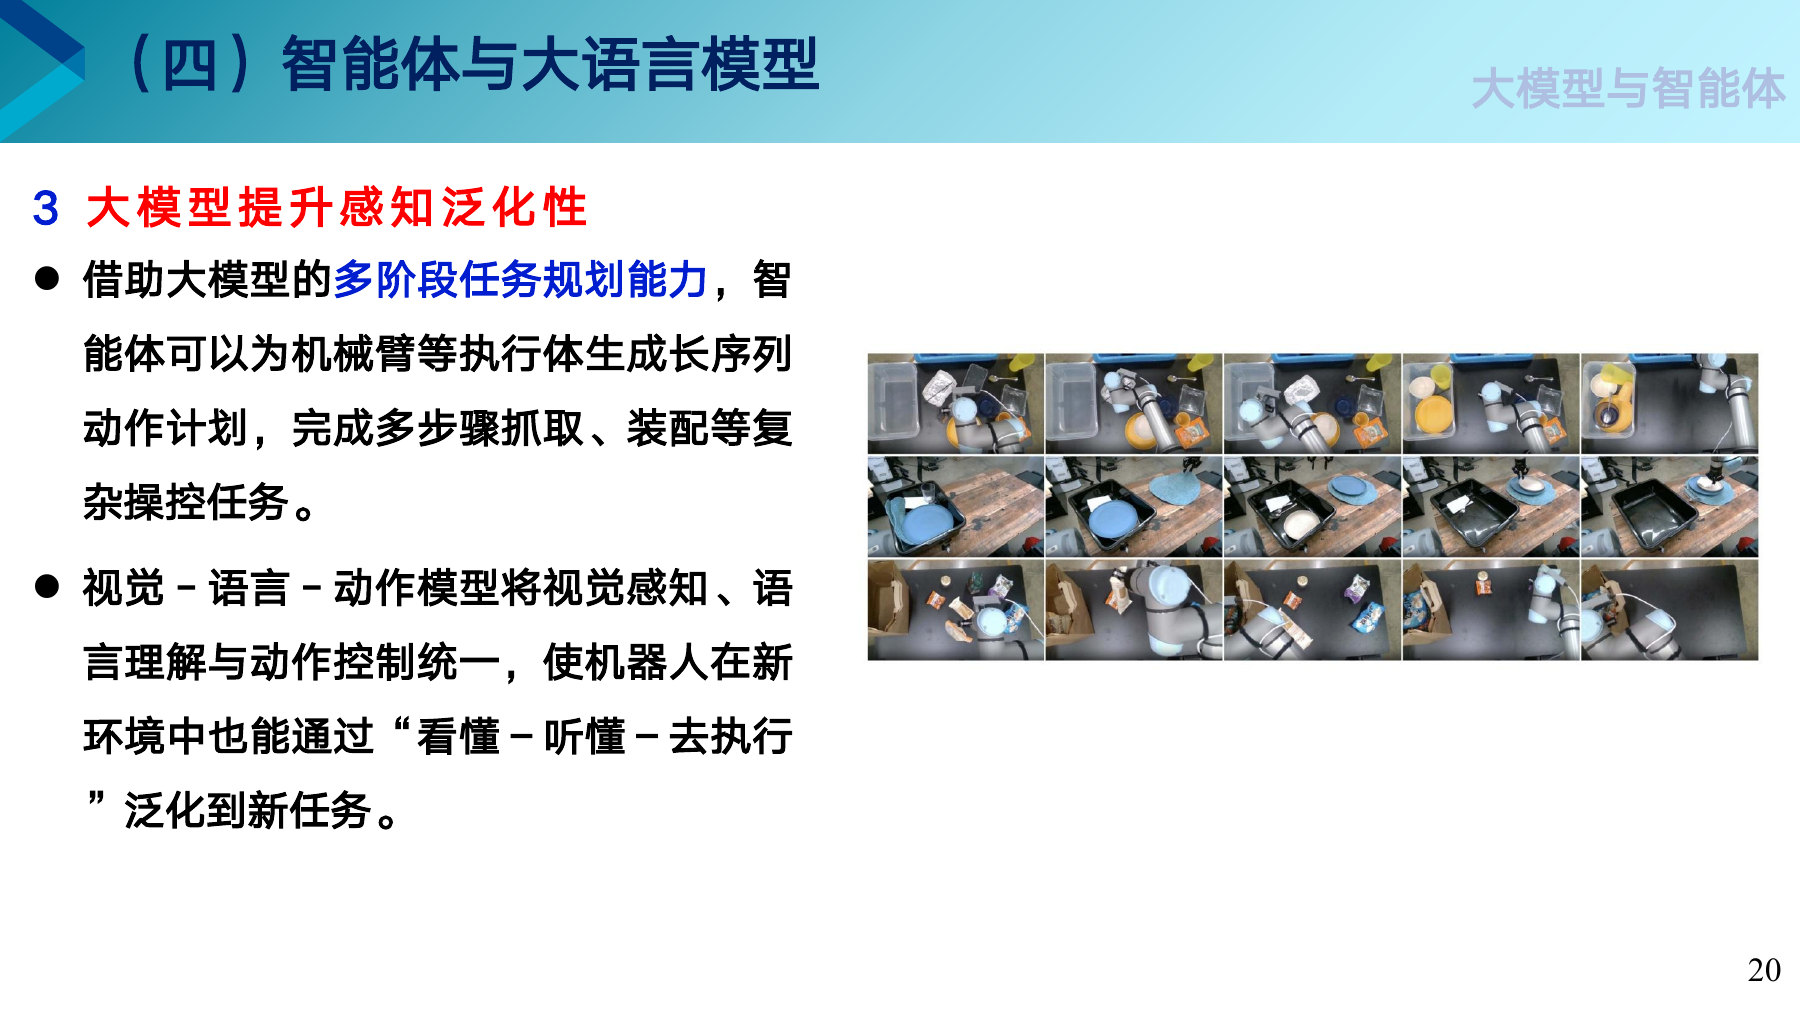
看懂是认出桌上有哪些东西、各在什么位置。听懂是明白“把碗放进水槽”是什么意思。去执行是算出机械臂每一步怎么动。视觉语言动作模型把这三件事交给同一个模型来做。

打个比方

做一份番茄炒蛋,要先打蛋、切番茄,再下锅翻炒、调味。顺序错了,或者哪一步没做好,后面都会受影响。机械臂做抓取、装配这类活也一样,一长串动作得先排好。

21
第 6 章 · 第二节

ReAct 范式与思维树

让模型边想边做,想岔了还能退回来。

第 21 页 ReAct 与思维树

两种让大模型想得更好的办法

ReAct:想一步,做一步,看一眼想推理做行动看观察转圈思维树:几条路比一比,走不通就退回问题思路一思路二思路三看着不行,先不走走不通可行退回
轮次想做看到的结果
1找坐得下 38 人的教室查各教室的座位数305 和 402 都有 50 个座位
2305 离宿舍近,先申请它提交 305 教室的借用申请305 已被别的班借走
3换一间差不多大的提交 402 教室的借用申请预订成功
上表是 ReAct 订教室时的三轮,这时时间已定在周三晚上,报名 38 人。ReAct 由姚顺雨等人在 2022 年提出,思维树由同一团队在 2023 年提出。

关键术语

ReActReasoning + Acting
推理加行动。让模型想一步、做一步、看一眼结果,再想下一步。
思维树Tree of Thoughts, ToT
让模型同时想出几种思路,比较以后挑有希望的往下走,走不通就退回来换一条。

打个比方

只顺着一条思路往下想的推理(比如思维链)像走独木桥,走错一步也只能往下走。思维树像下棋前先在心里摆几种走法,不行就退回来换一种。

随堂练习

上表第 2 轮看到“305 已被借走”,第 3 轮就换了一间教室。这体现了 ReAct 的哪一点?

  1. 先把所有步骤一次想完
  2. 根据看到的结果决定下一步
  3. 只推理,不行动
  4. 只行动,不推理
查看答案
答案 B。ReAct 每做一步都看一眼结果,再据此想下一步。305 被借走这个结果,直接改变了下一步的做法。
保山学院·人工智能教研室·曹鼎鼎