人工智能导论 第 5 章 · 第八节
课程 › 第 5 章 › 第八节 训练策略分阶段训练数据质量偏好对齐推理方法快慢思维过程监督无参优化流式推理
第 5 章 人工智能生成内容与大模型 · 第八节

多模态的训练与推理

分阶段怎样训练,用的时候怎样又准又快
本 节 知 识 点
  1. 69训练策略体系
  2. 70渐进式多阶段训练
  3. 71数据质量优化
  4. 72偏好对齐与奖励建模
  5. 73推理方法:准、稳、快的平衡
  6. 74快思维与慢思维
  7. 75过程监督:给每一步打分
  8. 76无参推理优化:关键帧与空间提示
  9. 77系统级效率优化与流式推理
69
第 5 章 · 第八节

训练策略体系

从看懂信号到答得可靠,训练分成几步走。
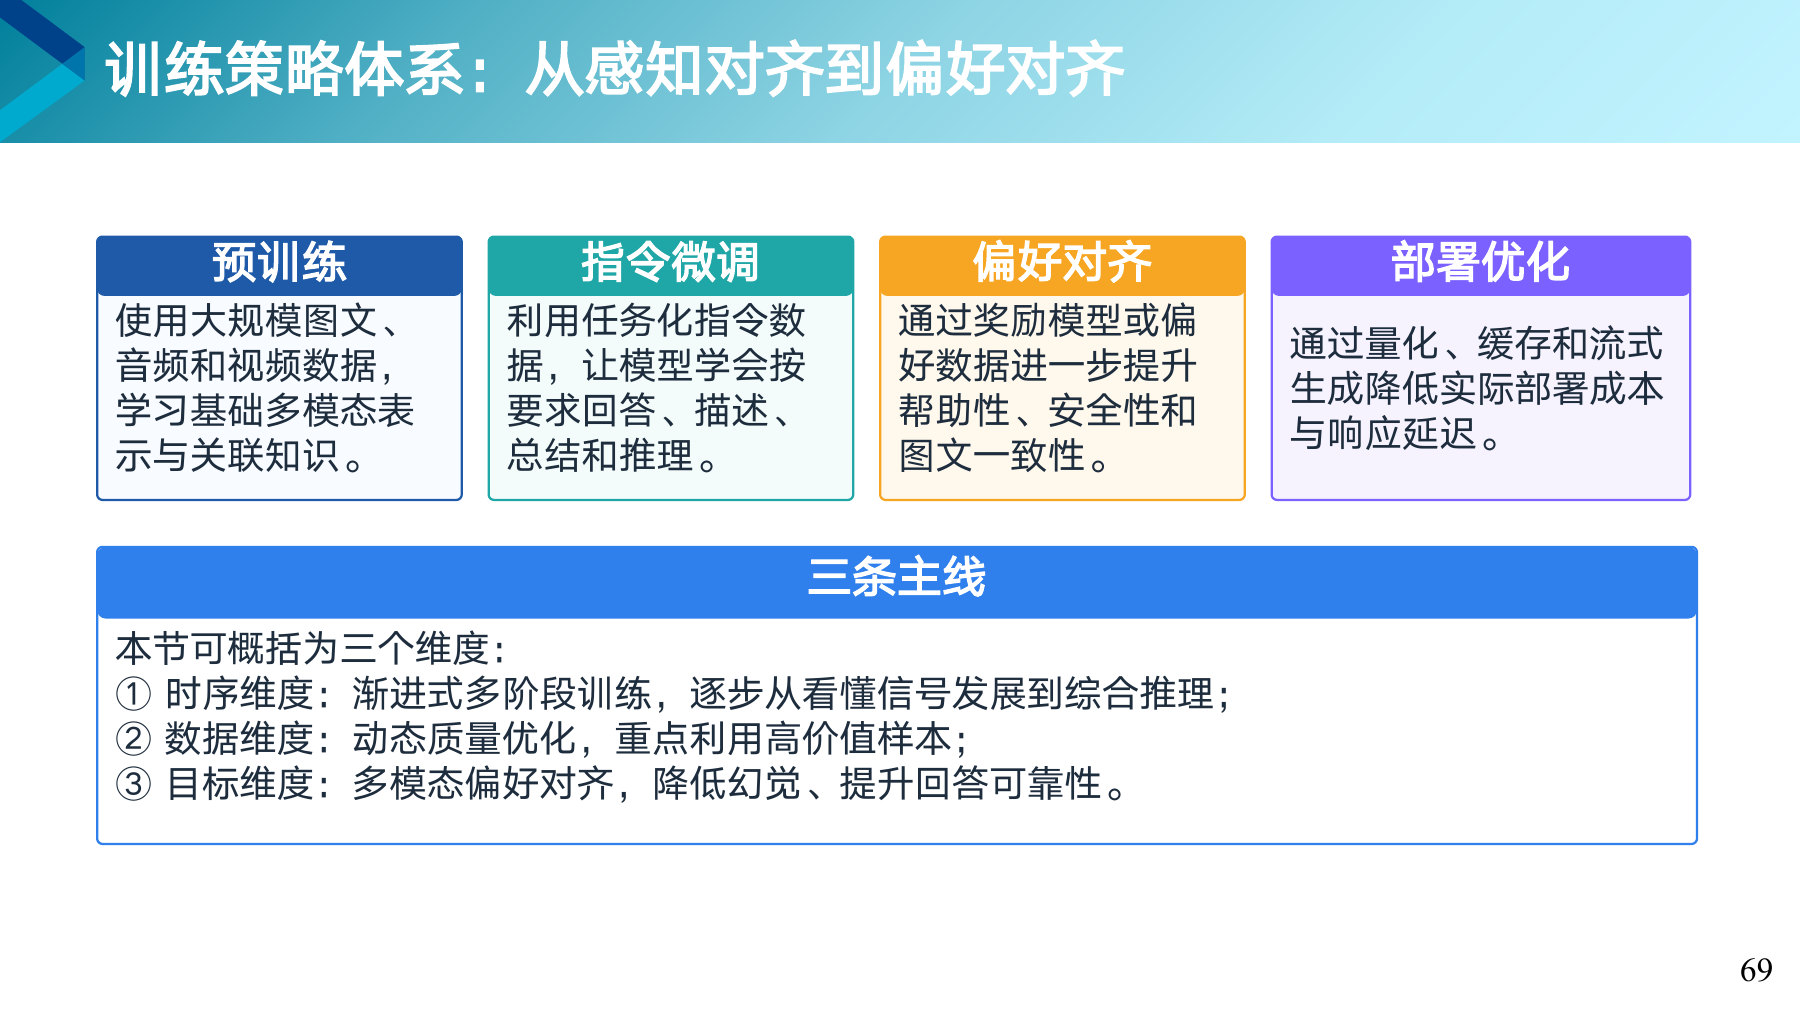
第 69 页课件

重 点四个阶段

预训练用海量图文、声音、视频学会基本的看和听。指令微调学会按要求回答。偏好对齐让回答更有帮助、更安全、和图片对得上。部署优化让模型用起来更省、更快。

知道更多下面的三条主线

时间上分阶段一步步训练,数据上挑出高质量的样本,目标上让回答符合人的偏好、少出幻觉。后面三页分别讲这三条。部署优化里的量化,第 4 章讲模型轻量化时介绍过。

70
第 5 章 · 第八节

渐进式多阶段训练

先搭好“看”和“听”的桥,再一起练,最后专练长内容。

第 70 页 渐进式多阶段训练

三个阶段,一步步放开

阶段 1 感知对齐语言模型(冻结)连接层视觉与音频编码器先搭好“看”和“听”的桥阶段 2 联合训练语言模型连接层视觉与音频编码器全部参数一起练阶段 3 长内容语言模型连接层视觉与音频编码器专练长视频、长音频(数据换成长内容)这一阶段在调参数冻结:参数不动
冻结,就是训练时让这部分的参数保持不动。语言模型已经学得很好,一开始就跟着改,容易把原来的本事改坏。所以第一阶段只训练编码器和连接层,让它们先和语言模型对上。
  • 阶段 1 决定看和听稳不稳。
  • 阶段 2 用文字、图片、视频、声音混合的数据一起训练,决定模型的通用性。
  • 阶段 3 专门用长视频、长音频、多页文档来练,让模型能理解很长的内容。

关键术语

冻结Freeze
训练时固定一部分参数,只调整其余部分。

打个比方

给一台好电脑加装摄像头。先装好驱动、调通摄像头,不去动系统本身。等摄像头能正常用了,再整体优化。

随堂练习

第一阶段为什么要冻结语言模型?

  1. 语言模型太小,不值得训练
  2. 防止把语言模型已经学会的本事改坏
  3. 冻结以后模型就能看懂视频
  4. 冻结可以让图片变清晰
查看答案
答案 B。语言模型已经训练得很好,编码器和连接层却还没和它对上。先只训练这两部分,把接口对好,就不会连累原来的语言能力。
71
第 5 章 · 第八节

数据质量优化

从拼命堆数据,走向挑出好数据来用。

第 71 页 数据质量优化:从堆数据走向用好数据

这些图文对,哪些该留

图片内容配的文字问题怎么处理
一只猫趴在沙发上一只狗在草地上奔跑图文不匹配删掉
同一张风景照重复出现了 500 次重复样本只留一份
一张商品照片这是一张图片套话,没有信息降低权重
一张海边照片今天心情很好关系很弱降低权重
质量评估:用一个模型给每一对图文打“匹配分”,再看它能提供多少新信息。分高的多用,分低的少用或不用。
图文不匹配危害最大。模型把猫当成狗学进去,以后看着图就可能说错,这是多模态幻觉的来源之一。

关键术语

动态重加权Dynamic Reweighting
训练时按每个样本的好坏调整它的分量,好样本多练,差样本少练或不练。

重 点越来越看重质量

模型越大,越容易把数据里的错误也一起记住。同样的算力,喂干净的数据,训出来的模型往往更强。

打个比方

复习时做一百道答案错漏百出的练习题,不如做二十道答案准确、题型全面的好题。

72
第 5 章 · 第八节

偏好对齐与奖励建模

从“能回答”提升到“答得让人愿意采纳”。

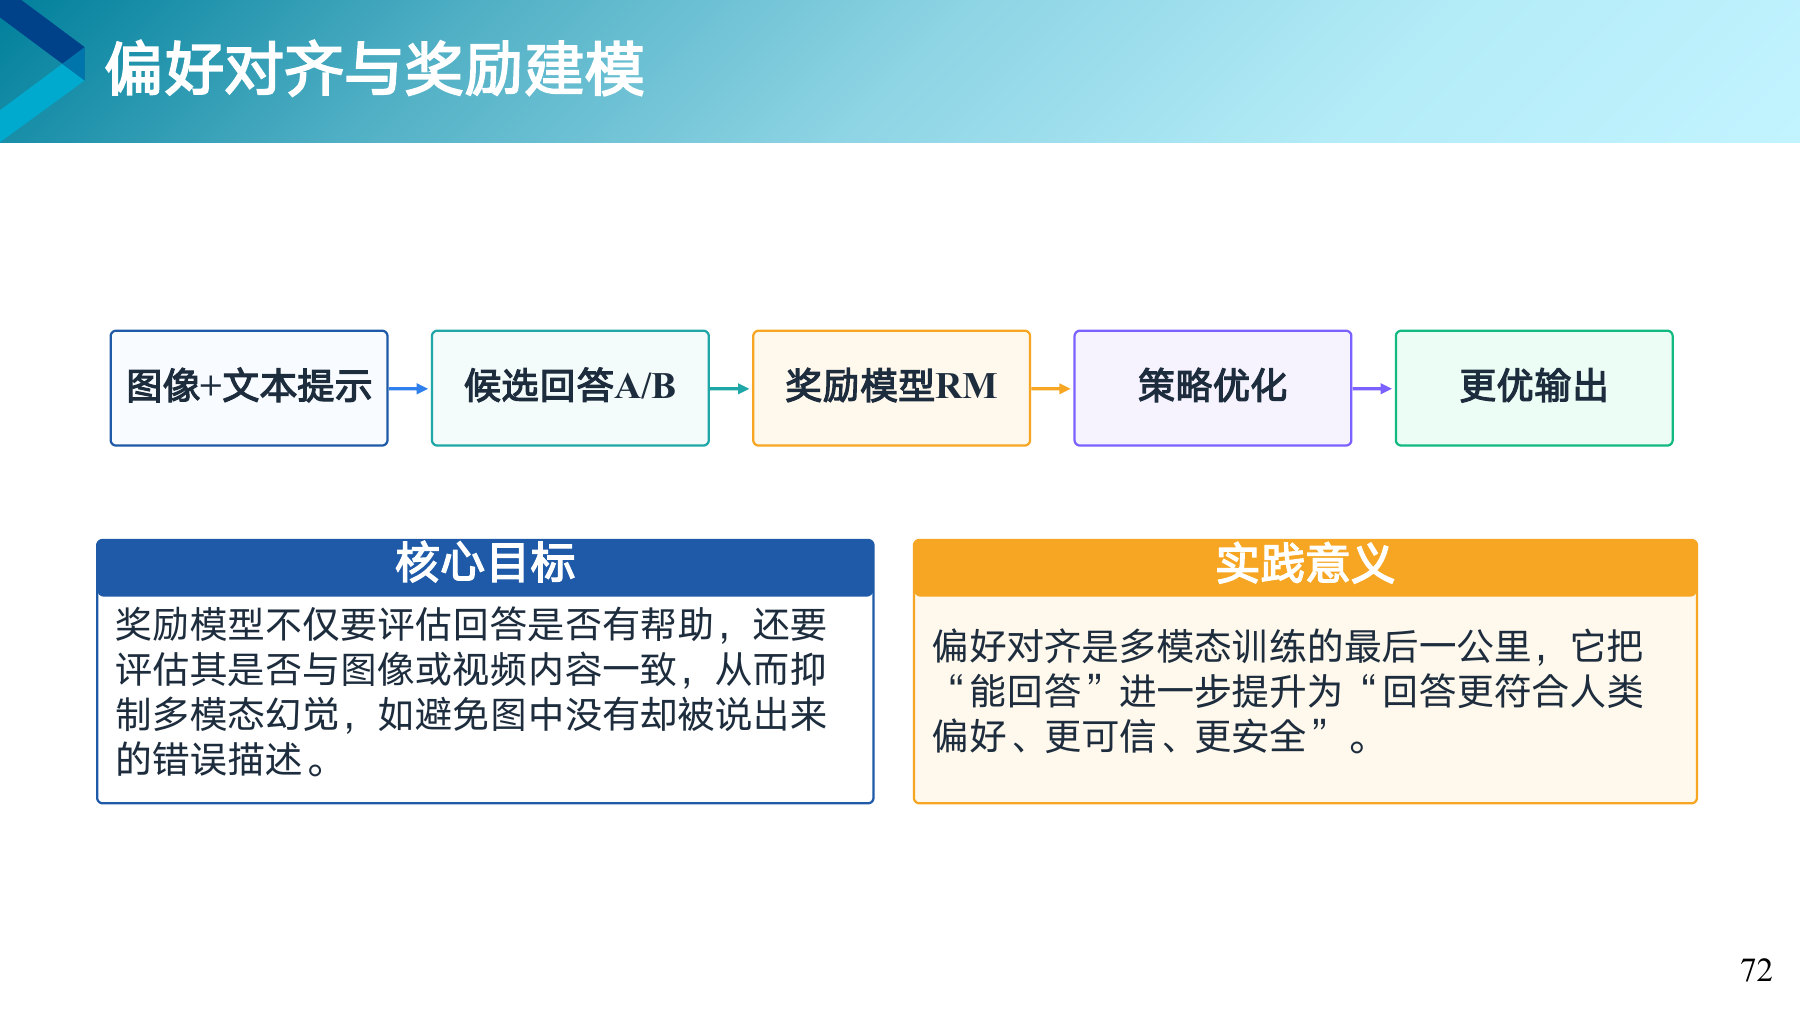
第 72 页课件

重 点多模态多了一项检查

图里是两只猫在睡觉。回答 A 说“两只猫在睡觉”,回答 B 说“两只猫和一只狗在玩”。B 说出了图里没有的狗,奖励模型要给它低分。这样训练,能减少看着图说瞎话。

知道更多和第 56 页是同一个思路

流程还是“生成几个候选回答,奖励模型打分,按分数调整模型”。区别在于打分时,除了看回答有没有帮助,还要看它和图片、视频的内容对不对得上。

关键术语

多模态幻觉Multimodal Hallucination
模型描述了图片或视频里根本没有的东西。
73
第 5 章 · 第八节

推理方法:准、稳、快的平衡

模型训练好以后,还要让它答得准、稳、快。

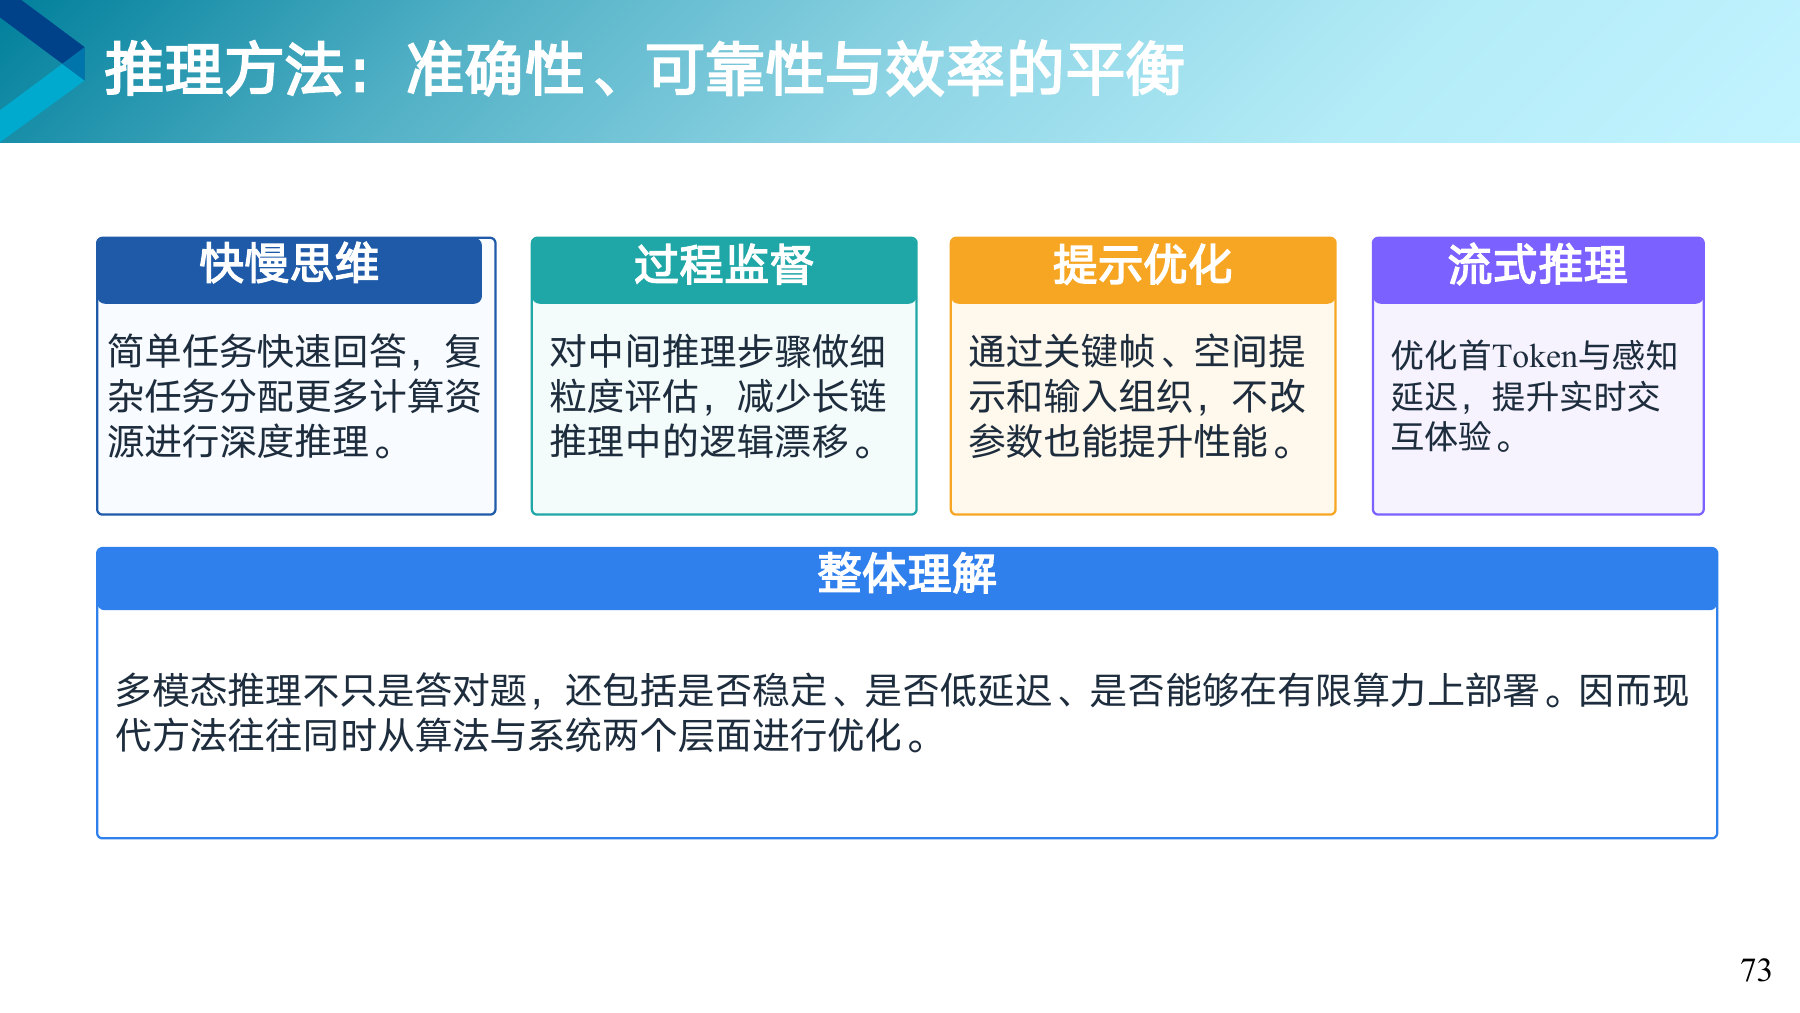
第 73 页课件

关键术语

推理Inference
这里指模型训练好以后被拿来使用、给出回答的过程。和“逻辑推理”里的推理意思不同。

重 点四个方向

快慢思维按题目难度分配算力。过程监督给中间每一步打分。提示优化(第 76 页叫无参推理优化)不改模型,只改输入的组织方式。流式推理让第一个字尽早出来。后面四页各讲一个。

打个比方

开一家餐馆,菜好吃只是基本要求。上菜快、成本可控、厨房天天都能这样运转,店才开得下去。

74
第 5 章 · 第八节

快思维与慢思维

简单的题马上答,难的题慢慢想。

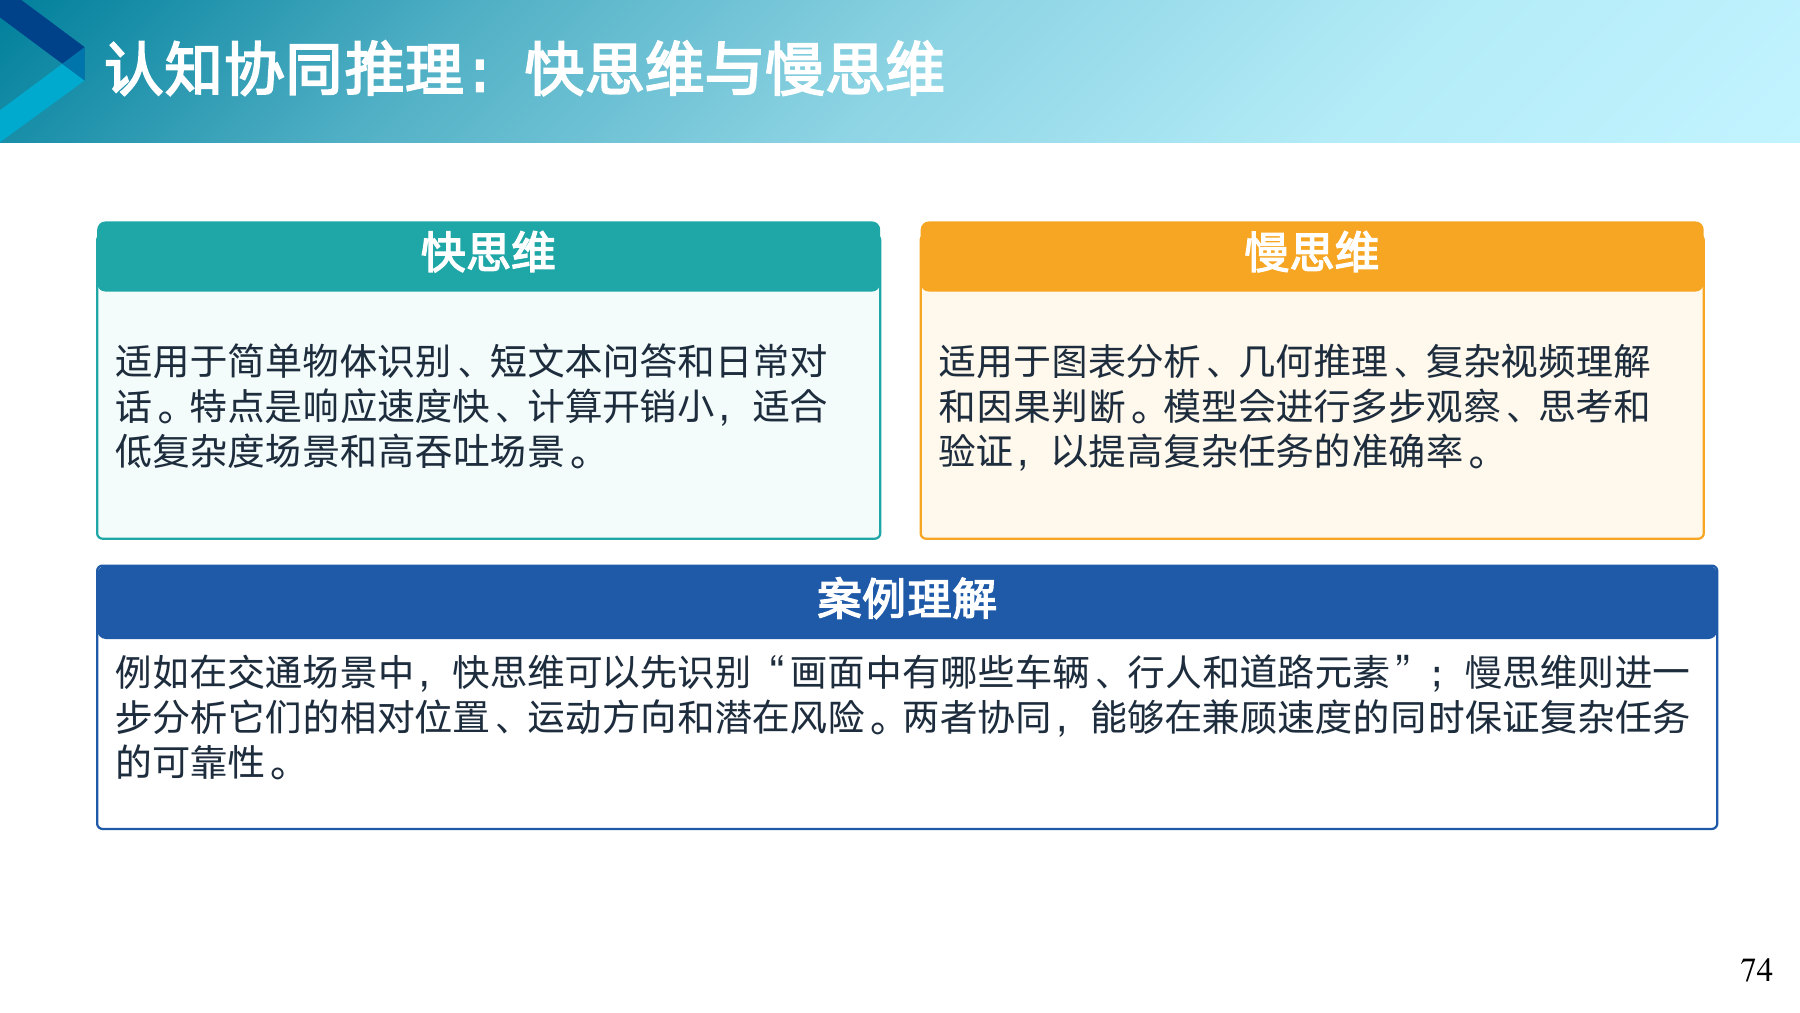
第 74 页课件

重 点怎么分工

认出图里有一只狗,用快思维,马上就能答。分析一张复杂的统计图、判断路口会不会出事故,要用慢思维,一步步观察、推理、检查。

知道更多名字的来历

心理学家丹尼尔·卡尼曼在《思考,快与慢》一书中,把人的思考分成快而凭直觉的“系统 1”和慢而费力的“系统 2”。这里借用了这个说法。

随堂练习

下面哪个问题更需要慢思维?

  1. 图里有没有猫
  2. 这张照片是白天还是晚上
  3. 根据这张折线图,哪一年增长最快,原因可能是什么
  4. 这句话是中文还是英文
查看答案
答案 C。看折线图找出增长最快的年份,还要推测原因,需要多步观察和推理。其余几个问题看一眼就能回答,用快思维就够了。
75
第 5 章 · 第八节

过程监督:给每一步打分

不光看答案对不对,还检查每一步推得对不对。

第 75 页 过程监督:细粒度评估推理链

答案对了,过程却错了

题目:买 3 支笔,每支 4 元,再买 2 本本子,每本 5 元,一共多少钱?

步骤模型写的只看答案过程监督
第 1 步3 支笔:3 × 4 = 10 元不检查错
第 2 步2 本本子:2 × 5 = 12 元不检查错
第 3 步10 + 12 = 22 元22 元,判对前两步都错,答案是凑巧对的
正确的算法是 12 + 10 = 22 元。两处错误恰好抵消,只看答案会把这个过程当成对的。过程奖励模型给每一步单独打分,错在哪一步一清二楚。
读题看文字、
看图表
→
写一步写出一步
推理
→
逐步打分判断这一步
对不对
→
修正或继续错了就改,
对了往下写

关键术语

过程奖励模型Process Reward Model, PRM
给推理过程中的每一步单独打分的模型。

打个比方

数学老师改作业不光看最后的数。学生两处算错恰好抵消,最后的数是对的,只看结果会给满分,看了步骤才知道错在哪。

随堂练习

只看最终答案来打分,最大的漏洞是什么?

  1. 算得太慢
  2. 答案太短
  3. 没法给文字题打分
  4. 凑巧答对的错误过程也会被当成对的
查看答案
答案 D。左边的例子里,两处错误恰好抵消,答案 22 元是对的。只看答案会给满分,给每一步打分才能发现前两步都错了。
76
第 5 章 · 第八节

无参推理优化:关键帧与空间提示

不改模型的参数,只把输入整理得更清楚。

第 76 页 无参推理优化:关键帧与空间提示

不改模型,只改喂给它的东西

123原来的图加上编号框问:“杯子在书的哪一边?”问:“1 号在 2 号的哪一边?”
挑关键帧

从一段视频里挑出画面变化大的几帧。和每隔几秒平均取一帧相比,重要的瞬间更不容易漏掉。

加空间提示

在图上画框、标号,或者画出物体移动的轨迹。模型回答“谁在谁左边”“它往哪走了”这类问题会更准。

不用重新训练,也不用换模型,改的只是输入的组织方式,所以成本很低。

重 点适合什么场合

室内导航、路线规划、按时间顺序提问、机器人干活,都要弄清东西在哪里、往哪里动。这些任务最能从空间提示里得到帮助。

打个比方

给人指路时,说“往那边走”和说“出门左转,走两百米过红绿灯”,对方走对的机会完全不同。路还是那条路,差别只在怎么说。

77
第 5 章 · 第八节

系统级效率优化与流式推理

用户觉得快不快,主要看第一个字多久出来。

第 77 页 系统级效率优化与流式推理

让第一个字早点出来

全部生成完再播放播放 10 秒等了 4 秒才听到第一个字边生成边播放播放 10 秒0.3 秒后就听到第一个字0 秒5 秒10 秒15 秒等待
分块预填充

很长的输入拆成几块分批读入,和生成回答的工作交替进行,机器不会被一大段输入堵住。

多码本流式生成

每一小段声音用几层编码来表示,第一层记个大概,后面几层逐层补细节。一小段的编码生成完就能播放。

图中的秒数只是示意,不同系统差别很大。

关键术语

首词元延迟Time To First Token, TTFT
从发出问题到收到第一个词元所用的时间。

重 点为什么盯着第一个字

语音助手、车载系统、机器人都在和人实时交流。播放的内容一样长,0.3 秒就开口的助手,比沉默 4 秒再开口的助手用起来顺畅得多。

知道更多这一章讲了什么

这一章从生成式 AI 的基本概念讲起,认识了四种生成方法,又讲了大语言模型怎样搭、怎样训、怎样用,最后讲到能看、能听、能动手的多模态大模型。下一章讲智能体系统,让模型自己规划、调用工具,把一件事从头办到尾。

保山学院·人工智能教研室·曹鼎鼎