人工智能导论 第 5 章 · 第四节
课程 › 第 5 章 › 第四节 扩散模型扩散公式隐空间扩散扩散变体自回归链式法则四类对比
第 5 章 人工智能生成内容与大模型 · 第四节

扩散模型与自回归模型

今天画图和写字背后的两种主力方法
本 节 知 识 点
  1. 31扩散模型
  2. 32扩散公式解析
  3. 33先压缩,再在小空间里去噪
  4. 34扩散模型的四类变体
  5. 35自回归模型
  6. 36自回归:一句话拆成连乘
  7. 37四类生成模型对比
31
第 5 章 · 第四节

扩散模型

先把图一步步弄成噪声,再学着一步步变回来。

第 31 页 扩散模型

先把图弄脏,再学着擦干净

第 0 步第 100 步第 250 步第 500 步第 1000 步正向:每一步加一点噪声,按固定规则来,不用学逆向:每一步去掉一点噪声,模型要学的就是这一步
  • 正向加噪 每一步往图上撒一点随机的噪声,走完 1000 步,图就变成了纯粹的噪声。
  • 逆向去噪 从纯噪声出发,每一步由模型猜出“这里面混进了哪些噪声”,去掉一点,最后得到一张清晰的图。
  • 特点 训练稳定,画质高。代价是要走很多步,生成比较慢。

关键术语

扩散模型Diffusion Model
通过“逐步加噪、再逐步去噪”来生成内容的模型。
噪声Noise
随机、杂乱的数值,加到图上就像电视雪花。

重 点为什么要拆成这么多步

一步从雪花变出一颗心,太难。把只脏了一点点的图擦干净一点点,就容易得多。扩散模型把一件很难的事,拆成了上千件很容易的小事。

打个比方

沙画艺人面对一盘撒乱的沙子,一下一下地推、抹,画面慢慢显出来。扩散模型的逆向过程也是这样,从一团乱糟糟的噪声出发,一步步“推”出一张图。
32
第 5 章 · 第四节

扩散公式解析

任何一步的图,都是原图和噪声按比例混合。

第 32 页 扩散公式解析

盯住一个像素,看它怎么变

像素的值放在 −1 到 1 之间,越大颜色越深,和上一页的小图一样。下面盯住一个原来是 0.8 的深色像素。

第 t 步的值 = a × 原来的值 + b × 噪声
第几步原图乘的数 a噪声乘的数 b这个像素的值
01.000.000.80
1000.950.320.60
2500.720.690.23
5000.280.96−0.26
10000.0061.00约 −0.5
不用真的一步一步撒,任何一步的样子都能用上面的式子一次算出来。这里假设抽到的那份噪声是 −0.5,为了好比较,各步都用它。a 越来越小,b 越来越大,像素的值慢慢从 0.8 滑向 −0.5。a 和 b 各自平方后相加,总是等于 1(表里的数四舍五入过)。
表中的 a、b 按常用的设置算出:一共 1000 步,每一步加噪声的力度从 0.0001 逐渐增大到 0.02。

关键术语

噪声调度Noise Schedule
规定每一步加多少噪声的方案,常用希腊字母 β 表示每一步的力度。

重 点噪声加多快

每一步加得太猛,几步就把结构毁了,模型每一步都很难猜。加得太轻,要走很多步,生成很慢。噪声调度就是在两者之间找一个合适的节奏。

打个比方

往一杯清水里一滴一滴加墨水。a 像还剩多少原来的清水,b 像已经混进去多少墨。滴得快,几下就全黑了。滴得慢,要滴很多次。

33
第 5 章 · 第四节

先压缩,再在小空间里去噪

把图压小以后再去噪,要处理的数只剩几十分之一。

第 33 页 隐空间扩散

先把图压小,再在小图上去噪

原图512 × 512 像素
共 786432 个数
→
压缩编码器压成
64 × 64 × 4
→
去噪在 16384 个数上
一步步去噪
→
还原解码器还原成
512 × 512 的图
786432 ÷ 16384 = 48。要处理的数只剩原来的 1/48,每一步去噪都快得多。压掉的主要是人眼看不出的细节,画面的内容都还在。
扩散模型适合高质量的内容创作、图像编辑、声音和视频生成。今天常见的文生图工具,大多采用这种“先压缩、再去噪”的做法。
数字按 Stable Diffusion 1.x 版本的设置计算。512 × 512 的彩色图,每个像素有红、绿、蓝三个数。

关键术语

隐空间扩散模型Latent Diffusion Model, LDM
在压缩后的隐空间里做扩散的模型,2022 年正式发表。Stable Diffusion 就建立在它的基础上。

打个比方

画家先在小本子上画好构图草稿,满意了再放大到画布上补细节。草稿小,改起来快得多。

随堂练习

按左边的数字,隐空间扩散要处理的数,是直接在原图上处理的几分之一?

  1. 1/3
  2. 1/8
  3. 1/48
  4. 1/512
查看答案
答案 C。原图有 512 × 512 × 3 = 786432 个数,压缩后只有 64 × 64 × 4 = 16384 个数,786432 ÷ 16384 = 48。
34
第 5 章 · 第四节

扩散模型的四类变体

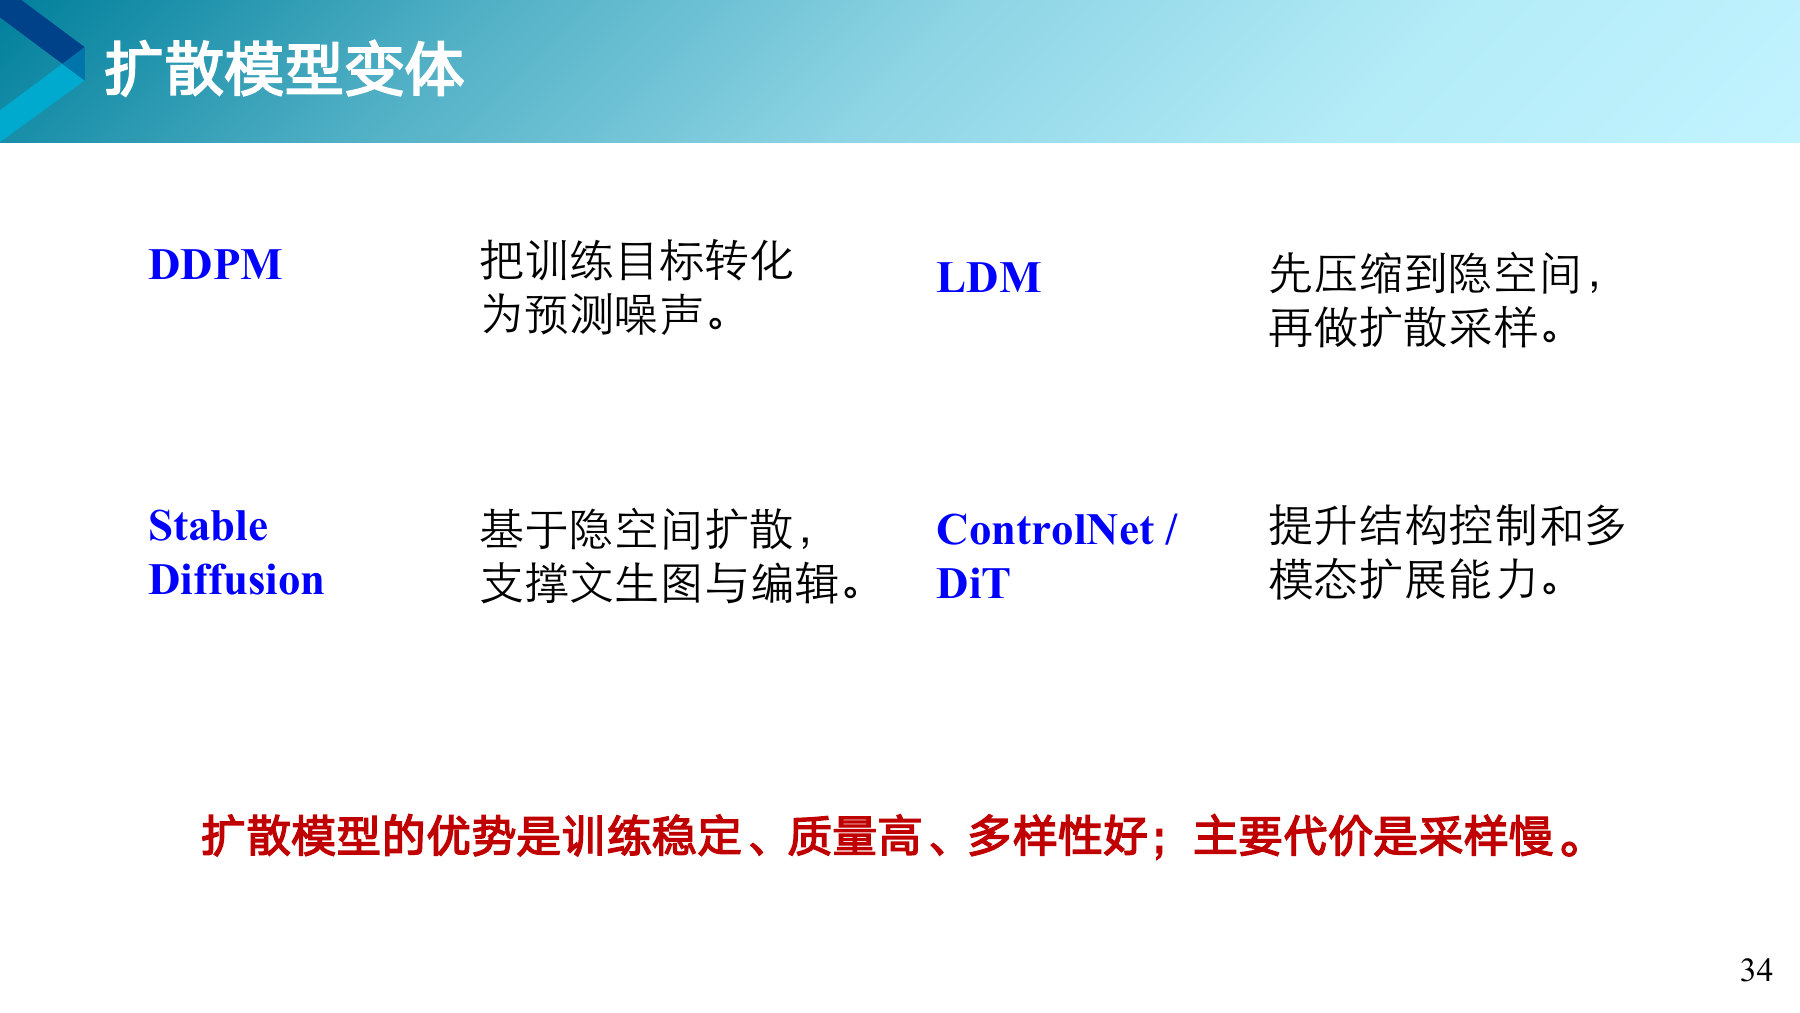
从学会预测噪声,到压缩提速,再到精细控制。

第 34 页课件

知道更多四个名字的来历

DDPM 发表于 2020 年,让扩散模型第一次画出了高质量的图。LDM 在 2022 年把扩散搬进隐空间。Stable Diffusion 在 2022 年公开发布,任何人都能下载使用。ControlNet 和 DiT 出现在 2023 年前后。

重 点ControlNet 管什么

光靠文字很难说清“人物摆什么姿势”。ControlNet 允许再给一张线稿或人体骨架图,模型照着这个结构去画。文字管内容,结构图管形状。

关键术语

DiTDiffusion Transformer
把扩散模型里负责去噪的网络换成 Transformer,第五节会讲 Transformer。
35
第 5 章 · 第四节

自回归模型

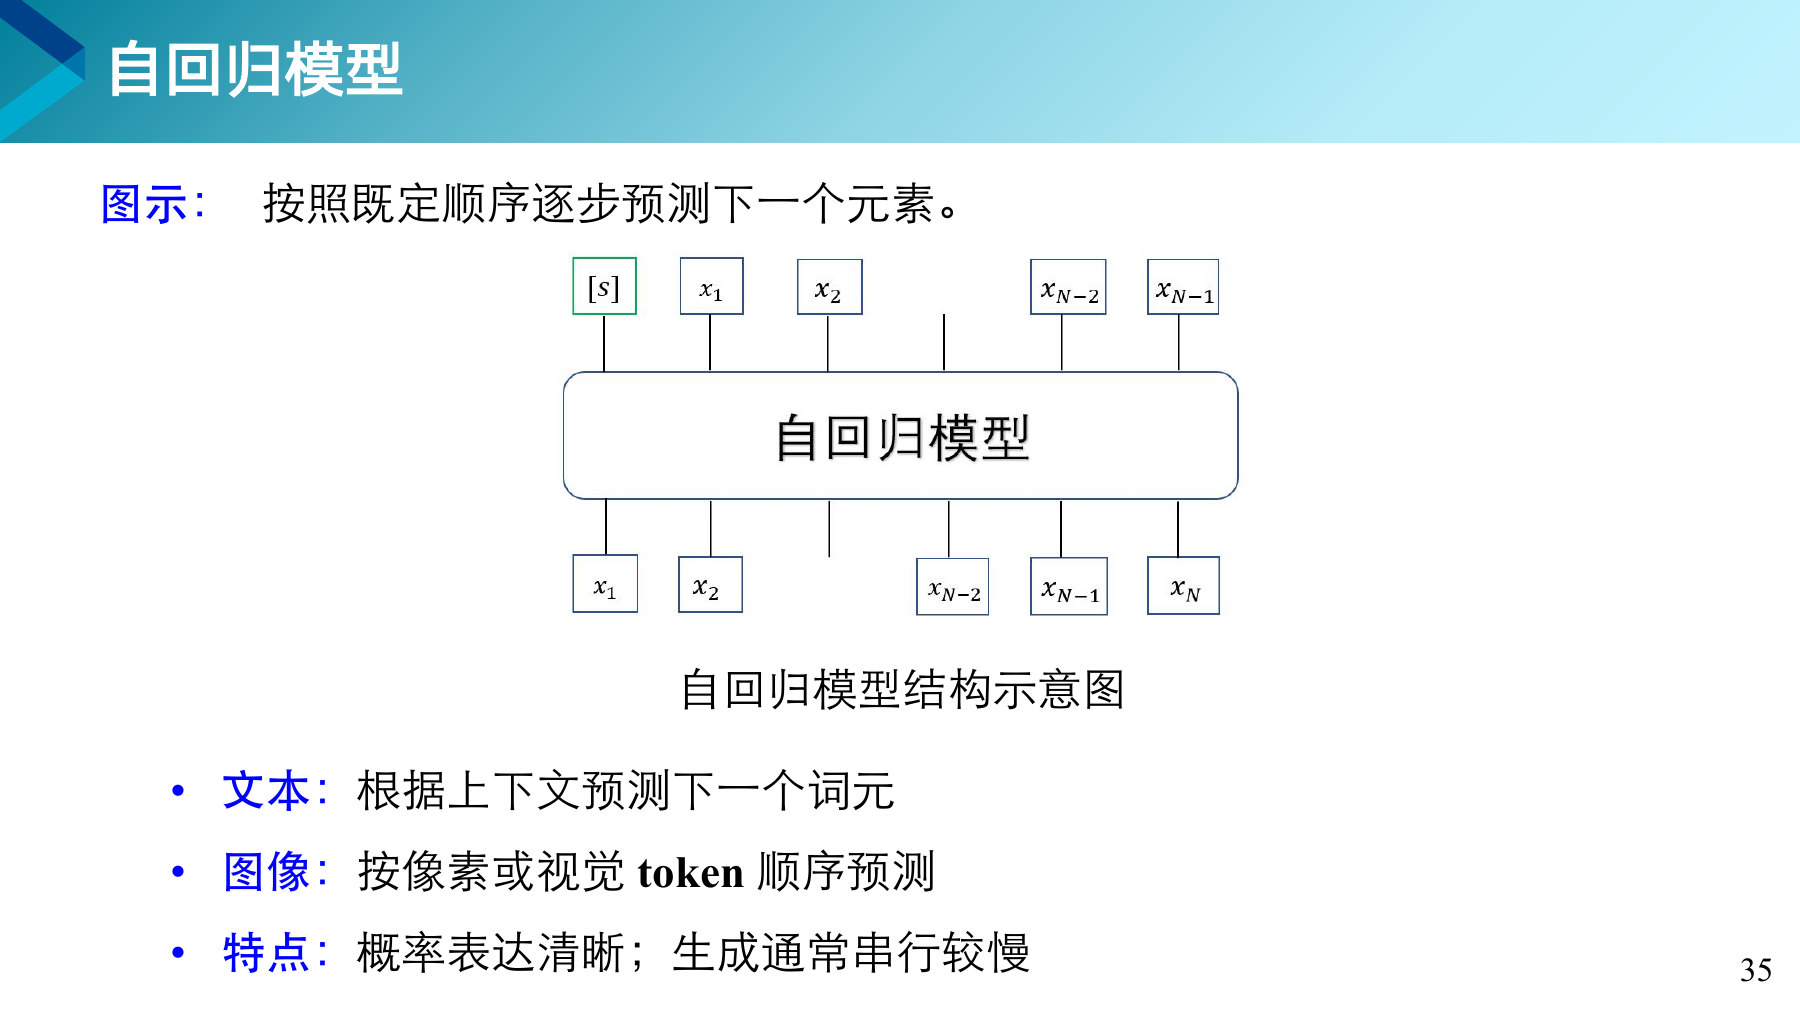
按顺序一个接一个地预测,每一步都参考前面写好的。

第 35 页课件

关键术语

自回归模型Autoregressive Model
按顺序逐个预测下一个元素,每一步都以已经生成的内容为条件。
词元Token
模型处理文字的最小单位,可能是一个字、一个词或半个词。

打个比方

背古诗接下句也是这样:先有前面的字,才接得出后面的字。“白日依山”后面接“尽”,“黄河入海”后面接“流”。

重 点快不起来的原因

第 5 个词必须等第 4 个词写出来才能算,几个词没法同时写。所以自回归生成通常比较慢。大模型回答时一个字一个字往外冒,就是这个原因。

36
第 5 章 · 第四节

自回归:一句话拆成连乘

整句话的可能性,等于每个词的可能性依次相乘。

第 36 页 自回归结构与例子

算一算“今天天气很好”这句话有多常见

第几步已经有的内容下一个词可能性
1(空)今天0.02
2今天天气0.10
3今天天气很好0.30
整句话的可能性 = 0.02 × 0.10 × 0.30 = 0.0006
这种拆法叫链式法则。生成时反过来用:每一步都在已经写好的内容后面,挑一个可能性高的词接上去。
代表模型按顺序预测什么
PixelCNN图片的像素,一个接一个
WaveNet声音的波形,一个采样点接一个
GPT文字的词元,一个接一个
表中的可能性是为了演示设的,真实模型会给每个候选词算出一个可能性。

重 点为什么说自回归的概率表达清晰

每一步都是一个明确的可能性,乘起来就是整句话的可能性。所以自回归模型能直接说出一句话有多像人话,别的生成方法往往做不到这么直接。

打个比方

人听别人说话时,也在不停地猜下一个词。听到“今天天气”,心里已经预备好“很好”“不错”“真冷”,几乎没有人会预备“电脑”。模型对每个候选词也都有一个可能性。

随堂练习

一句话有三个词,三步的可能性分别是 0.5、0.4、0.5。整句话的可能性是多少?

  1. 1.4
  2. 0.5
  3. 0.1
  4. 0.02
查看答案
答案 C。链式法则是连乘:0.5 × 0.4 × 0.5 = 0.1。把三个数加起来得到 1.4,比 1 还大,不可能是可能性。
37
第 5 章 · 第四节

四类生成模型对比

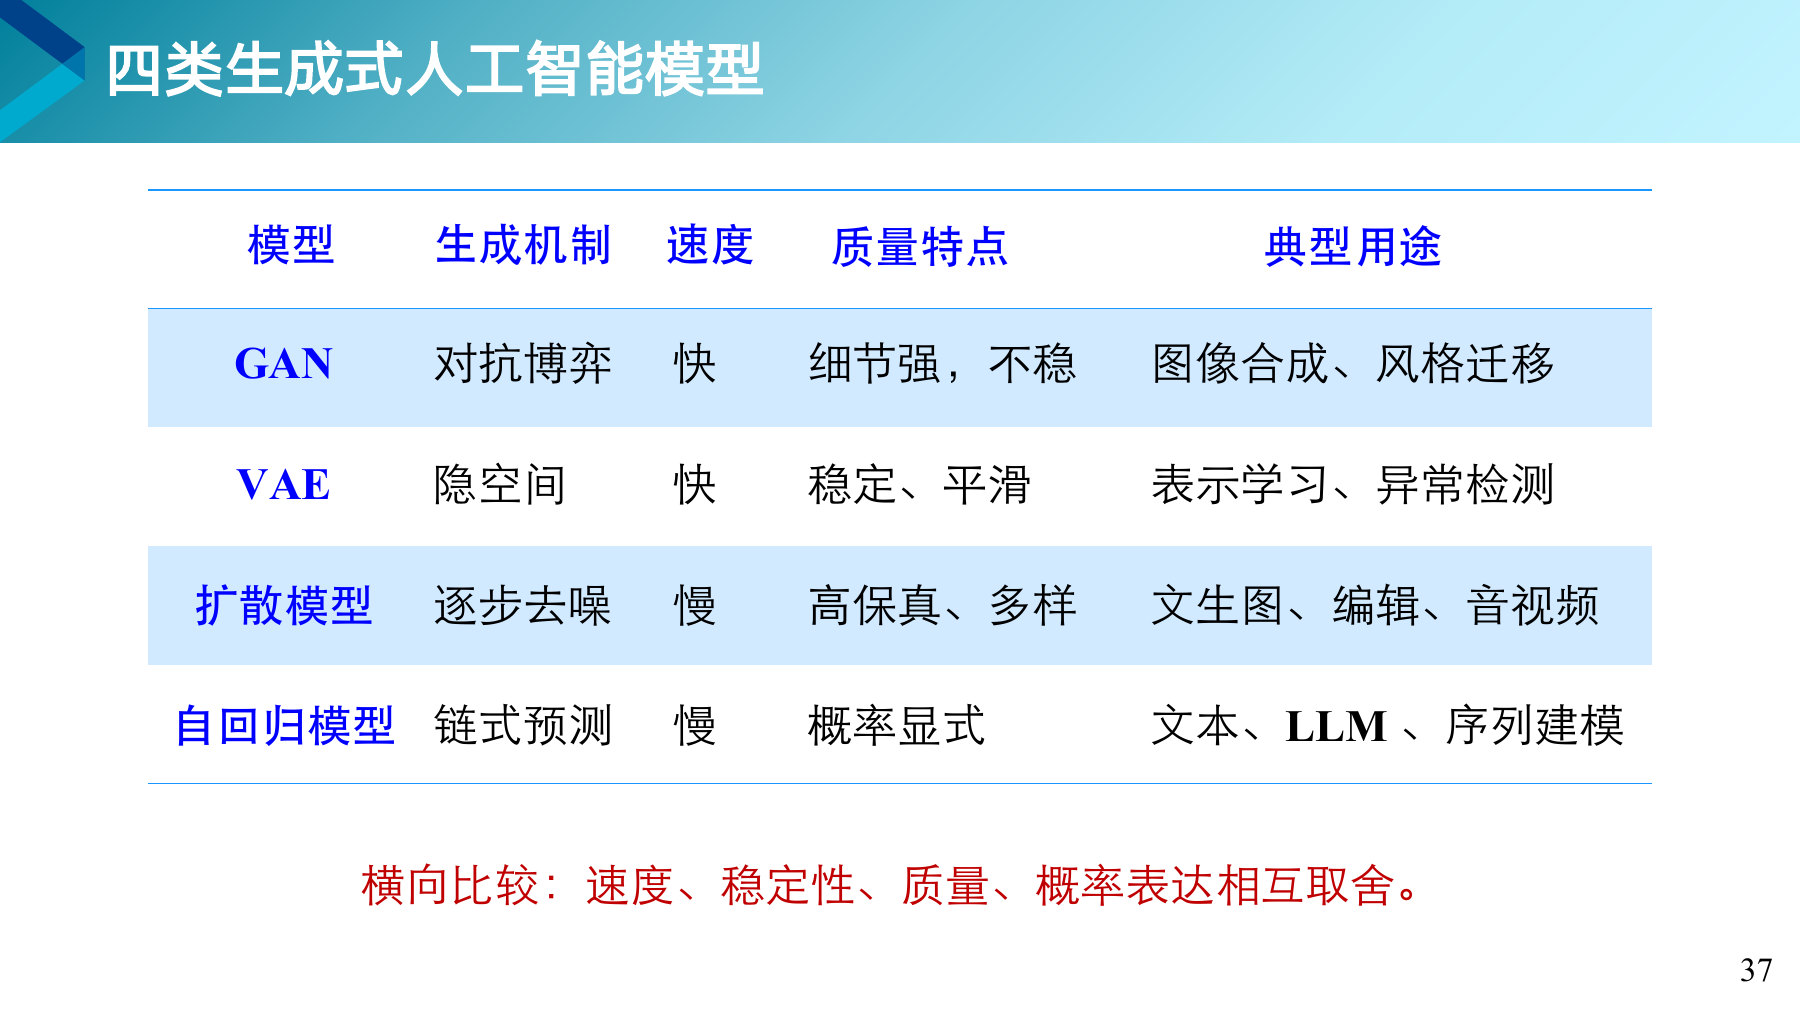
速度、稳定、质量、概率表达,没有一种全占优。

第 37 页课件

重 点横着读这张表

快的 GAN 训练不稳,稳的 VAE 画面偏软,画质高的扩散模型慢,概率清楚的自回归模型也慢。挑哪一种,要看任务最在乎什么。

打个比方

这和出门选交通工具一样。自行车灵活但慢,高铁快但要先去车站。问哪种最好没有意义,只能问这一趟用哪种合适。

随堂练习

要为一个聊天机器人逐字写出回答,按这张表最适合用哪一类模型?

  1. GAN
  2. VAE
  3. 扩散模型
  4. 自回归模型
查看答案
答案 D。表中自回归模型的典型用途是文本和大语言模型,它按顺序一个词一个词地写,正好适合写回答。GAN、VAE 和扩散模型主要用在图像等内容上。
保山学院·人工智能教研室·曹鼎鼎