第 4 章 · 第四节
为什么训练越来越难
好数据不够多,算力和显存也不够用。
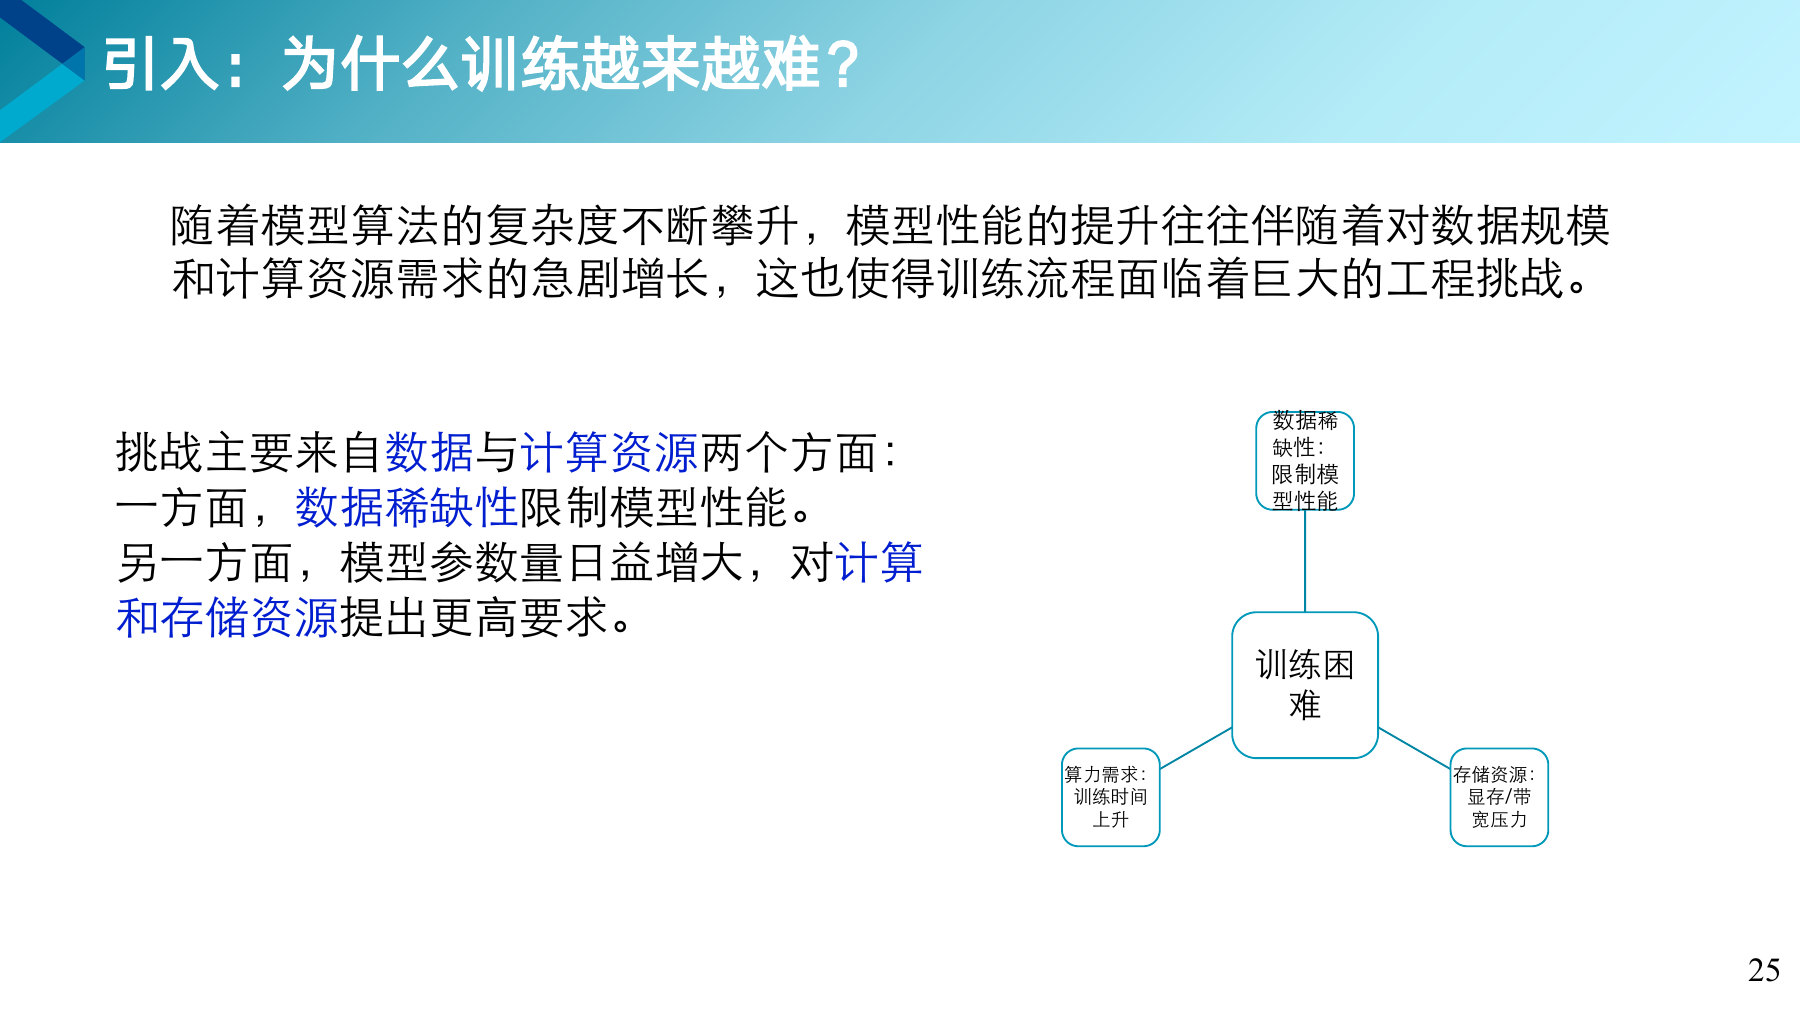
重 点难处来自两头
一头是数据:好的标注数据少,模型见识不到足够多的情况。另一头是资源:模型参数越来越多,训练要算得更久,显存和传输数据的带宽也更吃紧。
关键术语
带宽Bandwidth
每秒能传多少数据,就像水管的粗细。
打个比方
盖一栋越来越高的楼,一边缺砖,一边起重机又不够高。只补砖或只换起重机,楼都盖不上去。
好数据不够多,算力和显存也不够用。
一头是数据:好的标注数据少,模型见识不到足够多的情况。另一头是资源:模型参数越来越多,训练要算得更久,显存和传输数据的带宽也更吃紧。
盖一栋越来越高的楼,一边缺砖,一边起重机又不够高。只补砖或只换起重机,楼都盖不上去。
补数据、补算力、省显存,各有一种办法。
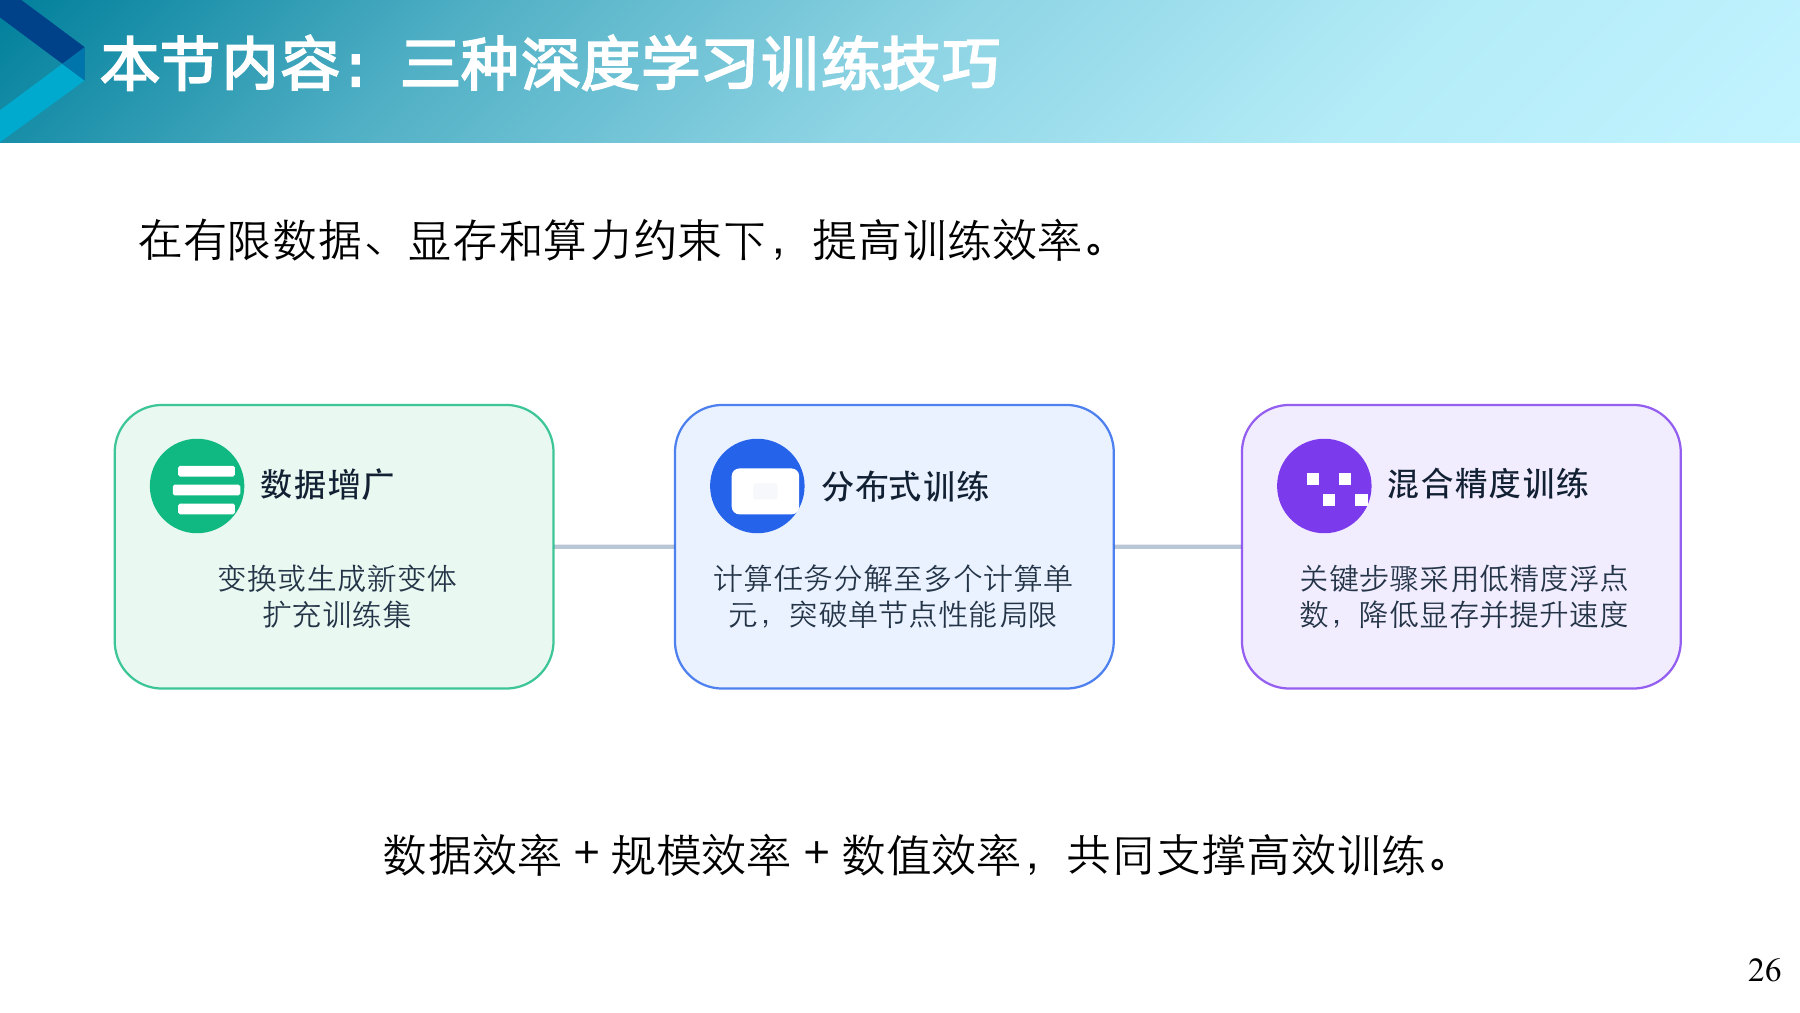
数据增广把已有的数据变出新样子,解决数据不够。分布式训练让很多张显卡一起算,解决一张卡算不完。混合精度训练在合适的地方用更短的数,既省显存又算得快。这一节讲第一种,下一节讲后两种。
模型大到一张显卡放不下,最直接相关的是哪种技巧?
不用多标注,对已有数据做变换,扩充训练集。
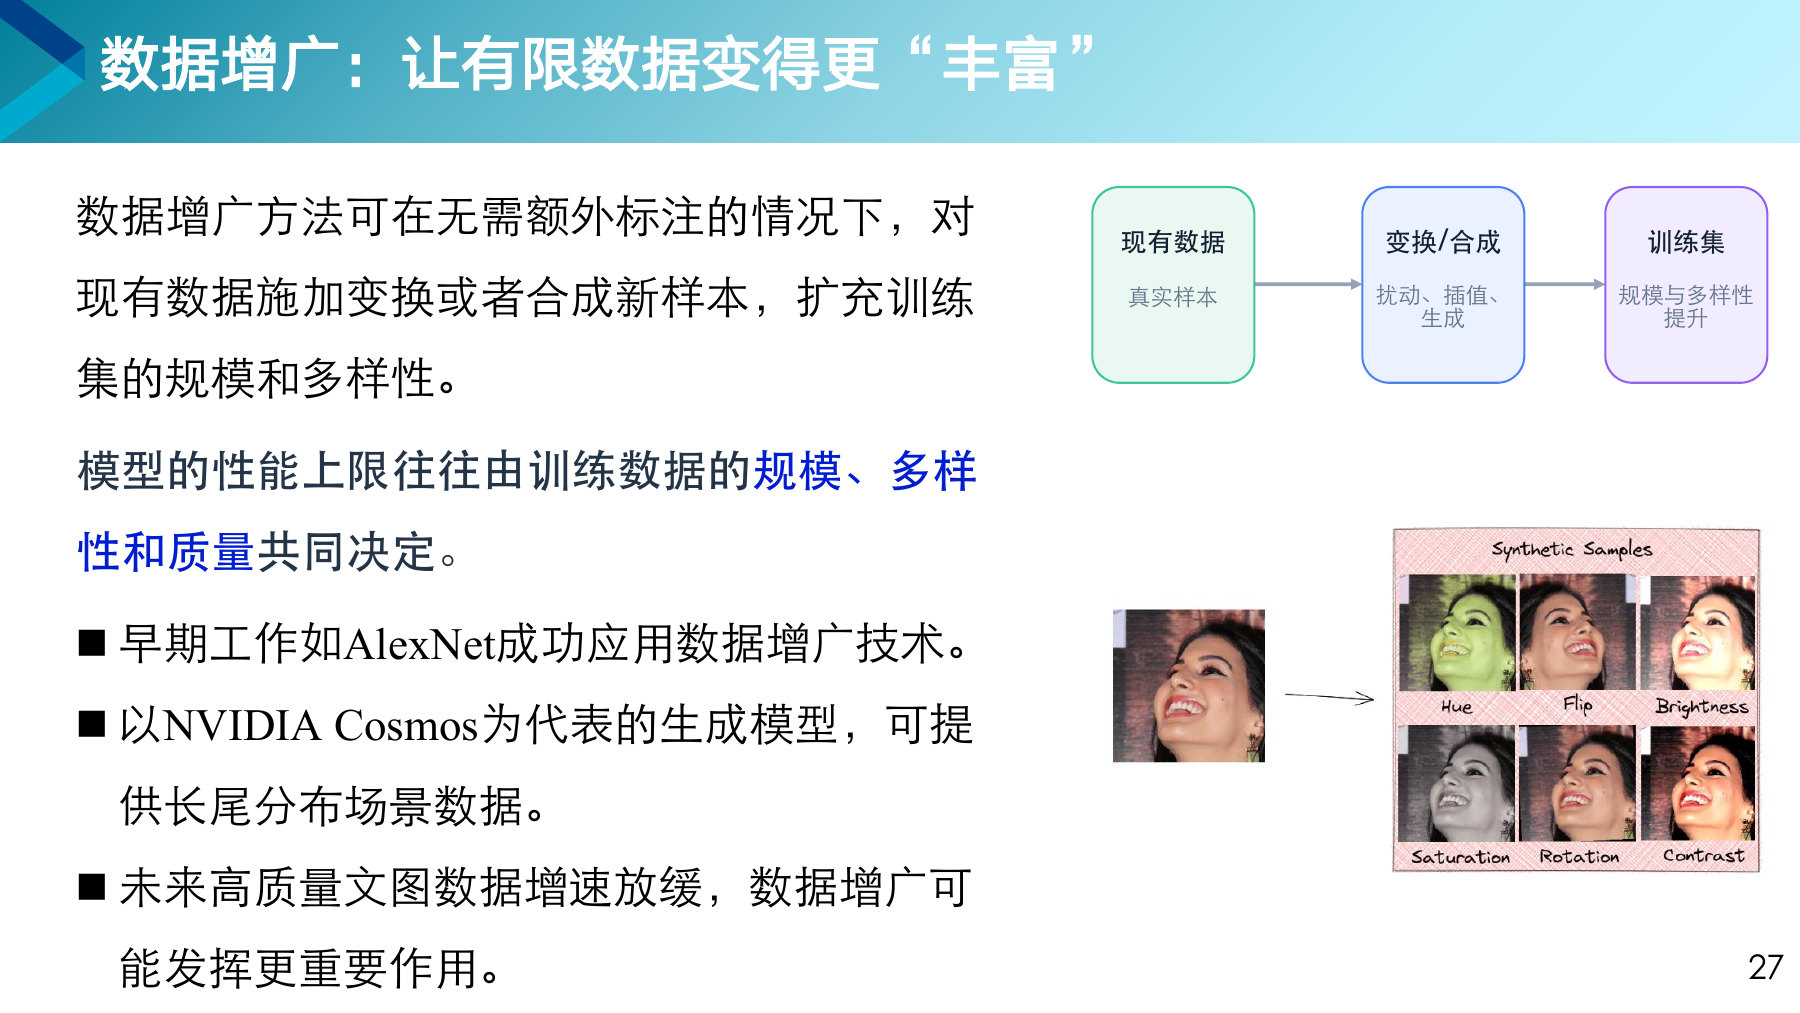
一张人脸照片,改色调、翻转、调亮度、调饱和度、旋转、调对比度,就变出了六张。对人来说还是同一个人,对模型来说是六个新样本,标签也不用重新标。
2012 年的 AlexNet 训练时就随机裁剪和翻转图片,这是它赢得那年图像识别比赛的原因之一。今天还可以用生成模型直接造数据,比如英伟达的 Cosmos 能生成现实中很少遇到的场景。
换个位置、方向、光线和颜色,猫还是那只猫。
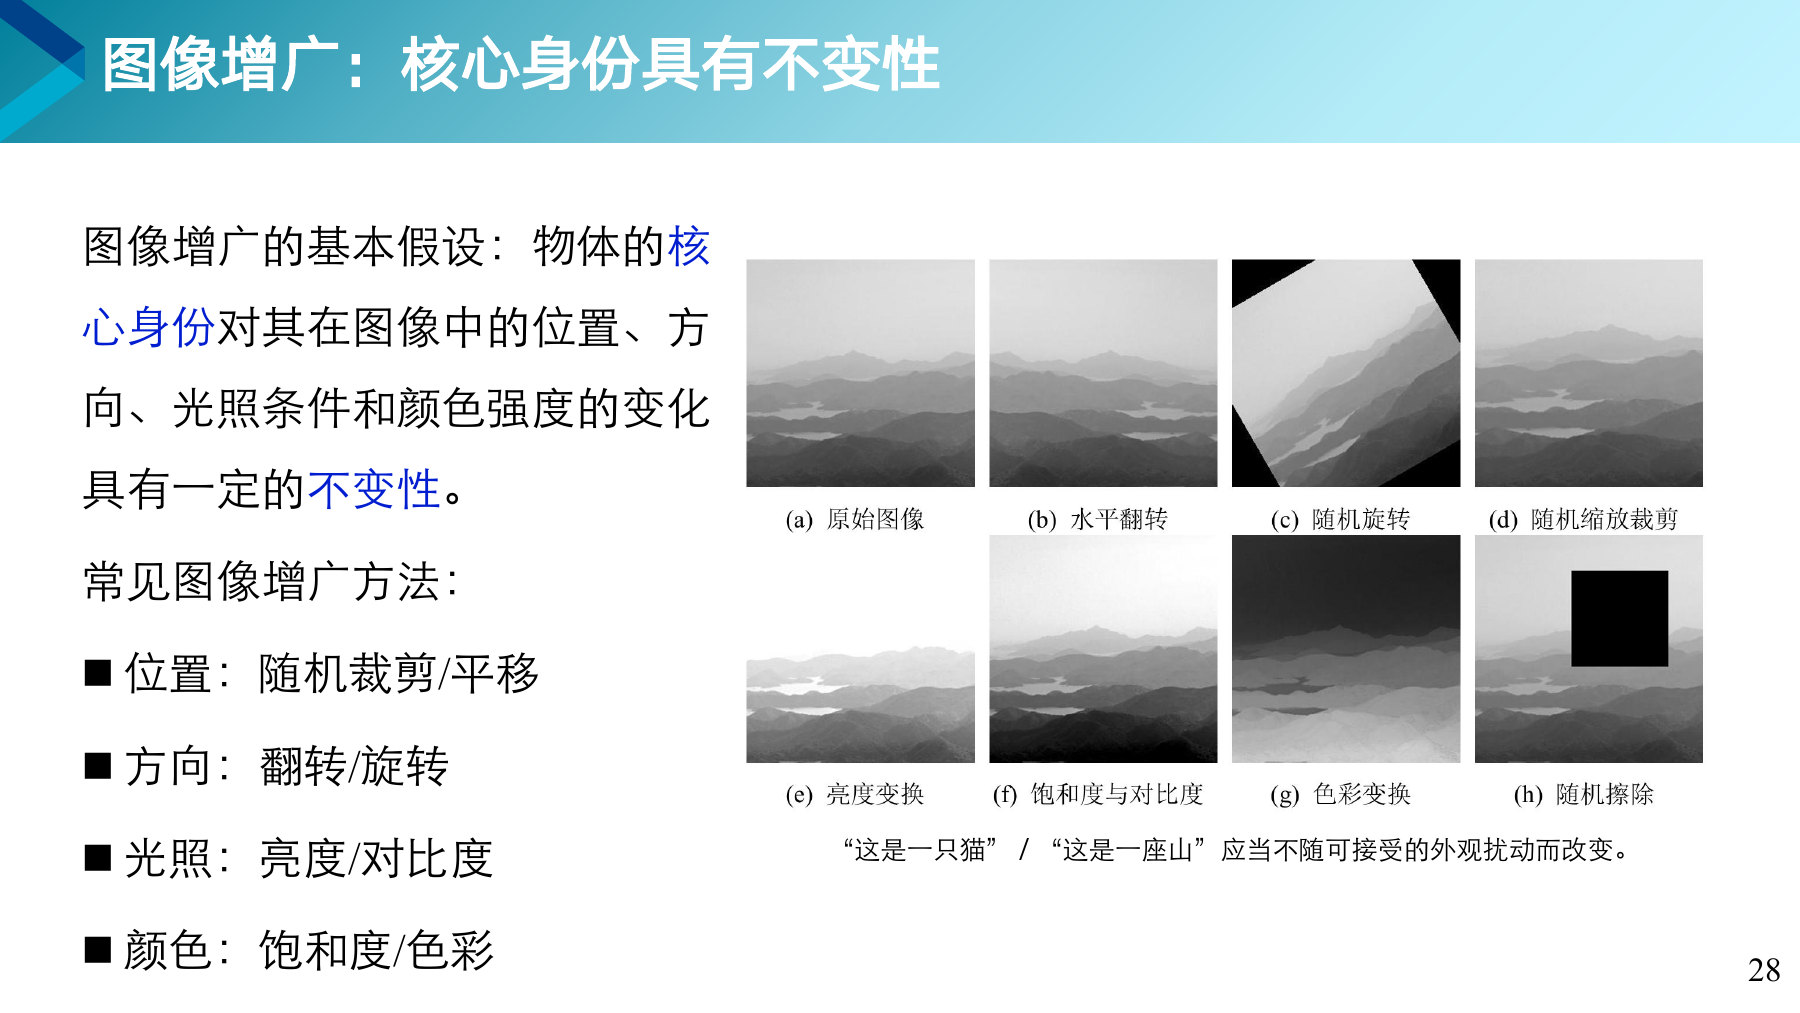
位置变了用随机裁剪和平移,方向变了用翻转和旋转,光线变了调亮度和对比度,颜色变了调饱和度和色彩。右边 (a) 是原图,(b) 到 (h) 是七种变换,(h) 是随机擦掉一块。
识别文字时,左右翻转会让字变成反的。识别手写数字时,把 6 转 180 度就成了 9。增广之前要先想清楚,这个变换会不会改变正确答案。
训练一个识别手写数字的模型,下面哪种增广最不合适?
图片按比例混合,标签也按同样的比例混合。
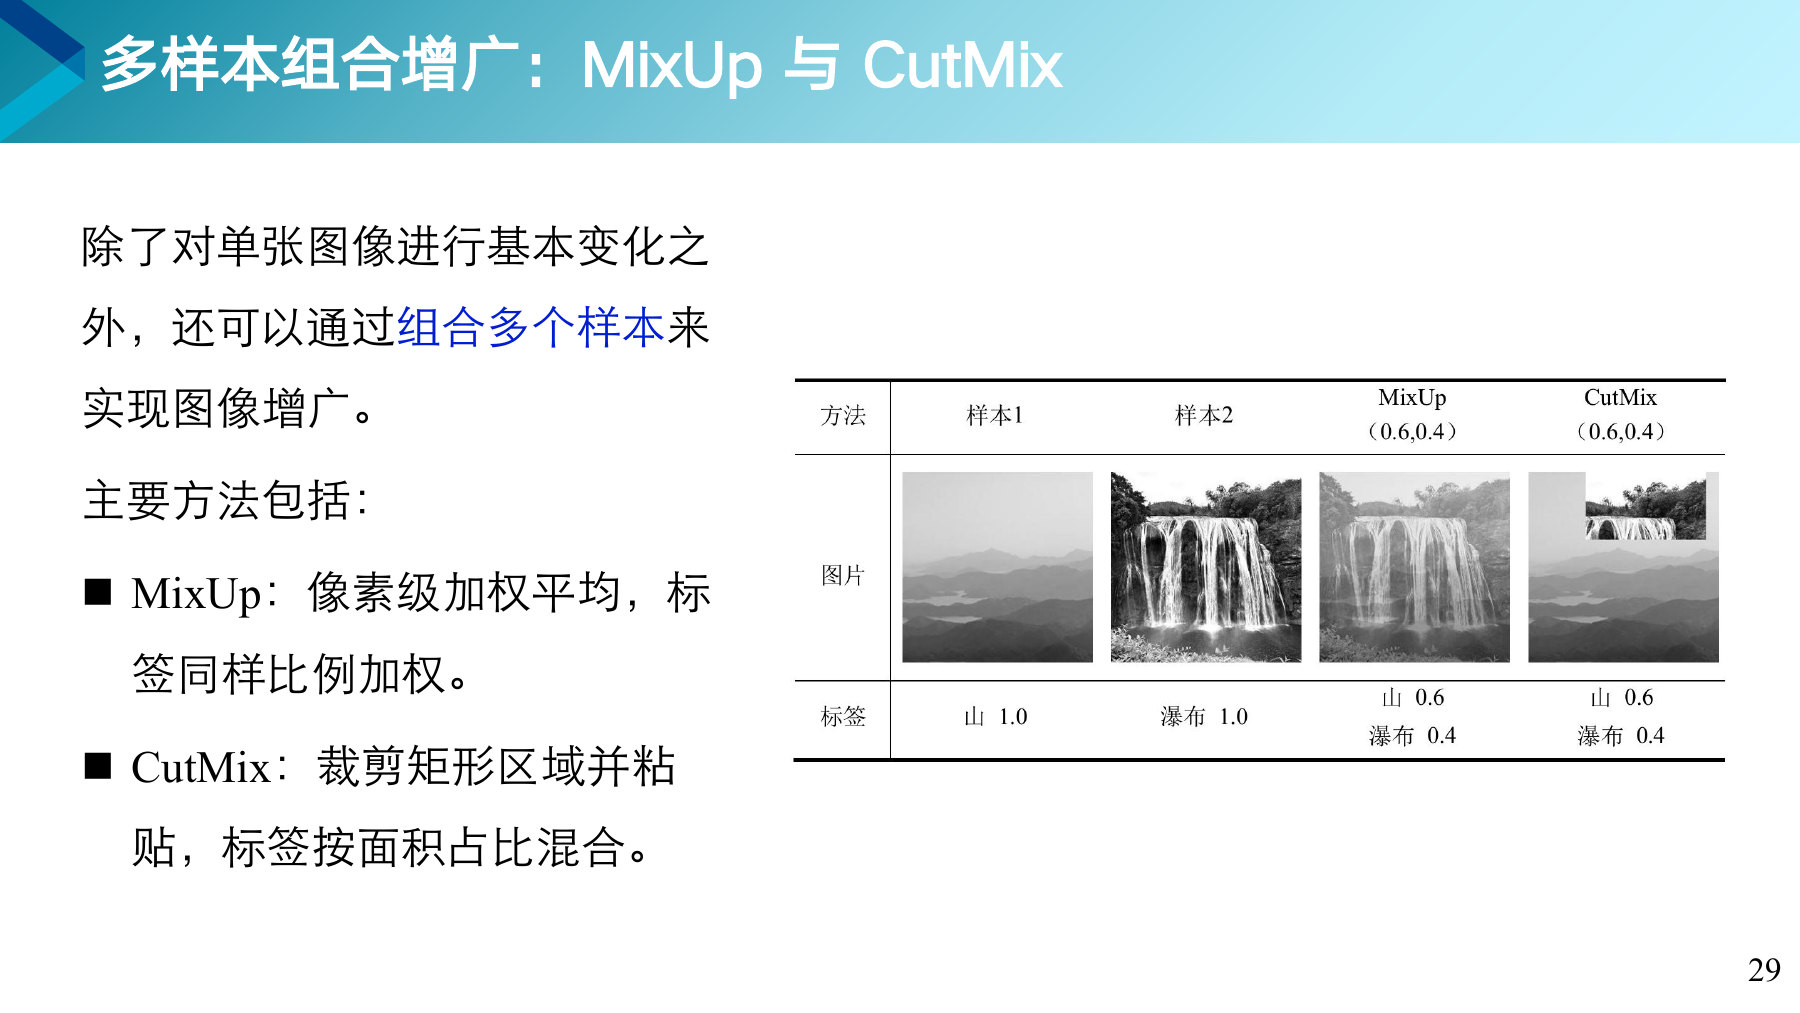
两张图的标签原本各是“山 1.0”和“瀑布 1.0”。MixUp 取 0.6 份山、0.4 份瀑布叠在一起,标签是“山 0.6,瀑布 0.4”。CutMix 那张图里贴上的瀑布约占两成,按面积算,标签应接近“山 0.8,瀑布 0.2”,表里的 0.6 和 0.4 只是示意。
用 CutMix 从一张狗的图上剪下一块,贴到猫的图上,贴上去的部分占整张图的 25%。新图的标签是什么?
文字改一个字就可能变了意思,增广时要格外小心。
| 方法 | 做法 | 改完的句子 |
|---|---|---|
| 同义词替换 | 换掉一两个词 | 这部电影的演出绝对是出色的。 |
| 随机插入 | 把某个词的同义词插到随机位置 | 这部电影的表演卓越且绝对是精彩的。 |
| 随机交换 | 交换两个词的位置 | 这部电影的表演是绝对精彩的。 |
| 随机删除 | 随机删掉一个词 | 这部电影的表演是精彩的。 |
| 回译 | 翻成外语,再翻回来 | 这部电影的演技简直出神入化。 |
| 生成 | 让大模型按要求写新句子 | 该片演员的表演堪称精湛。 |
图片调亮一点,猫还是猫。文字不一样,增删一个字就可能让意思完全改变。所以文本增广要守住两条:意思不能变,语法要通顺。表里随机插入、随机交换的结果读着有点别扭,这类简单做法改完常要再筛一遍。
不同数据有不同的增广办法,增广也不是越多越好。
| 数据 | 常见做法 | 说得直白些 |
|---|---|---|
| 时序信号 | 动态时间规整、频域扰动 | 把一段心电图或声音稍微拉长、压短,或加一点细小的波动 |
| 雷达点云 | 目标级粘贴、极端天气仿真 | 把别处扫到的汽车、行人“贴”进场景,或模拟雨雪雾天 |
| 跨模态数据 | 时空维度严格对齐 | 视频和声音要一起裁剪,图片左右翻转时,文字描述里的“左”“右”也要对调 |
| 强化学习 | 域随机化 | 在模拟器里随机改变摩擦、光照、颜色,让机器人不挑环境 |
控制每种变换的强度和使用的概率,挑和任务相符的多种变换搭配着用。训练时还要随时检查,不同类别的样本在模型眼里是不是还分得开。