模型迁移
不必每个任务都从零练起,把学过的本事搬过去用。

关键术语
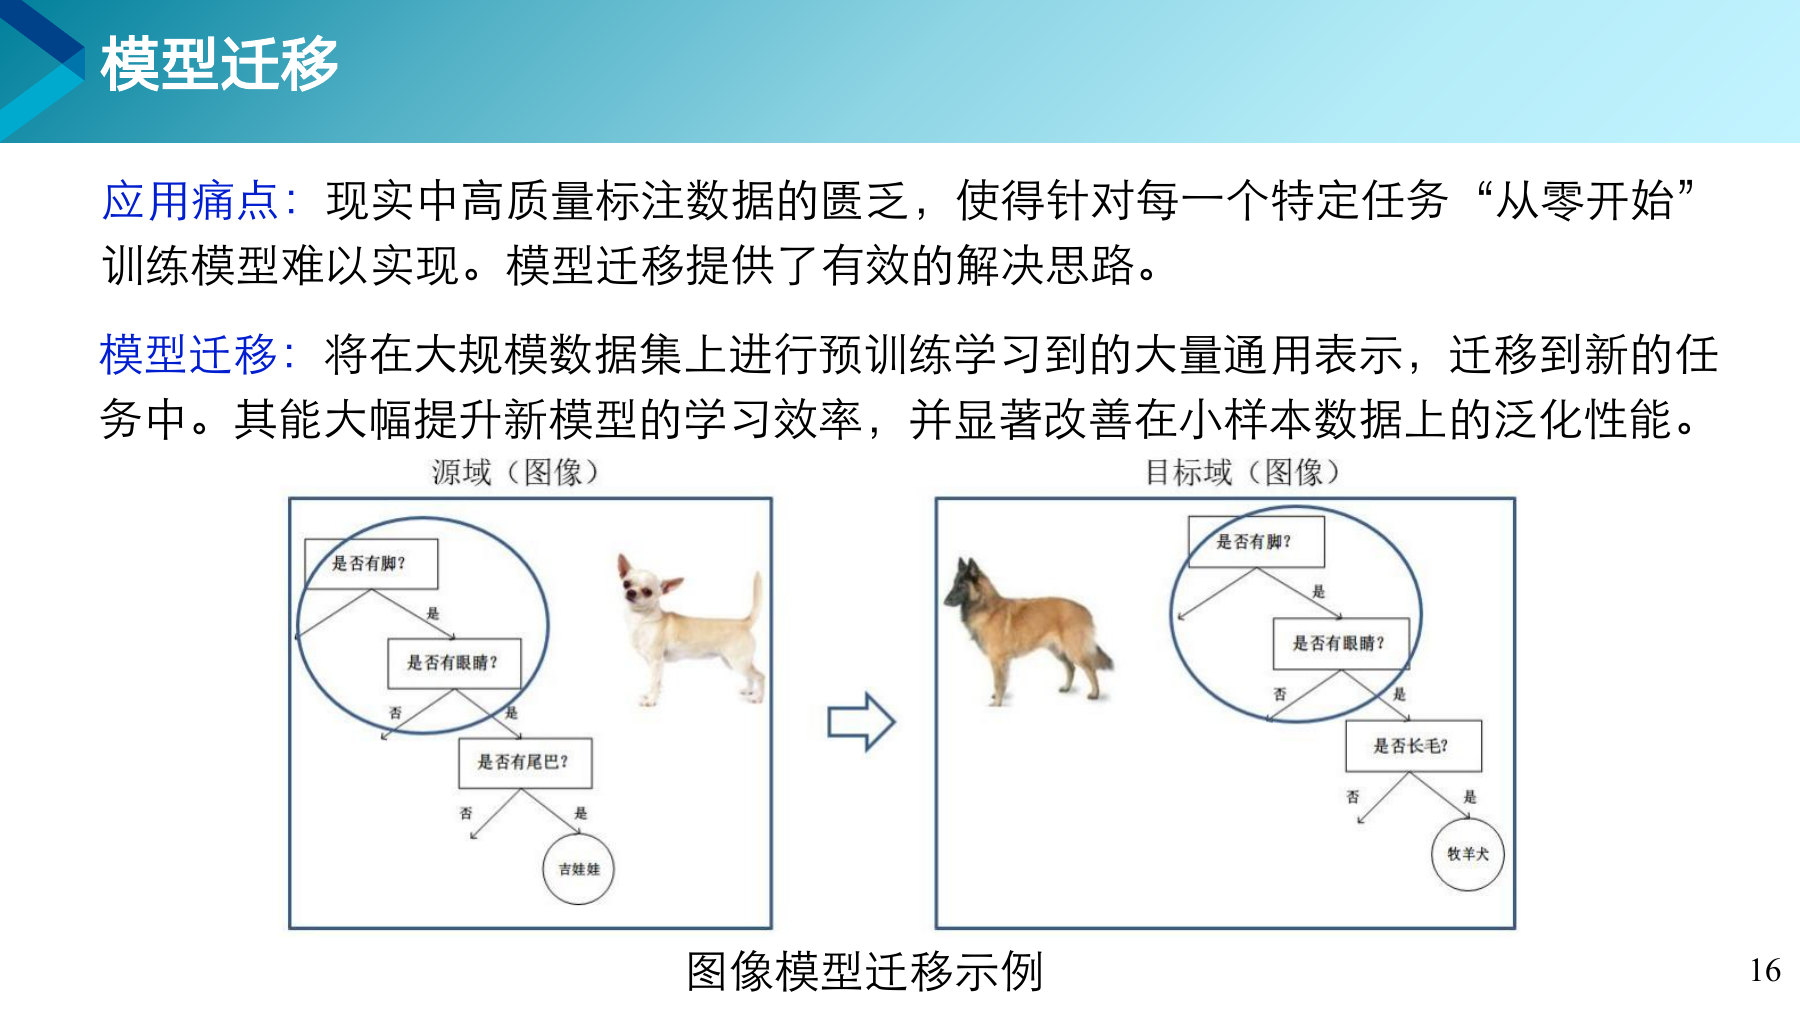
重 点看图上的两棵决策树
左边的模型会认吉娃娃,右边要认牧羊犬。“有没有脚”“有没有眼睛”这些判断两边都用得上,直接搬过来。只有最后一步需要改,把“有没有尾巴”换成“是不是长毛”。
打个比方
学过钢琴的人去学电子琴,识谱、节奏、指法都能直接用,只需要熟悉新琴的按键和音色。
不必每个任务都从零练起,把学过的本事搬过去用。

左边的模型会认吉娃娃,右边要认牧羊犬。“有没有脚”“有没有眼睛”这些判断两边都用得上,直接搬过来。只有最后一步需要改,把“有没有尾巴”换成“是不是长毛”。
学过钢琴的人去学电子琴,识谱、节奏、指法都能直接用,只需要熟悉新琴的按键和音色。
预训练模型可以原样拿来用,也可以在它的基础上再练一练。
| 做法 | 怎么做 | 适合什么情况 |
|---|---|---|
| 模型复用 | 预训练模型一个参数都不动,只训练后面新接的小头 | 数据很少,新任务和原来很像 |
| 全部微调 | 预训练模型的参数也跟着小幅调整 | 数据多一些,想要效果更好 |
| 参数高效微调 | 原模型不动,插入一小块新参数来训练 | 模型很大,全部微调太费钱 |
把 DINOv3 当成现成的看图工具,参数全部冻结,后面接一个小小的分割头,只训练这个头,就能把月球地面照片里的不同地貌分出来。
用预训练模型做复用时,训练过程中哪一部分的参数会改变?
从图片和文字里学到的常识,被搬到了机器人的动作上。
什么是杯子、什么是衣服、“叠好”是什么意思,这些常识是视觉语言模型在网上的图片和文字里学到的。
手臂先往哪伸、夹多紧、转多少度,这些要靠机器人的示范数据和实际练习来学。
一个读过很多菜谱、看过很多做菜视频的人,知道番茄炒蛋该怎么做,第一次真下厨时手还是会生。菜谱里的知识是搬来的,颠勺的手感要自己在灶台前练。
把 32 位的小数换成 8 位的整数,模型小了四分之三。
| 原来的权重(32 位) | 乘以 127 后取整(8 位) | 用时再除以 127 | 误差 |
|---|---|---|---|
| 0.7324 | 93 | 0.7323 | 0.0001 |
| −0.2150 | −27 | −0.2126 | 0.0024 |
| 0.0468 | 6 | 0.0472 | 0.0004 |
| −0.9031 | −115 | −0.9055 | 0.0024 |
模型训练好以后直接换算,只用少量数据看一看每层数值的范围。不用重新训练,又快又省事。
训练时就模拟取整带来的误差,让模型提前适应。要重新训练,误差更小。
记账时把 12.37 元记成 12.4 元,每个数少记一位小数,账本省了地方,月底算总账也差不了多少。
一个 70 亿参数的模型,每个参数从 32 位换成 4 位,大约要多少存储?
很多权重接近 0,对结果影响很小,可以剪掉。
绝对值小于 0.1 的权重一律清零。清掉的数零零散散,剩下的格子形状不规整。
每一行是连到同一个神经元的四个权重。第 2 行的四个都很小,说明这个神经元作用不大,就把整行拿掉。剩下的仍是规整的 3 行 4 列。
整理书架时,从每本书里撕掉几页用不着的,书一本不少,照样占着地方。把整本不看的书拿走,书架才真的空出位置。前一种像非结构化剪枝,后一种像结构化剪枝。
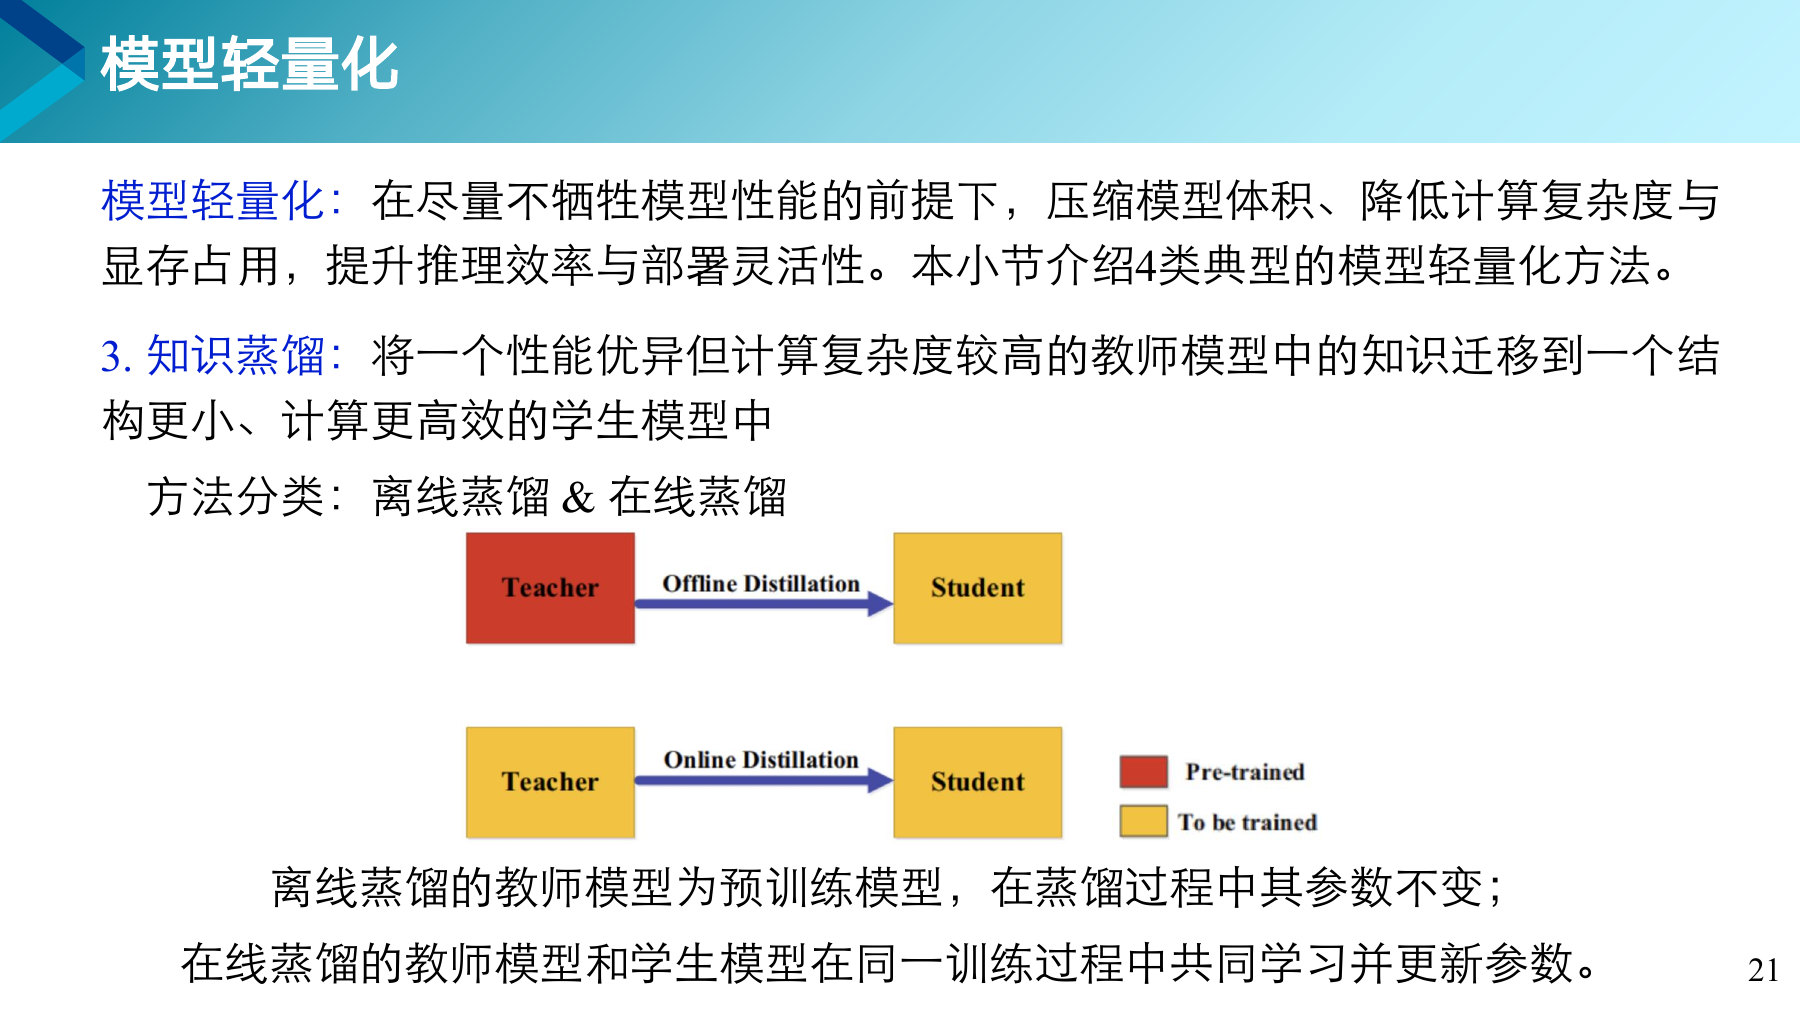
让一个小的学生模型,去模仿一个大的教师模型的答案。

红色表示已经训练好的,黄色表示正在训练的。离线蒸馏的教师早就训练好了,蒸馏时参数不变,只有学生在学。在线蒸馏的教师和学生在同一次训练里一起学、一起更新。
大模型看一张猫的照片,不只说“是猫”,还会给出“像猫 0.90,像狗 0.08,像老虎 0.02”。学生从这些数里还能学到,猫和狗、老虎都有几分像。这比只告诉它一个“猫”字有用得多。
一个把算过的存起来,一个让小模型先猜、大模型核对。
不存的话,每写一个新字都要把前面的字重新算一遍,写 100 个字共要处理 1 + 2 + … + 100 = 5050 次。把算过的中间结果存下来,每个字只算一次,共 100 次。
小模型很快猜出后面几个字,大模型一次核对完。猜对的直接用,第一个猜错的字换成大模型自己的答案。
大模型自己写,一次只能写一个字。核对时几个字可以一次算完,花的时间和写一个字差不多。小模型大多数时候猜得准,整体就能快上两三倍。
按面板里的例子,这一轮大模型跑了几次,得到了几个字?
自监督练出本领,迁移搬走本领,轻量化让模型跑得动。
| 要解决的问题 | 办法 | 一句话记住 |
|---|---|---|
| 没有人来标注 | 自监督学习 | 数据自己出题:遮住再补,或者认出同一张图 |
| 对比学习怎么算 | InfoNCE 损失 | 正样本在所有候选里的份额越大,损失越小 |
| 每个任务从零练太贵 | 模型迁移 | 复用或微调,把学过的本事搬过去 |
| 模型太大跑不动 | 模型轻量化 | 量化换短数,剪枝去连接,蒸馏换小模型,推理时存结果、先猜后验 |
先用没有标注的海量数据练出一个大模型,再把它迁移到各种具体任务上,最后压小,放进手机和普通电脑里用。今天很多人工智能产品都是沿着这条路做出来的。
想让一个大模型装进手机里运行,下面哪种办法不属于模型轻量化?