人工智能导论 第 3 章 · 第七节
课程 › 第 3 章 › 第七节 动态规划探索与利用Q 学习稀疏奖励深度强化学习多智能体本节小结课后交流
第 3 章 机器学习基础 · 第七节

强化学习的求解与前沿

怎样把价值算出来,以及还有哪些难题
本 节 知 识 点
  1. 55动态规划
  2. 56探索与利用
  3. 57Q 学习
  4. 58稀疏奖励问题
  5. 59深度强化学习进展
  6. 60多智能体强化学习
  7. 61小结与思考
  8. 62课后欢迎交流
55
第 3 章 · 第七节

动态规划

迷宫的规则全部已知时,可以一轮一轮把每一格的价值算出来。

第 55 页 用动态规划求解迷宫

价值从目标开始,一圈一圈往外铺

第 0 轮0000000目标00000扫完第 1 轮00000010.0目标10.00010.00扫完第 3 轮0008.109.010.0目标10.08.19.010.09.0
  • 第 1 步 所有格子的价值先设为 0。
  • 第 2 步 逐格计算:几个方向各算一遍“奖励 + 0.9 × 邻格的价值”,把最大的写回这一格。
  • 第 3 步 重复第 2 步,直到所有数字都不再变化。
  • 第 4 步 每一格都选第 2 步里算出来最大的那个方向走,这就是最优策略。

关键术语

动态规划Dynamic Programming
把一个大问题拆成许多小问题,从已知的一端往回推算。

重 点它有一个前提

必须事先知道每个动作会把你带到哪里。迷宫的规则是清楚的,所以能算。现实中的大多数问题并不知道这些规则,后面的 Q 学习就是为了解决这个难处。

打个比方

往水塘里丢一颗石子,波纹从落点一圈圈荡开。价值也是从目标开始,每算一轮就往外扩一格。实验四可以按着按钮,一轮一轮地看这个过程。
56
第 3 章 · 第七节

探索与利用

走熟悉的路稳当,试新路可能更好,每一步都要在两者之间取舍。

第 56 页课件

关键术语

利用Exploitation
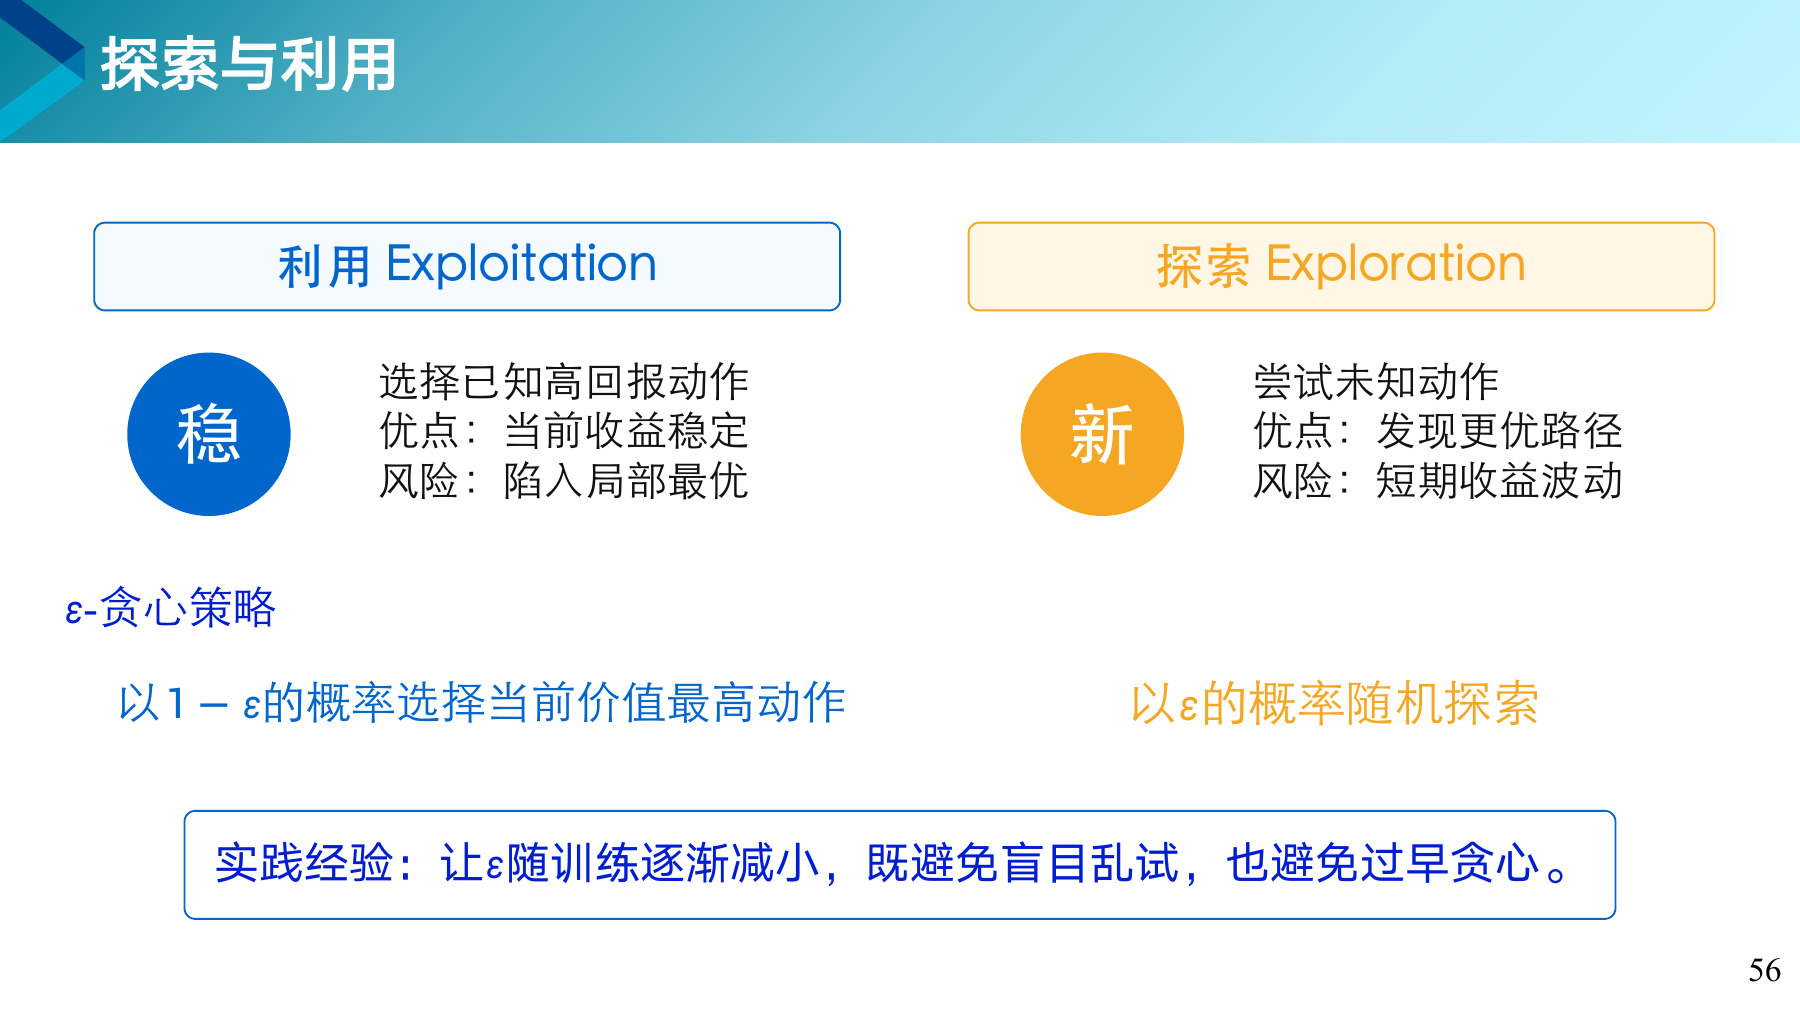
选目前已知最好的动作。
探索Exploration
试一试还没有把握的动作。
ε 贪心ε-greedy
以 1 − ε 的概率选目前最好的动作,以 ε 的概率随机试一个。ε 取 0.1,就是十次里九次按经验走,一次随便试。

重 点ε 为什么要慢慢变小

刚开始什么都不了解,多试一试才能发现好路。学得差不多了,就少试多用。所以 ε 通常随着训练逐渐减小。

打个比方

学校门口有家吃惯了的面馆,每次都去很稳妥,却可能错过更好吃的。每次都换新店,又容易踩雷。大多数时候去老店、偶尔试一家新店,是比较合理的做法。

57
第 3 章 · 第七节

Q 学习

不知道迷宫的规则也没关系,边走边把每个动作的价值记下来。

第 57 页 Q 学习

Q 表:记着每一步好坏的本子

所在格子往上 ↑往下 ↓往左 ←往右 →
(1,1)5.34.85.35.9
(2,4)7.39.08.18.1
(3,2)9.08.19.010.0
(4,3)10.09.08.18.1
走一步在当前格子
选一个方向走
→
看结果拿到多少奖励,
到了哪一格
→
改本子按“奖励 + 0.9 × 新格子那一行
最大的数”改写刚走的那个数
反复走上成千上万步,表里的数就越改越准。用的时候,站在哪一格就查哪一行,挑最大的那个数。
表中数字沿用前面的迷宫:走进目标得 10 分,γ 取 0.9,撞墙就留在原地。

关键术语

Q 学习Q-Learning
通过和环境反复交互,直接估计每个状态下每个动作的价值。
Q 表Q-Table
行是状态,列是动作,每一格记着这个动作的价值估计。

打个比方

动态规划像手里有一张完整的地图,在家就能算好路线。Q 学习像没有地图,每天实地走一走,在本子上记下“这个路口往哪边走比较好”,走得多了,本子就靠得住了。

随堂练习

按左边这张 Q 表,站在 (3,2) 这一格,应该往哪走?

  1. 往上
  2. 往下
  3. 往左
  4. 往右
查看答案
答案 D。查 (3,2) 这一行,往右是 10.0,最大。往右一步正好走进目标。
58
第 3 章 · 第七节

稀疏奖励问题

下完一整盘棋才知道输赢,很难说清是哪一步起了作用。

第 58 页课件

重 点什么是稀疏奖励

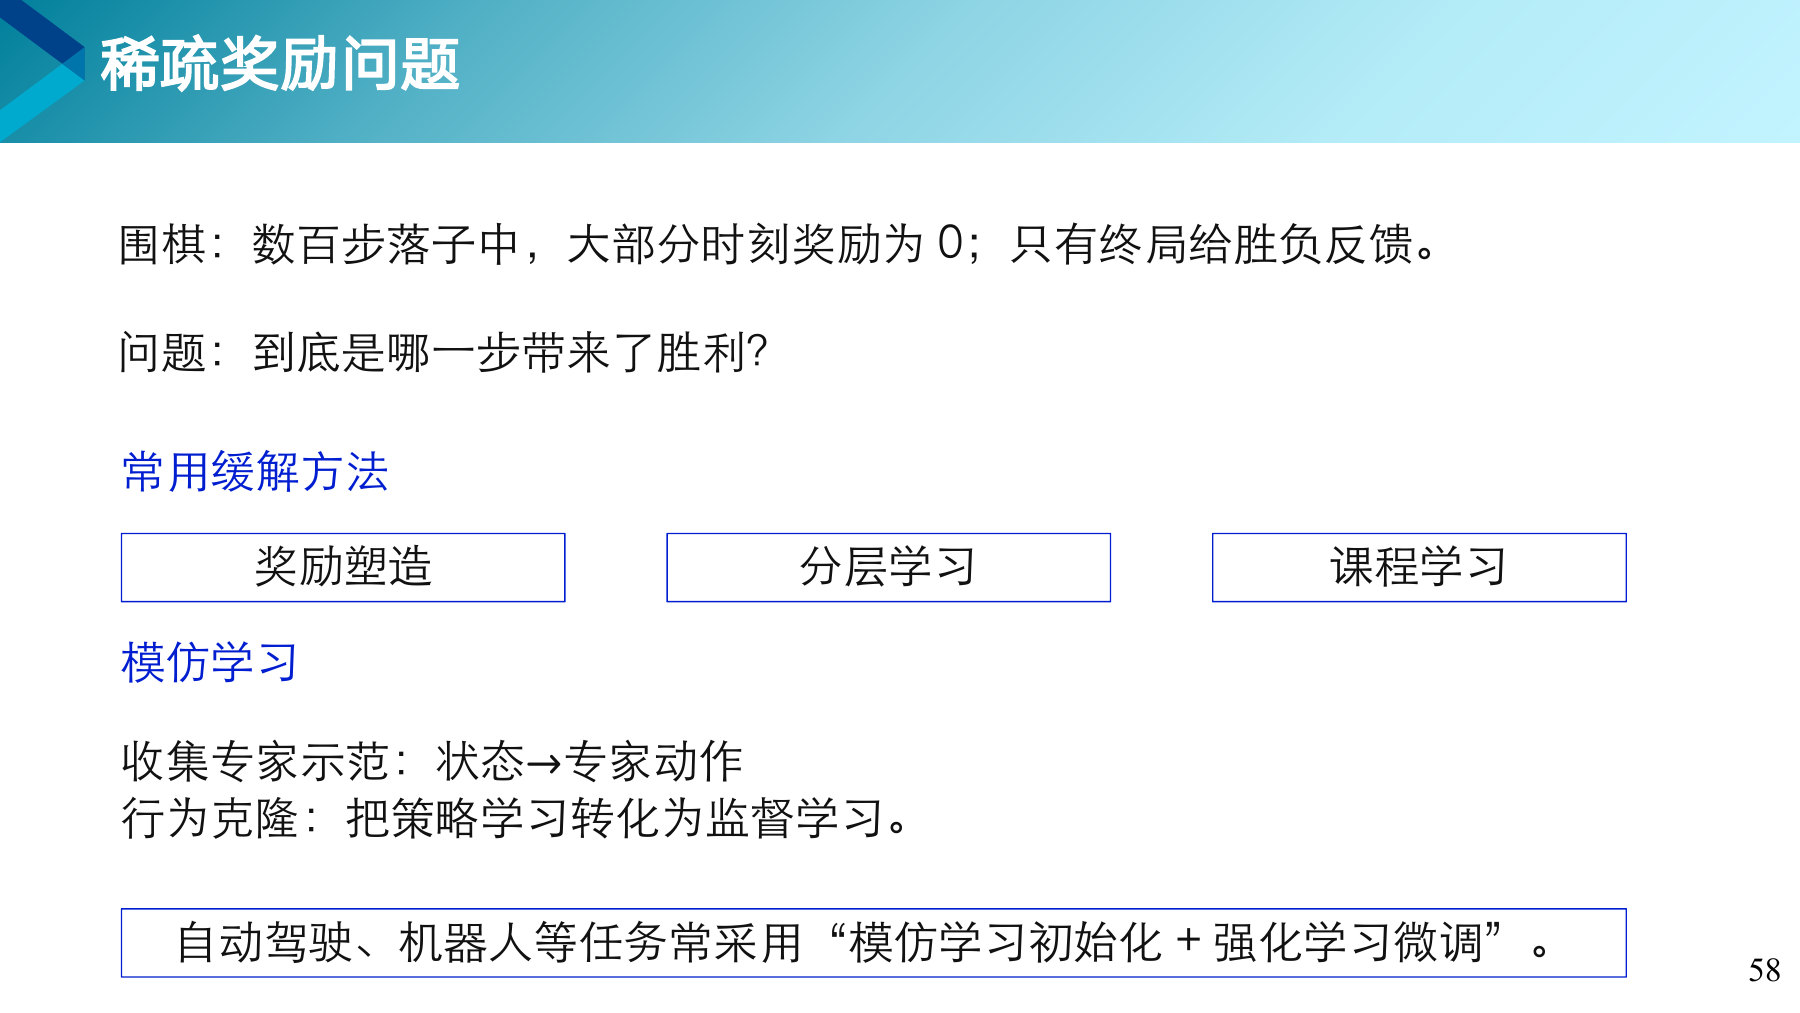
围棋一盘几百步,中间每一步的奖励都是 0,只有最后才知道赢还是输。有用的反馈太少,智能体很难知道该改哪一步,学起来很慢。

打个比方

做完一整套三十道题的卷子,只告诉你“及格了”,不说哪道对、哪道错。这样的反馈很难拿来改进。

知道更多课件上的几种办法

奖励塑造是在中间多给一些小奖励。分层学习是把大目标拆成小目标。课程学习是先学简单的,再学难的。模仿学习是先照着专家的示范学个大概,再自己试错改进,自动驾驶和机器人常这样做。

59
第 3 章 · 第七节

深度强化学习进展

表格装不下的时候,换成神经网络来估价值。

第 59 页 深度强化学习进展

Q 表装不下了,怎么办

Q 表

状态少的时候很好用。可一盘围棋可能出现的局面比宇宙里的原子还多,这样的表根本存不下,也填不满。

神经网络

输入一个局面,直接算出每个动作的价值,或者直接给出该做的动作。这就是深度强化学习。

课件上的名字擅长做什么
PPO 近端策略优化稳定、通用,训练游戏 AI 和聊天大模型时常用
GRPO 群组相对策略优化训练大语言模型解数学题、写代码时的推理能力
DDPG 深度确定性策略梯度动作是连续变化的数,比如机械臂要转多少度
三个算法的细节属于后续课程,这里认识名字、知道它们用在哪里就够了。

重 点为什么要加上“深度”

状态太多时,表格存不下,也不可能每一格都走到。换成神经网络以后,遇到没见过的局面也能估出价值。2015 年学会玩几十种雅达利游戏的 DQN,就是这样做的。

知道更多和大模型的关系

训练聊天大模型时,会让模型先回答问题,再给回答打分,把分数当作奖励继续训练。打分可以来自人的评价,也可以来自对答案对错的自动检查。PPO 和 GRPO 就用在这一步。

60
第 3 章 · 第七节

多智能体强化学习

好几个智能体在同一个环境里,身边既有队友也有对手。

第 60 页课件

重 点三种新情况

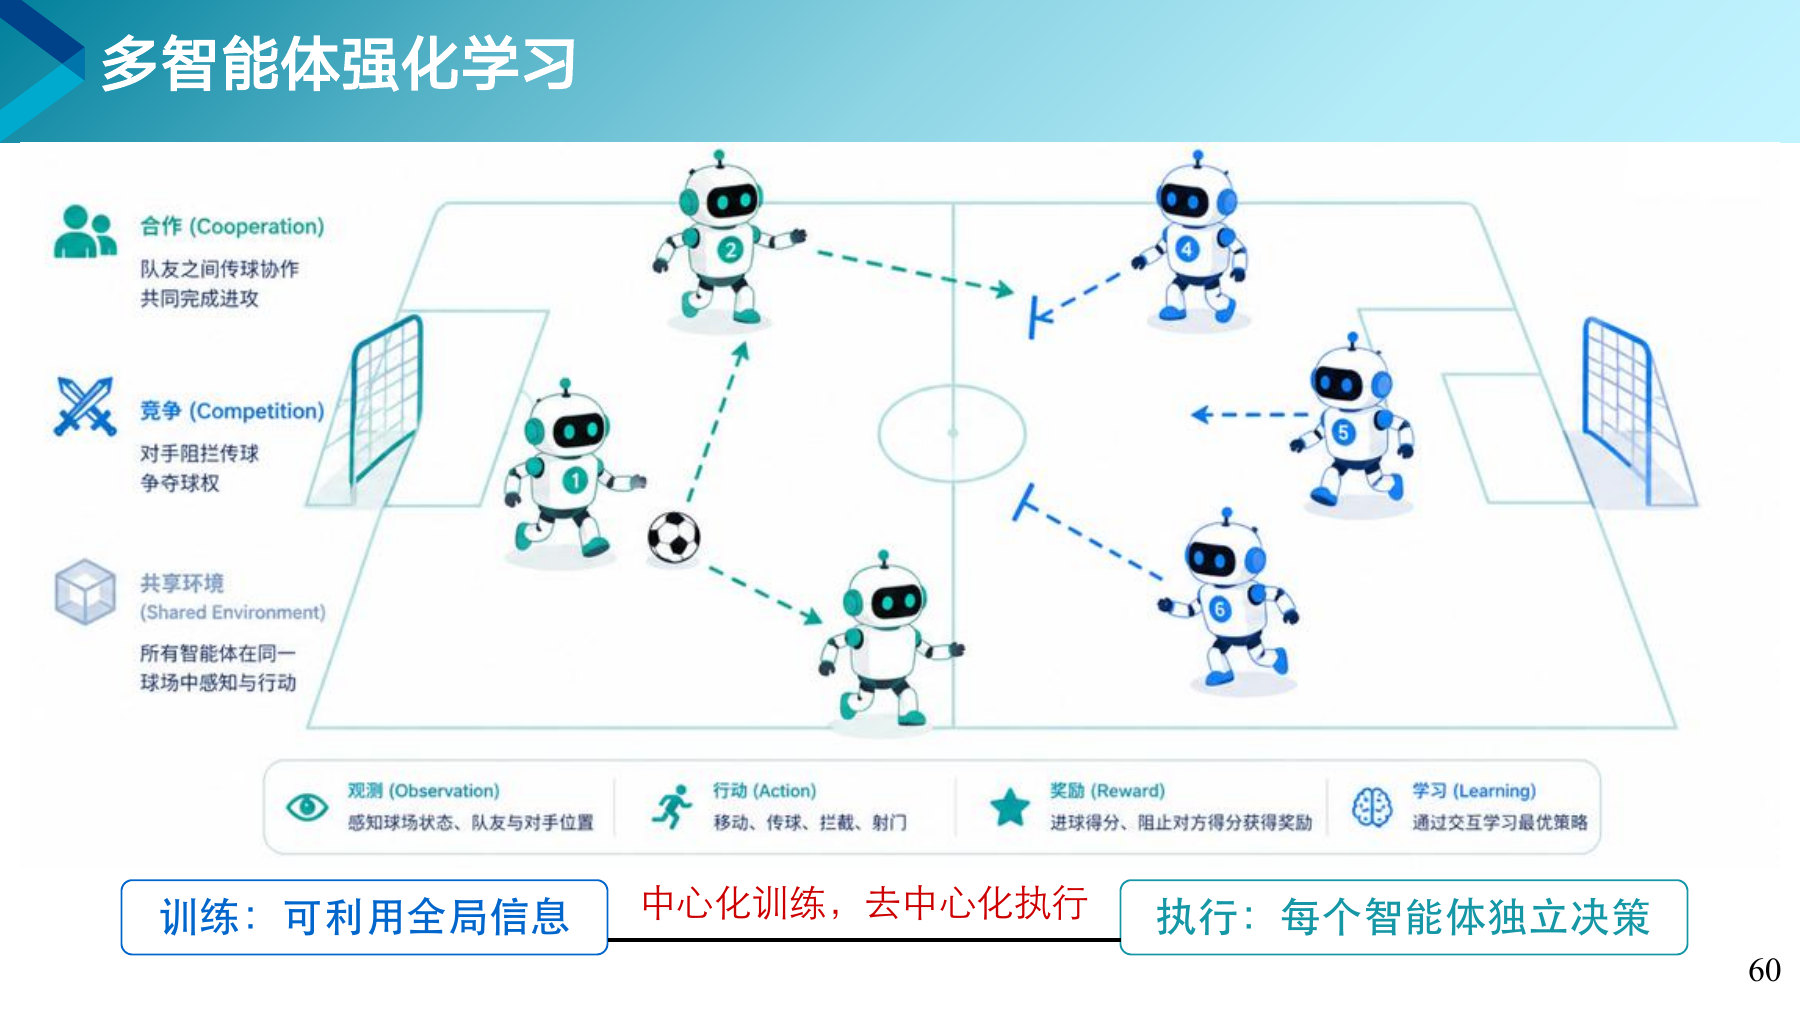
合作是队友之间互相配合,一起完成目标。竞争是对手之间争抢同一样东西。共享环境是大家在同一块场地上,谁的动作都会影响到别人。

打个比方

训练时,教练站在场边看得到全场,可以告诉球员“刚才该传给左边那个人”。正式比赛时,每个球员只能根据自己看到的情况,自己拿主意。这就是课件底部说的中心化训练、去中心化执行。

知道更多为什么更难

队友和对手也在学习、也在变化。昨天好用的打法,对手学会应对以后,今天可能就不灵了。

61
第 3 章 · 第七节

小结与思考

五个要素,一个方程,两种算法,两个难题。

第 61 页 强化学习小结

这两节讲了什么

内容
五个要素状态、动作、策略、奖励、状态转移
两种价值状态价值说这一格有多好,动作价值说在这一格这样走有多好
一个方程这一步的价值 = 眼前的奖励 + 打折后的未来价值
两种算法动态规划知道规则,一轮轮算出来。Q 学习不知道规则,边走边记
两个难题探索与利用怎样取舍,奖励太稀疏怎么办

重 点奖励决定学出什么

监督学习靠答案来学,强化学习靠奖励来学。奖励怎么给,智能体就朝哪个方向学。奖励设计得不周全,它会学出意想不到的行为。

想一想

训练一个扫地机器人,奖励该怎样设计?

查看参考思路
扫到灰尘加分,撞到家具扣分,电量用完还没回到充电座扣大分,每多走一步扣一点,促使它尽快扫完。还要防止它钻空子:如果只奖励“扫到灰尘”,它可能学会把灰尘推开再扫一遍,反复拿分。
62
第 3 章 · 第七节

课后欢迎交流

第 3 章到这里结束。

第 62 页课件

知道更多这一章学了什么

第 2 章搭好了数据、模型、目标这个框架,这一章往框架里填进了具体的方法:逻辑回归、支持向量机、决策树、K-Means、PCA,一套检验模型的办法,还有靠试错来学习的强化学习。下一章进入深度学习。

保山学院·人工智能教研室·曹鼎鼎