第 3 章 · 第六节
强化学习基础
从这一节开始,机器不再照着答案学,而是自己去试。
知道更多第 1 章提过的那条路线
第 1 章讲过行为主义,主张智能来自和环境打交道时的反复试错。强化学习就是这条路线在机器学习里的做法。AlphaGo 下围棋、机器人学走路,都用到了它。
从这一节开始,机器不再照着答案学,而是自己去试。
第 1 章讲过行为主义,主张智能来自和环境打交道时的反复试错。强化学习就是这条路线在机器学习里的做法。AlphaGo 下围棋、机器人学走路,都用到了它。
监督学习有老师给答案,强化学习只有环境给的奖励。
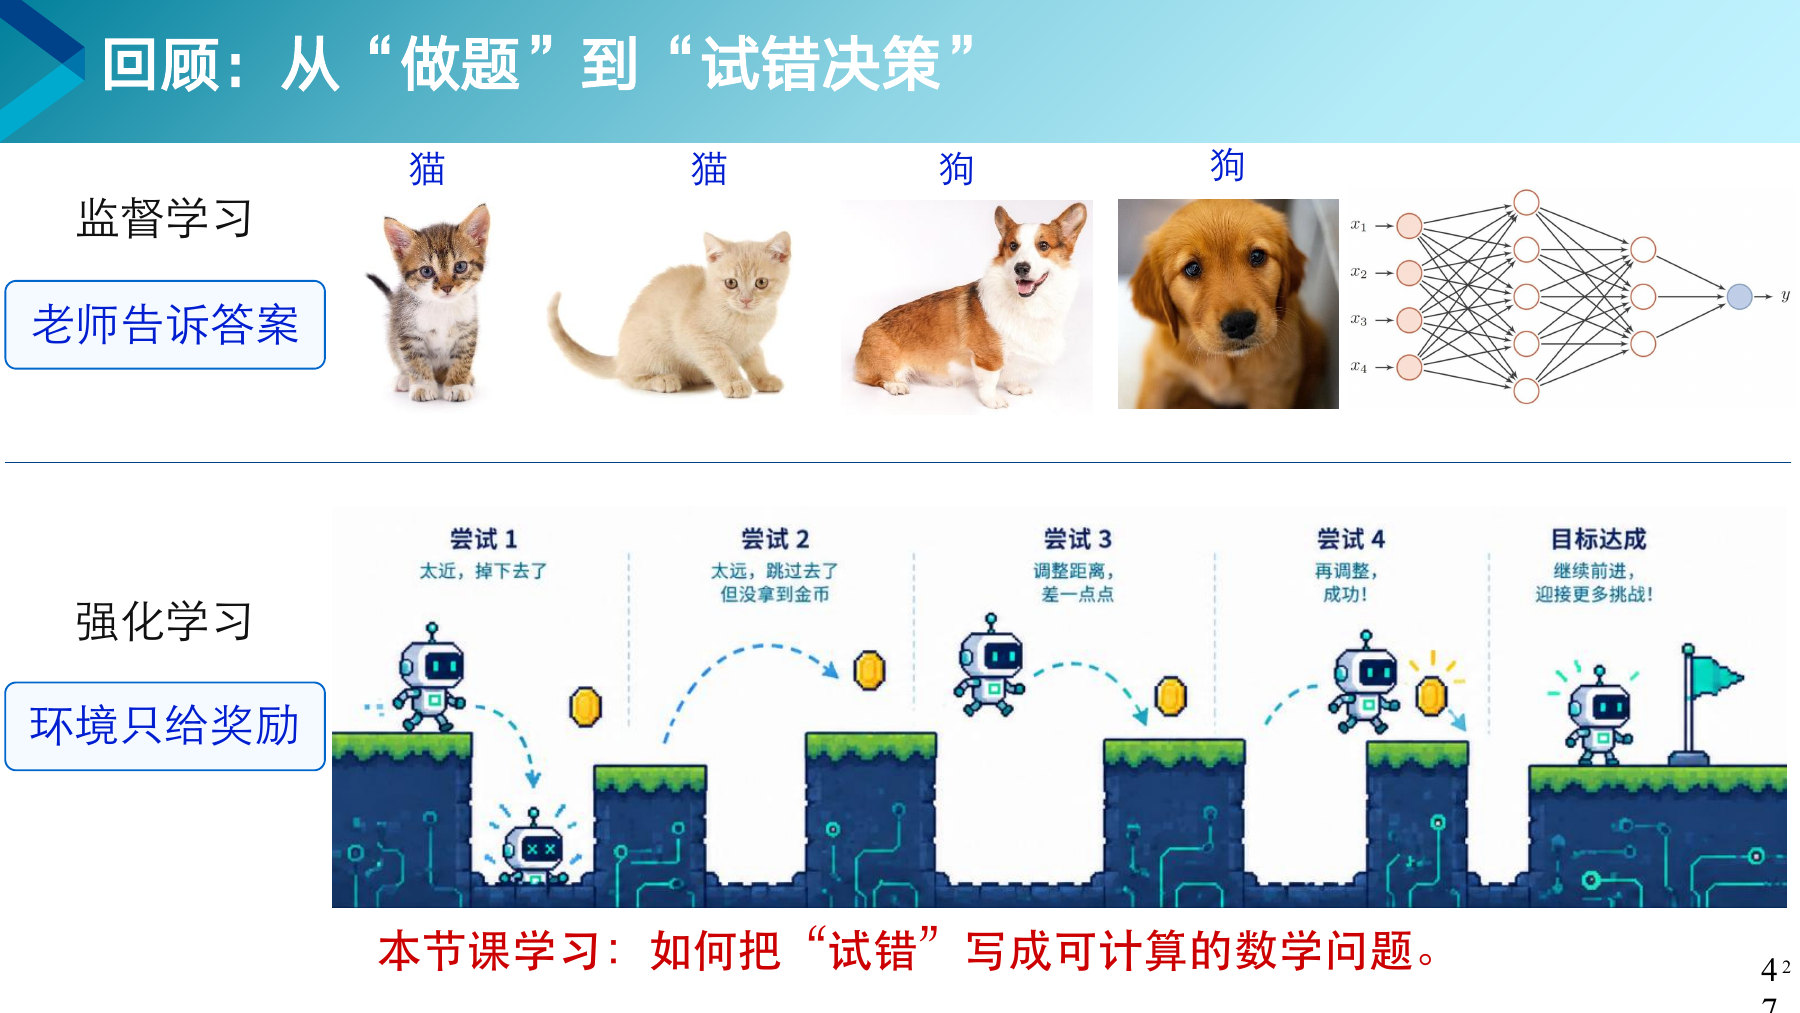
上面一行,每张照片都标好了猫或狗,机器照着答案学。下面一行,小机器人跳了四次,前几次掉下去或者跳过了头,第四次才成功。没有人告诉它每一跳该用多大的力,它只知道结果好不好。
学骑自行车时,教练说不出“车身歪了 5 度,车把该转几度”。你只能自己骑,摔了就知道刚才不对,骑稳了就知道这样可以。骑稳像是加分,摔倒像是扣分,这就是环境给你的奖励。
看局面,做动作,拿奖励,再看新局面,一直循环下去。
| 要素 | 回答的问题 | 在走迷宫里是什么 |
|---|---|---|
| 状态 | 现在是什么局面 | 站在哪一格 |
| 动作 | 下一步做什么 | 往上、下、左、右哪边走 |
| 策略 | 怎样选动作 | 每一格该往哪走的规则 |
| 奖励 | 刚才做得好不好 | 到终点加分,掉进陷阱扣分 |
| 状态转移 | 做完动作,局面怎么变 | 往右走一步,就到了右边那格 |
玩游戏时,屏幕上的画面是状态,按哪个键是动作,你心里那套“什么时候该跳”的经验是策略,分数的变化是奖励,按键之后画面怎么变是状态转移。
下面哪一项由智能体自己决定?
所有可能的局面合起来叫状态空间,每个局面下能做的动作叫动作空间。
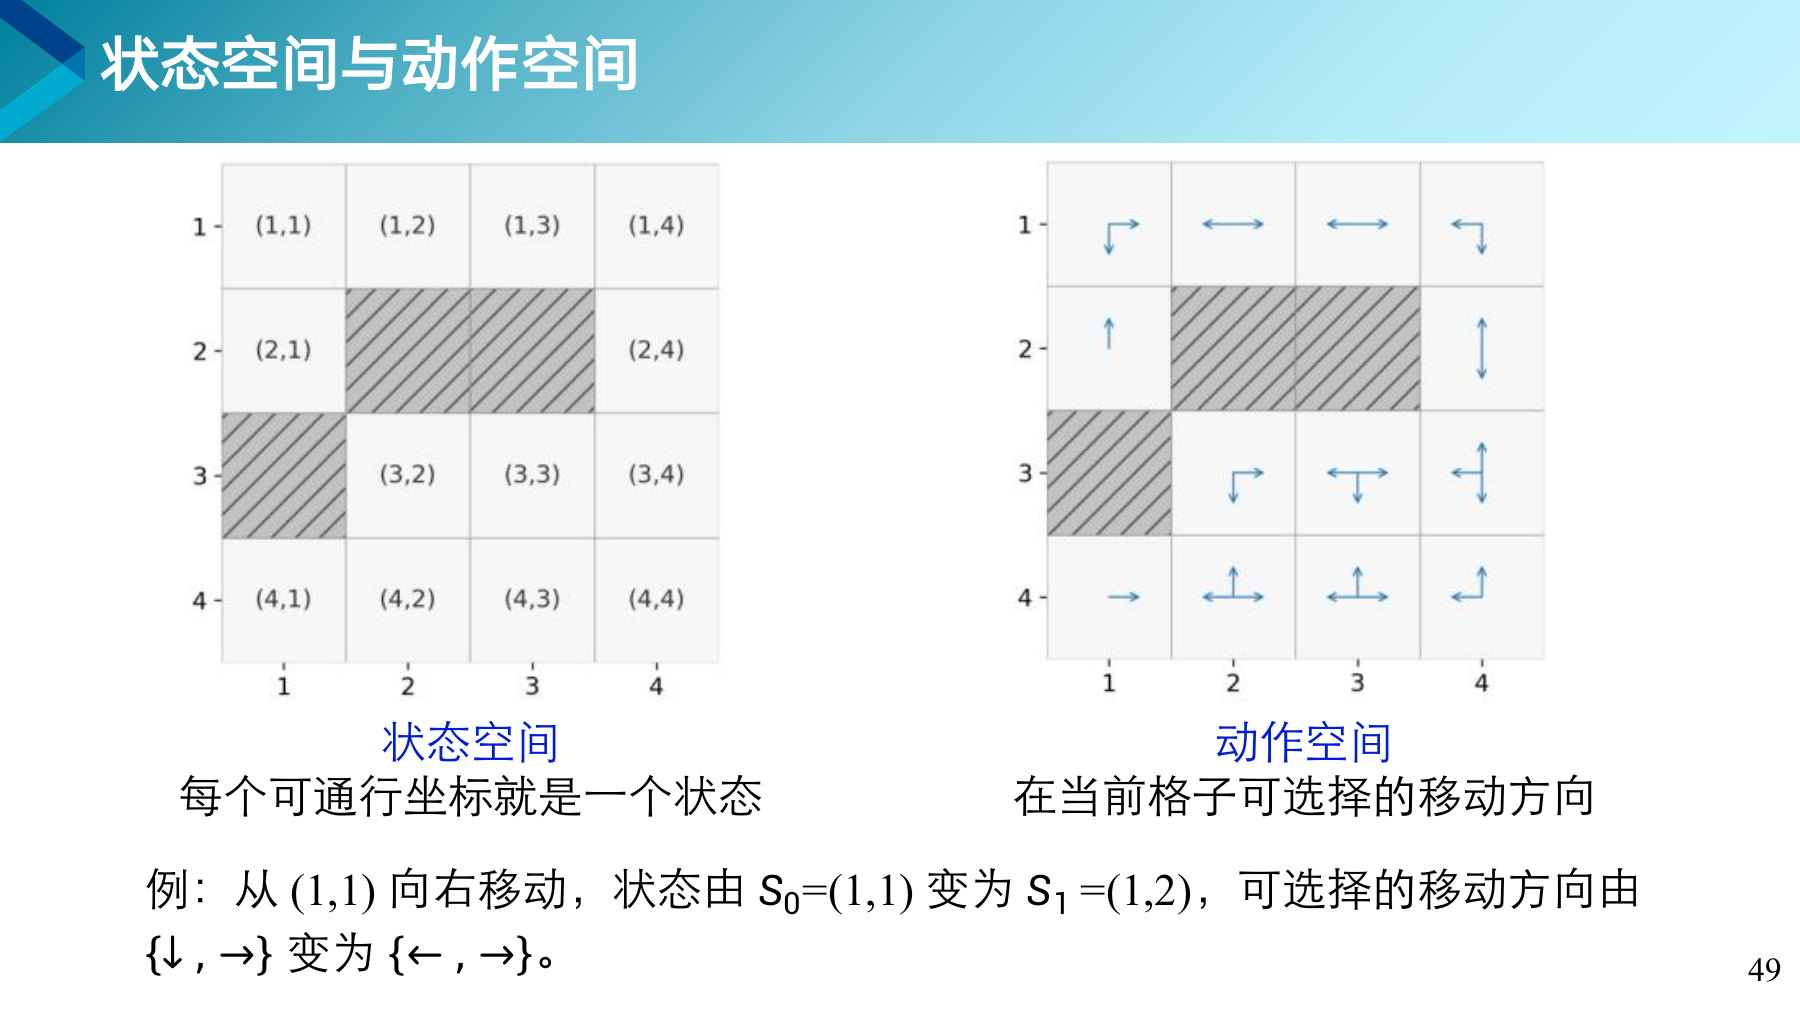
左图每个白格是一个状态,用行号和列号标出,比如 (1,1) 是第 1 行第 1 列。斜线格是墙,走不进去。右图每格里的箭头,是站在这一格时能走的方向。
靠墙和角落的格子能走的方向少,比如 (2,1) 只能往上走。课件底部举的例子:从 (1,1) 往右走到 (1,2),能走的方向就从“下、右”变成了“左、右”。
这个 4 × 4 的迷宫一共有多少个状态?
策略写的是在每一格里,往各个方向走的可能性各有多大。
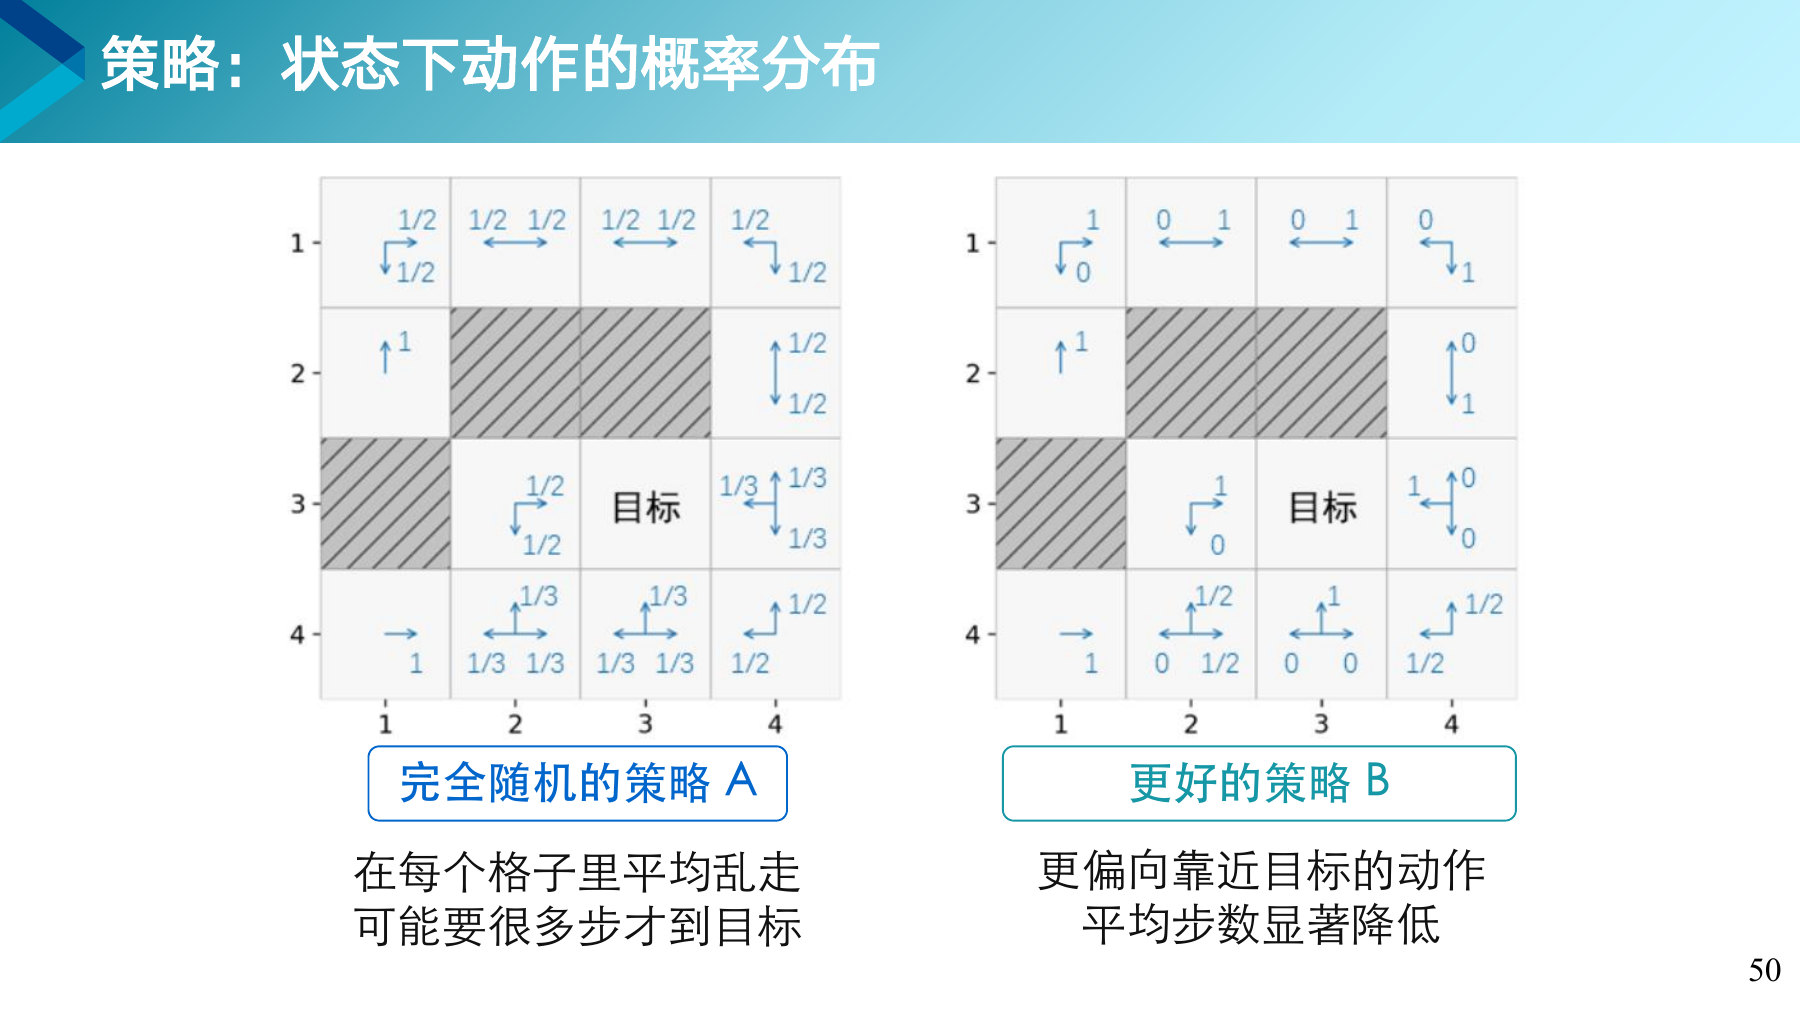
左边的策略 A,每格里各个方向都是 1/2、1/3 这样平均分配,等于闭着眼睛乱走。右边的策略 B,大多数格子里朝向目标的方向变成 1,其余变成 0。有两个方向一样近时,就各占 1/2。学习的过程,就是把左边这张表一点点改成右边那张。
策略像一本行动手册。新手的手册上每一页都写着“随便选”,老手的手册上大多数情况都写明了“就这么走”。
把以后能拿到的奖励都加起来,越晚拿到的打折越多。
| 这 10 分在第几步拿到 | 折扣因子 γ 取 0.9 时,现在看值多少 |
|---|---|
| 第 1 步就拿到 | 10 |
| 第 2 步拿到 | 10 × 0.9 = 9 |
| 第 3 步拿到 | 10 × 0.9 × 0.9 = 8.1 |
| 第 6 步拿到 | 约 5.9 |
| 第 21 步拿到 | 约 1.2 |
越远的事越不确定,不能和眼前的分数同样看待。另外,一局如果能无限走下去,不打折的话分数会越加越大,没法比较。
今天拿到一百块,和一年后才拿到一百块,多数人更想要今天的。γ 接近 1,表示很有耐心,看重长远。γ 接近 0,表示只顾眼前。
价值说的是:站在这里,或者在这里这样走,以后平均能拿到多少回报。
站在这一格,按当前的策略一直走下去,平均能拿到多少回报。
站在这一格,先往某个方向走一步,再接着走下去,平均能拿到多少回报。
到目标要走的步数越少,价值越高。(2,1) 被墙挡住,要绕一大圈,所以价值最低。站在任何一格,一直往价值更高的相邻格子走,就能走到目标旁边,再一步走进目标。
下象棋时判断“这个局面对我有没有利”,是在估状态价值。判断“这个局面下跳马好不好”,是在估动作价值。
环境里常有随机性,从同一格出发,每次的结果可能不一样。价值说的是平均能拿多少,不是保证能拿多少。
在每一格都不比别的走法差,这样的策略就是最优策略。
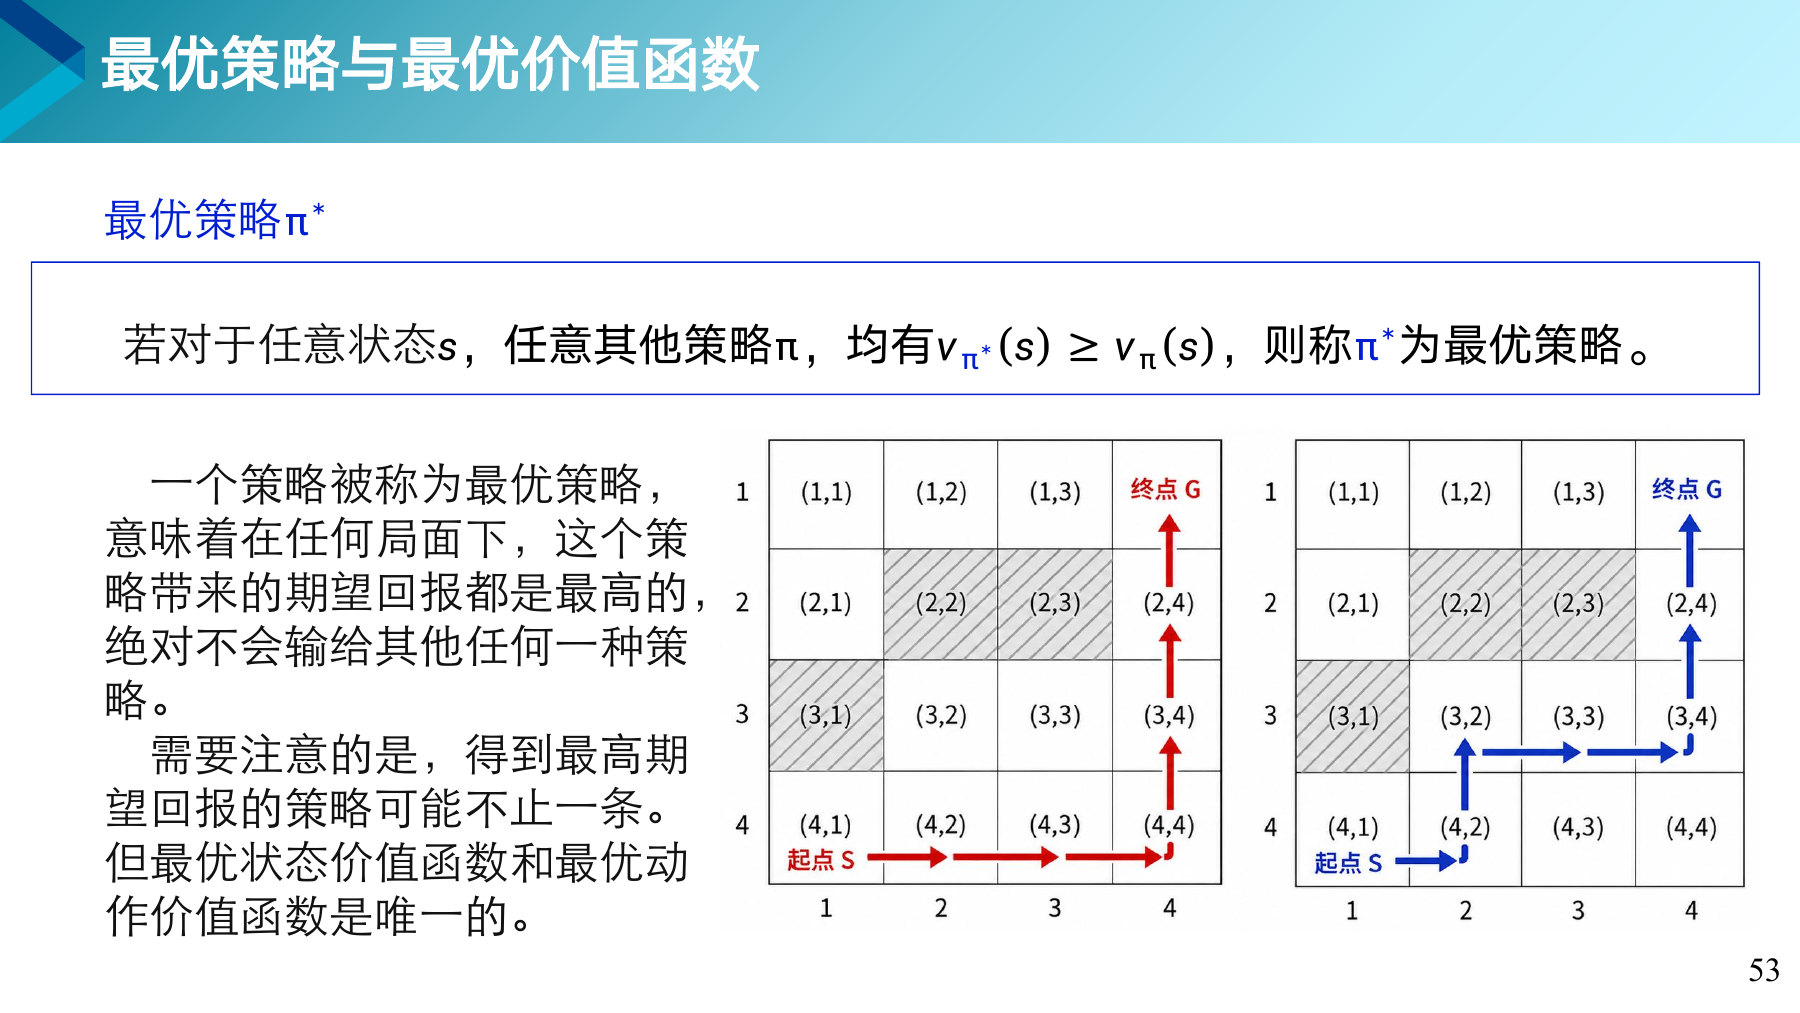
拿最优策略和任何别的策略比,在每一个格子上,它能拿到的回报都不会更少。要求的是每一格都不差,不是平均下来更好。
这一页的终点换到了右上角 (1,4),起点在左下角 (4,1)。右边两张图里,红色路线和蓝色路线都走 6 步,两条都是最优策略。可是“最少要走 6 步”这个答案只有一个,这就是课件说的最优价值函数是唯一的。
一步值多少,看它马上带来什么,再加上它通往的地方值多少。
式子右边分两部分。前一部分是马上拿到的奖励,课件叫“眼前的甜头”。后一部分是下一个位置的价值再乘上折扣,叫“未来的盼头”。两者相加,就是这一步的价值。
下象棋时吃掉对方一个车,吃子本身是眼前的甜头。吃完以后局面对你好不好,是未来的盼头。有时吃了车反被将死,两部分加起来,才是这步棋值多少。
它把“让以后的奖励总和最大”这个笼统的目标,变成了每一格都能动手算的一个式子。下一节的动态规划和 Q 学习,都是在反复使用它。