人工智能导论 第 7 章 · 第八节
课程 › 第 7 章 › 第八节 Kaggle其他平台房价任务标签分布目标变换训练与提交
第 7 章 人工智能实践 · 第八节

算法竞赛平台实践

上竞赛平台,完整做一道房价题
本 节 知 识 点
  1. 63Kaggle 平台介绍
  2. 64其他主流竞赛平台
  3. 65House Prices:任务定义
  4. 66标签分布与探索性分析
  5. 68取对数与补缺失值
  6. 69选模型、训练、交结果
63
第 7 章 · 第八节

Kaggle 平台介绍

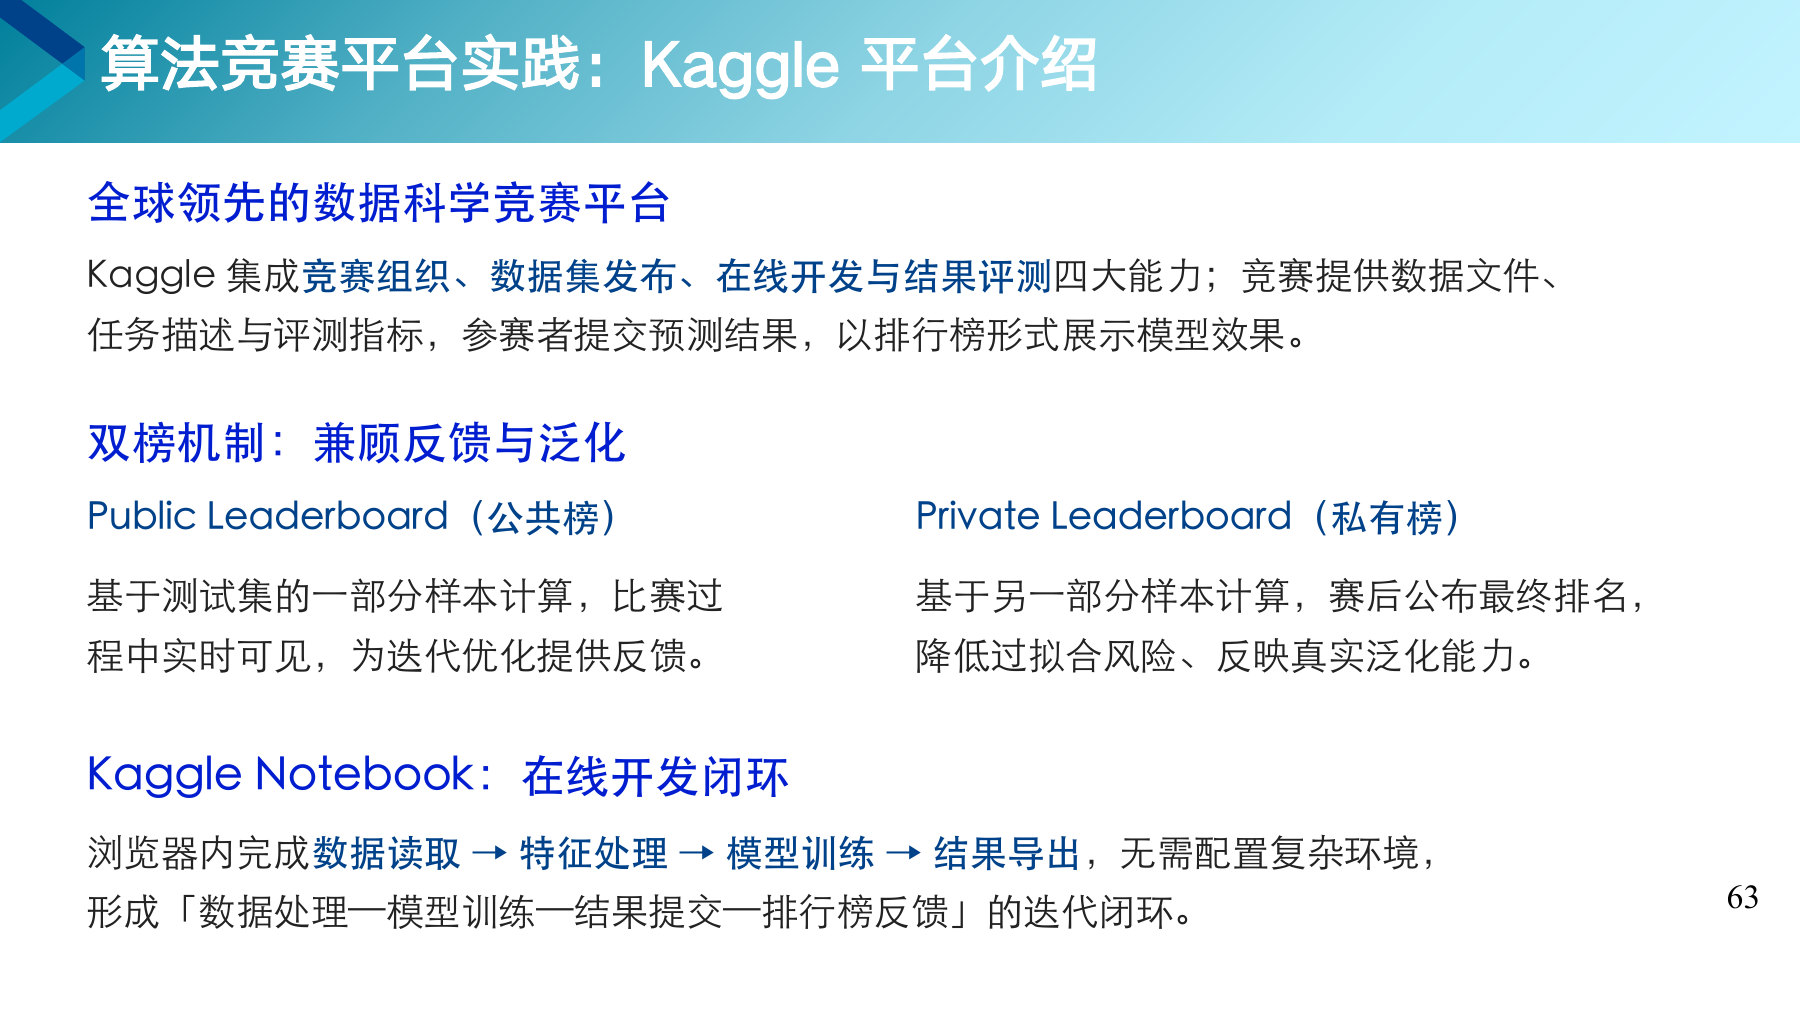
最有名的数据科学竞赛平台,双榜排名防止刷分。
第 63 页课件

关键术语

公开榜Public Leaderboard
用测试集的一部分算分,比赛期间随时能看到。
私有榜Private Leaderboard
用测试集的另一部分算分,比赛结束才公布,最终名次按它排。

重 点为什么要藏起一部分

全部成绩都实时可见的话,有人会盯着分数反复提交,调出一个只对这批测试数据好的模型。藏起一部分,这条路就走不通了。

知道更多实验三会看到

实验三会反复重洗数据划分,看公开榜上的第一名到了私有榜还能排第几。
64
第 7 章 · 第八节

其他主流竞赛平台

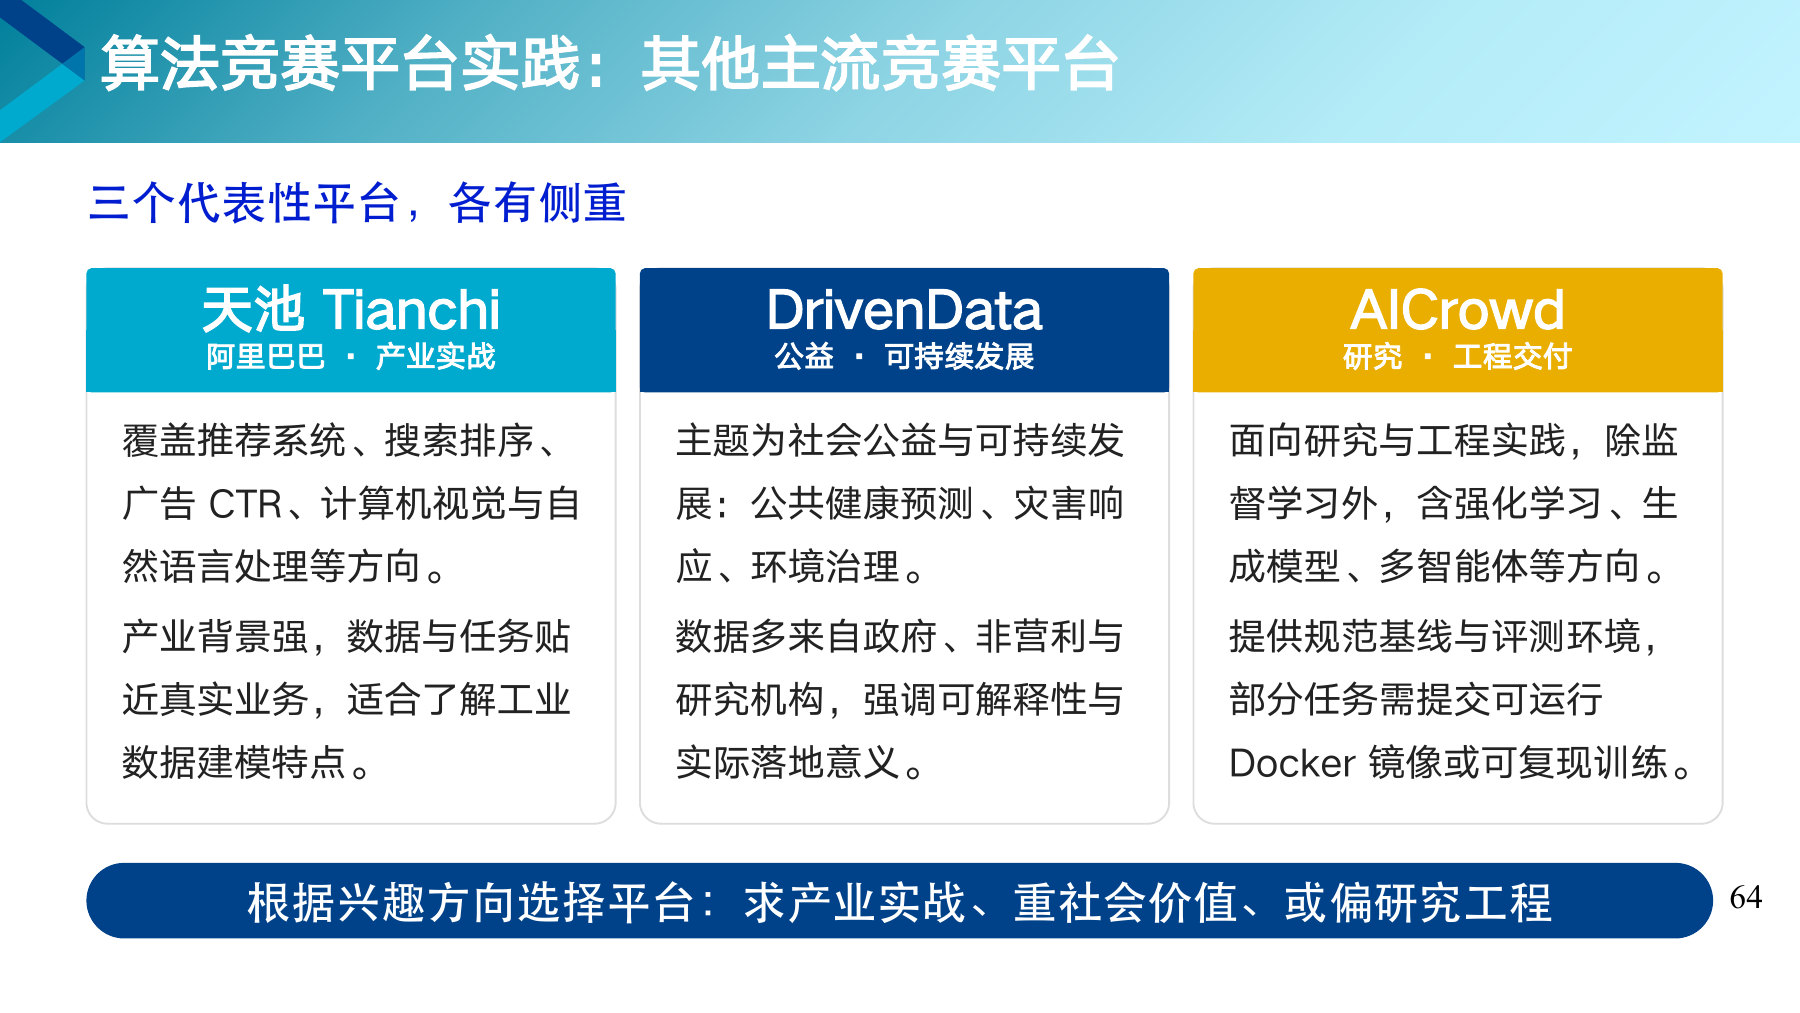
三个平台各有侧重,按想练的方向去选。

第 64 页课件

重 点按想练的方向选

想了解企业里的真实数据,可以去天池。想做对社会有用的题,比如灾害响应、公共健康,可以去 DrivenData。想练强化学习、练把整套程序交给别人去跑,可以去 AIcrowd。

知道更多提交镜像是什么要求

多数比赛只要交一个预测结果文件。有些比赛要交一个 Docker 镜像,由平台在它的机器上从头跑一遍。这要求整套流程在别人的电脑上也能跑通,第二节讲的容器化就用上了。

65
第 7 章 · 第八节

House Prices:任务定义

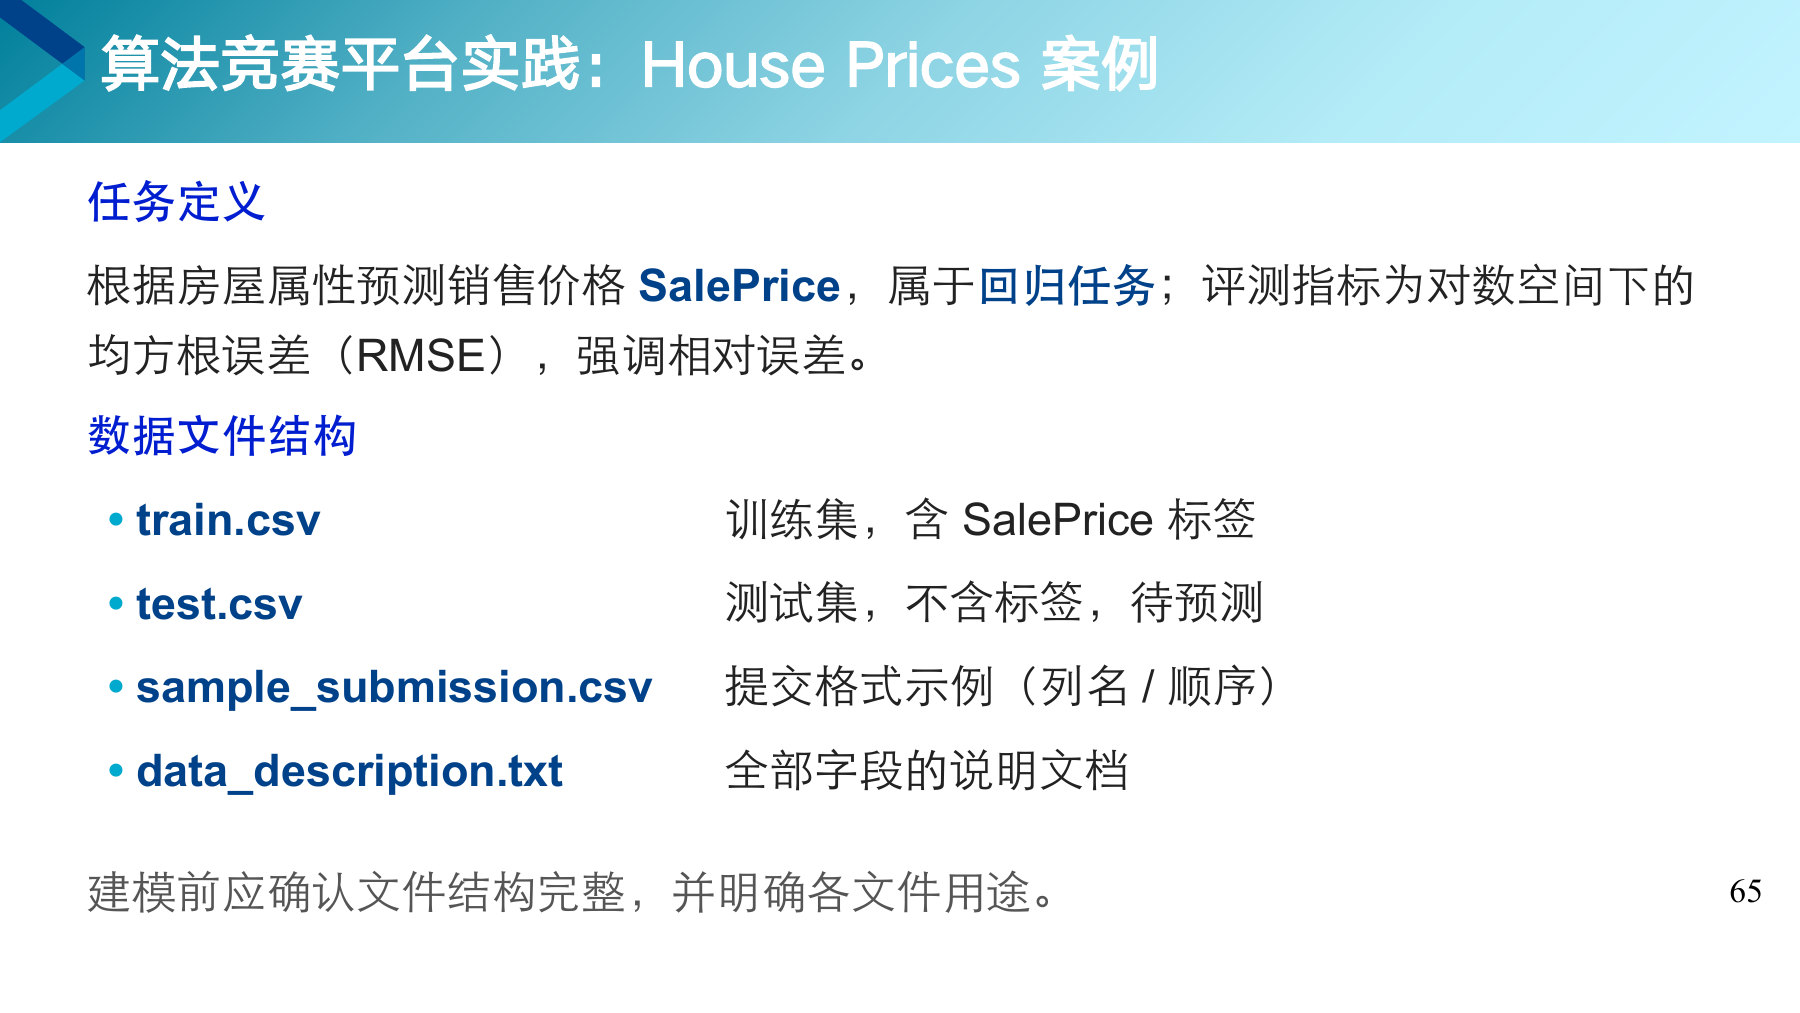
根据房子的各种属性预测售价,是一道回归题。

第 65 页课件

关键术语

RMSERoot Mean Squared Error
均方根误差,把每次的误差平方、取平均,再开平方。
回归Regression
要预测的答案是一个具体的数,比如一套房卖多少美元。

重 点四个文件先看哪个

train.csv 有答案,用来训练。test.csv 没有答案,要你预测。sample_submission.csv 是提交的样子。data_description.txt 解释每一列,最该先读。

知道更多这份数据

它记录的是美国艾奥瓦州埃姆斯市的房屋交易,训练集 1460 套房,每套有 79 个属性。

66
第 7 章 · 第八节

标签分布与探索性分析

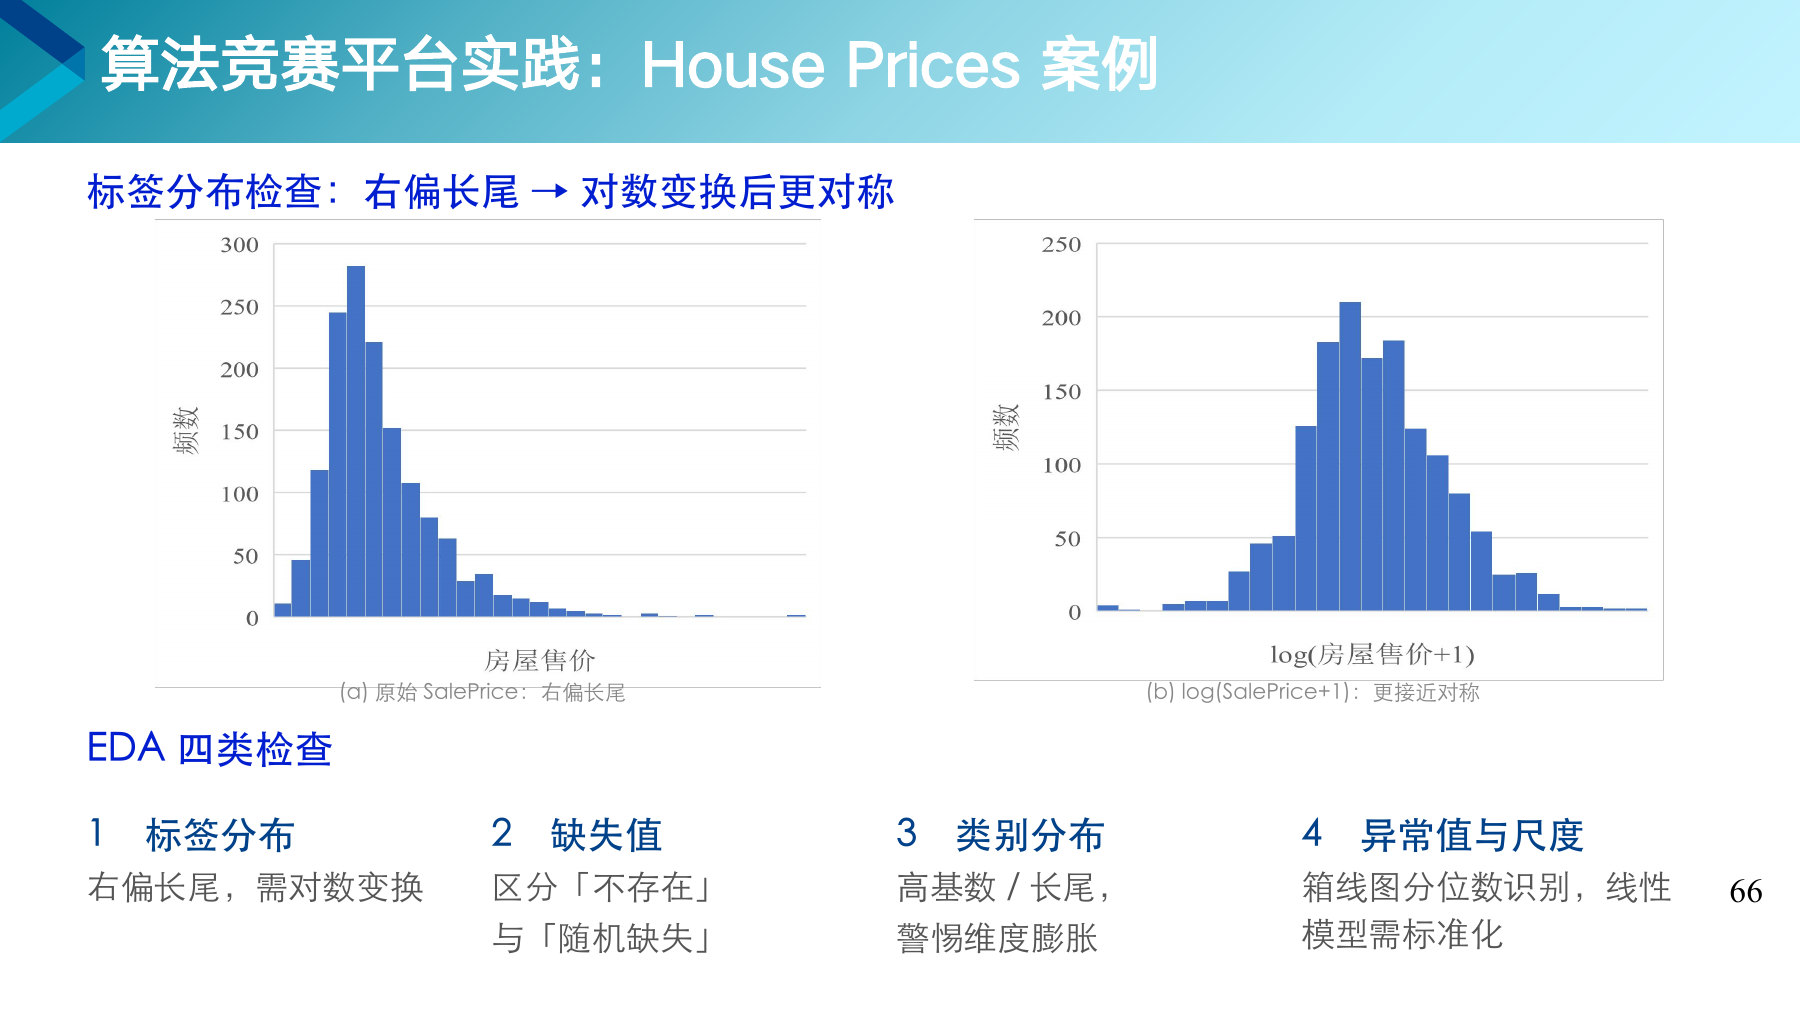
房价右边拖着长尾巴,取对数以后就匀称多了。

第 66 页课件

关键术语

探索性数据分析Exploratory Data Analysis, EDA
建模之前先把数据的分布、缺失和异常看清楚。
长尾Long Tail
大多数数据挤在一边,少数极端值拖出一条长长的尾巴。

重 点两张图对照看

左图是原始房价,大多数房子挤在左边,右边拖着一条长尾巴,那是少数豪宅。右图是取对数以后的分布,左右基本对称,像一口钟。

随堂练习

房价取对数以后,原来最贵的那套房还是最贵的吗?

  1. 是,取对数不改变谁大谁小
  2. 不是,会变成最便宜的
  3. 不一定,要看房子多少
  4. 取对数以后没法比较
查看答案
答案 A。取对数只把大的数压得更紧,不改变先后顺序,换算回房价后贵贱顺序也不会乱。
68
第 7 章 · 第八节

取对数与补缺失值

房价取对数,缺失值先分清是“没有”还是“漏记”。

第 68 页 目标变换与缺失值处理

房价每翻一倍,取对数后都只多 0.69

房价(美元)ln(1 + 房价)比上一行多多少
100,00011.51
200,00012.210.69
400,00012.900.69
取对数以后,比的是“差了几成”。10 万的房子猜成 11 万,100 万的房子猜成 110 万,都是多估了一成,在对数上的误差都是 0.095。比赛的评分正是这样算的。
缺了是因为“没有”

围栏这一列是空的,多半是这户人家没有围栏。填成一个新的类别“无”。

缺了是因为“漏记”

临街宽度这一列是空的,更像是没量到。用训练集的平均值补上,这一户照样参加训练。

原课件第 67 页是四类检查的逐条说明,其中缺失值的内容已经写进上面两张卡片。

重 点为什么要先加 1

房价不会是 0,但别的量常常是 0,而 0 没法取对数。先加 1 再取对数,0 就变成了 ln 1,也就是 0,公式对所有数都能用。模型预测出的对数值,最后还要换算回房价。

打个比方

同样差 1 万,买 10 万的房子差 1 万让人心疼,买 100 万的房子差 1 万几乎感觉不到。取对数以后比的是差了几成。

知道更多实验三也要补缺失

实验三里泰坦尼克号乘客的年龄缺了一部分,会比较几种补法。几种补法的分数相差不大,比较时要让它们考同一批人。

69
第 7 章 · 第八节

选模型、训练、交结果

交叉验证定配置,全量重训,再生成提交文件。

第 69 页 模型选择与训练评估

从选模型到交出结果

  1. 选模型 选多层感知机。只有一千多套房子,模型太简单学不出弯曲的关系,太复杂又容易死记。
  2. K 折交叉验证挑配置 比较不同的优化器、学习率、Dropout 比例,看各折的平均成绩。
  3. 全量重训 配置定下来以后,用全部训练数据再训练一次。
  4. 预测并提交 对测试集里的每套房预测售价,存成平台要求的格式上传,平台自动打分、更新排行榜。
Id,SalePrice
1461,121500
1462,158300
1463,183900
上面是提交文件的开头几行,数字只是示意。第一列是房子的编号,第二列是预测的售价。

关键术语

多层感知机Multilayer Perceptron, MLP
最基本的神经网络,一层层加权求和再往下传。
DropoutDropout
训练时随机让一部分神经元休息,逼模型别只靠少数几个,减少过拟合。

重 点为什么还要全量重训

交叉验证时,每次都有一折数据拿去验证,没参加训练。配置选好后用全部数据再训一遍,模型见过的房子更多,通常更准。

随堂练习

挑模型配置时,应该看哪里的成绩?

  1. 私有榜
  2. 反复提交后的公开榜
  3. 训练集内部的交叉验证
  4. 测试集
查看答案
答案 C。挑配置要在训练集内部用交叉验证做。反复拿公开榜来调,等于拿测试数据挑模型,到了私有榜常常会掉名次。
保山学院·人工智能教研室·曹鼎鼎