Kaggle 平台介绍
最有名的数据科学竞赛平台,双榜排名防止刷分。

关键术语
重 点为什么要藏起一部分
全部成绩都实时可见的话,有人会盯着分数反复提交,调出一个只对这批测试数据好的模型。藏起一部分,这条路就走不通了。
知道更多实验三会看到
实验三会反复重洗数据划分,看公开榜上的第一名到了私有榜还能排第几。
最有名的数据科学竞赛平台,双榜排名防止刷分。

全部成绩都实时可见的话,有人会盯着分数反复提交,调出一个只对这批测试数据好的模型。藏起一部分,这条路就走不通了。
实验三会反复重洗数据划分,看公开榜上的第一名到了私有榜还能排第几。
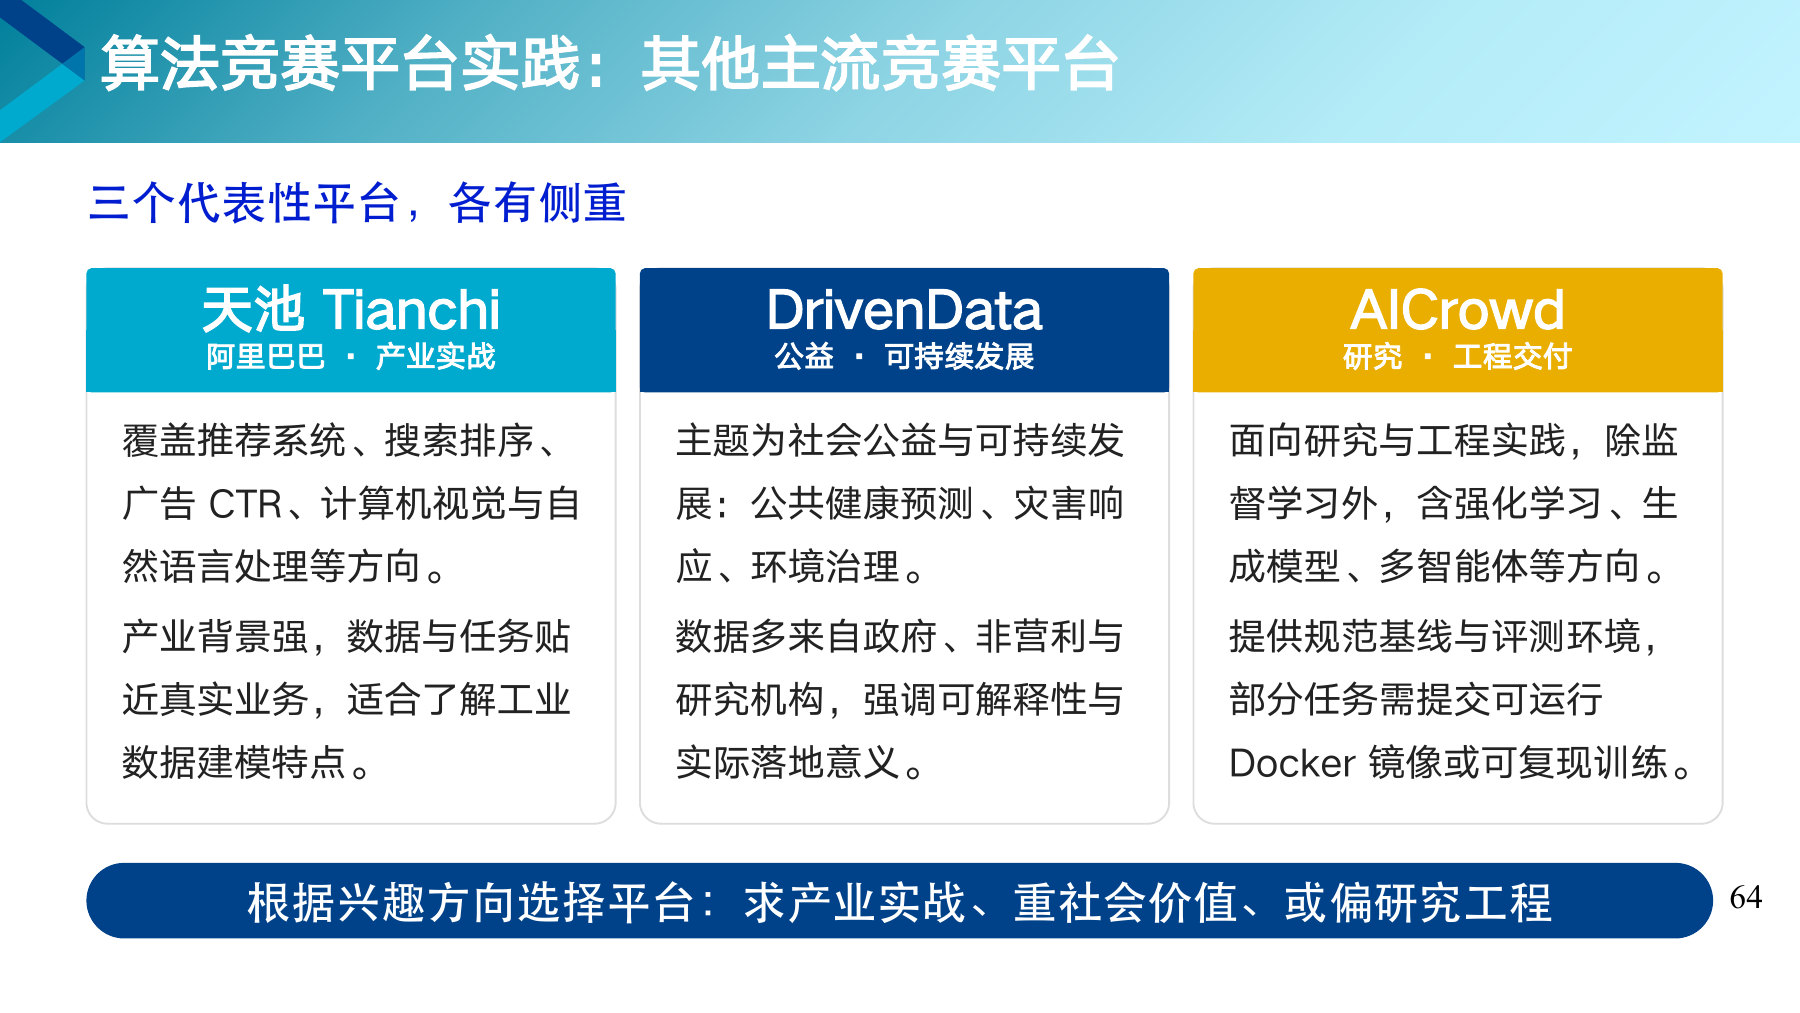
三个平台各有侧重,按想练的方向去选。

想了解企业里的真实数据,可以去天池。想做对社会有用的题,比如灾害响应、公共健康,可以去 DrivenData。想练强化学习、练把整套程序交给别人去跑,可以去 AIcrowd。
多数比赛只要交一个预测结果文件。有些比赛要交一个 Docker 镜像,由平台在它的机器上从头跑一遍。这要求整套流程在别人的电脑上也能跑通,第二节讲的容器化就用上了。
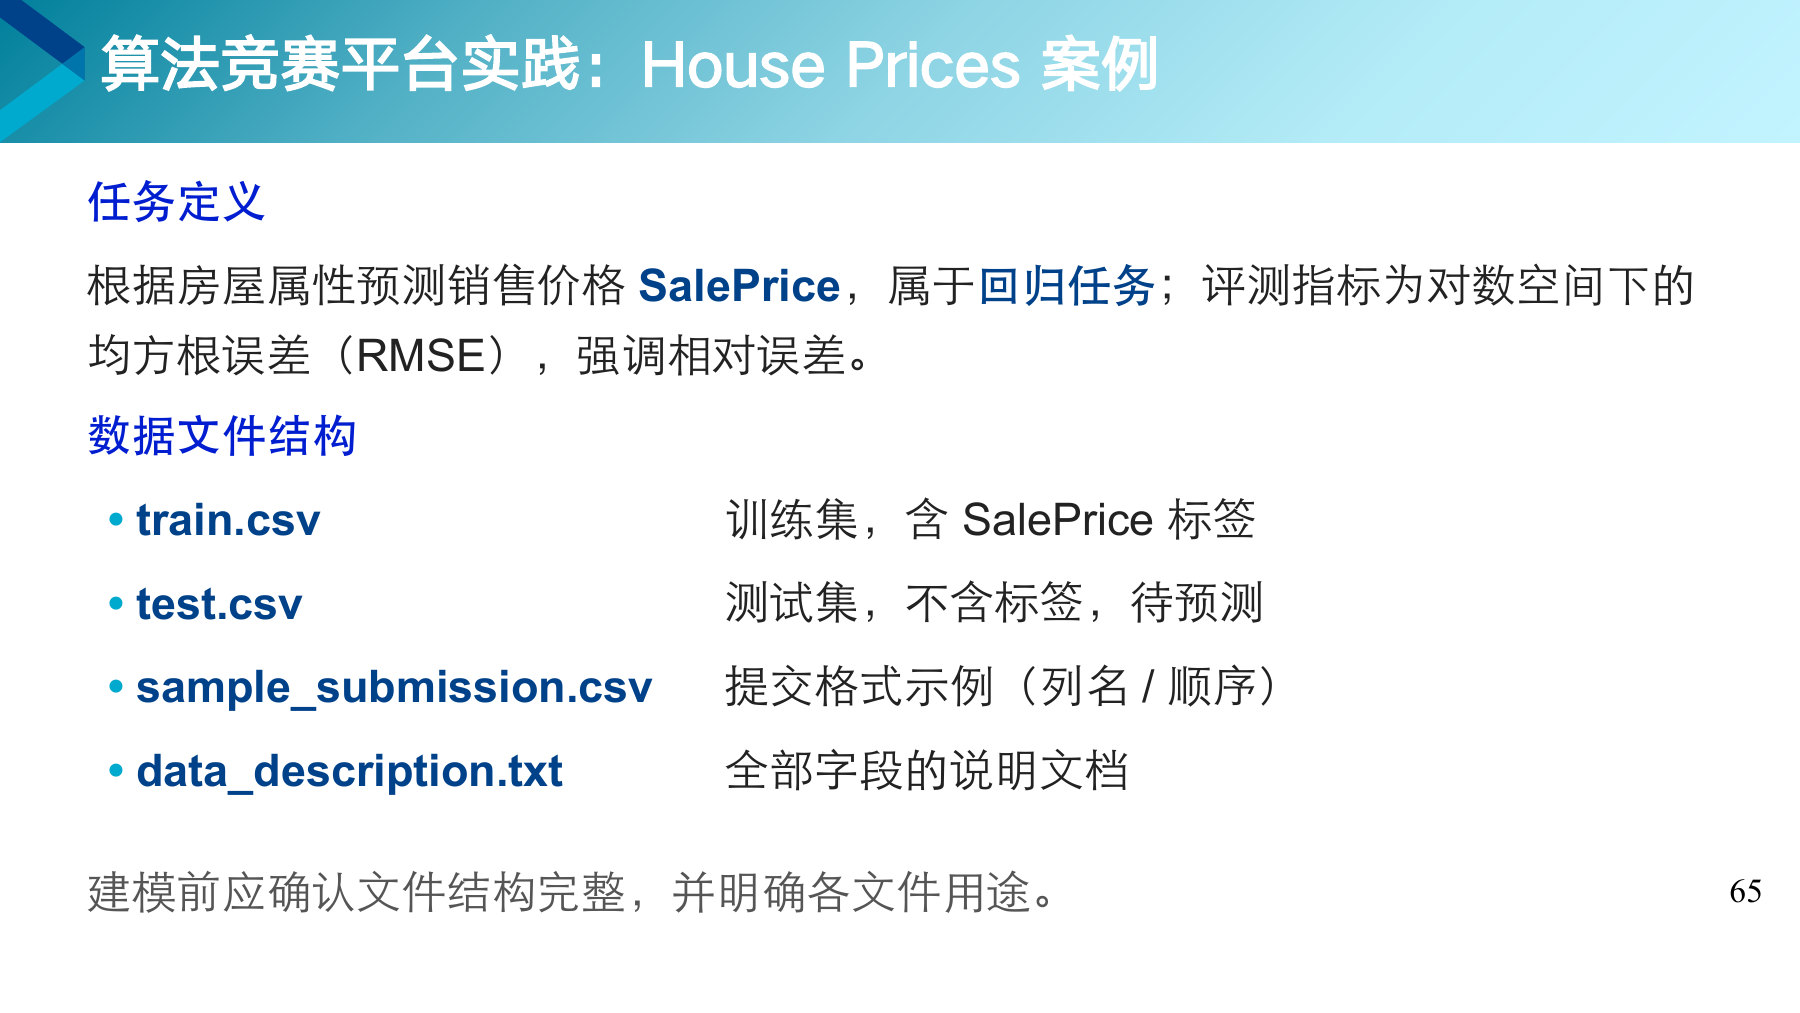
根据房子的各种属性预测售价,是一道回归题。

train.csv 有答案,用来训练。test.csv 没有答案,要你预测。sample_submission.csv 是提交的样子。data_description.txt 解释每一列,最该先读。
它记录的是美国艾奥瓦州埃姆斯市的房屋交易,训练集 1460 套房,每套有 79 个属性。
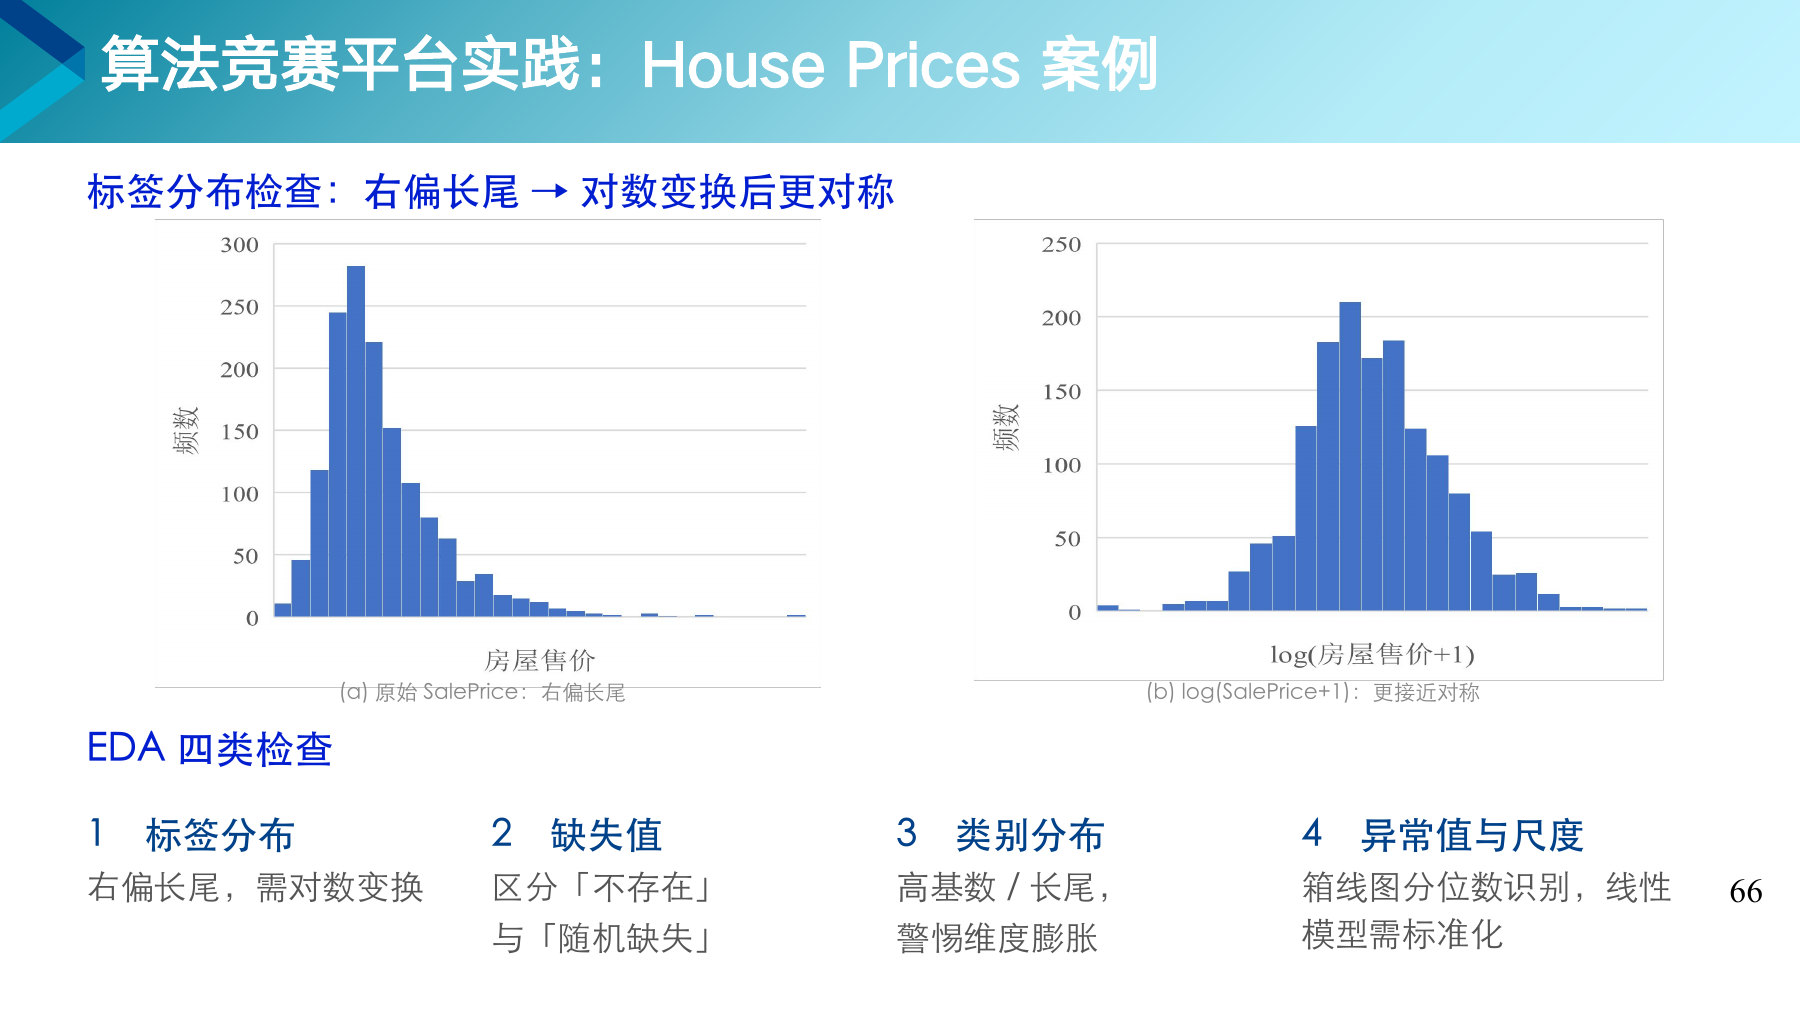
房价右边拖着长尾巴,取对数以后就匀称多了。

左图是原始房价,大多数房子挤在左边,右边拖着一条长尾巴,那是少数豪宅。右图是取对数以后的分布,左右基本对称,像一口钟。
房价取对数以后,原来最贵的那套房还是最贵的吗?
房价取对数,缺失值先分清是“没有”还是“漏记”。
| 房价(美元) | ln(1 + 房价) | 比上一行多多少 |
|---|---|---|
| 100,000 | 11.51 | |
| 200,000 | 12.21 | 0.69 |
| 400,000 | 12.90 | 0.69 |
围栏这一列是空的,多半是这户人家没有围栏。填成一个新的类别“无”。
临街宽度这一列是空的,更像是没量到。用训练集的平均值补上,这一户照样参加训练。
房价不会是 0,但别的量常常是 0,而 0 没法取对数。先加 1 再取对数,0 就变成了 ln 1,也就是 0,公式对所有数都能用。模型预测出的对数值,最后还要换算回房价。
同样差 1 万,买 10 万的房子差 1 万让人心疼,买 100 万的房子差 1 万几乎感觉不到。取对数以后比的是差了几成。
实验三里泰坦尼克号乘客的年龄缺了一部分,会比较几种补法。几种补法的分数相差不大,比较时要让它们考同一批人。
交叉验证定配置,全量重训,再生成提交文件。
Id,SalePrice 1461,121500 1462,158300 1463,183900
交叉验证时,每次都有一折数据拿去验证,没参加训练。配置选好后用全部数据再训一遍,模型见过的房子更多,通常更准。
挑模型配置时,应该看哪里的成绩?