第 5 章 · 第一节
人工智能生成内容
前几章教机器判断,这一章教机器创造。
知道更多这一章讲什么
前两节讲生成式人工智能是什么、能做什么,第三、四节介绍四种生成方法。第五、六节讲大语言模型怎样搭起来、怎样训练、怎样使用。最后两节讲能看图、能听声音的多模态大模型。
前几章教机器判断,这一章教机器创造。
前两节讲生成式人工智能是什么、能做什么,第三、四节介绍四种生成方法。第五、六节讲大语言模型怎样搭起来、怎样训练、怎样使用。最后两节讲能看图、能听声音的多模态大模型。
一个给已有的东西分类,一个造出新的东西。
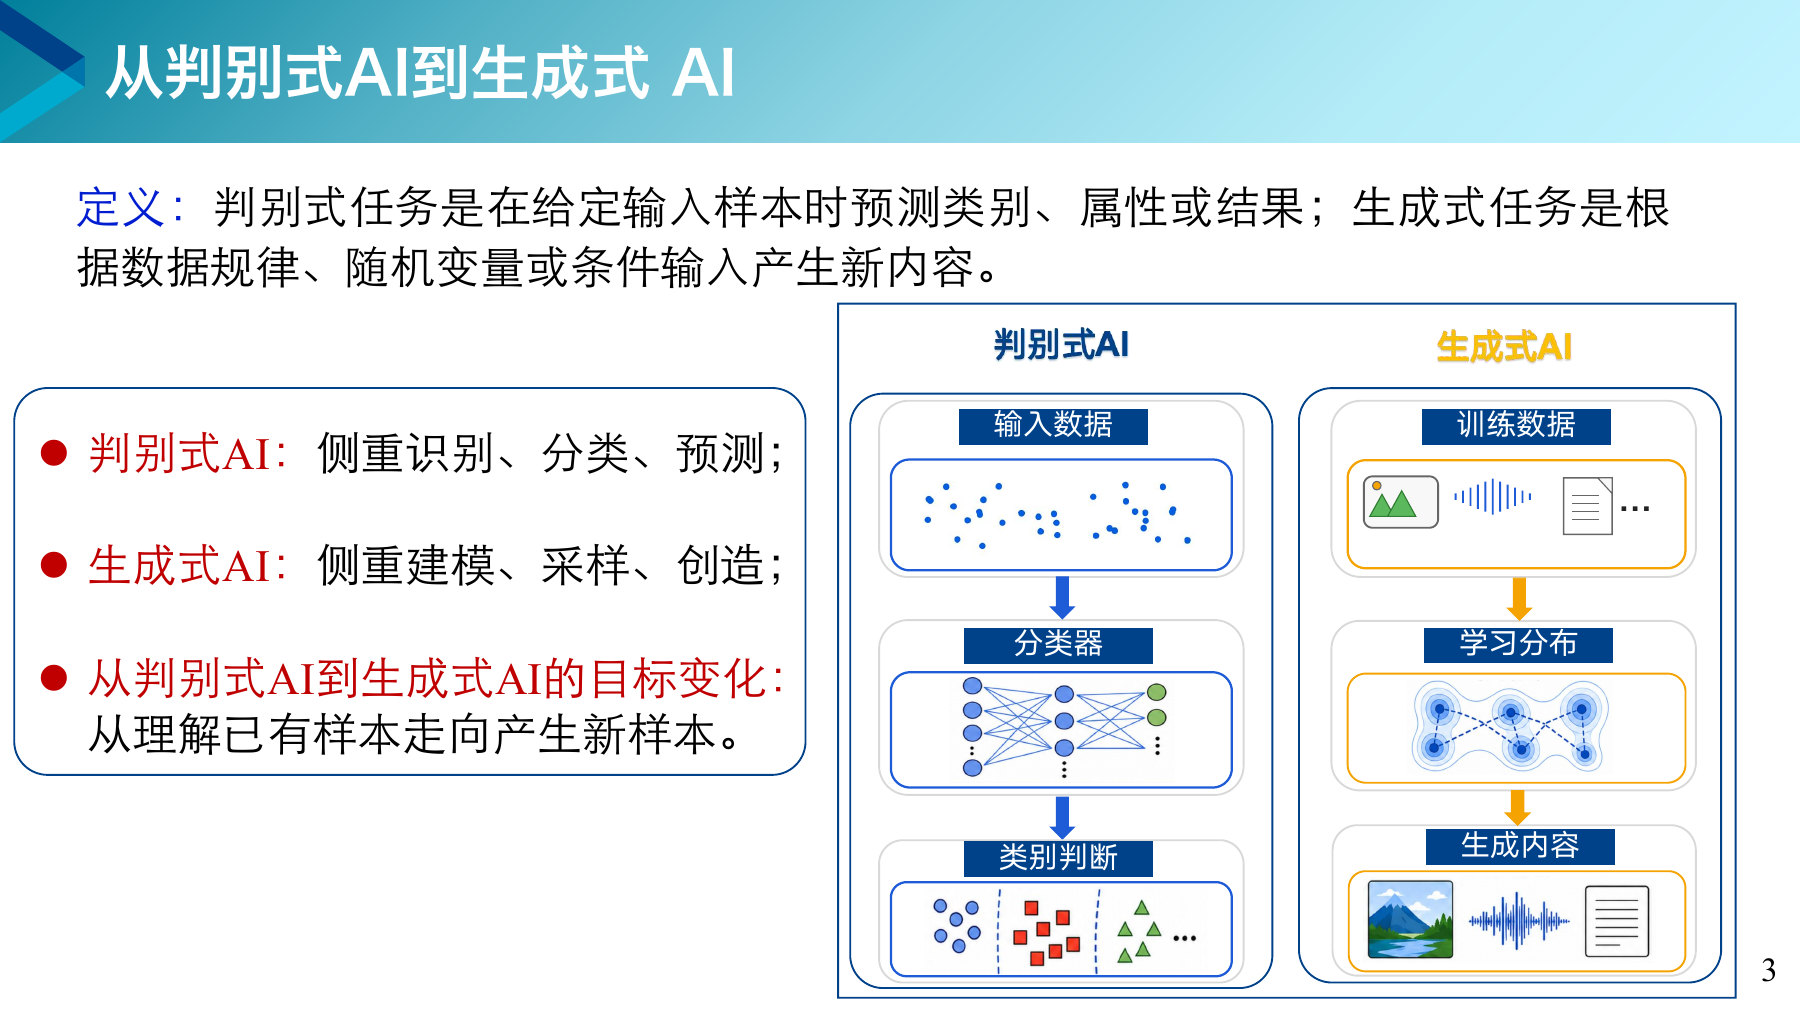
左边的判别式 AI 拿到数据,经过分类器,给出“属于哪一类”的判断。右边的生成式 AI 先从训练数据里学出规律,再按规律产出新的图片、声音或文字。
判别和生成的差别,像认字和写字。认字只要能把“己”和“已”分开就行,写字就得知道每一笔落在哪里、有多长,要掌握的东西多得多。
两者学的东西不一样,打分的办法也不一样。
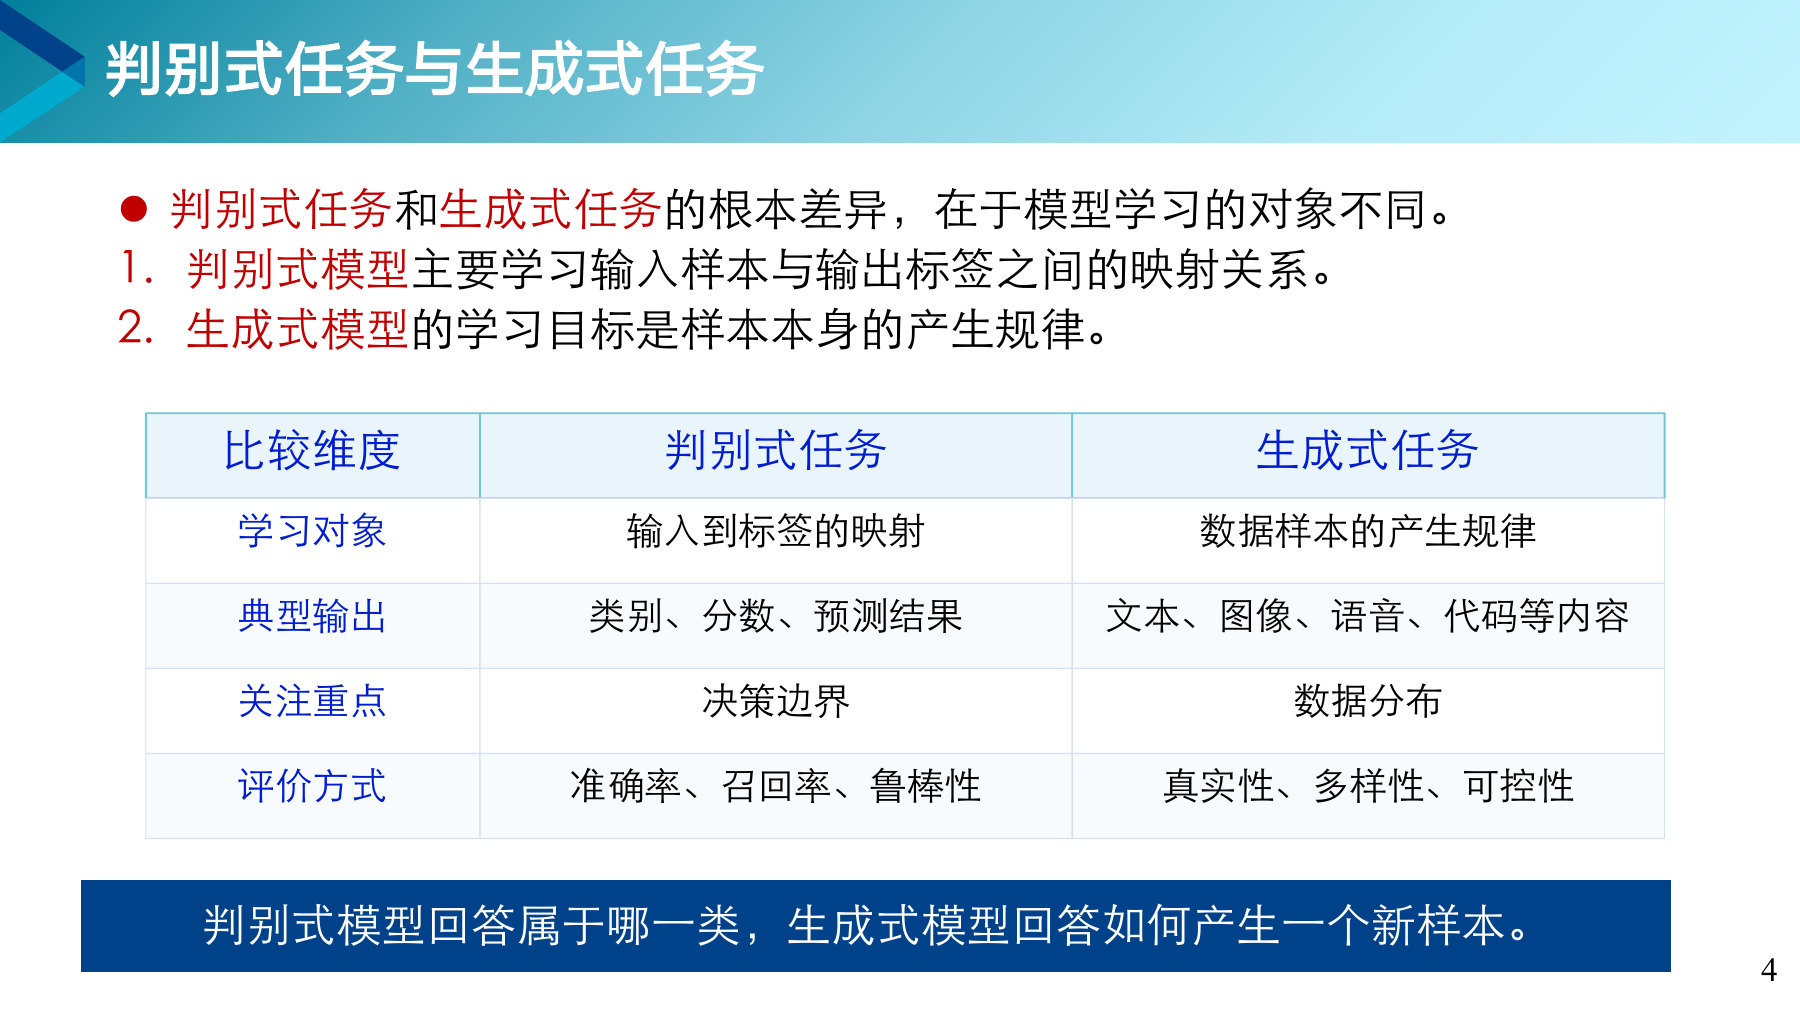
判别有标准答案,判对就是判对。生成没有唯一答案,同样画一只猫,可以有无数种画法,只能看它像不像真的、够不够多样、合不合要求。
第 3 章的逻辑回归和支持向量机,都在两类数据之间画一条分界线,这条线就是决策边界。判别式模型只要画好这条线,不必知道每一类数据长什么样。
下面哪一项属于生成式任务?
从已有数据学规律,生成相似却不重样的新内容。
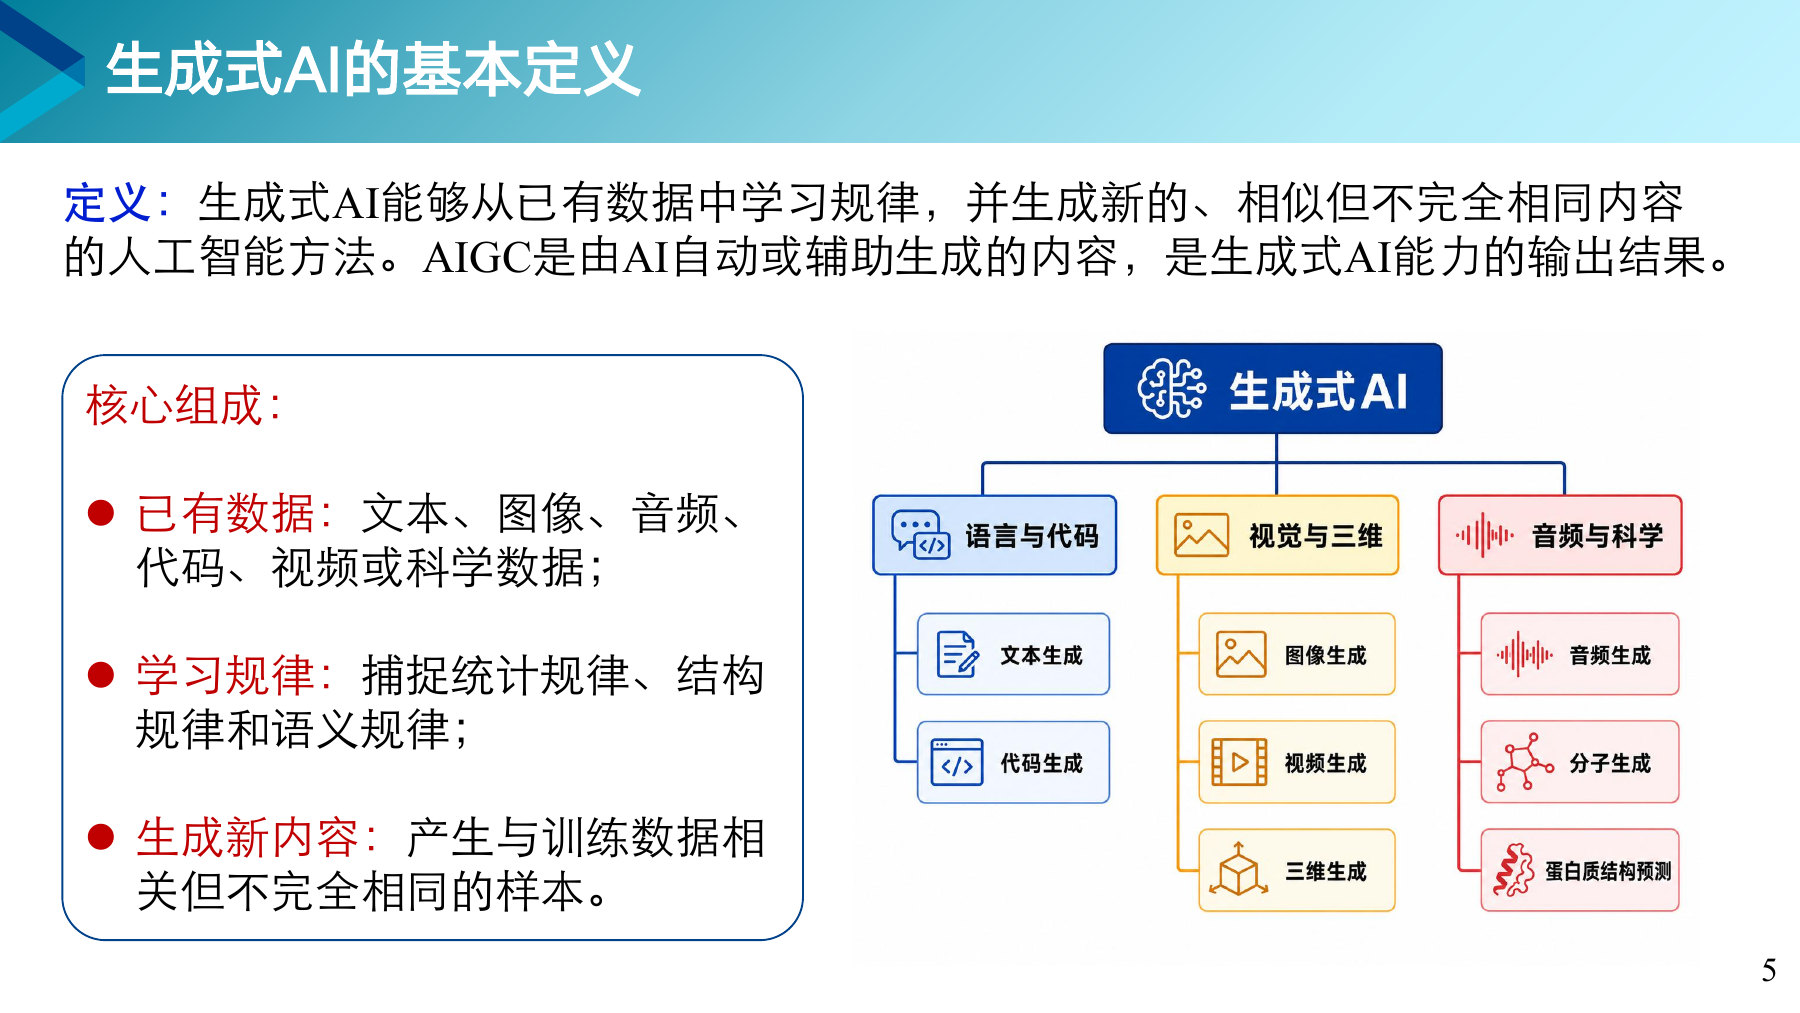
生成的内容不能照搬训练数据,也不能和任何一个训练样本一模一样。它又要和训练数据相似,符合同一套规律。
生成式 AI 和 AIGC 的关系,像相机和照片。前者是干活的工具,后者是工具做出来的作品。右边那棵树列出了作品的种类,从文章、代码一直到蛋白质结构。
真实数据只落在一小片区域里,生成就是在那里取新点。
灰点是一群真实的人的身高和体重,它们集中在一条斜斜的带子里。A 落在带子里,看上去就是一个普通人。B 身高 186 厘米却只有 42 千克,落在带子外面,生成模型不应该造出这样的样本。
老式电视没有信号时满屏雪花,那就是把像素乱填的结果。无论盯着看多久,雪花里也不会碰巧出现一张人脸。
几个看不见的“旋钮”,决定了生成结果的样子。
调音台上有一排推子,一个管音量,一个管低音,一个管混响。推子的位置就是隐变量,所有推子能调出的组合就是隐空间。
照片里只有一个个像素,并没有写着“笑容 0.8”。这些因素藏在像素背后,要靠模型从大量数据里自己总结出来。
随机选一个起点,再交给模型画出来。
摸奖箱里的奖券就是分布,伸手摸一张就是采样。箱子没有变,每次摸出来的可以不同。
同一句提示词让绘图模型画两次,得到两张不一样的图,最主要的原因是什么?
一种随便生成,一种按要求生成。
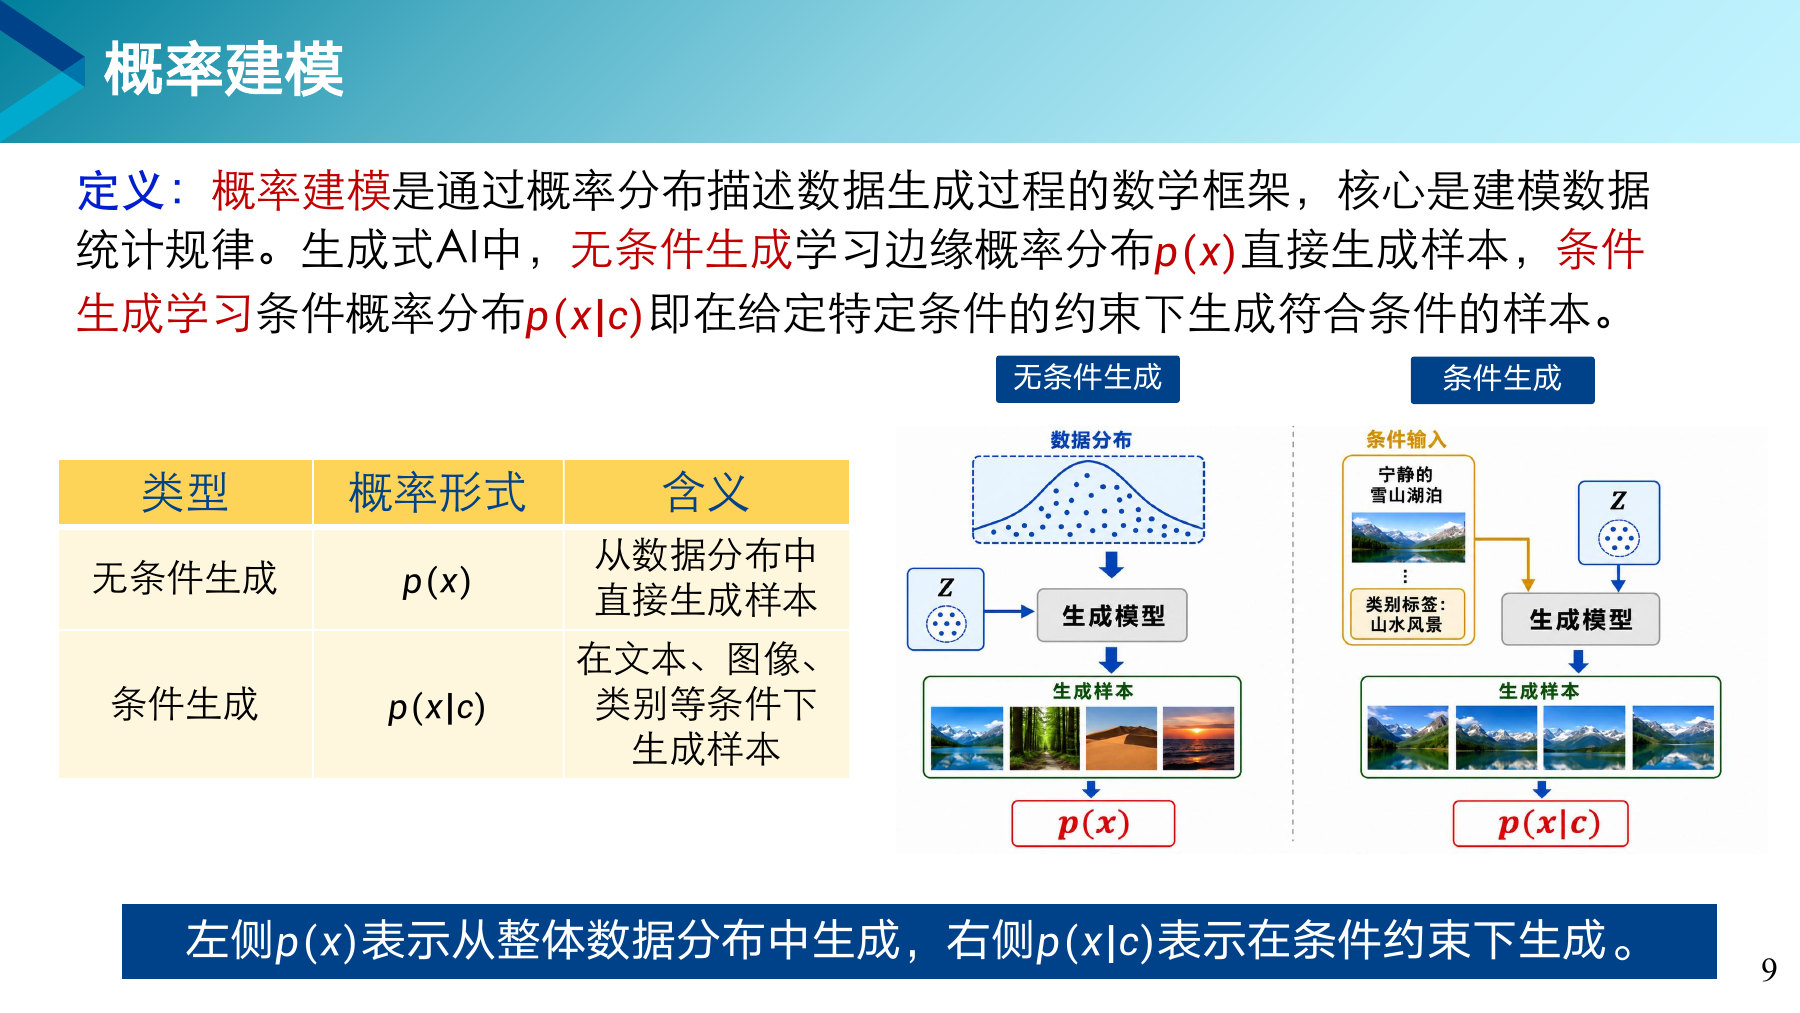
p(x) 读作“x 出现的可能性”。p(x|c) 里的竖线读作“在……条件下”,整个式子是“已知条件 c,x 出现的可能性”。右图里 c 是“宁静的雪山湖泊”这句话,生成的就只剩雪山湖泊一类风景。
假设某地一年里有三成的日子下雨,这是不加条件的可能性。如果已知天上乌云密布,下雨的可能性就高得多,这是加了条件的可能性。
一句话、一张图、一个类别名称,都可以当条件。今天常用的文生图、文生视频工具,走的都是条件生成这条路,输入的提示词就是条件。
生成的内容看着像样,不等于它是对的。
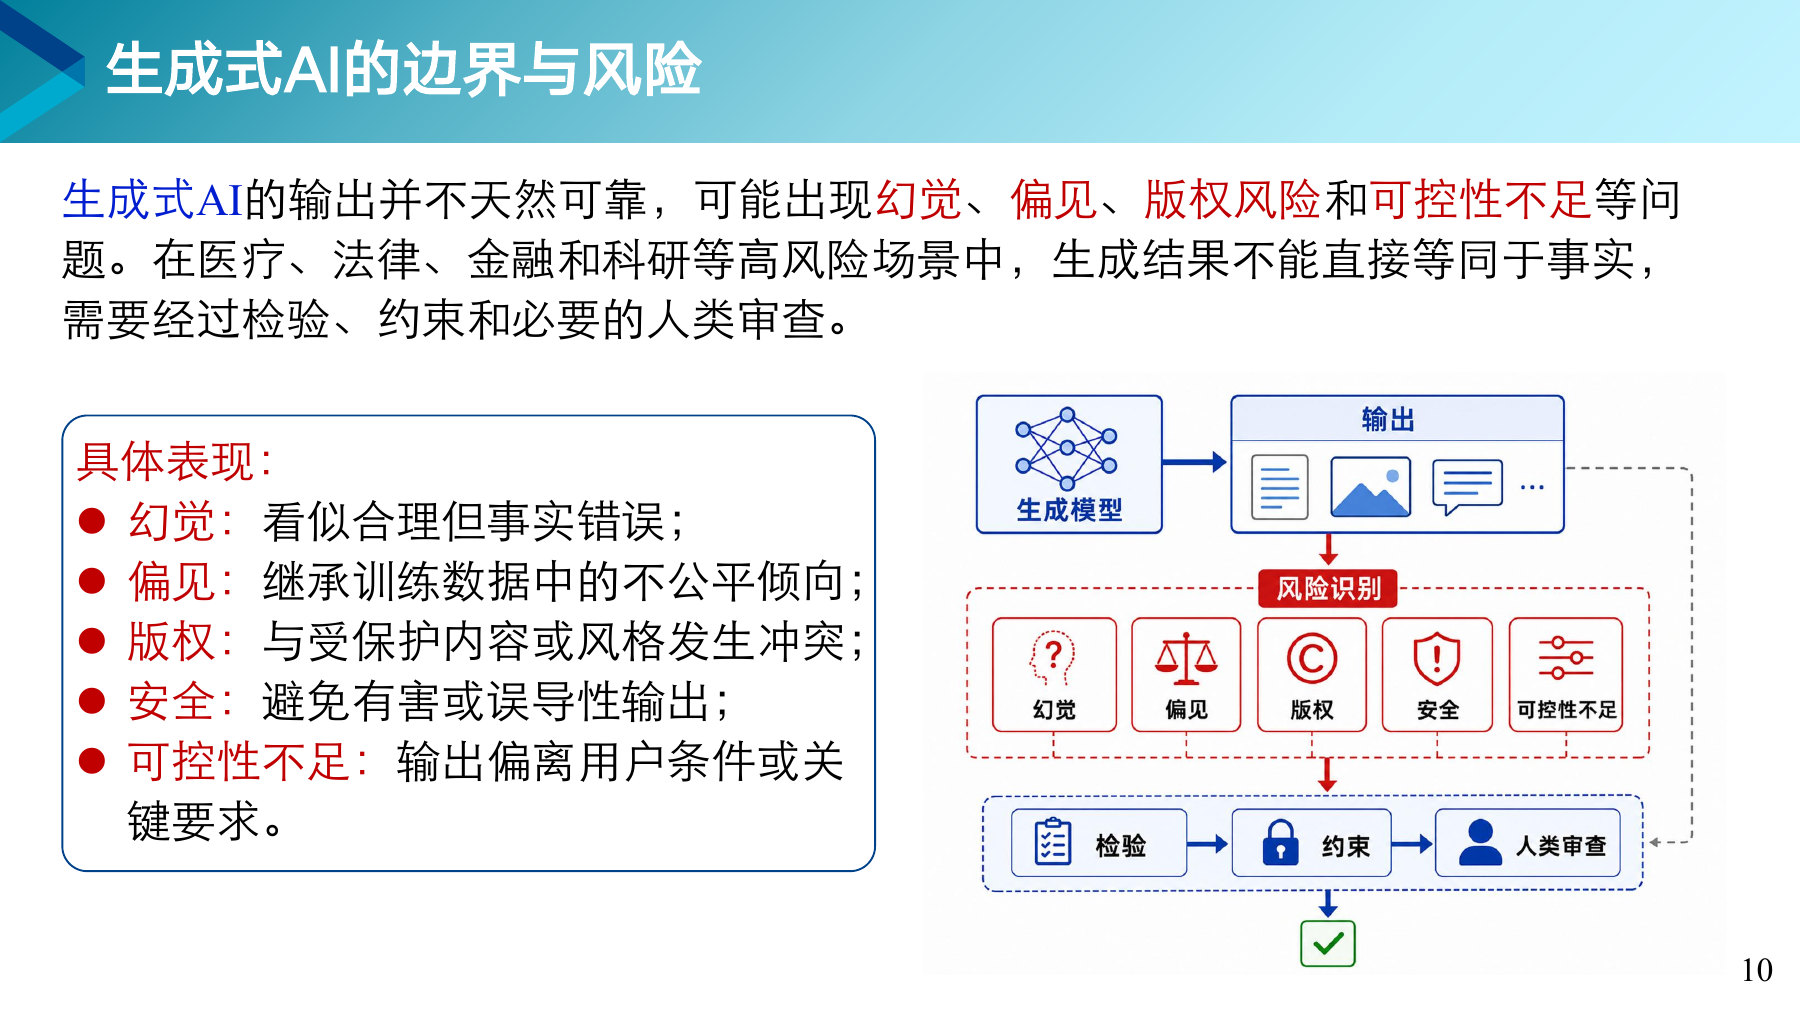
医疗、法律、金融、科研里,一句错话可能造成很大损失。生成的结果只能当作参考,要经过核对、加上限制,最后由懂行的人审查。右图最下面一行就是这三道关。
医生开出的药方,病人看不出对错,所以药房还要请药师再核对一遍。生成的专业内容也一样,读起来头头是道,外行很难看出哪里编错了,要请懂行的人把关。
先学规律再动手:训练一次,生成很多次。
训练阶段(只做一次,比较慢)
生成阶段(每次都做,比较快)
训练阶段要看大量数据,一般要花很多时间和算力,只做一次。训练好以后,每按一次“生成”就走一遍生成阶段,通常几秒钟就能出结果。
学做菜也分两段。先尝遍各种菜、摸清调味的规律,这是训练。以后每次下厨,定一个口味、下锅、出菜,这是生成。
好看只是一方面,还要真实、多样、协调、可控、有用。
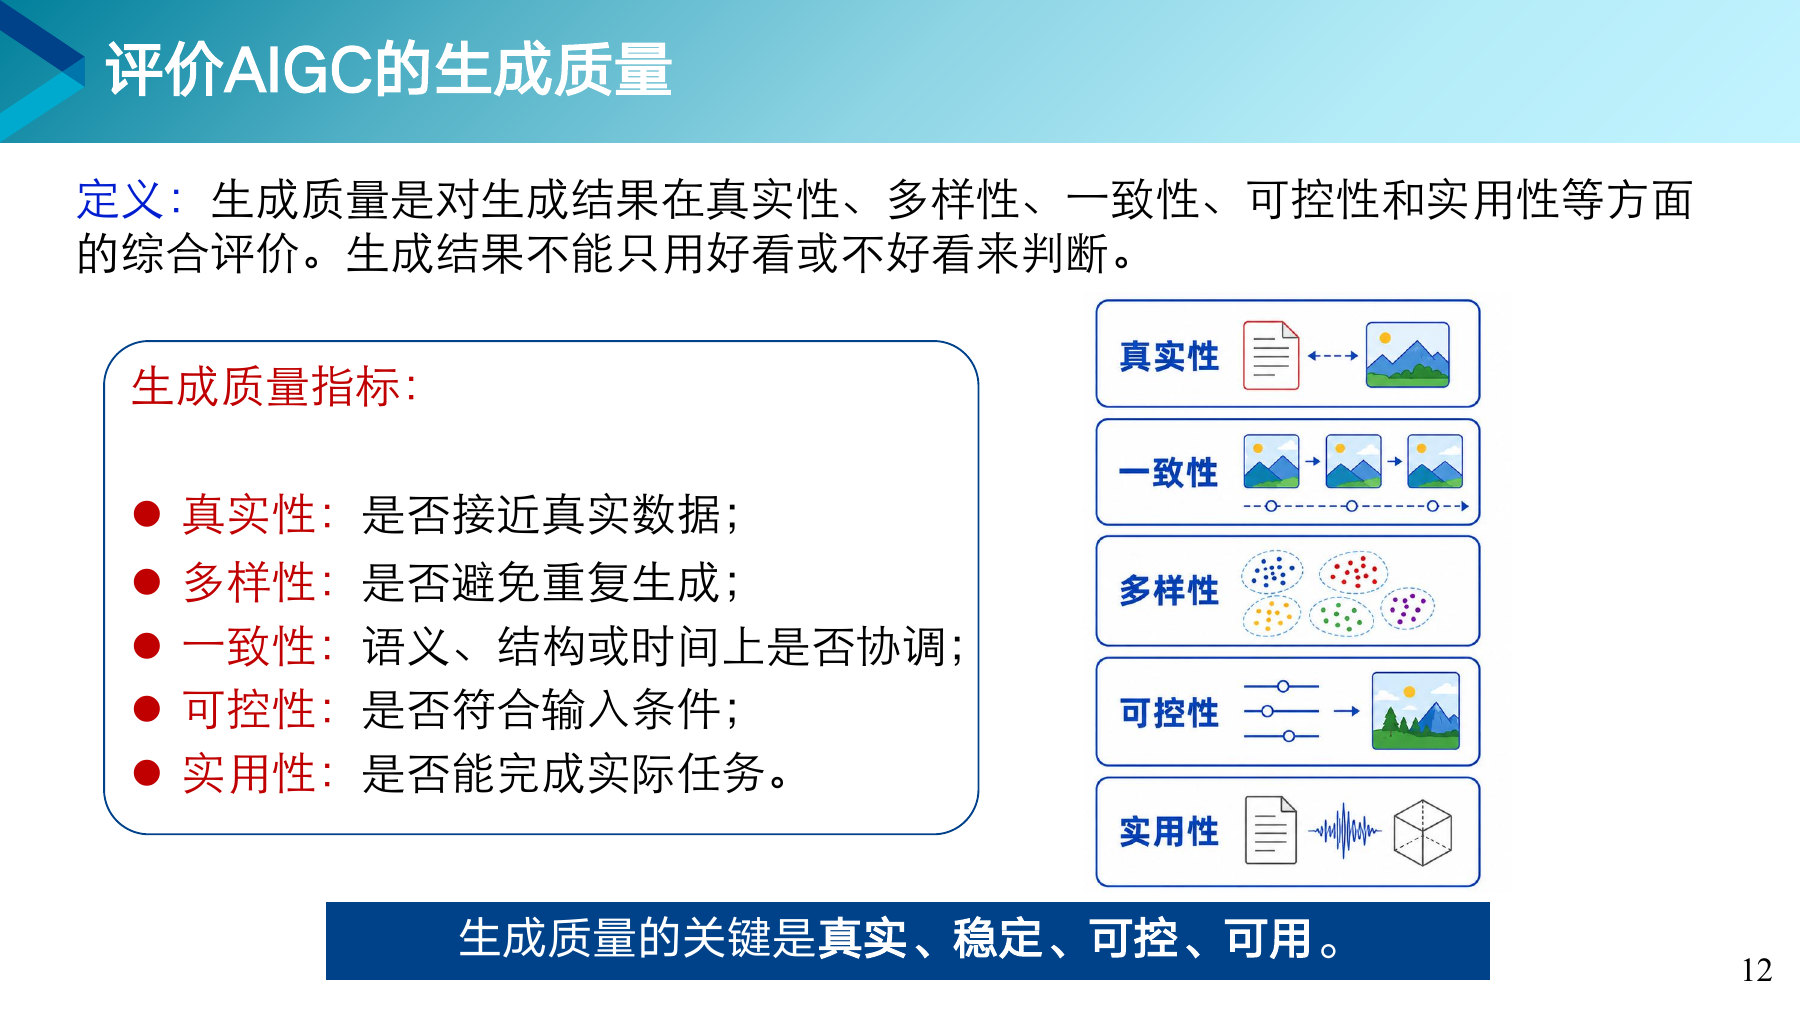
一段视频每一帧都很漂亮,人物的衣服颜色却一帧一变,这是时间上不一致。一张图里人的左手五根手指、右手六根,这是结构上不一致。
一个模型每次都画出几乎同一张脸,单看每张都很真实,合起来却没什么用处。所以除了看单张像不像,还要看一批结果够不够多样。
让模型生成 100 张猫的图片,每一张都很逼真,但几乎一模一样。这批结果哪项指标最差?