人工智能导论 第 4 章 · 第七节
课程 › 第 4 章 › 第七节 集成梯度沿路累加两个性质工程近似归因结果t-SNE挪点可视化效果小结与思考课后交流
第 4 章 深度学习新方法 · 第七节

输入归因与 t-SNE

模型看图时看哪儿,所有样本在它眼里怎样分布
本 节 知 识 点
  1. 46集成梯度:从全黑走到原图
  2. 47沿路把坡度攒起来
  3. 48集成梯度的两个好性质
  4. 49切成小段来加
  5. 50归因结果:模型在看哪儿
  6. 51t-SNE:把高维画到纸上
  7. 53在纸上一轮轮挪点
  8. 54t-SNE 画出来的样子
  9. 55小结与思考
  10. 56课后欢迎交流
46
第 4 章 · 第七节

集成梯度:从全黑走到原图

从一张全黑的图出发,一点点变成原图,沿路记下每个像素的作用。

第 46 页 输入归因:集成梯度

先铺一条路:画面从全黑一点点亮起来

α = 0亮度 0α = 0.25亮度 50α = 0.5亮度 100α = 0.75亮度 150α = 1亮度 200基线:全黑原图
α 是一个 0 到 1 之间的数,表示走到了哪儿。α = 0 是全黑的基线,α = 1 是原图。原图里亮度为 200 的像素,走到 α = 0.5 时亮度是 100。
集成梯度沿着这条路,在每个位置都看一看:这个像素再亮一点,模型的分数会涨多少。把一路上看到的都累加起来,就是这个像素的功劳。
这条路写成式子是 γ(α) = x′ + α × (x − x′),x′ 是基线,x 是原图。

关键术语

输入归因Input Attribution
把模型的判断结果分摊到输入的每个部分,看谁出力最多。
集成梯度Integrated Gradients
沿着从基线到输入的一条直线,把每一点的梯度累加起来,得到每个像素的功劳。
基线Baseline
代表“什么都没有”的输入,常用全黑的图。

重 点为什么不只在原图上看一眼

模型看到原图时往往已经非常确定,这时再把某个像素调亮,分数几乎不动,梯度接近 0。只看这一点,会误以为很多重要的像素没有用。下一页用一个小例子说明。
47
第 4 章 · 第七节

沿路把坡度攒起来

终点的坡度可能是 0,一路攒起来的功劳却不是 0。

第 47 页 输入归因:计算集成梯度

一个只看一个特征的小模型

分数 = x − x² ÷ 4,x 是这个特征的值。基线取 0,输入取 2。分数先涨得快,到 x = 2 时正好涨到 1,曲线变平。曲线的坡度就是上一页说的梯度。

模型的分数特征的值终点坡度 0021一开始很陡
算法怎么算结果
只看终点的梯度终点的坡度 0 × 特征的值 20
集成梯度一路上的平均坡度 0.5 × 走过的距离 21
实际涨了多少终点的分数 1 − 起点的分数 01
只看终点,会说这个特征毫无作用。集成梯度把一路上的坡度攒起来,算出的功劳正好等于分数实际涨的量。

重 点集成梯度怎么算

一个特征的功劳 = 它从基线到输入一共变了多少 × 沿路坡度的平均值。在面板里的例子中,特征变了 2,沿路坡度从 1 均匀地降到 0,平均是 0.5,功劳就是 1。

打个比方

评价一名队员对球队的贡献,不能只看比赛最后一分钟他有没有得分。最后一分钟比分早已拉开,他投不投都一样。要把整场比赛看下来,把他每个阶段的贡献加起来。

随堂练习

按面板里的小模型,只用“终点的坡度 × 特征的值”来估计功劳,会得到多少?

  1. 0
  2. 0.5
  3. 1
  4. 2
查看答案
答案 A。终点处曲线已经变平,坡度是 0,乘以 2 还是 0。这就是只看一点的梯度会低估功劳的例子。集成梯度算出的是 1。
48
第 4 章 · 第七节

集成梯度的两个好性质

功劳加起来正好等于总变化,模型换个写法也不影响结果。

第 48 页 集成梯度的特性

完整性:功劳加起来,正好等于分数涨的量

长的功劳= 3宽的功劳= 3长 = 2宽 = 3起点 0×0终点 2×3,面积 6虚线是长和宽一起变大的那条路
把长方形的面积当作模型的分数,长和宽当作两个特征。从 0 × 0 沿虚线长到 2 × 3,面积涨了 6。用集成梯度算,长的功劳是 3,宽的功劳也是 3,加起来正好是 6。
完整性

所有特征的功劳加起来,严格等于模型对输入的分数减去对基线的分数。功劳不会多算,也不会漏算。

实现不变性

两个模型内部写法不同,只要对任何输入给出的分数都一样,归因结果就一样。

重 点长的功劳为什么是 3

长每增加一点,面积增加的量等于当时的宽。沿着虚线走,宽从 0 均匀涨到 3,平均是 1.5。长一共增加了 2,功劳就是 2 × 1.5 = 3。宽的功劳是 3 × 1 = 3,道理一样。

打个比方

完整性像公司年底分奖金。今年比去年多赚了 100 万,分到各个部门的钱加起来必须正好是 100 万,不能多也不能少。

随堂练习

模型对全黑基线图的分数是 0.1,对一张船的照片的分数是 0.9。用集成梯度算出所有像素的功劳,加起来是多少?

  1. 0.1
  2. 0.8
  3. 0.9
  4. 1.0
查看答案
答案 B。按完整性,所有像素的功劳之和等于 0.9 − 0.1 = 0.8。
49
第 4 章 · 第七节

切成小段来加

一路上的坡度没法处处都测,就隔一段测一次,再加起来。

第 49 页 集成梯度的工程近似

每隔一段测一次坡度

坡度特征的值120真实的坡度4 个小矩形面积合计 0.75斜线下的三角形面积正好是 1
分成几段41050100
算出的功劳0.750.900.980.99
分得越细越准,代价是每多一段,模型就要多算一次梯度。实际常取几十到几百段。
例子沿用第 47 页的小模型,真实的功劳是 1。每一段都用这一段末尾的坡度来算,所以结果略小一些。

关键术语

近似Approximation
算不出精确值时,用一个足够接近的值来代替。

打个比方

估计一段山路一共爬升了多少米。每走一百米测一次坡有多陡,用这个坡度乘以一百米,估出这一段爬了多高,再把各段加起来。测得越密越准,也越费事。

50
第 4 章 · 第七节

归因结果:模型在看哪儿

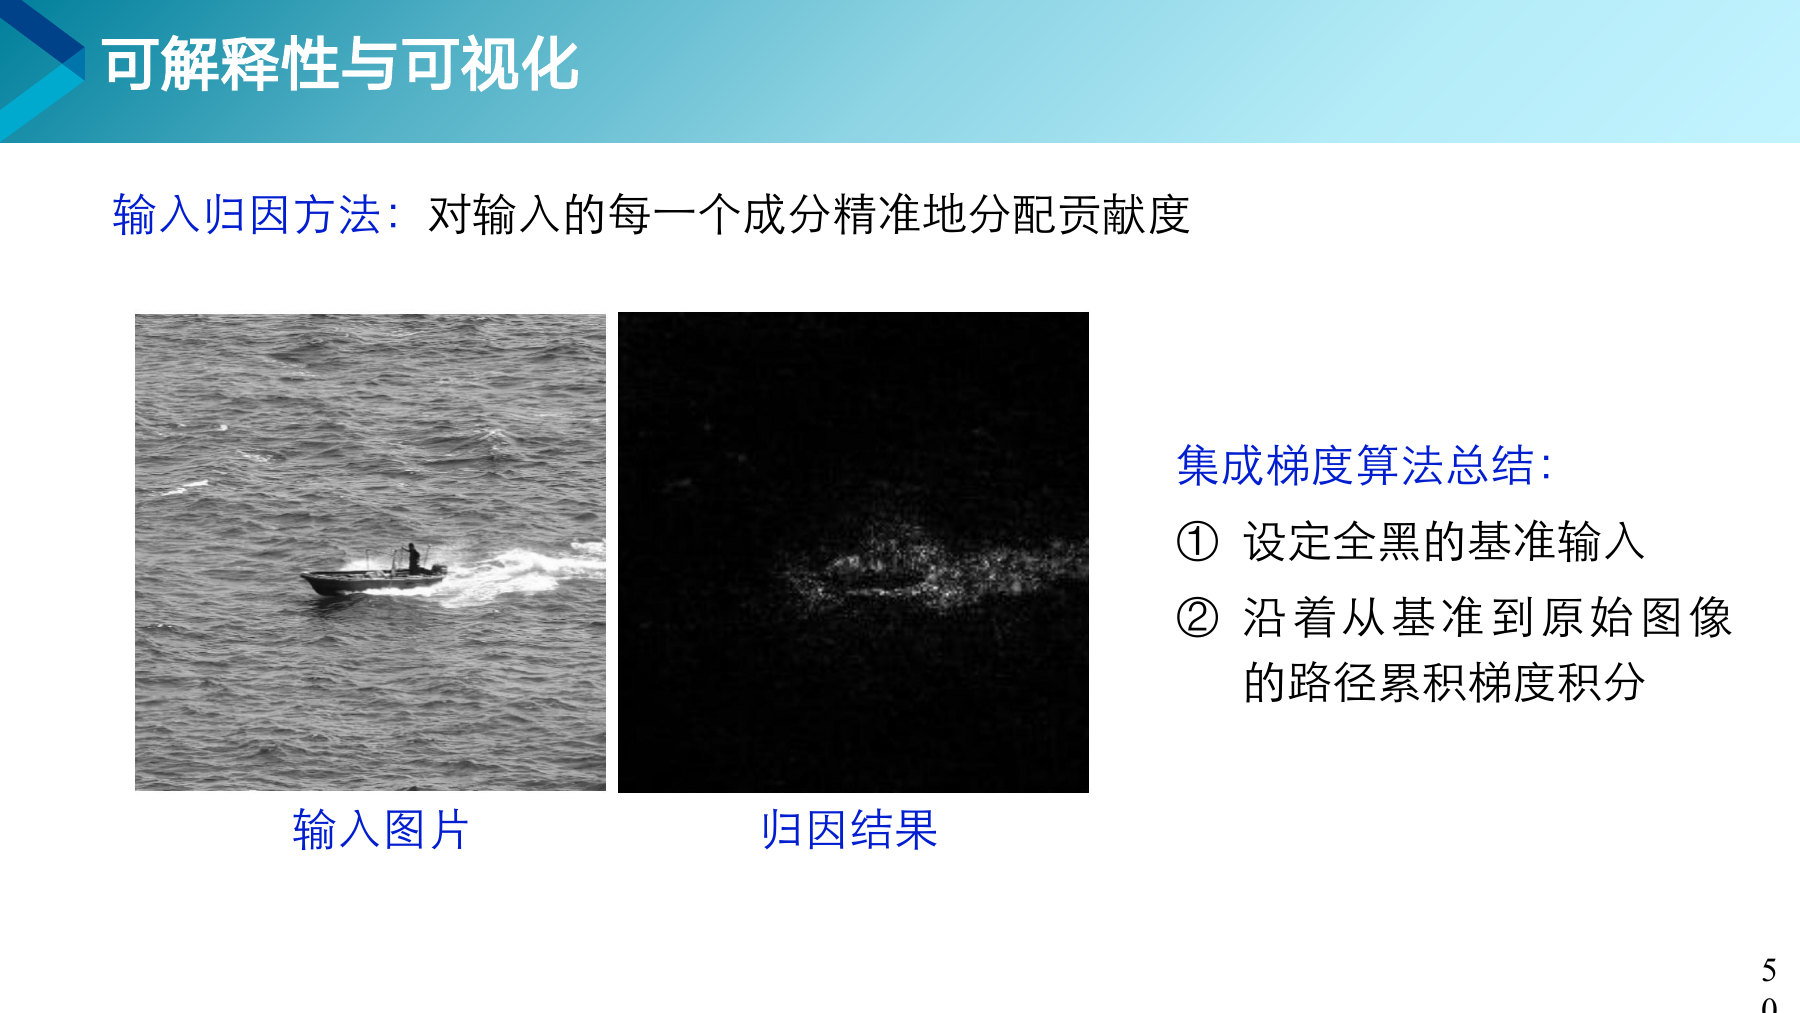
亮的地方就是对判断出力最多的像素。

第 50 页课件

重 点两张图对着看

左边是海面上的一艘小船。右边是归因结果,亮的是船和船尾翻起的白浪,远处的海面几乎全黑。模型判断“这是船”时,主要看的是船和它激起的浪花。图右侧列出的两步,就是前几页讲的做法。

知道更多抓出“蒙对”的模型

2016 年有研究者专门挑了一批照片来训练,照片里的狼都站在雪地上,哈士奇没有。模型把两者分得不错,解释工具一看,它盯着的是背景里的雪。只看准确率发现不了这种问题。

知道更多实验二

本章实验二会动手给一张图做归因,看模型看图时看的是哪儿。

51
第 4 章 · 第七节

t-SNE:把高维画到纸上

把高维的点摆到纸上,原来挨得近的,在纸上还要挨得近。

第 51 页 表示空间可视化:t-SNE

第一步:按距离给邻居打分

AB距离 1C距离 2D距离 5
A 的邻居距离相似度邻居分数
B10.60781.8%
C20.13518.2%
D50.000004约 0%
相似度随距离下降得很快,距离为 5 的 D 几乎是 0。把三个相似度换算成占比,就是 A 的邻居分数:A 的近邻几乎只有 B 和 C。
t-SNE 在原来的高维空间里给每个点都这样打分,再到纸上重新摆点,让纸上的邻居分数尽量和原来一样。它只在乎谁挨着谁,不太在乎远处的点离多远。
相似度按 e 的 −(距离² ÷ 2) 次方来算,比如距离为 2 时,e⁻² ≈ 0.135。

关键术语

t-SNEt-Distributed Stochastic Neighbor Embedding
t 分布随机邻居嵌入,把高维数据画到平面上的常用方法。
高维High-Dimensional
每个样本用很多个数来描述。模型内部的特征常有几百上千个数,没法直接画出来。

知道更多和 PCA 有什么不同

第 3 章的 PCA 是找一个好角度把点投影下来,保留整体上散得最开的方向。t-SNE 直接在纸上重新摆点,专门保住谁和谁是近邻。所以 t-SNE 图上团和团之间离多远,参考价值不大。

53
第 4 章 · 第七节

在纸上一轮轮挪点

纸上的邻居分数和原来差多少,就当作损失,用梯度下降降下来。

第 53 页 表示空间可视化:相似度对齐

t-SNE 的四步

先随手撒在纸上挪了很多轮以后
  1. 算原来的邻居分数 在高维空间里,按第 51 页的办法给每一对点打分。
  2. 随手撒点 在纸上随机放同样多的点,也给每一对点打分。纸上改用 t 分布来算,距离远时分数降得慢一些。
  3. 比一比 用 KL 散度衡量两套分数差多少,差得越多,损失越大。
  4. 挪点 用梯度下降一点点挪动纸上的点,让损失越来越小。原来挨得近的点慢慢聚到一起,同一类样本往往就聚成一团。
纸上改用 t 分布,是因为它随距离下降得慢,能把不同的团推得更开。

关键术语

KL 散度Kullback-Leibler Divergence
衡量两套邻居分数差多少的一个数,两套完全一样时为 0。
t 分布Student's t-Distribution
纸上用的另一种打分办法,距离变远时,分数比第 51 页那种降得慢。

打个比方

凭记忆画一张全班的座位关系图。你记得谁和谁是好朋友,就先在纸上随手画几个点,再反复挪动,直到好朋友都挨在一起,不太熟的离得远一些。

54
第 4 章 · 第七节

t-SNE 画出来的样子

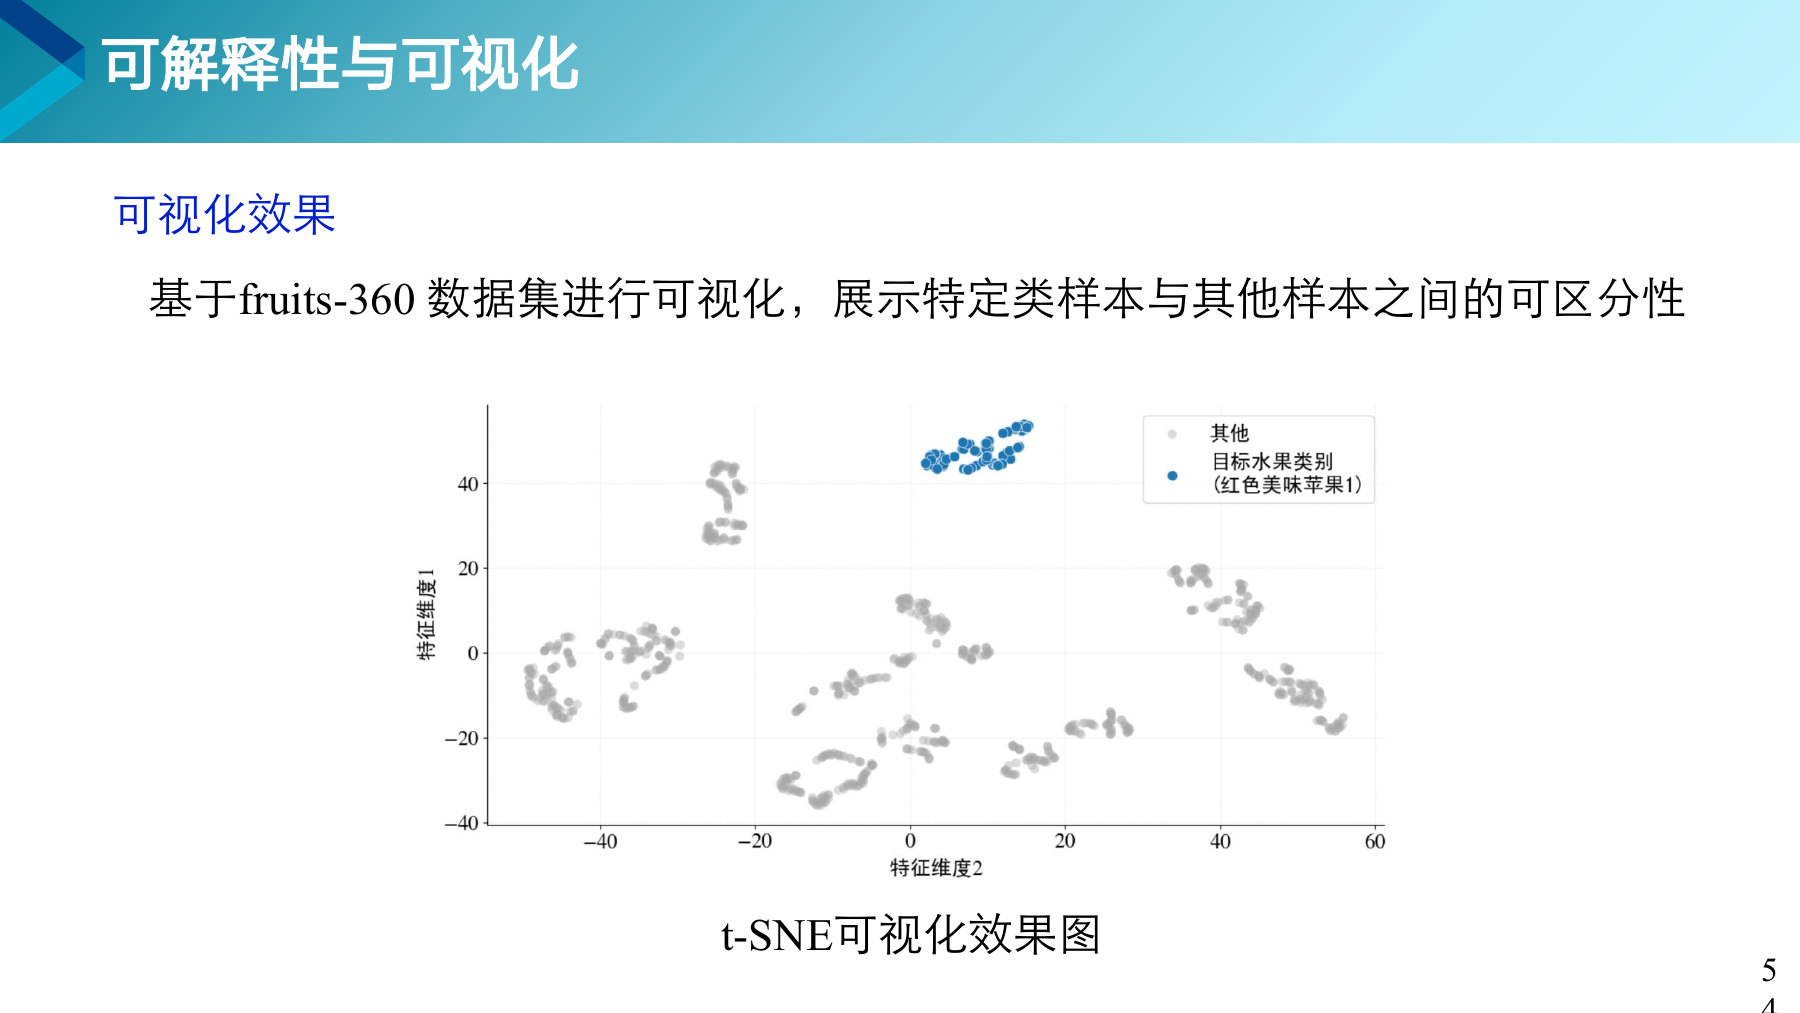
同一类样本聚成一团,说明模型能把这一类和别的类分开。

第 54 页课件

关键术语

Fruits-360Fruits-360
一个公开的水果图片数据集,每种水果和蔬菜都有很多张不同角度的照片。

重 点这张图怎么看

图里每个点是一张水果图片,位置由模型提取的特征经 t-SNE 摆出来。蓝色是目标类别红色美味苹果,灰色是其他水果。蓝点紧紧聚成一团,离灰点很远,说明模型能把这种苹果和别的水果分清。

知道更多一个常用的检查办法

训练完一个模型,把中间层的特征拿出来做一次 t-SNE,哪些类分得开、哪些类糊在一起,一眼就能看出来。

55
第 4 章 · 第七节

小结与思考

看神经元、看输入、看整体,三种办法从不同角度打开黑箱。

第 55 页 小结

三种看懂模型的办法

办法问的问题看的是怎么做
激活最大化这个神经元喜欢什么模型内部固定参数,改图片,让它最兴奋
集成梯度这张图的哪些像素起了作用输入从全黑走到原图,沿路攒梯度
t-SNE所有样本在模型眼里怎样分布整体把高维特征摆到纸上,保住近邻
三种办法看的地方不同,常常配合着一起用。

重 点为什么要看懂模型

第 50 页狼和哈士奇的例子里,模型分得不错,靠的却是背景里的雪。用在看病、开车这些场合之前,要先弄清它依靠什么做判断。

想一想

如果模型给出的解释看起来完美无缺,怎样判断它是学到了规律,还是恰好骗过了解释工具?

查看参考思路
可以动手做干预实验。把归因图上最亮的区域遮住或换掉,看模型的判断是不是随之改变。再把这块区域贴到别的背景上,看模型是否还认得出。如果遮掉“关键区域”后判断纹丝不动,说明这份解释不可信。
56
第 4 章 · 第七节

课后欢迎交流

第 4 章到这里结束。

第 56 页课件

知道更多这一章学了什么

标注少,就用自监督学习让数据自己出题。任务多,就用模型迁移把学过的本事搬过去。模型大,就用量化、剪枝、蒸馏把它压小。训练资源紧,就用数据增广、分布式训练和混合精度。最后用三种办法看清模型学到了什么。

知道更多下一章

第 5 章讲人工智能生成内容与大模型,看机器怎样画图、写文章、和人对话。

保山学院·人工智能教研室·曹鼎鼎