分布式训练:把任务拆开
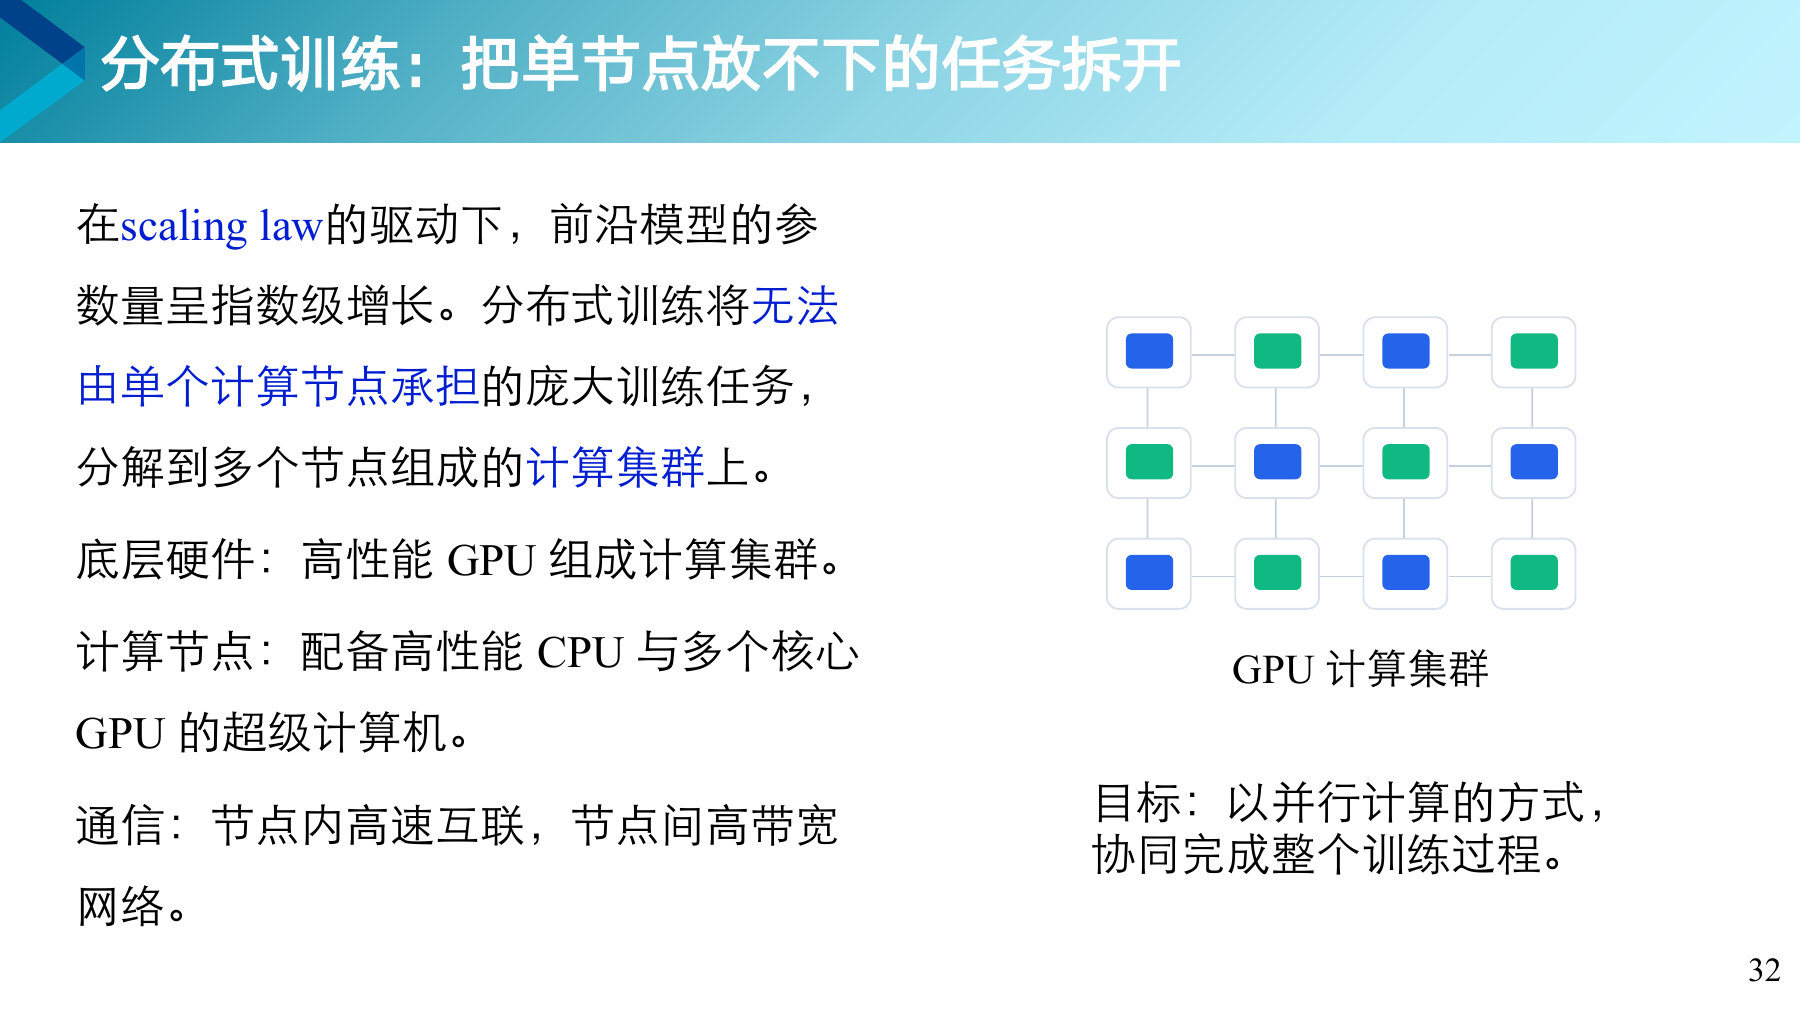
一台机器放不下的训练任务,拆给很多台机器一起做。

关键术语
重 点为什么非拆不可
前沿模型的参数量增长得很快,单张显卡的显存远远跟不上。模型一张卡放不下,训练一次也要算很久,只能让成百上千张卡分工合作。
一台机器放不下的训练任务,拆给很多台机器一起做。

前沿模型的参数量增长得很快,单张显卡的显存远远跟不上。模型一张卡放不下,训练一次也要算很久,只能让成百上千张卡分工合作。
每张卡放一份完整模型,各算一部分数据,再把结果合起来。
四位老师分头批改同一场考试的卷子,每人手里都有一份完整的评分标准,各改一摞。改完碰个头,把各自发现的问题汇总起来,一起修改评分标准,保证四个人的标准始终一样。
用 8 张卡做数据并行,一批数据有 1024 张图,每张卡分到多少张?
模型大到一张卡放不下,就把模型本身切开。
把 8 层的模型按层切成 4 段,每张卡负责 2 层。数据从第 1 张卡流到第 4 张卡,像工厂的流水线。常用在不同机器之间。
把一层里的一大块乘法和加法切成两半,两张卡同时算,再把结果拼起来。两张卡要频繁交换数据,通常放在同一台机器里,靠高速连线通信。
流水线并行像汽车装配线,第一个工位装底盘,第二个工位装车身,车一辆接一辆往下传。张量并行像两个人合抬一张大桌子,必须同时用力,靠得很近,配合很紧。
切什么不一样,卡与卡之间交换数据的频繁程度也不一样。
| 数据并行 | 流水线并行 | 张量并行 | |
|---|---|---|---|
| 切的是 | 训练数据 | 模型的层 | 一层内部的计算 |
| 每张卡放 | 完整的模型 | 其中几层 | 每层的一部分 |
| 多久交换一次 | 低:每轮结束同步一次梯度 | 中:相邻两段之间传中间结果 | 高:每算一层都要交换 |
| 主要麻烦 | 卡越多,同步梯度越费时 | 有的卡要空等上一段 | 通信太频繁,很难扩展到很多卡 |
哪种并行方式要求每张卡都能放下完整的模型?
三种资源可以互相交换,省下一样,就要多花另一样。
| 技巧 | 拿什么换什么 | 怎么做 |
|---|---|---|
| 激活重算 | 多花计算,省显存 | 正向算出的中间结果不全存,反向要用时再算一遍 |
| FSDP | 多花通信,省显存 | 模型切碎分给各张卡保管,用到哪块临时取来 |
| 内存卸载 | 多花搬运,省显存 | 暂时用不上的数据搬到电脑的内存里放着 |
| 通信压缩 | 多花计算,省通信 | 数据先压缩或量化变小,再传给别的卡 |
做一道很长的计算题,草稿纸不够用。可以把每一步的中间结果都记下来,多占纸。也可以只记关键几步,需要时再重算一遍,多花时间。显存像草稿纸,激活重算选的是后一种。
模型切碎分给各张卡保管,用到哪块临时取哪块。
每张卡都存一整份:参数、梯度、优化器要记的数,合计约 16 GB。四张卡存的内容一模一样。
把这 16 GB 切成 4 片,每张卡只保管一片,约 4 GB。算到某一层时,临时把这一层的参数从别的卡取来,用完就放掉。
一个车间四个工位,以前每个工位都配一整套工具,大部分时间闲着占地方。现在每个工位只放四分之一,要用别的工具就去隔壁借,用完马上还。地方省了,代价是多跑几趟。
指数位管能表示多大,尾数位管能分多细。
| 格式 | 最大能表示 | 把 100.7 存进去 | 常用在 |
|---|---|---|---|
| FP32 | 约 3.4 × 10³⁸ | 100.7 | 存参数、更新参数 |
| FP16 | 65504 | 100.6875 | 混合精度训练、推理 |
| BF16 | 约 3.4 × 10³⁸ | 100.5 | 大模型训练的主流 |
指数位像尺子的长度,尾数位像尺子上的刻度。量一栋楼,宁可用刻度粗但足够长的尺子,也不要刻度很细却只有十厘米的尺子。
训练中算出了一个数 70000,用哪种格式存会上溢变成无穷大?
算的时候用 16 位,存参数和更新参数用 32 位。
| 参数 1.0 加上一次很小的改动 0.0001 | 结果 |
|---|---|
| 用 FP32 记 | 1.0001 |
| 用 FP16 记 | 1.0,这次改动被抹掉了 |
记账时,平时的流水账写个大概,几十几百地记,快。月底结账用精确到分的总账本,慢一点但不能出错。
FP16 表示不了特别小的数,比约 0.00000006 还小的梯度会直接变成 0,这叫下溢。常见的办法是先把损失乘上一个大数,比如 1024,算完梯度再除回去。