人工智能导论 第 4 章 · 第三节
课程 › 第 4 章 › 第三节 模型迁移复用与微调跨模态迁移量化剪枝知识蒸馏推理加速前三节小结
第 4 章 深度学习新方法 · 第三节

模型迁移与轻量化

学过的本事搬到新任务上,大模型压成小模型
本 节 知 识 点
  1. 16模型迁移
  2. 17模型复用与模型微调
  3. 18跨模态迁移:从看懂到动手
  4. 19模型量化:换成更短的数
  5. 20模型剪枝:去掉没用的连接
  6. 21知识蒸馏:小模型学大模型
  7. 22让大模型说话更快
  8. 23前三节小结
16
第 4 章 · 第三节

模型迁移

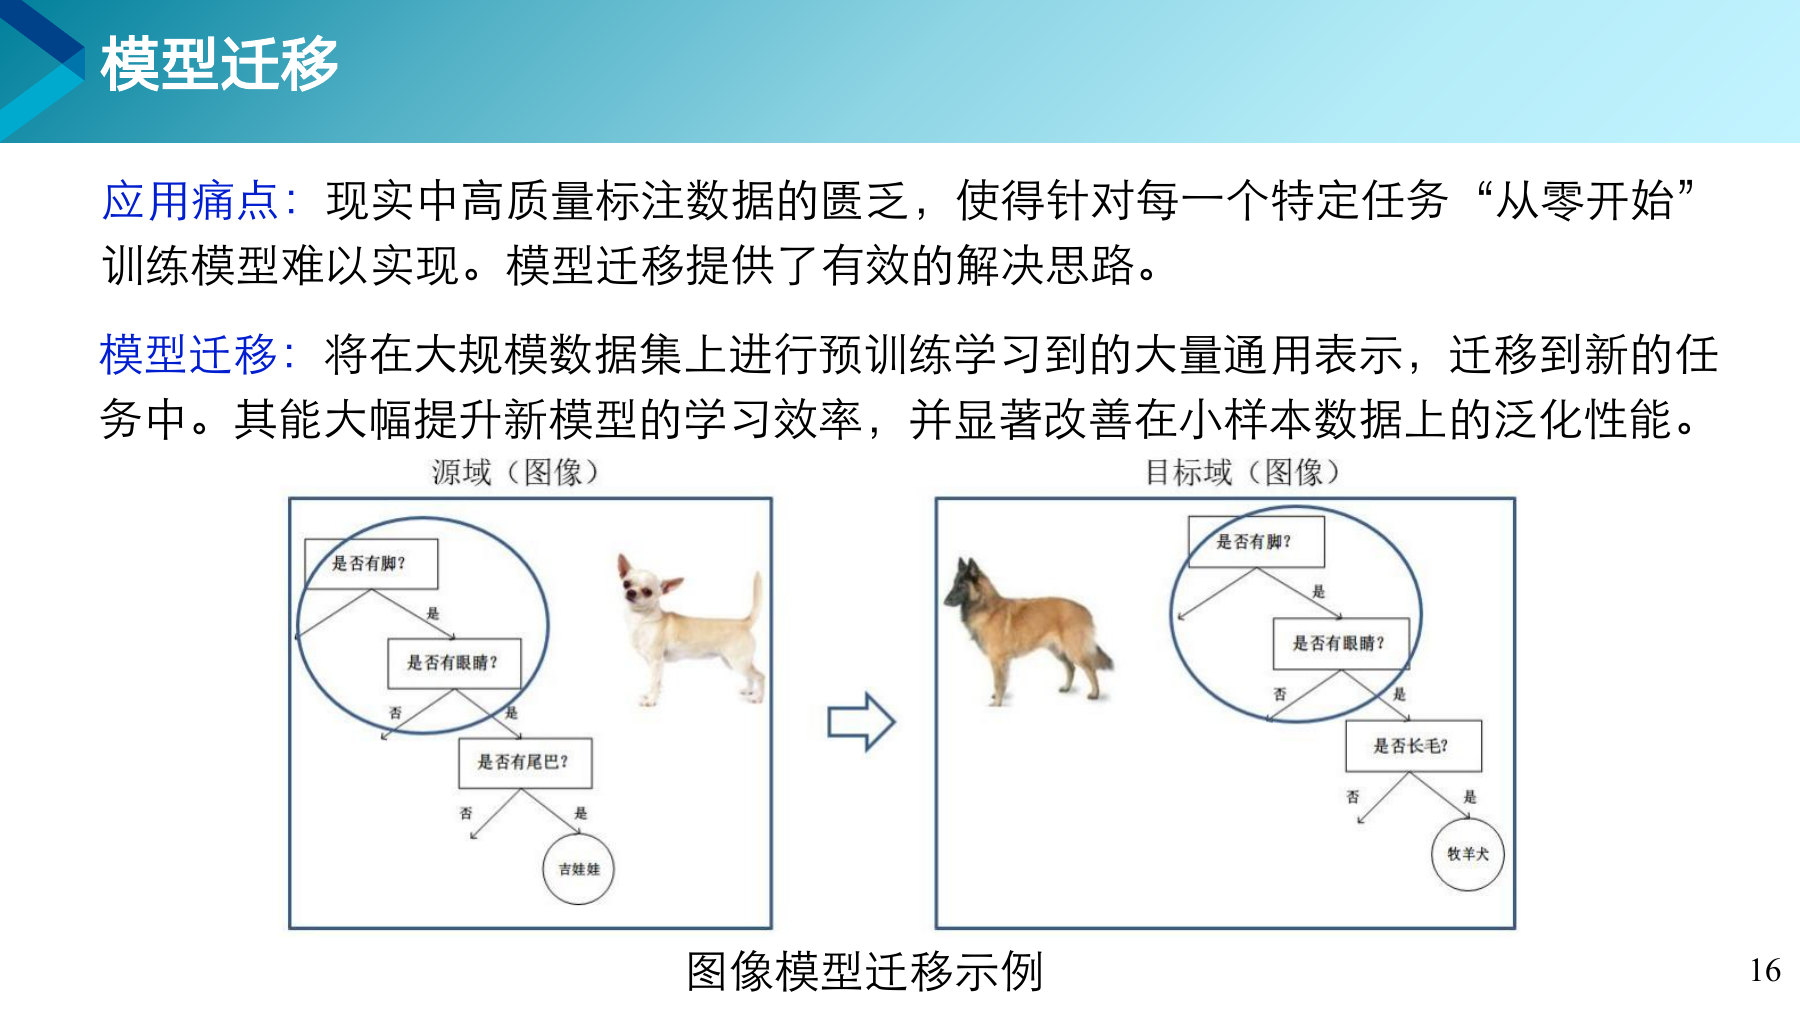
不必每个任务都从零练起,把学过的本事搬过去用。
第 16 页课件

关键术语

模型迁移Transfer Learning
把在大数据上预训练学到的本领,用到新的任务上。
源域与目标域Source / Target Domain
原来学的那个任务叫源域,要搬过去的新任务叫目标域。

重 点看图上的两棵决策树

左边的模型会认吉娃娃,右边要认牧羊犬。“有没有脚”“有没有眼睛”这些判断两边都用得上,直接搬过来。只有最后一步需要改,把“有没有尾巴”换成“是不是长毛”。

打个比方

学过钢琴的人去学电子琴,识谱、节奏、指法都能直接用,只需要熟悉新琴的按键和音色。
17
第 4 章 · 第三节

模型复用与模型微调

预训练模型可以原样拿来用,也可以在它的基础上再练一练。

第 17 页 模型迁移的两类方法

三种用法:哪些部分要训练

模型复用预训练模型参数不动新任务的头全部微调预训练模型参数小幅调整新任务的头参数高效微调预训练模型参数不动新块新任务的头不训练要训练新插入的一小块
做法怎么做适合什么情况
模型复用预训练模型一个参数都不动,只训练后面新接的小头数据很少,新任务和原来很像
全部微调预训练模型的参数也跟着小幅调整数据多一些,想要效果更好
参数高效微调原模型不动,插入一小块新参数来训练模型很大,全部微调太费钱

关键术语

冻结Freeze
训练时让一部分参数保持不变。
参数高效微调Parameter-Efficient Fine-Tuning
只训练新插入的少量参数,原模型不动,常简称 PEFT。

重 点复用的一个例子

把 DINOv3 当成现成的看图工具,参数全部冻结,后面接一个小小的分割头,只训练这个头,就能把月球地面照片里的不同地貌分出来。

随堂练习

用预训练模型做复用时,训练过程中哪一部分的参数会改变?

  1. 预训练模型的全部参数
  2. 只有后面新接的小头
  3. 预训练模型的前几层
  4. 所有参数都不变
查看答案
答案 B。复用时预训练模型被冻结,只有新接上的小头在训练。全部微调时,预训练模型的参数才会跟着调整。
18
第 4 章 · 第三节

跨模态迁移:从看懂到动手

从图片和文字里学到的常识,被搬到了机器人的动作上。

第 18 页 跨模态迁移案例

视觉-语言-动作模型怎样工作

输入相机拍到的画面
和一句文字指令
→
视觉语言模型从海量图文里
预训练出的常识
→
动作专家把理解变成
关节该怎么动
→
输出机器人的
一连串动作
从别处搬来的

什么是杯子、什么是衣服、“叠好”是什么意思,这些常识是视觉语言模型在网上的图片和文字里学到的。

在这里补学的

手臂先往哪伸、夹多紧、转多少度,这些要靠机器人的示范数据和实际练习来学。

这里的例子是 2025 年 11 月发布的机器人模型 π*0.6。它在做咖啡、折纸箱、叠 T 恤等任务上的成功率达到九成以上,叠各式各样的衣物这一项略低。

关键术语

模态Modality
信息的形式,比如图片、文字、声音、动作各是一种模态。
VLAVision-Language-Action
视觉-语言-动作模型,看画面、听指令,直接输出机器人的动作。

打个比方

一个读过很多菜谱、看过很多做菜视频的人,知道番茄炒蛋该怎么做,第一次真下厨时手还是会生。菜谱里的知识是搬来的,颠勺的手感要自己在灶台前练。

19
第 4 章 · 第三节

模型量化:换成更短的数

把 32 位的小数换成 8 位的整数,模型小了四分之三。

第 19 页 模型轻量化:模型量化

用 −127 到 127 的整数,记下 −1 到 1 之间的权重

原来的权重(32 位)乘以 127 后取整(8 位)用时再除以 127误差
0.7324930.73230.0001
−0.2150−27−0.21260.0024
0.046860.04720.0004
−0.9031−115−0.90550.0024
每个数从 4 个字节变成 1 个字节。一个有 70 亿个参数的模型,原来要 28 GB,量化以后只要约 7 GB。表中四个数的误差都不到千分之三,这样换算,误差最大也只有约千分之四。
训练后量化(PTQ)

模型训练好以后直接换算,只用少量数据看一看每层数值的范围。不用重新训练,又快又省事。

量化感知训练(QAT)

训练时就模拟取整带来的误差,让模型提前适应。要重新训练,误差更小。

关键术语

位与字节Bit / Byte
位是计算机存数的最小单位,只能是 0 或 1。8 位合成 1 个字节。
模型轻量化Model Compression
在尽量不降低效果的前提下,让模型变小、变快、少占显存。
PTQ 与 QATPost-Training Quantization / Quantization-Aware Training
训练后量化与量化感知训练。

打个比方

记账时把 12.37 元记成 12.4 元,每个数少记一位小数,账本省了地方,月底算总账也差不了多少。

随堂练习

一个 70 亿参数的模型,每个参数从 32 位换成 4 位,大约要多少存储?

  1. 28 GB
  2. 14 GB
  3. 7 GB
  4. 3.5 GB
查看答案
答案 D。8 位是 1 个字节,4 位是半个字节。70 亿 × 0.5 字节 = 35 亿字节,约 3.5 GB。
20
第 4 章 · 第三节

模型剪枝:去掉没用的连接

很多权重接近 0,对结果影响很小,可以剪掉。

第 20 页 模型轻量化:模型剪枝

同一组权重,两种剪法

原来的权重0.82−0.070.450.03−0.040.060.02−0.050.61−0.730.090.340.180.52−0.06−0.88非结构化剪枝0.8200.45000000.61−0.7300.340.180.520−0.88结构化剪枝0.82−0.070.450.030.61−0.730.090.340.180.52−0.06−0.8816 个数零散地清零 8 个整行拿掉,剩 3 行
非结构化剪枝

绝对值小于 0.1 的权重一律清零。清掉的数零零散散,剩下的格子形状不规整。

结构化剪枝

每一行是连到同一个神经元的四个权重。第 2 行的四个都很小,说明这个神经元作用不大,就把整行拿掉。剩下的仍是规整的 3 行 4 列。

非结构化剪得多,这里清掉了一半,可零散的 0 不一定能让计算变快。结构化剪得少,却直接得到一个更小的模型,实际提速更明显。

关键术语

剪枝Pruning
去掉神经网络里多余的参数或结构。
非结构化剪枝Unstructured Pruning
一个一个地把小权重清零。
结构化剪枝Structured Pruning
按整个神经元、通道、层或注意力头成块地拿掉。

打个比方

整理书架时,从每本书里撕掉几页用不着的,书一本不少,照样占着地方。把整本不看的书拿走,书架才真的空出位置。前一种像非结构化剪枝,后一种像结构化剪枝。

21
第 4 章 · 第三节

知识蒸馏:小模型学大模型

让一个小的学生模型,去模仿一个大的教师模型的答案。

第 21 页课件

关键术语

知识蒸馏Knowledge Distillation
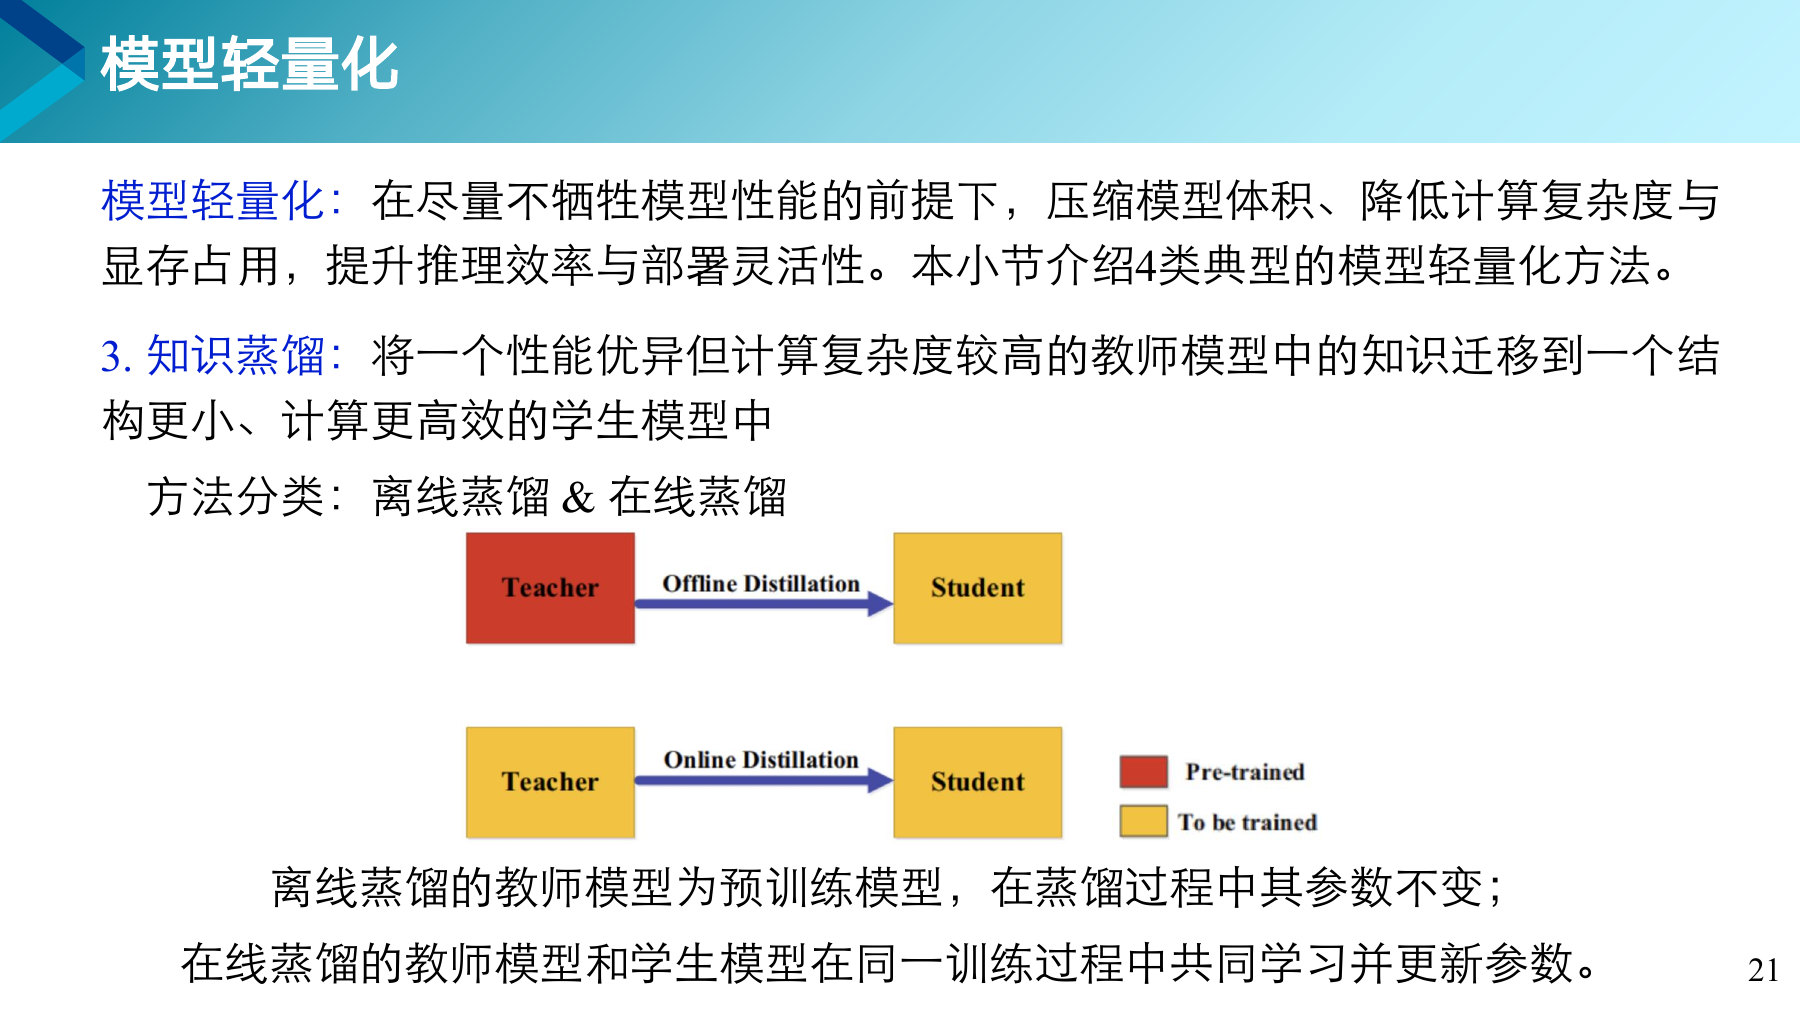
把大模型(教师)学到的本领,传给结构更小、算得更快的小模型(学生)。

重 点离线与在线

红色表示已经训练好的,黄色表示正在训练的。离线蒸馏的教师早就训练好了,蒸馏时参数不变,只有学生在学。在线蒸馏的教师和学生在同一次训练里一起学、一起更新。

打个比方

大模型看一张猫的照片,不只说“是猫”,还会给出“像猫 0.90,像狗 0.08,像老虎 0.02”。学生从这些数里还能学到,猫和狗、老虎都有几分像。这比只告诉它一个“猫”字有用得多。

22
第 4 章 · 第三节

让大模型说话更快

一个把算过的存起来,一个让小模型先猜、大模型核对。

第 22 页 模型轻量化:语言模型推理加速

大模型是一个字一个字往外写的

键值缓存:算过的不再算

不存的话,每写一个新字都要把前面的字重新算一遍,写 100 个字共要处理 1 + 2 + … + 100 = 5050 次。把算过的中间结果存下来,每个字只算一次,共 100 次。

预测解码:先猜,再核对

小模型很快猜出后面几个字,大模型一次核对完。猜对的直接用,第一个猜错的字换成大模型自己的答案。

已经写出床前明月光,小模型猜疑是地下大模型核对✓✓✓✗这一轮得到疑是地上大模型只跑了一次
上图里,大模型只跑了一次,就写出了四个字。不用预测解码,它要跑四次。键值缓存多占了显存,换来了速度,叫以空间换时间。

关键术语

键值缓存KV Cache
把前面每个字算出的“键”和“值”两组中间结果存起来,后面直接取用。
预测解码Speculative Decoding
也叫投机解码,小模型先猜几个字,大模型一次核对。

重 点为什么核对比自己写快

大模型自己写,一次只能写一个字。核对时几个字可以一次算完,花的时间和写一个字差不多。小模型大多数时候猜得准,整体就能快上两三倍。

随堂练习

按面板里的例子,这一轮大模型跑了几次,得到了几个字?

  1. 跑 4 次,得到 4 个字
  2. 跑 1 次,得到 3 个字
  3. 跑 1 次,得到 4 个字
  4. 跑 4 次,得到 3 个字
查看答案
答案 C。大模型一次核对了四个字,前三个采用,第四个换成它自己的“上”。
23
第 4 章 · 第三节

前三节小结

自监督练出本领,迁移搬走本领,轻量化让模型跑得动。

第 23 页 小结

前三节讲了什么

要解决的问题办法一句话记住
没有人来标注自监督学习数据自己出题:遮住再补,或者认出同一张图
对比学习怎么算InfoNCE 损失正样本在所有候选里的份额越大,损失越小
每个任务从零练太贵模型迁移复用或微调,把学过的本事搬过去
模型太大跑不动模型轻量化量化换短数,剪枝去连接,蒸馏换小模型,推理时存结果、先猜后验

知道更多三节连成一条线

先用没有标注的海量数据练出一个大模型,再把它迁移到各种具体任务上,最后压小,放进手机和普通电脑里用。今天很多人工智能产品都是沿着这条路做出来的。

随堂练习

想让一个大模型装进手机里运行,下面哪种办法不属于模型轻量化?

  1. 量化
  2. 剪枝
  3. 知识蒸馏
  4. 数据增广
查看答案
答案 D。量化、剪枝、蒸馏都是让模型变小。数据增广是扩充训练数据的办法,下一节会讲,它不会让模型变小。
保山学院·人工智能教研室·曹鼎鼎