第 4 章 · 第一节
深度学习新方法
标注少、模型大、算力紧,这一章讲应对这三件难事的办法。
知道更多本章讲什么
第一至三节讲没有标注也能训练的自监督学习,以及怎样把练好的模型搬到新任务上、压得更小。第四、五节讲训练时补数据、补算力、省显存的技巧。第六、七节讲怎样看清模型内部学到了什么。
重 点和第 3 章的不同
第 3 章的逻辑回归、决策树等方法要用人标好的答案,模型也不大。这一章面对的情况正好相反:标注很少,模型很大,一张显卡可能都装不下。
标注少、模型大、算力紧,这一章讲应对这三件难事的办法。
第一至三节讲没有标注也能训练的自监督学习,以及怎样把练好的模型搬到新任务上、压得更小。第四、五节讲训练时补数据、补算力、省显存的技巧。第六、七节讲怎样看清模型内部学到了什么。
第 3 章的逻辑回归、决策树等方法要用人标好的答案,模型也不大。这一章面对的情况正好相反:标注很少,模型很大,一张显卡可能都装不下。
监督学习靠人标的答案,自监督学习的答案藏在数据里。
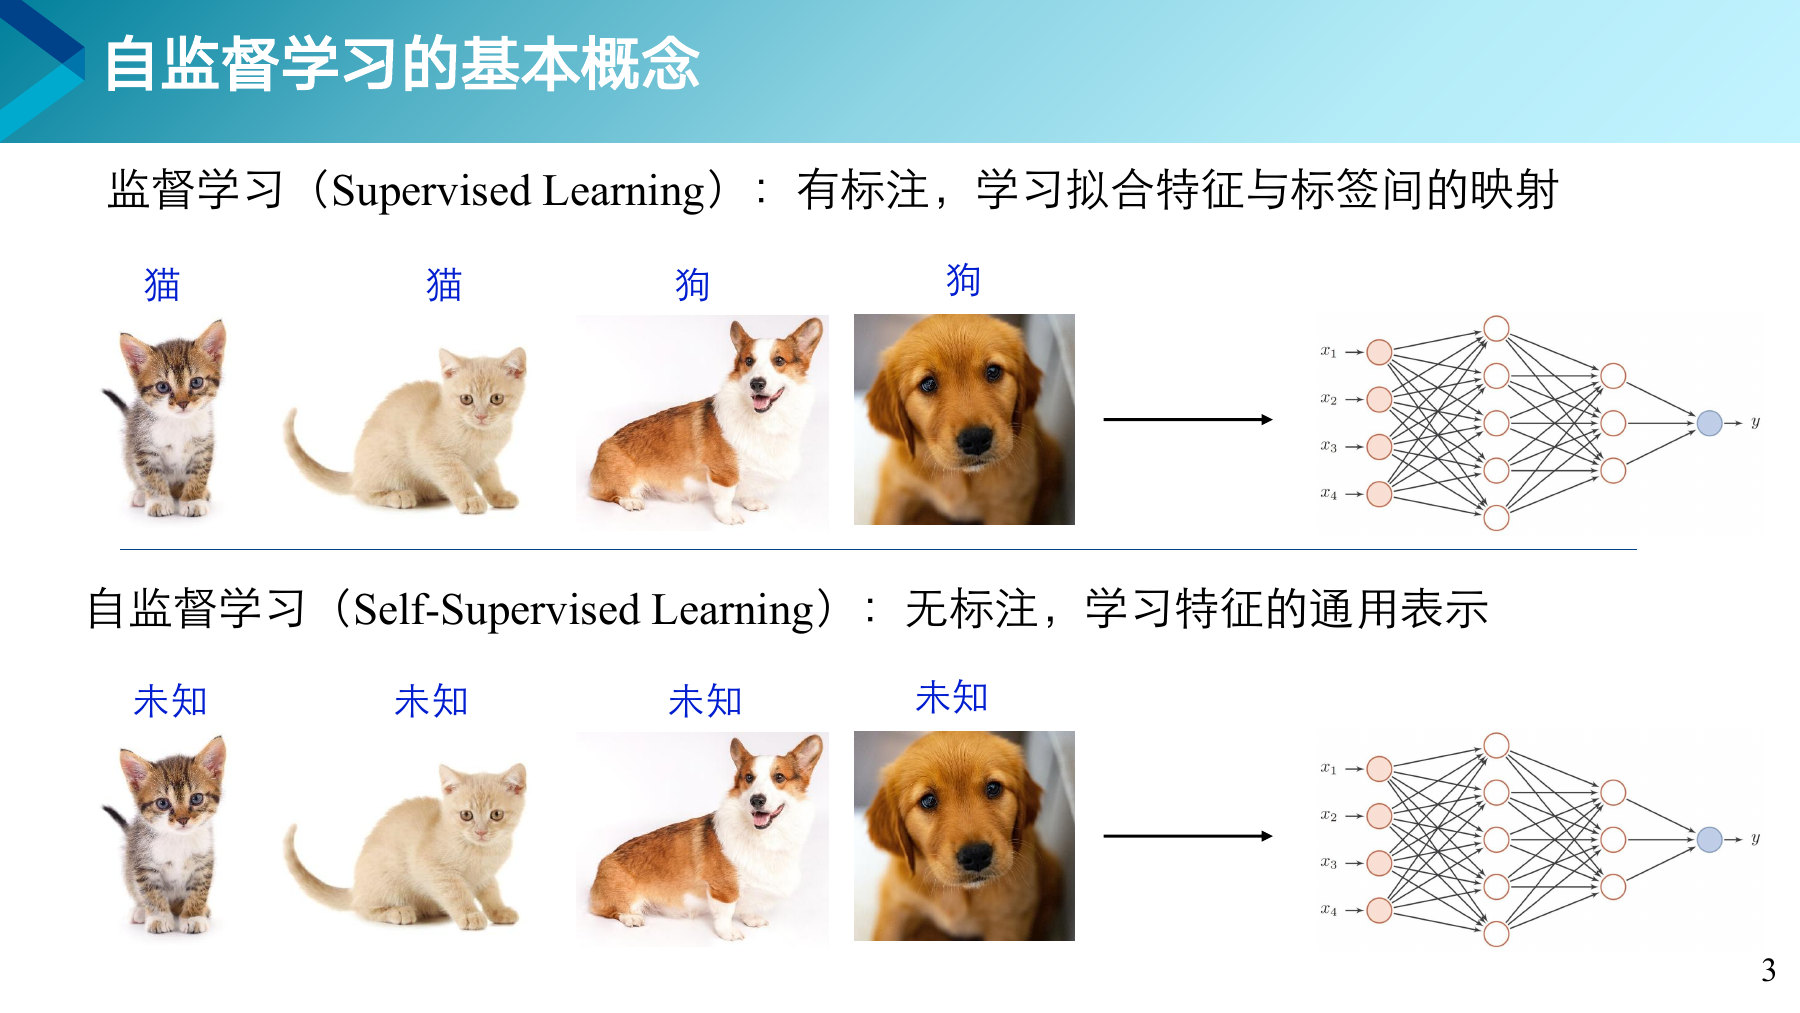
上面一行,每张照片都标好了猫或狗,模型照着答案学。下面一行全是“未知”,没有人告诉模型这是什么。两行用的网络可以一模一样,差别在于训练用的答案从哪里来。
做配了答案的练习册,是监督学习。拿一篇课文遮住几个字默写,写完翻书对照,是自监督学习,答案就在课文里。
先用海量无标注数据练基本功,再用少量标注数据学具体任务。
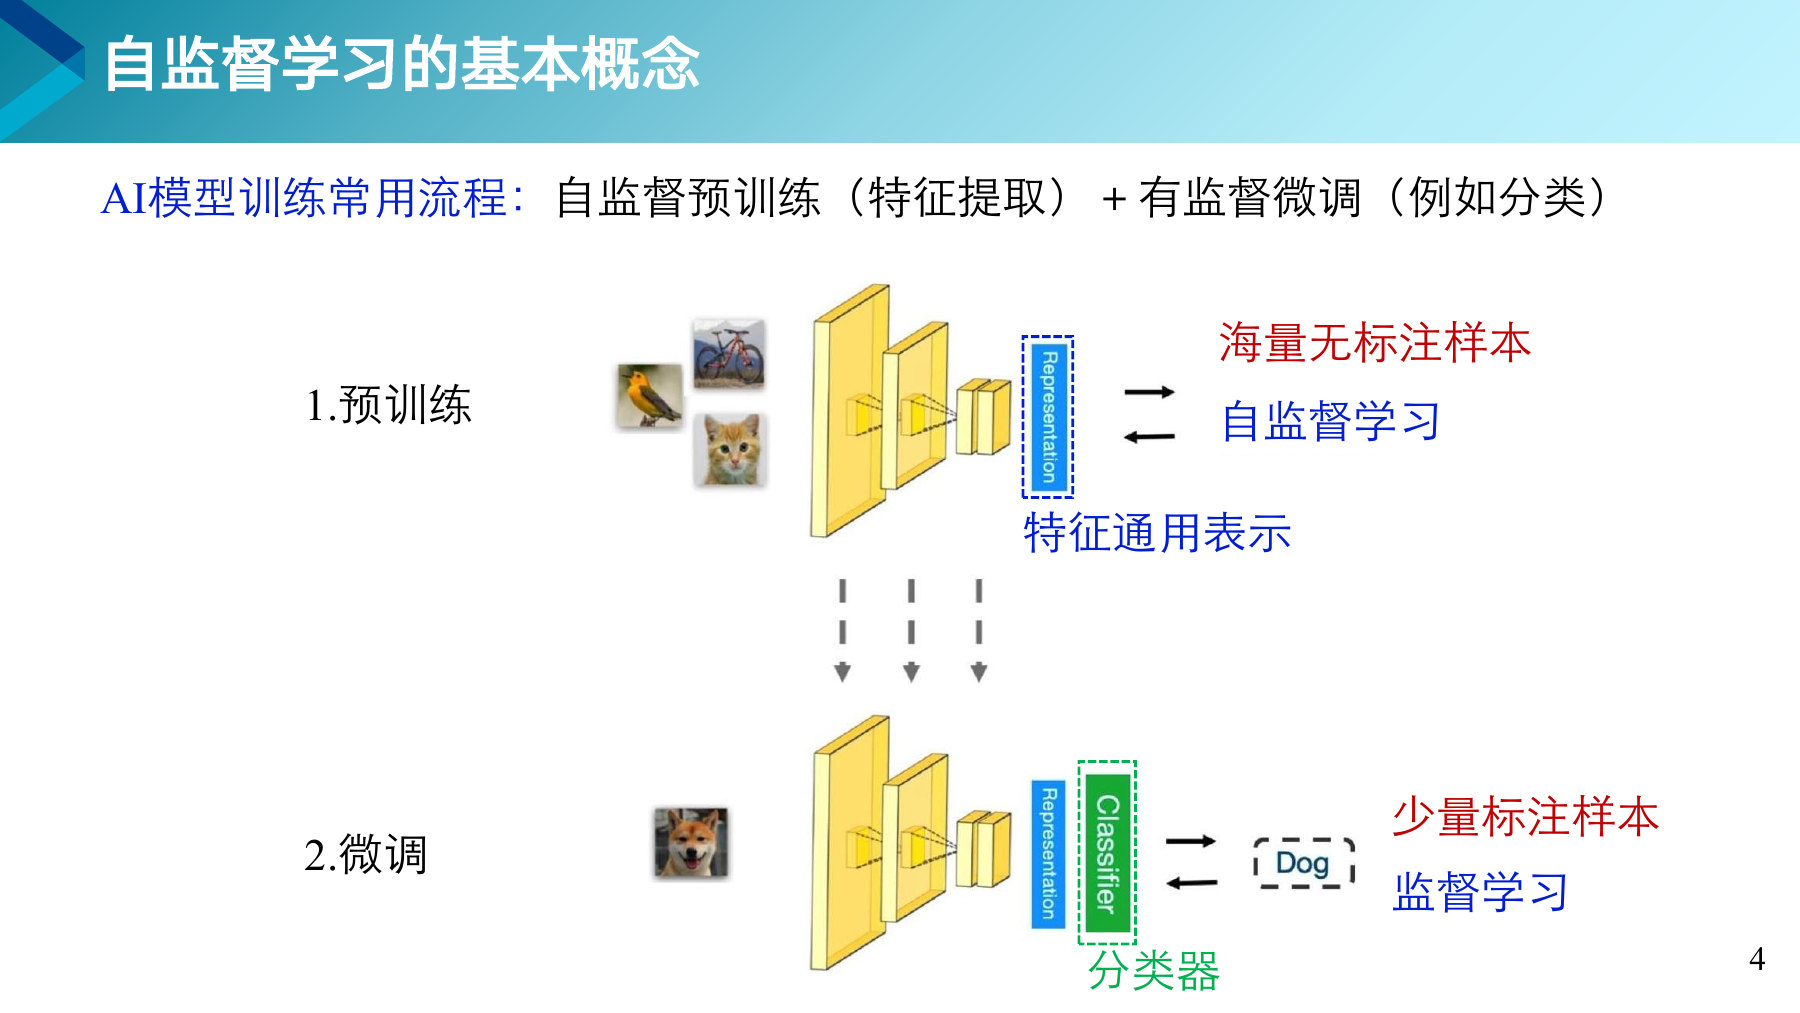
第一步用海量没有标注的图片做自监督学习,学会一套通用的看图本领,图中叫“特征通用表示”。第二步接上分类器(Classifier),只用少量标好的图片教它认狗。
先读十几年书打基础,这时还不知道以后做什么工作。入职后做几周岗位培训就能上手。上学对应预训练,岗位培训对应微调。
一类是遮住一部分让模型补,一类是让模型认出同一张图。
把句子遮掉一个字,或把图片涂黑几块,让模型根据剩下的部分补出来。答案就是被遮住的原文。
把同一张图裁剪、调色,做出两个版本。模型要认出这两个版本来自同一张图,并把它们和别的图区分开。
要把“窗外下着?雨”补成“大雨”,模型得知道雨有大有小。要认出裁剪、调色后的猫还是那只猫,模型得抓住猫的模样,不能只记颜色。做这些题,逼着模型学会看懂内容。
掩码学习像做完形填空。对比学习像在一叠照片里,找出同一张照片的彩色版和黑白版,不用说出照片上是谁,只要认出它们是同一张。
遮住句子里的词或图片的一部分,让模型从上下文把它推出来。
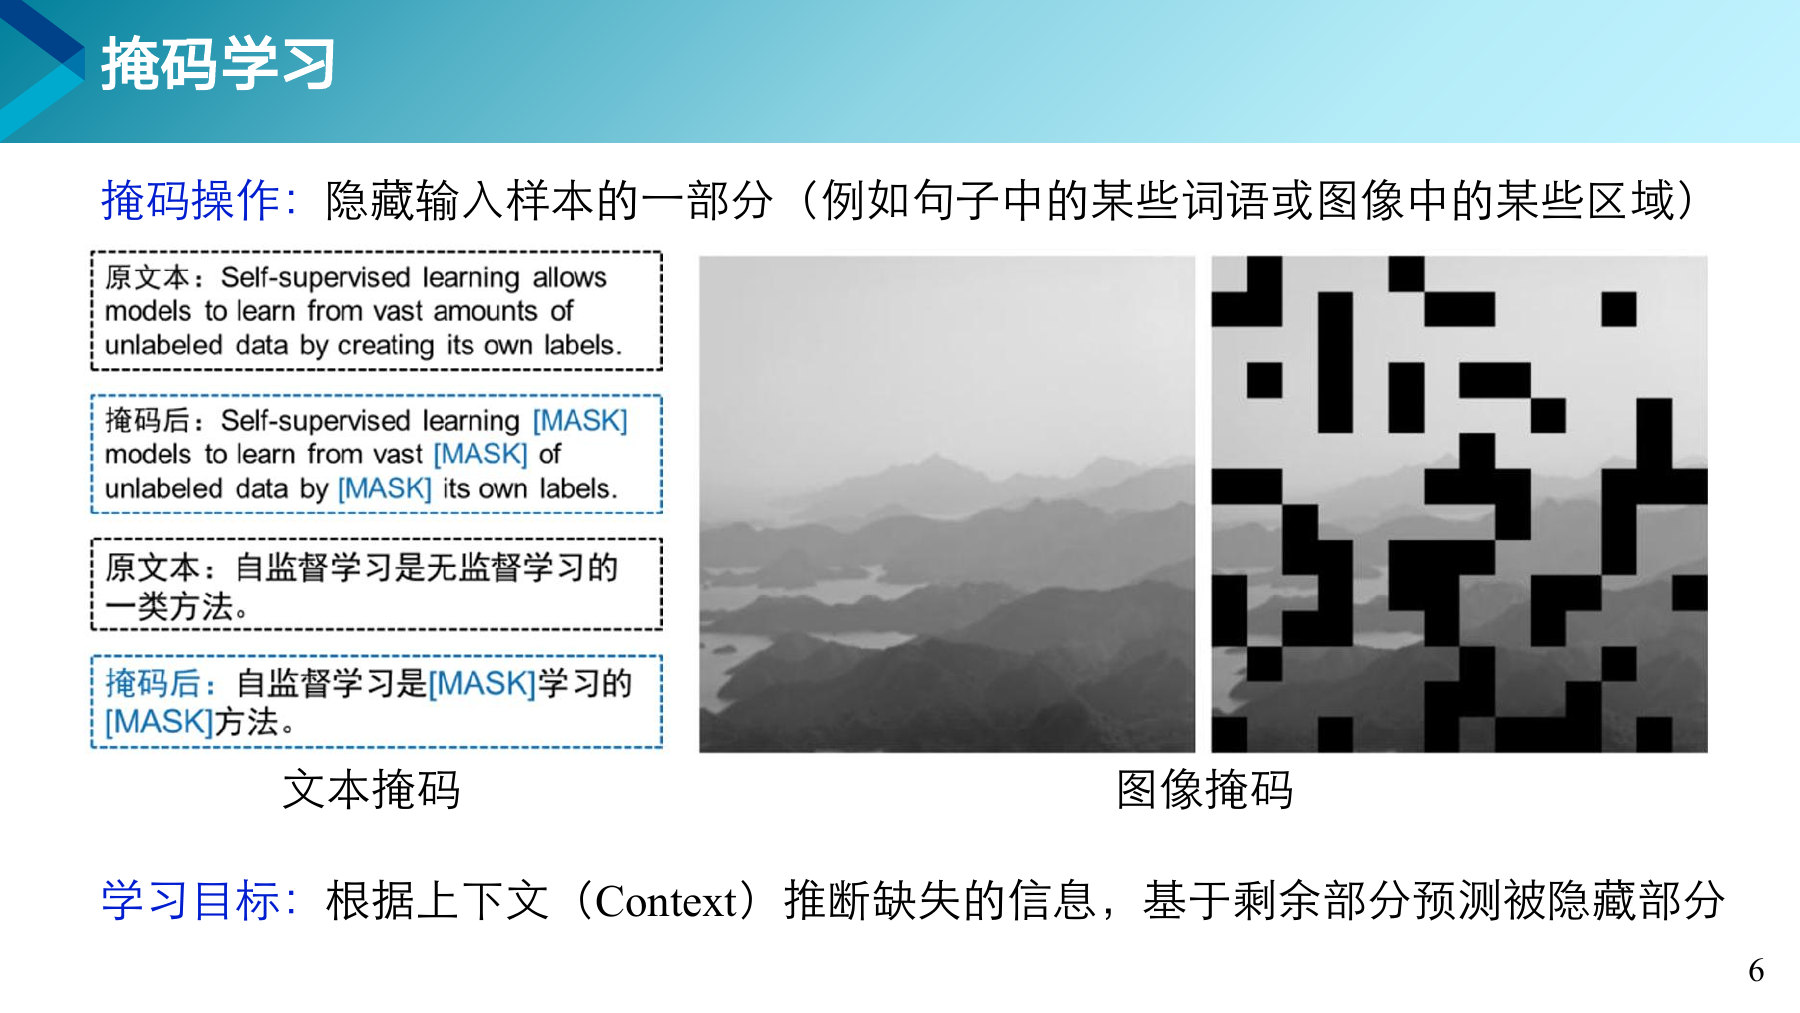
左边把一句英文和一句中文里的几个词换成 [MASK],让模型猜出原词。右边把一张山景图切成小方块,随机涂黑一大片,让模型把涂黑的地方画回来。
把“自监督学习是无监督学习的一类方法”遮成“自监督学习是[MASK]学习的[MASK]方法”,训练时的标准答案从哪里来?
一种只看前文往后接,一种看着前后往中间填。
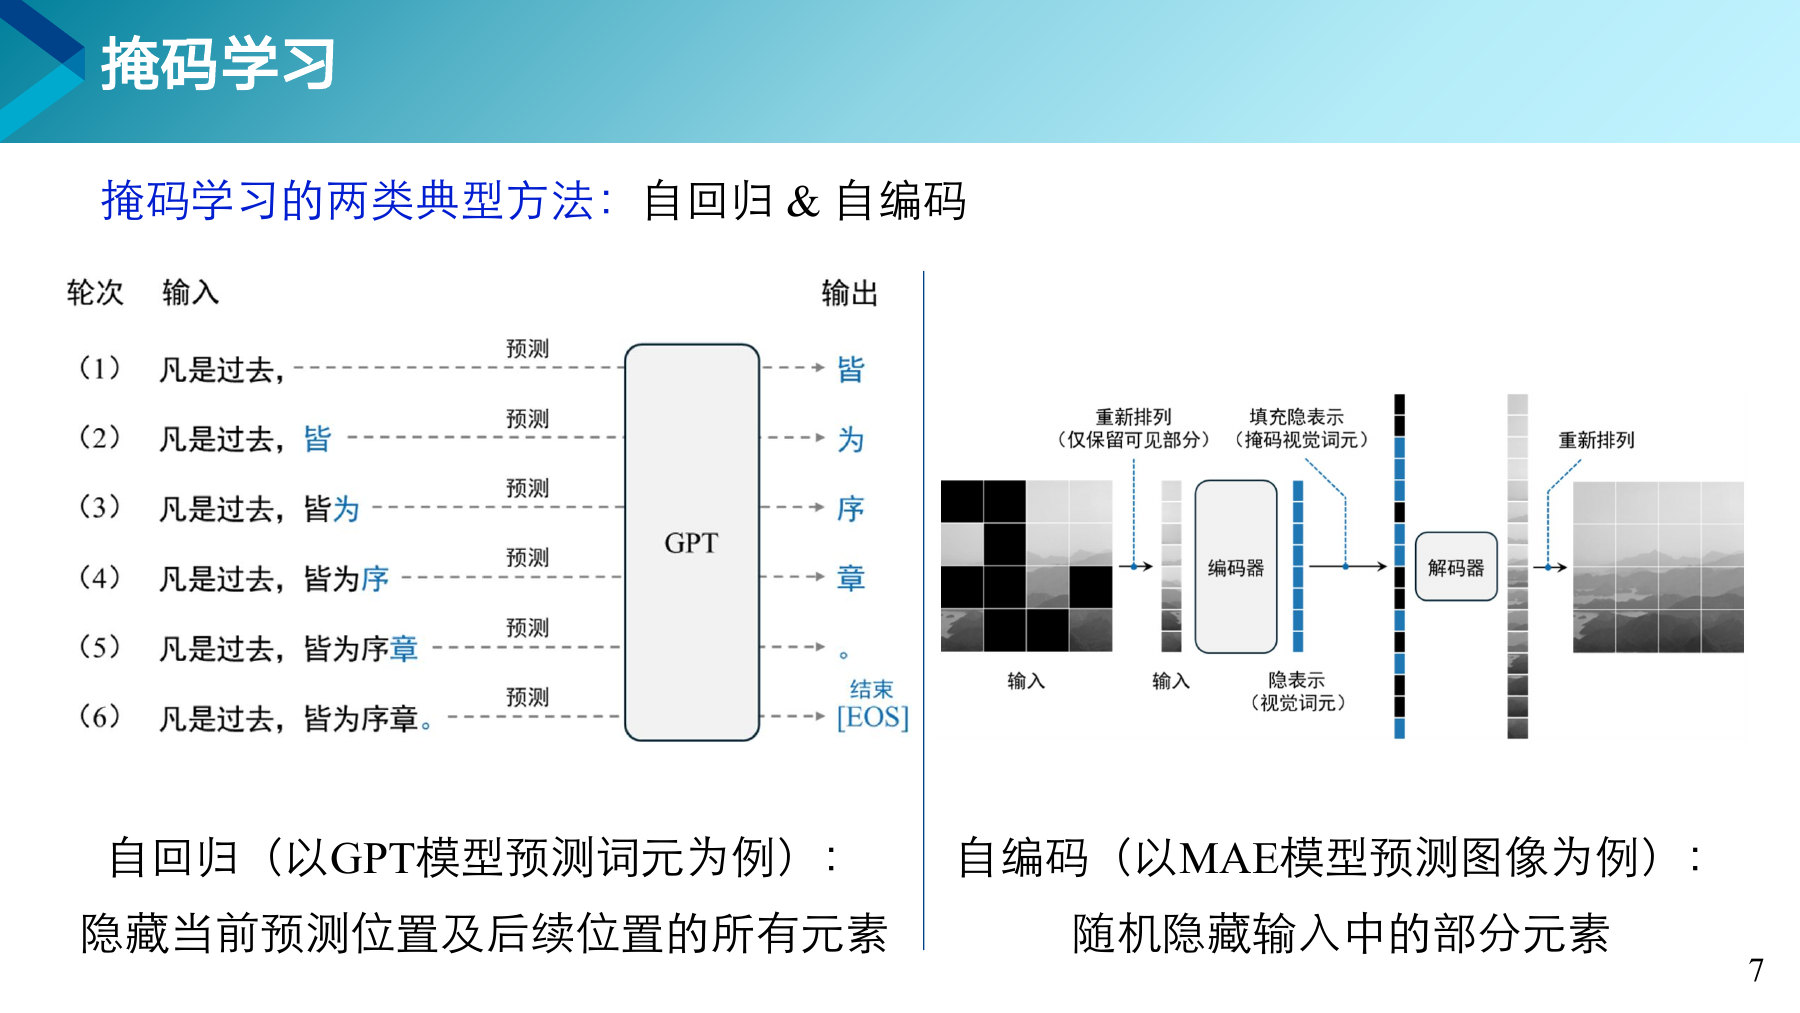
第 1 轮只给“凡是过去,”,让模型猜出“皆”。第 2 轮接上“皆”,再猜“为”。一个字一个字往后接,直到输出表示结束的 [EOS]。聊天大模型就是这样生成文字的。
MAE 会随机遮掉约四分之三的小块,文字通常只遮约 15%。图片里相邻的小块很像,遮得多也推得出来。
拉近锚点和正样本,推远锚点和负样本。
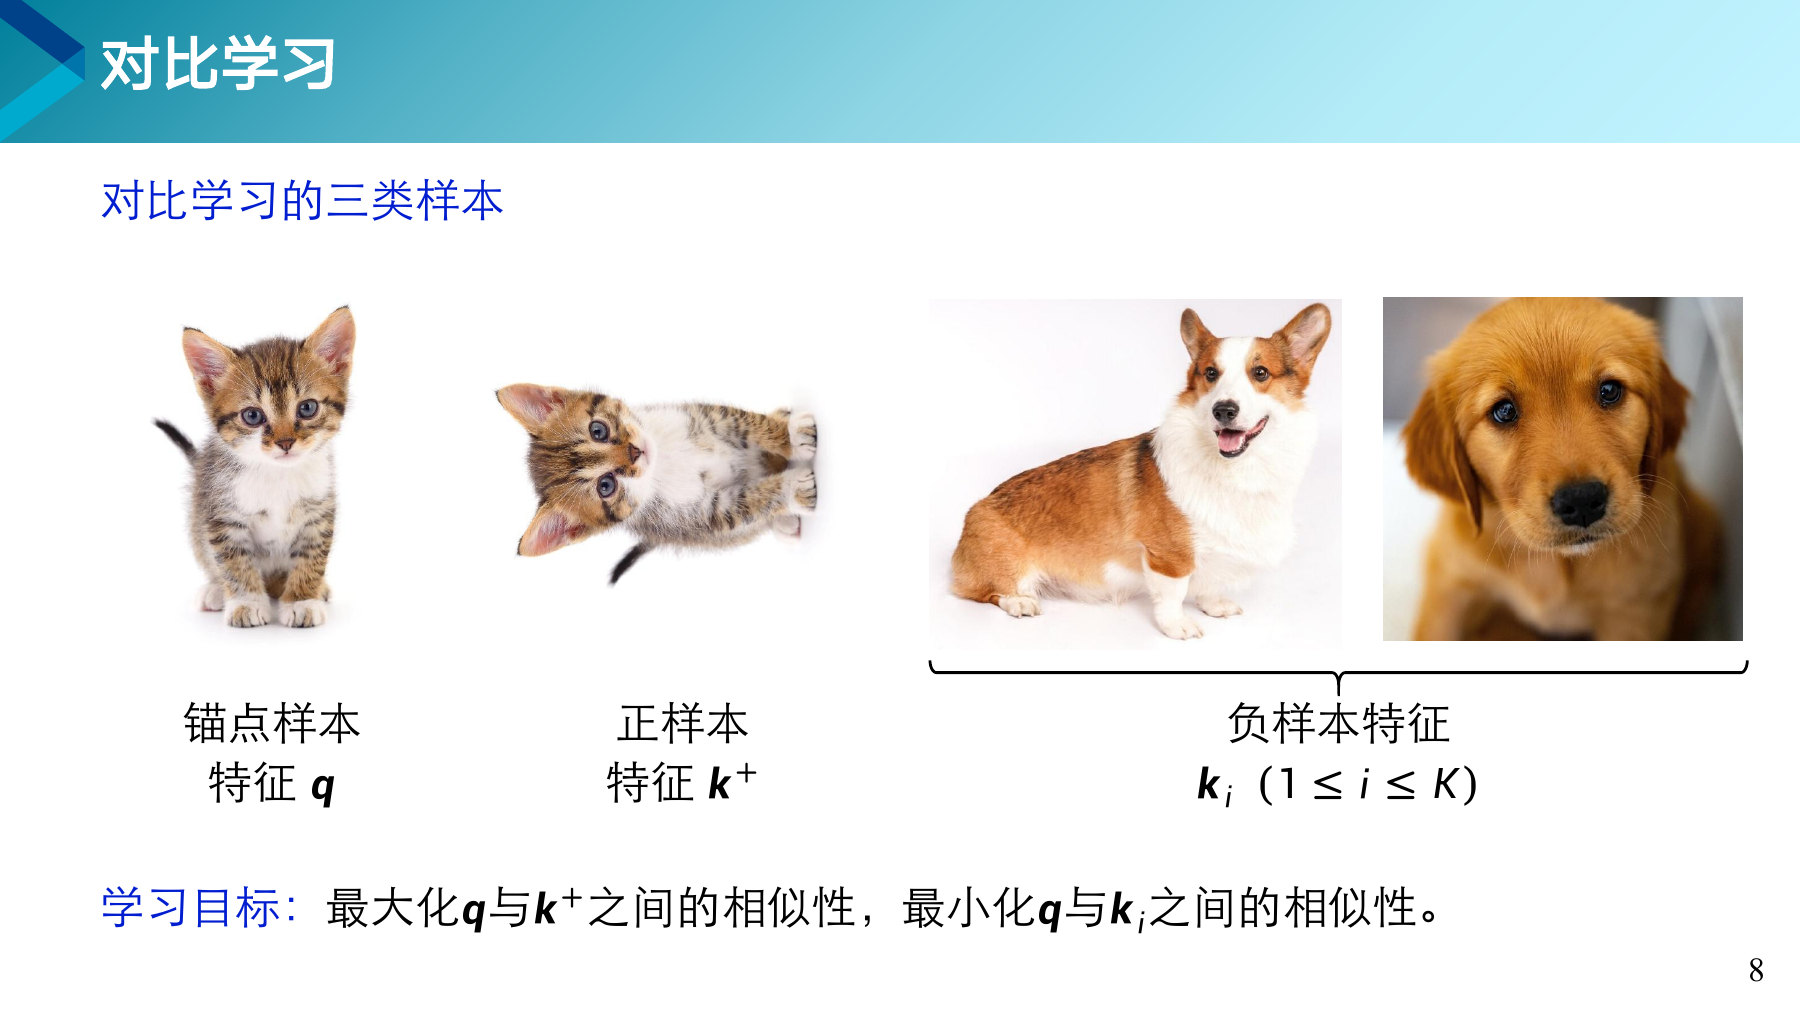
图中的正样本是另一只猫。没有标注时,常把同一张图随机裁剪、翻转、调色,做出两个版本,一个当锚点,一个当正样本,别的图都当负样本。
锚点是一张猫的照片。把这张照片左右翻转后得到的新图,在对比学习里算什么?