人工智能导论 第 2 章 · 第四节
课程 › 第 2 章 › 第四节 非凸优化极小值与鞍点二阶信息特征值判别逃离鞍点现代优化算法随机梯度下降动量法自适应学习率三者对比结构设计本节小结本节习题
第 2 章 人工智能数学基础 · 第四节

非凸优化与现代优化算法

坡度为零的地方未必是谷底
本 节 知 识 点
  1. 312.4.2 非凸优化挑战
  2. 32局部极小值与鞍点
  3. 33局部极小值与鞍点的判别方法
  4. 34通过海森矩阵判别临界点
  5. 35逃离鞍点
  6. 362.4.3 现代优化算法
  7. 37随机梯度下降
  8. 38动量法
  9. 39自适应学习率优化算法
  10. 40三种自适应算法的收敛路径
  11. 41神经网络结构设计
  12. 42小结
  13. 43习题
31
第 2 章 · 第四节

2.4.2 非凸优化挑战

坡度为零的地方不一定是谷底,也可能只是走到了平地。

局部极小 全局最低 鞍点 平台 ? 损失函数的地形:到处都可能是平地

关键术语

临界点Critical Point
函数曲面上所有方向的坡度都等于零的点,脚下是平的,但不一定是最低点。

重 点平地不等于谷底

深度学习的损失函数曲面是非线性、非凸的,地形极其复杂。曲面上有大量坡度为零的平坦区域,它们可能是最低点,也可能只是一块中途的平台,甚至是一个山口。

训练模型的过程就是在这样的地形上找最低处。如果只凭"脚下是平的"来判断,很容易停在错误的位置。

打个比方

浓雾里下山,走到一处发现四周都不往下了,你会以为到了山脚。但你也可能只是走到了半山腰的一块平台,或者一个山口。光凭脚感分不出来,必须有别的办法才能判断。

知道更多为什么这在深度学习里特别麻烦

凸函数只有一个最低点,走到平的地方就是答案。非凸函数遍地是平地,影响最大的是局部极小值和鞍点。上面的地形图中标出了它们各自的位置。

想一想

你怎么判断自己是走到了山脚,还是只走到了一块平台?
32
第 2 章 · 第四节

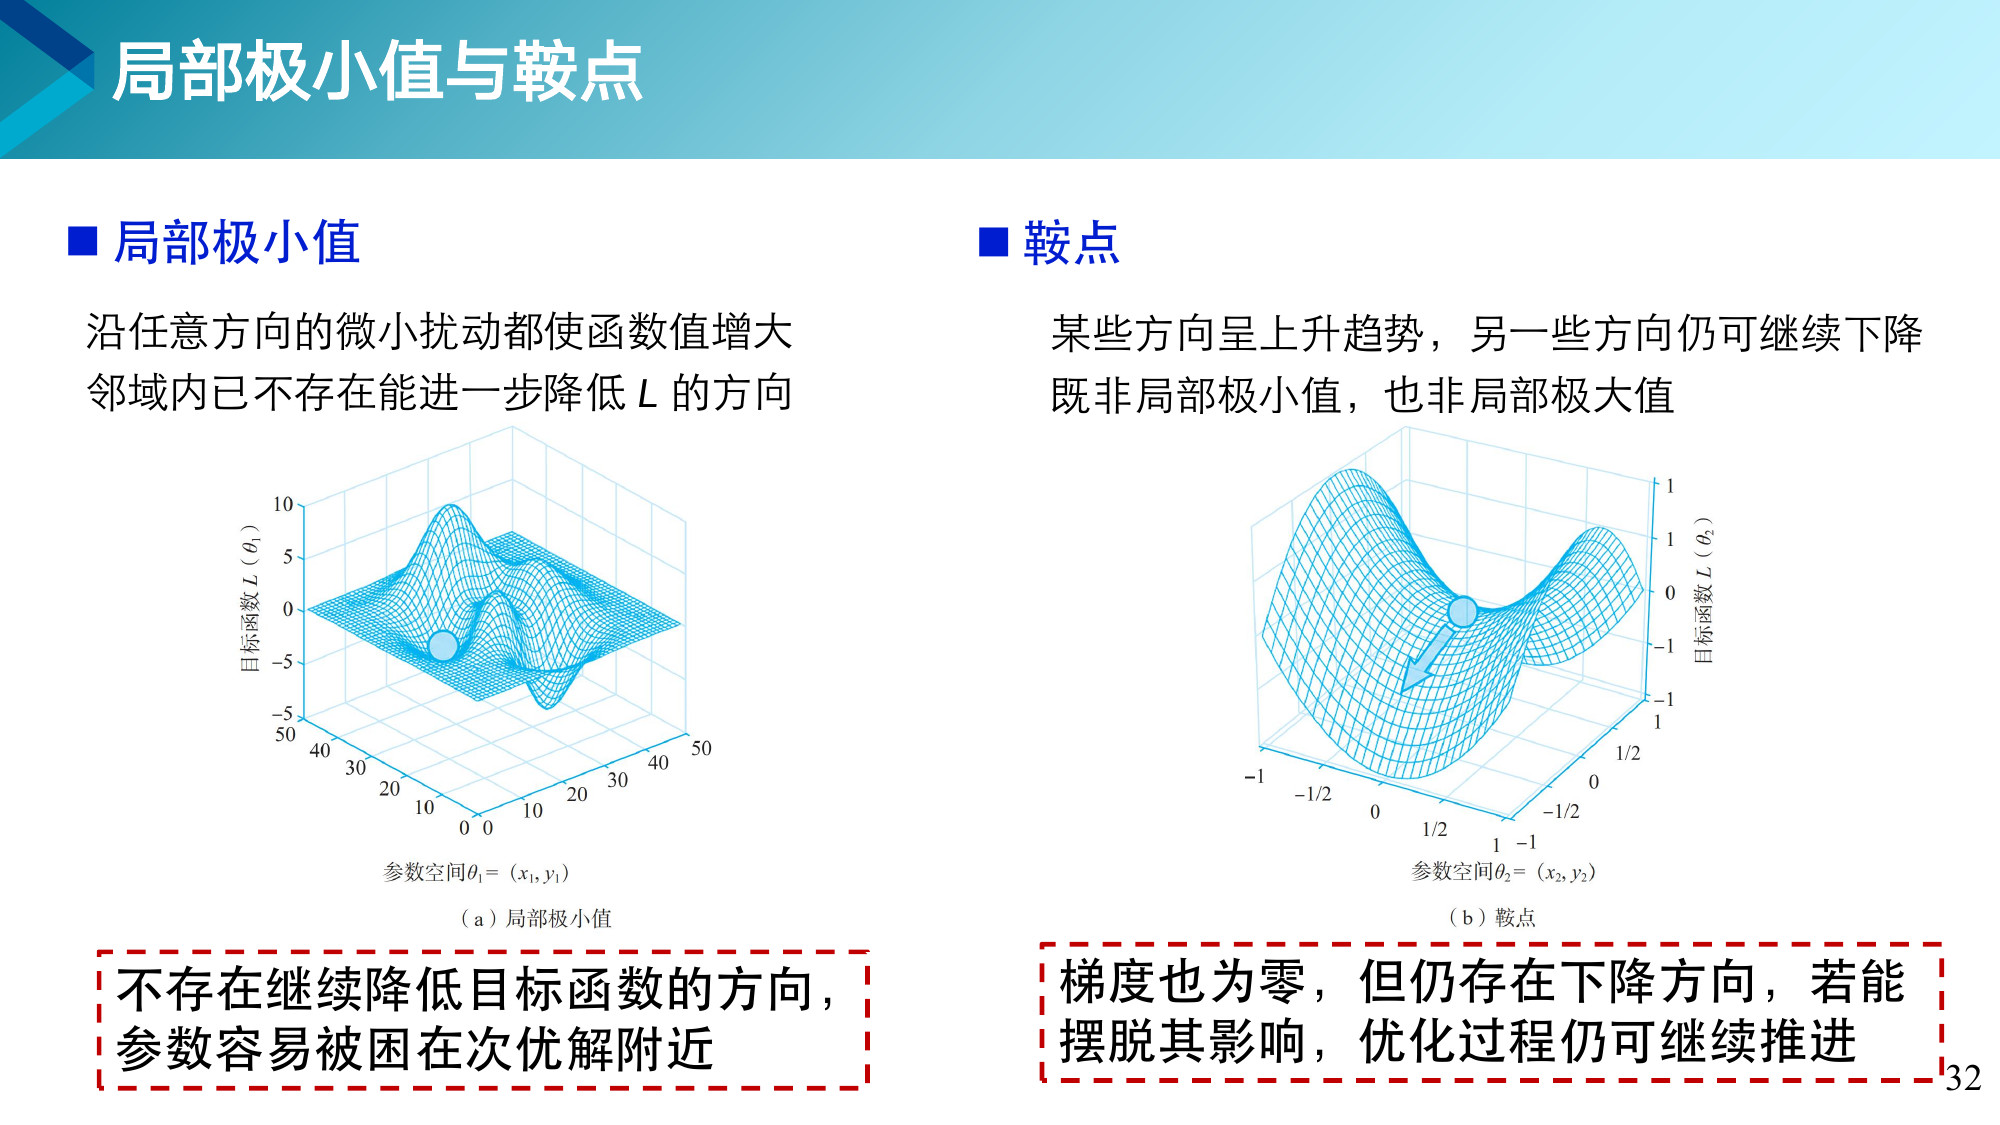
局部极小值与鞍点

一个是四面都是上坡的坑,一个是有的方向还能下去的马鞍。

第 32 页课件

重 点碗底和马鞍的区别

局部极小值像一个碗底,沿任意方向都是上坡,邻域内不存在能继续降低损失的方向。一旦走到这里,普通的下坡方法就会以为已经到了终点。

鞍点像一副马鞍,某些方向是上坡,另一些方向仍然可以继续下行。虽然坡度也是零,但如果能找到那个下坡方向,优化过程就能继续推进。

两者的坡度都是零,差别在于还有没有出路。

打个比方

局部极小值像碗底,往哪个方向爬都是上坡,真出不去。鞍点是一副马鞍,沿着马背前后走是上坡,跨着马身左右走是下坡。人站在马鞍正中央也觉得是平的,但只要往侧面挪一步就能滑下去。

知道更多哪个更常见

在参数极多的高维空间里,一个点要成为局部极小值,需要所有方向都往上弯,条件很苛刻。只要有一个方向往下弯,它就成了鞍点。所以深度学习里遇到的平地,绝大多数是鞍点而不是局部极小值。这算是个好消息,因为鞍点有出路。

想一想

站在马鞍正中间,怎么知道往哪边挪能下去?

33
第 2 章 · 第四节

局部极小值与鞍点的判别方法

一阶信息只能看出平不平,要分辨类型得看二阶。

一阶 vs 二阶信息 一阶信息:这里是平的 ✓ 但是碗底、碗顶、马鞍中间都是平的,分不出来 二阶信息:看曲面往哪边弯 向上弯 → 碗底 极小值 向下弯 → 碗顶 极大值

关键术语

海森矩阵Hessian Matrix
描述曲面在各个方向上弯曲情况的数学工具,可以理解为"对坡度再看一次变化",告诉你曲面是往上弯还是往下弯。

重 点为什么需要二阶信息

一阶信息(坡度)只能回答"这里是不是平的"。碗底是平的,碗顶也是平的,马鞍中间也是平的。光看一阶,三者没有区别。

二阶信息回答的是"平的这一块是往上弯还是往下弯"。往上弯说明是碗底(极小值),往下弯说明是碗顶(极大值),有的方向往上弯有的往下弯就是鞍点。

打个比方

闭着眼摸一个碗和一个倒扣的碗,摸到最中间那一点,两者都是平的,摸不出区别。要分清楚,必须再往四周摸一圈,看看是往上翘还是往下垂。"往四周摸一圈"就是二阶信息在做的事。

想一想

碗底和倒扣的碗顶,最中心那一点有什么共同点?

34
第 2 章 · 第四节

通过海森矩阵判别临界点

每个方向的弯曲情况拼在一起,就能判断这是什么类型的平地。

各方向弯曲情况 → 判别结果 全部向上弯 极小值 碗底,出不去 全部向下弯 极大值 山顶,不是目标 有上有下 鞍点 马鞍,有出路 如果某个方向既不向上弯也不向下弯(完全平的), 二阶信息也判断不了,需要更高阶的分析

重 点判别方法

海森矩阵记录了曲面在每个方向上的弯曲情况。把所有方向的弯曲方向汇总起来,就可以做判断。

每个方向都往上弯,说明四面都是上坡,这里是碗底,即局部极小值。每个方向都往下弯,说明四面都是下坡,这里是山顶,即局部极大值。有的方向往上弯有的往下弯,就是鞍点。

打个比方

站在一个曲面上沿不同方向各摸一遍。每摸一个方向,记一个结果:往上翘记"上",往下垂记"下"。全是"上"就是坑,全是"下"就是包,有"上"有"下"就是马鞍。海森矩阵做的就是这件事,只不过把"摸"换成了数学计算。

知道更多有的方向完全平怎么办

如果某个方向既不往上弯也不往下弯,是完全平的,那么二阶信息也不够用了,需要借助更高阶的分析手段。这种退化情况在实际中不常遇到,知道有这么一种可能就够了。

想一想

一个方向往上弯、九十九个方向往下弯的点,是什么类型?

35
第 2 章 · 第四节

逃离鞍点

往下弯的那个方向,就是还能继续走的通道。

从鞍点逃离 上坡方向 上坡方向 下坡 下坡 鞍点 逃跑方向 道理简单,但计算代价极高,实际中很难直接使用

重 点逃离的道理很简单

海森矩阵告诉我们哪些方向是往下弯的。往下弯的方向,意味着沿着这个方向走,函数值会下降。所以只要朝着往下弯的方向迈出一步,就能滑出鞍点,继续寻找更低的位置。

一句话:下弯方向等于可以继续下降的方向。

打个比方

站在马鞍正中央,四周摸一圈,发现左右两侧是往下垂的。那就往左边迈一步,人自然就滑下去了。下弯方向就是"侧面"这个方向。

知道更多为什么实际中做不到

直接算出海森矩阵的代价极高,因为它的大小与参数个数的平方成正比。现代深度学习模型动辄几百万甚至上亿个参数,完整地算出这张表既装不下也算不完。所以实际训练中没人真去算它,只能用下一部分介绍的那些只依赖坡度信息的优化算法来间接应对。

想一想

知道办法却因为太贵而用不了,前面哪一页也遇到过同样的情况?

36
第 2 章 · 第四节

2.4.3 现代优化算法

不算二阶,只用坡度信息,也要把二阶的活干出来。

现代优化算法 随机梯度下降 解决什么: 速度太慢 每次只用一小部分 数据来估计坡度 动量法 解决什么: 方向来回震荡 累积历史方向 平滑更新路径 自适应学习率 解决什么: 步长一刀切 给每个参数 各配一个步长

重 点三大类各解决一个问题

既然直接算海森矩阵代价过高,现代优化算法另辟蹊径,只用坡度(一阶信息)就能在复杂的损失曲面上高效前行。这些算法分成三大类。

随机梯度下降解决速度问题,通过随机采样训练样本来估计坡度。动量法解决震荡问题,累积历史方向来平滑前进路径。自适应学习率算法解决步长问题,根据各参数的情况分别调整步长大小。

知道更多三者之间的关系

这三类方法不是互相替代的,而是可以叠加的。比如 Adam 算法就同时用了动量和自适应学习率。它们在不依赖二阶信息的前提下,部分弥补了坡度方法对曲面弯曲信息的不足。注意是部分弥补,不是完全替代。

想一想

不能直接测量一样东西,只能用别的办法来估计它,你还能想到什么例子?

37
第 2 章 · 第四节

随机梯度下降

每次只看一个或一小撮样本就更新,把单步开销压到最低。

全批量 vs 随机梯度下降 起点 终点 全批量 直但很慢,每步都要看全部数据 SGD 锯齿但很快,每步只看几个样本

关键术语

随机梯度下降Stochastic Gradient Descent, SGD
每次迭代仅使用一个训练样本或一小批样本来估计坡度并更新参数,用精度换取速度。

重 点速度与精度的交换

全批量梯度下降在每一步更新前都要把全部训练数据看一遍,坡度估计很准,路径也很直,但每一步的计算开销极大。

随机梯度下降每次只看一个或一小批样本就更新,坡度估计含有噪声,路径是一条锯齿线。但因为单步开销极低,同样的时间内能迈出成百上千步。走错几步没关系,方向的平均值是对的。

打个比方

相当于问路。全批量是把全城的人都问一遍再决定往哪走,答案准但一天只能走一步。随机梯度下降是随便拉一个路人问一句就走,那个人可能指错,但你一天能走几百步。总体方向是对的,冤枉路走不了多远。

想一想

问一个路人和问一百个路人,哪种更容易走冤枉路,哪种更容易一天走不完?

38
第 2 章 · 第四节

动量法

不只看这一步的坡度,还带着之前积累的惯性。

动量法:像一个滚下山的球 历史方向 当前坡度 实际方向 (历史+当前) 优点 方向一致时加速 方向摇摆时互相抵消 代价 冲得太快可能过头 在终点附近来回摆动

关键术语

动量法Momentum
在更新参数时加入历史方向的影响,对前进方向做平滑处理,让路径更稳、更快。

重 点历史与当下的混合

动量法的更新方向不再由当前这一步单独决定,而是把历史方向和当前坡度按一定比例混合在一起。历史方向占的比例越大,惯性越强。

方向一致的时候,历史和当前互相叠加,速度越来越快。方向来回摇摆的时候,正负互相抵消,震荡就被压下去了。所以动量法的路径比随机梯度下降的锯齿线平滑很多。

打个比方

想象一个球滚下山。球不会因为地面坡度稍微变一下就立刻转向,它带着速度往前冲。在一段一直往下的坡上,球越滚越快。遇到地面来回起伏,球的惯性会把小颠簸抹平。

但球冲得太快,到了谷底也会冲上对面坡再滚回来。这是动量法要付的代价,就是所谓的过冲。

想一想

骑车下坡到了平路,你会立刻停住吗?

39
第 2 章 · 第四节

自适应学习率优化算法

不同参数用不同步长,谁动得频繁就让谁慢一点。

三种自适应学习率算法 AdaGrad 记住全部历史 步长越来越小 后期几乎走不动 不适合长时间训练 RMSprop 只记最近一段 步长保持稳定 能持续推进 比 AdaGrad 更稳 Adam 记方向 + 记幅度 = 动量 + 自适应 又快又稳 目前最常用的默认选择 核心思想 某个参数过去变化很大 → 把它的步长调小 某个参数过去变化很小 → 把它的步长调大

重 点每个参数有自己的步长

之前的方法,所有参数共用一个步长。但不同参数的情况不同,有的变化剧烈,有的变化平缓,统一步长必然有人过大有人过小。

自适应学习率的核心思想是:某个参数过去变化很大,就把它的步长调小,避免震荡。某个参数过去变化很小,就把它的步长调大,加快推进。

重 点三种算法的区别

AdaGrad 把过去所有坡度变化全部累计起来。问题是越积越大,步长最终衰减到几乎走不动。RMSprop 只看最近一段时间的变化,步长不会无限衰减,能稳定推进。Adam 把动量法和 RMSprop 结合在一起,既记住方向,又调整幅度。

打个比方

一个班里基础好的学生进度快,基础差的进度慢,用同一个进度必然有人跟不上有人吃不饱。自适应学习率就是给每个参数配一个自己的进度,因材施教。

想一想

三个算法里,你觉得哪一个最不适合训练很久的任务?

40
第 2 章 · 第四节

三种自适应算法的收敛路径

同一座山,三条不同的下山路线。

三条收敛路径对比 最优点 AdaGrad 越走越密 RMSprop 稳步推进 Adam 快且平稳 椭圆是损失函数的等高线,中间红点是最优解

重 点三条路径的差别

AdaGrad(绿色)前期走得快,但步长一直衰减,后期步伐越来越密,离终点很近却迟迟到不了。

RMSprop(赭色)只看最近一段时间的变化,步长保持稳定,能一路推进到终点。

Adam(蓝色)结合了动量的方向平滑和自适应的步长调整,收敛更快也更平稳。

知道更多那些同心椭圆是什么

是损失函数的等高线,和地图上的等高线一个意思。线越密表示坡越陡。中间那颗红点是最优点。三条路径都要从各自的起点走到红点,比的是谁走得快、谁走得稳。

知道更多实际用哪个

Adam 是目前最常用的默认选择。但这不代表它永远最好,具体任务上仍然需要尝试。深度学习里很多结论都是这样,有一个通常不错的默认值,但没有放之四海皆准的答案。

想一想

三条路径最后都到了红点,那快和稳哪个更重要?

41
第 2 章 · 第四节

神经网络结构设计

除了改算法,还可以改模型结构,让这座山本身变得好走。

两种"修路"的办法 归一化 扁椭圆:难走 → 接近圆:好走 把不同参数的尺度拉到 差不多大,等高线变圆 残差连接 第 N 层 第 N+1 层 第 N+2 层 直通 旁路 给信号修一条直通车道 跨过中间层直接传回去 思路转变:不是练更强的走法,而是把路修好

关键术语

归一化Normalization
把网络中间层的输出拉到差不多的范围,缩小不同参数方向上的尺度差异。
残差连接Residual Connection
引入跨层的直接连接,让信号可以绕过中间层直接传回浅层。

重 点换个思路:修路而不是练腿

前面几页都在改优化算法,相当于换一种走法。这一页改的是模型结构,相当于把路修好。目标函数的地形变好了,一阶的坡度方法自然更容易收敛。

打个比方归一化在做什么

假如一个参数的合理范围是 0 到 1,另一个是 0 到 10000,那么等高线会被拉成一个极扁的椭圆。沿着窄的方向稍微一动就冲过头,沿着长的方向走半天没进展。归一化就是把两个方向的尺度拉回到差不多,扁椭圆变回接近圆形,路自然好走了。

打个比方残差连接在做什么

网络很深时,信号一层层往回传会越传越弱,传到最前面几层已经几乎没有了。残差连接是给信号修了一条直通车道,绕过中间层直接传回浅层,不衰减、不丢失。

想一想

与其练出更强的登山技巧,不如先把路修好。这个思路你还能用在哪?

42
第 2 章 · 第四节

小结

从认识地形到选择走法,再到修整道路。

本节脉络 认识地形 临界点与非凸 极小值 vs 鞍点 选择走法 SGD:用速度换精度 动量:平滑方向 自适应:调整步长 修整道路

重 点

深度学习的损失函数是非线性、非凸的,曲面上充满了坡度为零的平坦区域。仅凭坡度无法区分局部极小值和鞍点,理论上需要二阶信息,但海森矩阵的计算代价太高。

现代优化算法只依赖一阶坡度信息来应对:随机梯度下降用采样压低单步开销,动量法用历史信息平滑方向,自适应学习率为每个参数分别调整步长。归一化和残差连接则从模型结构入手,让损失曲面本身变得更规则。

想一想

这一节里,哪些办法是"换走法",哪些是"修路"?

43
第 2 章 · 第四节

习题

两道题,覆盖本节最要紧的两个判断。

本节习题 第一题 在深度学习训练中,为什么通常采用 小批量梯度下降而非解析解或全批量? 第二题 临界点处坡度为零,仅凭坡度能不能 区分局部极小值和鞍点?需要什么工具?

知道更多第一题的思路

解析解要求对矩阵求逆,计算量随参数个数急剧增长,而且要求矩阵可逆,深度网络达不到这个条件。全批量每一步都要看全部数据,单步开销太大。小批量用部分数据估计坡度,单步快,而且引入的随机波动反而有助于跳出局部极小值。

知道更多第二题的思路

不能。局部极小值和鞍点的坡度都是零,光看坡度分不出来。要区分它们,需要看曲面在各个方向上的弯曲情况,也就是海森矩阵记录的二阶信息。所有方向都往上弯是极小值,有上有下是鞍点。

想一想

用一句不带任何数学符号的话,向没学过这一节的人解释什么是鞍点。

保山学院·人工智能教研室·曹鼎鼎